每秒 110 个 token 对 57 个,Gemini 4 Neon 的输出速度接近 Carbon 的两倍。可真等一项任务跑完,报道里的时间是 21 分钟对 36 分钟。至于哪款更便宜,翻开 11 月 19 日的账单,Carbon 的促销还没结束,价格关系又会反过来。这个差距比榜单名次更贴近我关心的问题:一张工单从交给 AI 到能合并,中间到底要等多久、返工几次?这期 AI 热点沿着六条线聊模型选型、团队账单、代码验收和上线边界,给你几种当天就能跑完的对照。The Decoder、DEV Community
一、Gemini 4 Neon 编程榜第一,换到自己的仓库还能快多少?
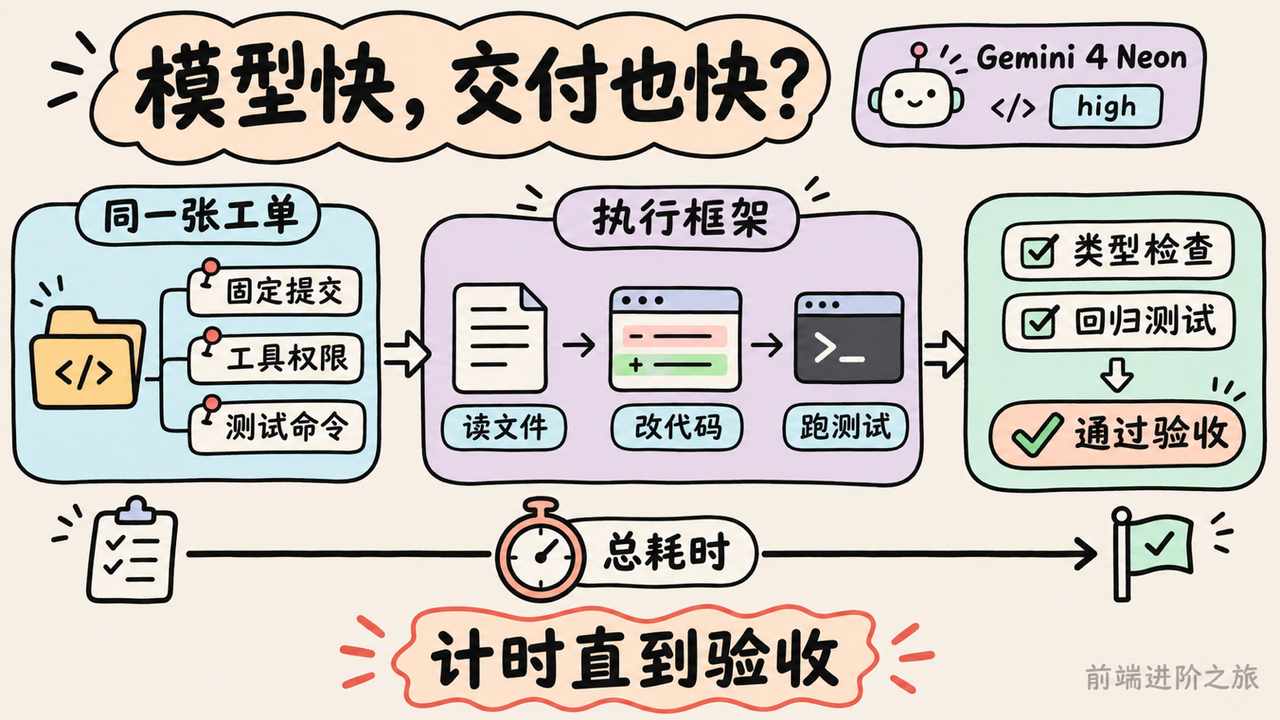
先说结论,我会把 Neon 加进跨文件任务的候选,默认从 high 开始跑。Artificial Analysis 的编程智能体指数给了它 58.6 分,排第一。另一张综合智能榜上,它用 xhigh 拿到约 61 分,排第三。两张榜测的是不同任务,综合分也对应明确的推理档位。你在 API 里用默认配置,起点是 high。MarkTechPost、DEV Community
我更在意同一个模型换环境后的表现。报道给出的 SWE-sweep 成绩,在 mini-SWE 执行框架里是 12.8%,在 Google Antigravity 里是 39.0%。工具怎么给、文件怎么找、测试挂了怎么继续,这些都由执行框架参与决定。报道没有拆开各环节的贡献,所以我看到 Copilot 也接入 Neon 时,最想测的是它在 Copilot 里能读到哪些文件、能跑哪些命令,以及被我中途叫停后能否接着推进。MarkTechPost、DEV Community
我会从工单交给 Agent 的那一刻计时,一直记到补丁通过验收。
回到这块,Neon 的百万 token 窗口对跨模块排障确实有用。比如客服给了一段复现录屏,前端有表单提交逻辑,后端有一份刚改过的接口定义,再加一段失败日志,这些能放在同一轮里看。对应的代价是输入要计费,Agent 多次读取工具结果也会继续积累用量。报道里的 21 分钟和 36 分钟来自特定评测,拿来安排自己团队的任务时长还早。The Decoder、DEV Community
要我选,我会拿一张最近做过的接口字段变更工单,固定提交、工具权限和测试命令,给现用模型和 Neon high 各跑一轮。两边都从接口定义、调用点和失败日志起步,让它们自行找剩下的文件。哪个更早交出通过类型检查和回归测试的补丁,哪个就更适合进下一轮。
二、GPT-6.2、Gemini 4 Neon 和 Qwen4-Max 怎么算单任务成本?
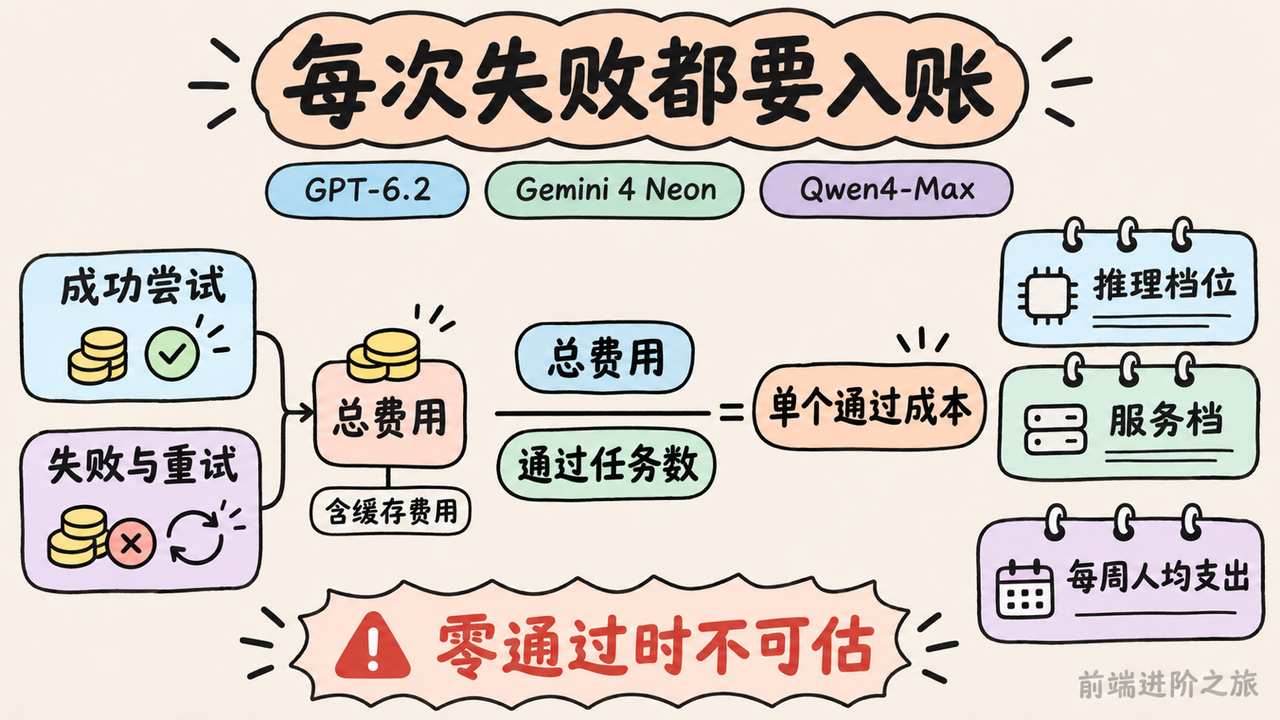
截至 11 月 19 日,按报道列出的每百万 token 价格,Neon 普通输入 3 美元、缓存输入 0.15 美元、输出 15 美元。Carbon 促销期间普通输入和输出是 2 和 10 美元,Neon 在这两项上贵 50%。按报道所列的 12 月 1 日起常规价 4 和 20 美元算,Neon 又低 25%。同一组评测里,Neon xhigh 每任务约 6.44 美元,Carbon 按常规价算约 7.76 美元。Neon 的输出 token 还多约 15%,用量吃掉了一部分单价差。The Decoder、DEV Community
顺着上面聊,OpenAI 于 11 月 17 日推出 GPT-6.2 Astra 和 Sol。据报道,Vercel AI Gateway 已提供对应模型,Astra 面向多步任务,Sol 面向日常编码。Astra 每百万 token 普通输入 8 美元、缓存输入 0.40 美元、输出 40 美元。网关还有按请求启用的 ultrafast 档,以更高的 token 成本换延迟。我会把服务档也写进测试记录,免得同一个模型两轮跑出不同账单,回头还得猜哪轮开了加速。发布前流传的 89% 跑分,公开结果里没有对应记录,我会从选型表里删掉这项。DEV Community · GPT-6.2 发布、DEV Community · Vercel 网关
Qwen4-Max 的费率更适合拿来对照。报道给出的普通输入和输出价是每百万 token 1.50 和 4.50 美元,较 Qwen3-Max 分别降了 32.8% 和 31%,它也登上了 LMArena WebDev 榜首。我的读法是,给它一张网页开发工单挺合适,尤其是有现成组件库、能验收交互的那种。单价优势能留下多少,要看交付时用了多少轮,还有多少需要人补的活。DEV Community · Qwen4-Max
这里有个坑。AWS 文章里,Airbnb 有个候选模型在评测中得分更高、单任务成本相近,上线几周后,用户平均每周支出却涨到原来的数倍。单次任务的用量和一周里发起的任务量都可能变,得分别看。他们还报告过一次推理档位对照,某模型从 low 调到 high 只多拿 0.8 分,单任务成本到了原来的 2.5 倍。AWS Machine Learning Blog
下面这段把同一配置下的尝试费用汇总起来,失败和重试都会记在账上。
function summarizeRuns(runs) {
  const passed = runs.filter(run => run.accepted).length;
  const totalUsd = runs.reduce((sum, run) => sum + run.costUsd, 0);
  return {
    attempts: runs.length,
    passed,
    passRate: runs.length ? passed / runs.length : null,
    totalUsd,
    usdPerAcceptedTask: passed ? totalUsd / passed : null, // 失败照样花钱,零通过时成本不可估。
  };
}
最容易算错的是 totalUsd 那一行,上游的 costUsd 要包括一次尝试里的所有模型调用,缓存读写也得按对应费率记。今天能跑完的版本可以只挑三张工单,覆盖页面修改、接口联调和失败测试修复,给每个候选相同的重试预算。团队要定默认档,再把试用期间的每周人均支出补进来。
三、LLM 推理提速怎么测,才能排除预热和缓存的影响?
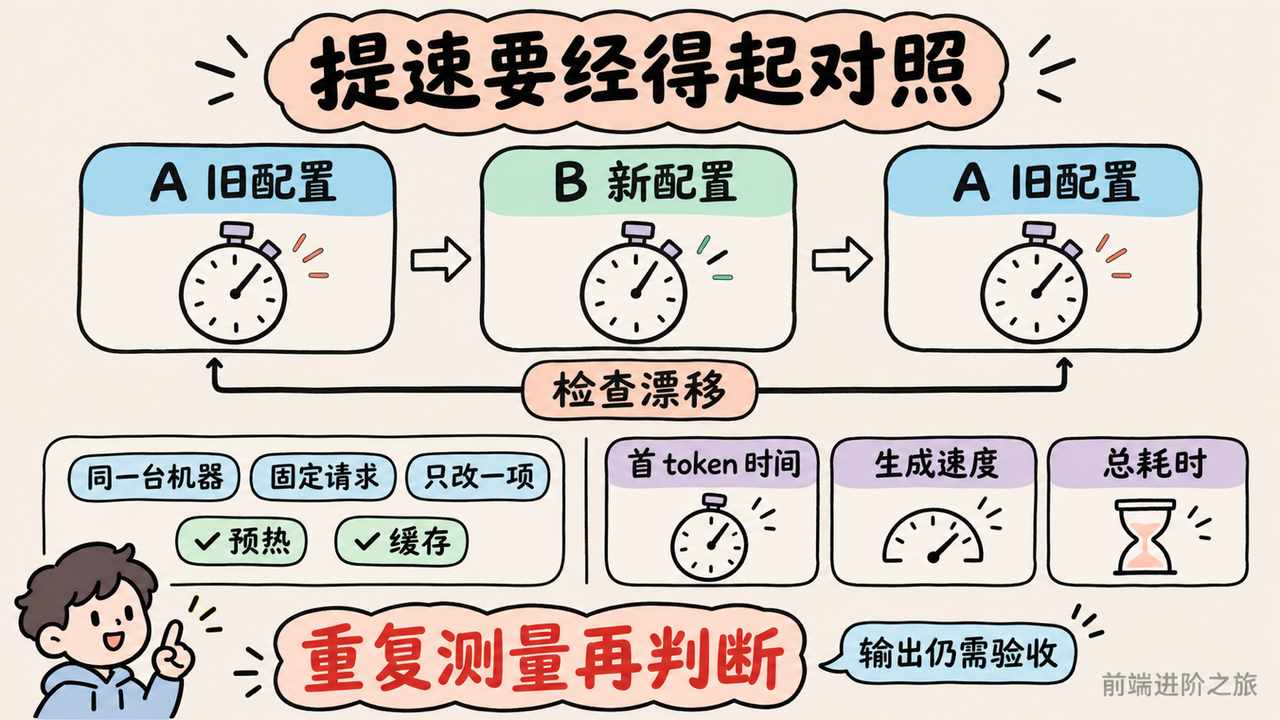
说实话,拿两张终端截图比速度,我会先问测试顺序。你先把旧配置跑一遍,再切新配置,第二轮可能已经吃到了预热或缓存。讲交错对照的文章建议按 A、B、A 跑,用前后两轮旧配置夹住候选配置。作者用模拟数据验证了方法,观察到真实提升更容易被识别,模拟里的误报率却没有下降。所以这个顺序适合拿来检查漂移,收益还得靠重复测量站稳。DEV Community · 交错对照
另一篇在 RTX 3050 8GB 上测了 Gemma 4 E4B。作者让每种配置回答同一批题,其中 GSM8K 有 1,319 道。这个题集上,开 thinking 后耗时达到原来的 2.24 到 2.47 倍,最多净增 16 道正确答案。草稿模型在部分配置里最高带来 2.39 倍加速,测试得分保持不变。这个结果给本地推理调参提供了试验顺序,适用范围仍是这张卡、这些配置和这批数学题。要给本地 AI 编程助手选默认模式,题得换成实际会交给它的活。DEV Community · Gemma 4 E4B 实测
页面上多久能看到第一个字,和工单多久能交付,要分开计时。
要是你在做聊天界面,首 token 时间会影响用户多久看到反馈。要是你在做后台代码 Agent,读文件、跑测试以及失败重试占掉的时间也得留下来。否则你可能把流式输出调得很顺,开发者等一张 PR 的时间还是一样长。
今天可以拿十条固定请求,在同一台机器上只切一个选项,跑几轮 A、B、A。输入长度、输出上限和缓存状态都记下来,分别看首 token 时间、生成速度和总耗时,再按相同条件核对输出是否通过验收。两轮 A 自己差得很大时,我会先查当时的负载和缓存状态,再决定这组数据能不能用。
四、AGENTS.md 怎么验证,才能挡住 AI 写出的站内跳转回归?
大概率你也遇到过,AI 给设置页加个「返回」入口,点击确实能跳走,代码里却是一个裸 <a>。如果仓库靠共享 Link 做客户端导航,这一下可能变成整页刷新,多步表单里的草稿也跟着丢了。项目封装还可能负责语言前缀、滚动恢复和埋点。审查这种改动,我会顺手点一下带未提交状态的页面,因为只检查目标地址,很难看见这类回归。DEV Community · 站内路由
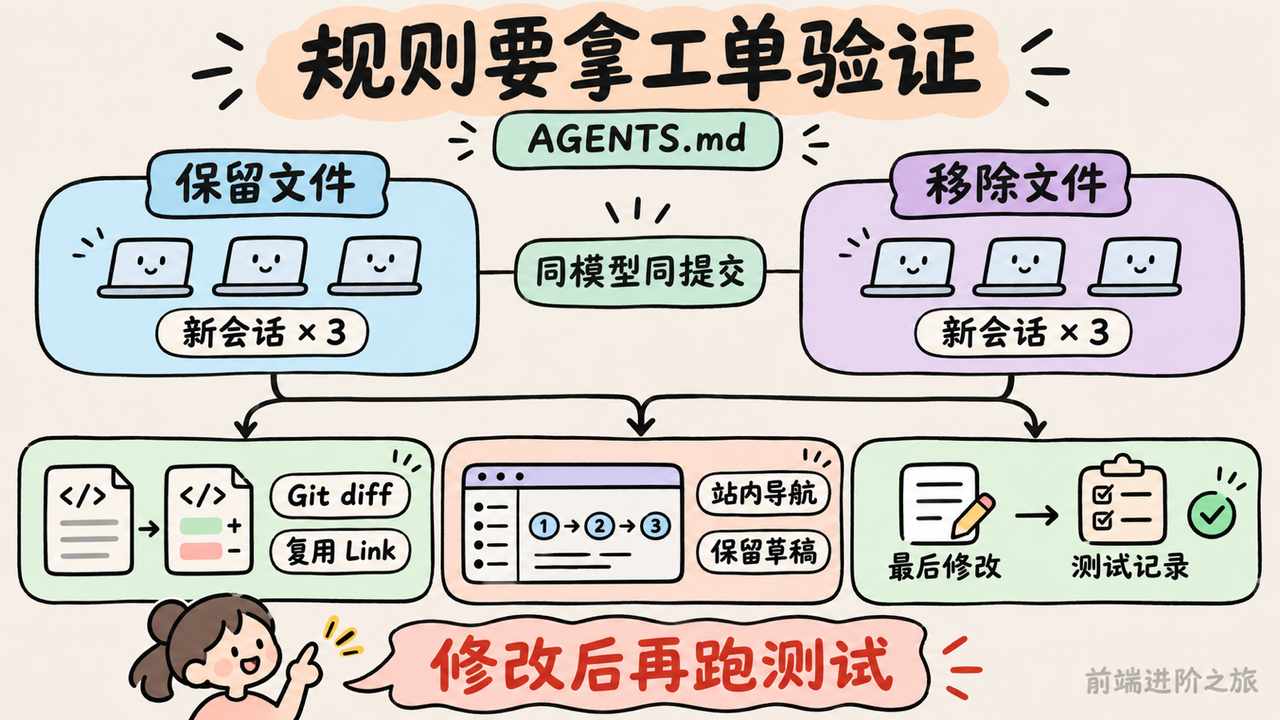
有篇文章给 AGENTS.md 设计了五项对照。固定仓库,每项任务分别在保留和移除文件的条件下各跑三次,每次开新会话,用 Git 差异或会话记录判定通过。里面有一项我很喜欢,检查 Agent 有没有在最后一次代码修改之后跑过测试。它先跑了检查,随后又改实现,前一次通过就覆盖不到最后交付的版本。作者给的是测试方法,示例分数只用于说明怎么记录。DEV Community · AGENTS.md 对照测试
你要是也在做 AI 生成页面,可以顺手把规则扩到表单和键盘操作。WebCraft Pro 的作者把工程指导和自动检查配在一起,关注可点击 div、输入框缺少关联标签、纯图标按钮缺少可访问名称等问题。我会让仓库规则告诉 Agent 现成组件在哪,让检查在提交时指出遗漏。文中的示例属于工具演示,团队自己能拦下多少问题,跑过业务页面才有数。DEV Community · 自动化护栏
我会先选「给多步表单新增一个站内入口」这一题。固定模型、起始提交、工具权限和其他指令,每组各开三个会话。看 Git diff 里用的是哪个组件,再实际走一次带草稿的导航,顺手确认最后一次修改后的测试记录。两组都能通过时,这道题暂时测不出那条规则带来的增益。保留规则仍然失败,就把组件路径和站内链接的适用范围写得更具体,再跑一轮。
五、AI 输出进页面、进数据库、进发布队列,分别该在哪验收?
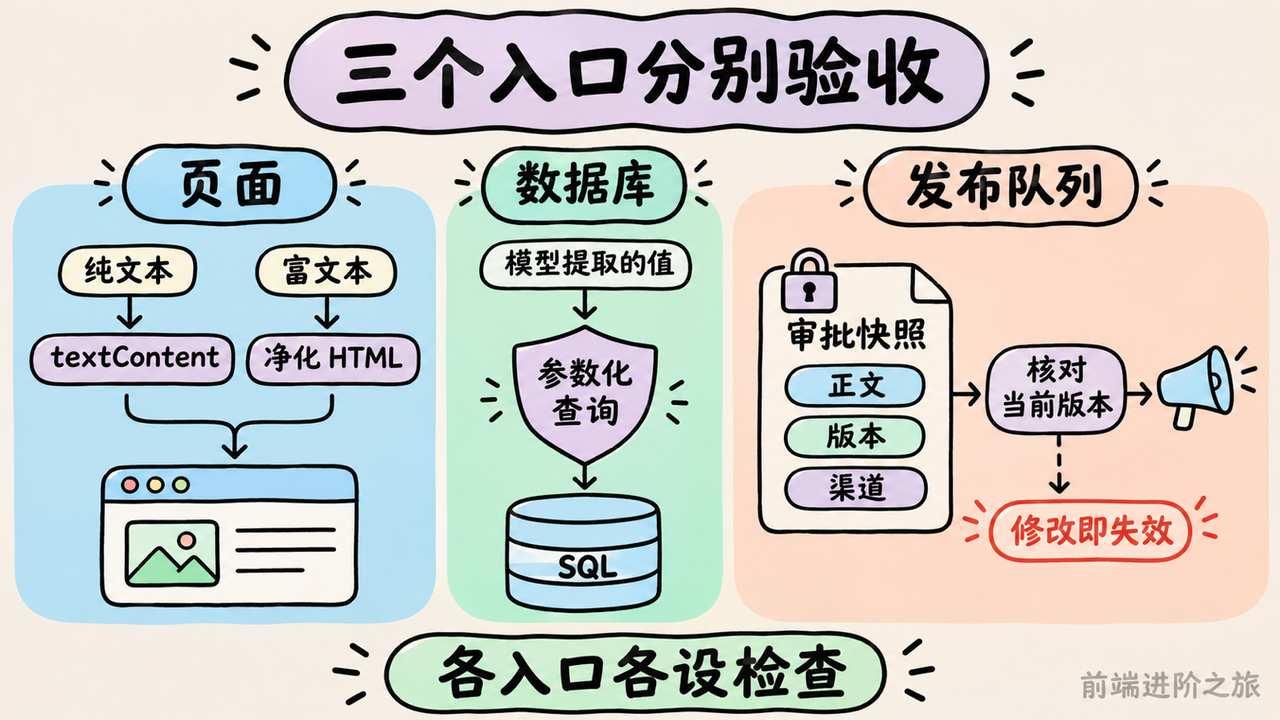
AI 办公提效很容易从「帮我写个摘要」长成「写完顺便发掉」。这时得把几个入口单独翻出来看。ReviewBot 的案例里,应用把模型生成的商品评论摘要当 HTML 插进后台,又把模型提取的商品名直接拼进 SQL,分别导致 XSS 和 SQL 注入。对于纯文本摘要,我会走框架的默认转义或 DOM 的 textContent。确实要展示富文本,再走专门的净化流程。数据库侧使用参数化查询,会话 Cookie 用 HttpOnly 限制脚本读取。三处各管各的事。DEV Community · ReviewBot 输出处理案例
给 Agent 读仓库之前也有一道边界。TokenCap v3.1 把文件、diff 和代码片段放到统一出口脱敏,遮蔽硬编码凭据,同时保留 process.env.SECRET 这样的引用,好让 Agent 看懂配置从哪来。它会保留连接串的用户名和主机信息,这个取舍得看仓库。内部主机名也敏感的团队,要把相应字段纳入遮蔽规则。DEV Community · TokenCap 脱敏
发布端还有个很容易漏测的时序。编辑审过一稿,队列还没消费,有人点了 Rewrite。如果批准状态只存在可变的草稿对象上,发布任务取到的正文可能已经换了。原文的做法是把正文、修订版本和目标渠道绑定到审批。我会让当前版本一变化,旧审批立即失效,尤其是正文和渠道还会一起改的流程。DEV Community · 发布审批
下面这段用 JavaScript 表达发布 worker 的交接检查,通过后把已审核快照交给发送函数。
async function publishApproved({ approval, snapshot, loadDraft, send }) {
  const current = await loadDraft(snapshot.id);
  if (
    !approval ||
    approval.snapshotId !== snapshot.snapshotId ||
    current?.revision !== snapshot.revision
  ) {
    return { status: "needs_review" };
  }
  // snapshot 由服务端按 ID 读取,正文和渠道都来自同一份不可变记录。
  await send({ channel: snapshot.channel, body: snapshot.body });
  return { status: "sent" };
}
最容易翻车的是 send 那一行,它必须用审核过的快照里的渠道和正文。这段只展示交接检查。如果产品要求「点了改写后,尚未实际发送的任务一律撤销」,版本检查和任务领取还得由存储层一起协调,队列重试也要有独立的防重机制。当天用一个假的发送函数就能测三条路径:原稿正常发送、审批后改正文、审批后换渠道。后两条都应停在发送之前。
六、Azure o3 退役和 PyPI 依赖投毒,为什么都要查实际运行环境?
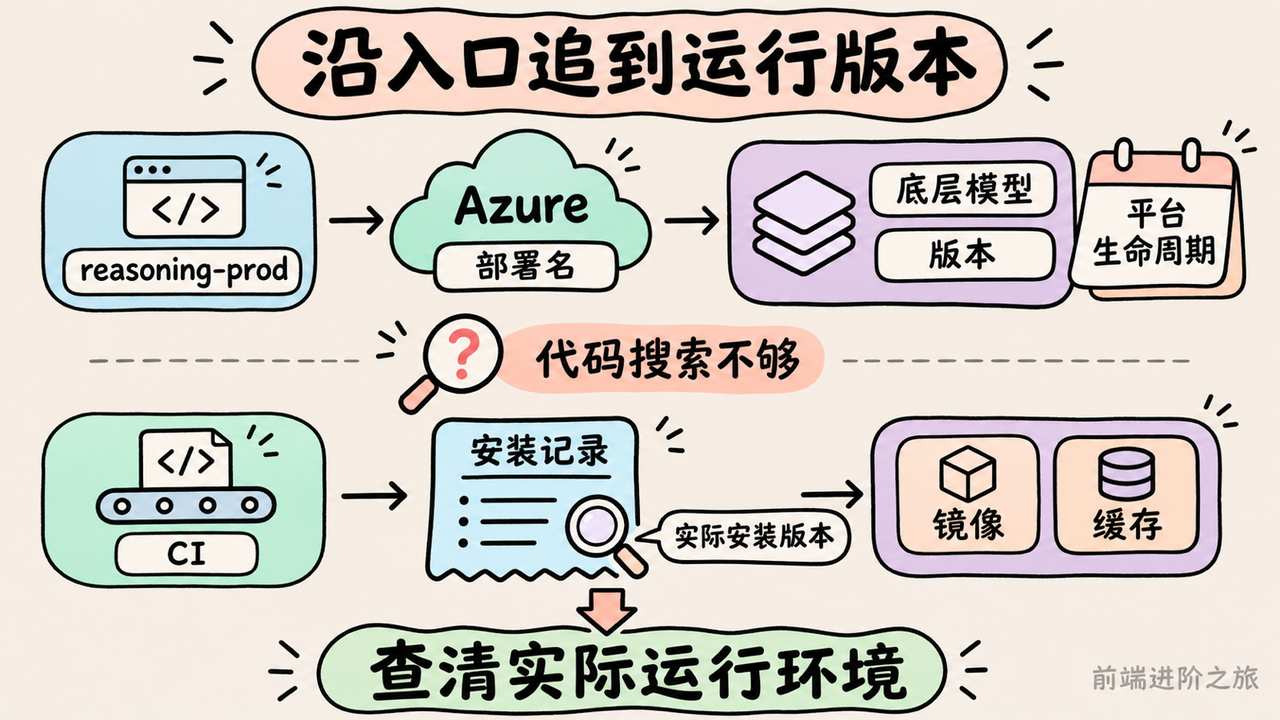
同样是 o3-2025-04-16,报道列出的 Azure OpenAI 退役日是 11 月 19 日,OpenAI API 的关闭日是 12 月 11 日,相差 22 天。最容易漏掉的是自定义部署名。应用里可能只写了 reasoning-prod,代码全文搜索不到 o3。排查需要从实际调用的 Azure 账户列出部署,拿部署名、底层模型和版本一起核对,再按接入平台的生命周期安排迁移。DEV Community · o3 退役日期
同一天还有一条依赖消息。IT 之家援引报道说,微软 Agent Framework 的 PyPI 版本 1.26.1 和 1.26.2 被植入恶意代码,随后均被移除。按报道,安装后的风险可在 Python 启动阶段出现,业务代码里搜不到 import 也要查运行环境。第二个版本还涉及对 GitHub Actions 身份令牌的请求能力,目前报道没有确认是否成功取得令牌或发生泄露。我会优先看 CI 的实际安装记录、镜像和缓存,因为光看清单里今天锁的是哪个版本,回答不了前几次构建装过什么。IT之家
这两件事对技术管理者的影响很具体。团队把模型接进网关、把依赖封进镜像以后,最好还能从线上入口查回底层版本,遇到变更才知道哪个服务要动、哪次构建需要复查。今天可以从一个线上应用反查它实际用的模型部署,再从最近一次 CI 运行反查 Python 依赖版本。若发现装过报道中的两个版本,按安装时间和环境盘点可能暴露的凭据,撤销相关凭据并检查云平台及 CI 的异常访问记录。
总结
11 月 19 日这批公开报道里,Neon 的评测成绩和费率、GPT-6.2 在 Vercel 网关的模型入口、Qwen4-Max 的 API 报价,都有具体口径可以拿来做对照。Airbnb 的案例也摆出了一笔实账,内部评测看起来差不多的成本,上线后可能变成数倍的人均周支出。
我的取舍是把 Neon 放进跨文件任务,把 Qwen4-Max 放进网页任务,已经接 Vercel 网关的团队可以用 Sol 和 Astra 对照日常改动与多步任务。每组都记验收率、完成时间和每个通过任务的成本。Neon 在自己仓库里能省几轮、最高推理档能多做对几题、加速档能不能让开发者更早拿到可合并补丁,这几笔还得靠真实工单来算。
参考
- Gemini 4 Neon 的速度、价格与评测|The Decoder
- Gemini 4 Neon 的输出速度和任务耗时|DEV Community
- Gemini 4 Neon 的编程智能体和长上下文评测|MarkTechPost
- Gemini 4 Neon 的推理档位与实际费用|DEV Community
- Gemini 4 Neon 接入 Copilot|DEV Community
- Gemini 4 Neon 的多模态输入与上下文规格|The Decoder
- GPT-6.2 Astra 与 Sol 发布及跑分传闻核对|DEV Community
- GPT-6.2 接入 Vercel AI Gateway|DEV Community
- Qwen4-Max API 报价与 WebDev 排名|DEV Community
- Airbnb 如何按单任务成本运营编程智能体|AWS Machine Learning Blog
- 用交错对照验证 LLM 提速|DEV Community
- RTX 3050 8GB 上的 Gemma 4 E4B 实测|DEV Community
- 让 AI 复用仓库已有的站内路由组件|DEV Community
- 用五项对照测试验证 AGENTS.md|DEV Community
- 给 AI 编程加入无障碍与安全检查|DEV Community
- ReviewBot 的 HTML 与 SQL 输出处理案例|DEV Community
- 给编程 Agent 脱敏并保留代码语义|DEV Community
- AI 发布按钮究竟批准了哪一稿|DEV Community
- Azure OpenAI 与 OpenAI API 的 o3 退役日期|DEV Community
- 微软 Agent Framework 的两个 PyPI 版本遭投毒|IT之家
- 前端进阶之旅