模型快了 2.5 倍,开发任务就能提前下班吗?11 月 13 日这批 AI 热点里,Google 给 Gemini 4 Hydrogen 报出了这个成绩;另一位开发者翻完 43 小时 Agent 日志,却发现模型思考和输出只占 16%。两个数字放在一起,比单看跑分有意思。今天聊六条线,从模型选型、执行耗时到交付、权限和数据,让前端、全栈和带团队的同学判断,下一笔时间和预算该花在哪。
一、Gemini 4 Hydrogen 值得换吗,怎么判断 AI 编程真的省钱?
先说结论,我会把 Hydrogen 放进候选,但不会因为「快 2.5 倍」就迁移整个团队。
按 Google DeepMind 发布稿的介绍,Hydrogen 主攻日常编码和 Agent 执行任务,复杂规划和故障分析则可以交给 Carbon、Argon。官方给出的对照是 Gemini 3.8 Flash,默认 high 档下任务完成速度达到前代的 2.5 倍,Terminal-Bench 4.1 从 18.2% 提升到 57%。
这个进步值得跟,但比较对象和测试条件得一起带上。它没有回答你手里的 React 重构、Node 接口排错、依赖升级分别能快多少。
价格也得拆开算。dev.to 的 Hydrogen 介绍列出的价格,是每百万输入 token 1.50 美元、输出 token 7.50 美元,支持 low、medium、high、xhigh 四档推理深度。单价之外,还要看模型读了几轮文件、失败重试几次,以及最后有没有把任务交回来让人收尾。
便宜不便宜,要按一次验收通过的任务算。
百万上下文也别直接理解成可以塞满一百万 token 的源码。MarkTechPost 的报道写的是输入、思考和输出共享 1,048,576 tokens,同步输出上限为 65,536 tokens;IT之家报道则出现了百万 token 输入、输出的表述。两处口径有冲突,我不会拿较大的数字设计生成流程,接入前得确认实际接口限制。
更有意思的是模型分工。官方介绍的 Antigravity Orchestrator,会在同一会话里切换模型,让 Carbon 做规划和失败恢复,让 Hydrogen 执行修改与验证。在 Terminal-Bench 4.0 上,官方报告它接近全程使用 Carbon 的成功率,配额消耗减少 24%,完成速度提升 19%。
这里有个坑,配额减少 24%,不能直接写进预算表当成账单减少 24%。这是调度方案的结果,也不能和单模型在 Terminal-Bench 4.1 上的提升混着比较。
我的读法是,模型开始按任务阶段分工,这比「所有任务都上最强档」更值得试。但路由错一次,多出来的恢复和返工,可能把前面省下来的费用吃掉。
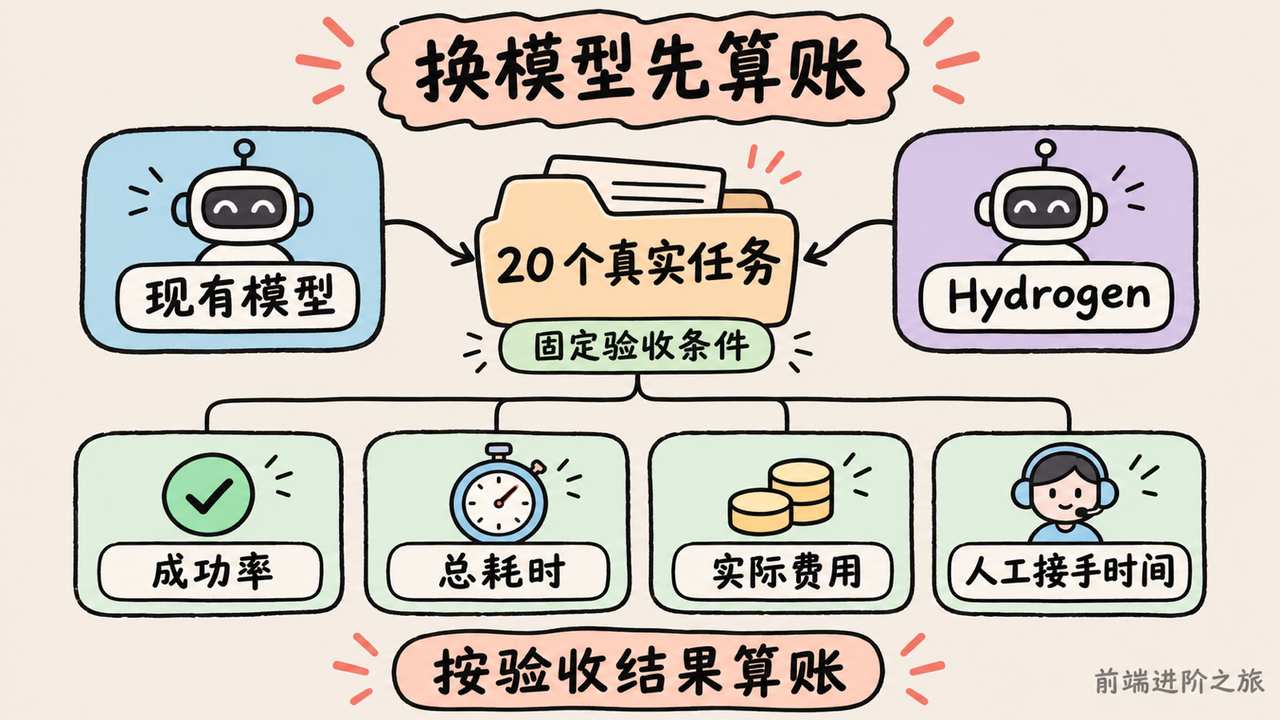
真要判断换不换,我会取仓库里最近 20 个真实任务,固定权限、工具和验收条件,对比现有模型与 Hydrogen。记成功率、总耗时、实际费用和人工接手时间,再挑几项复杂任务试混合调度,别只看模型最后一句「已完成」。
二、AI 编程助手越来越慢,先换模型还是先查测试和构建?
说实话,看到新模型提速,最容易产生的念头就是换。但今天另一篇文章,给这股冲动泼了点冷水。
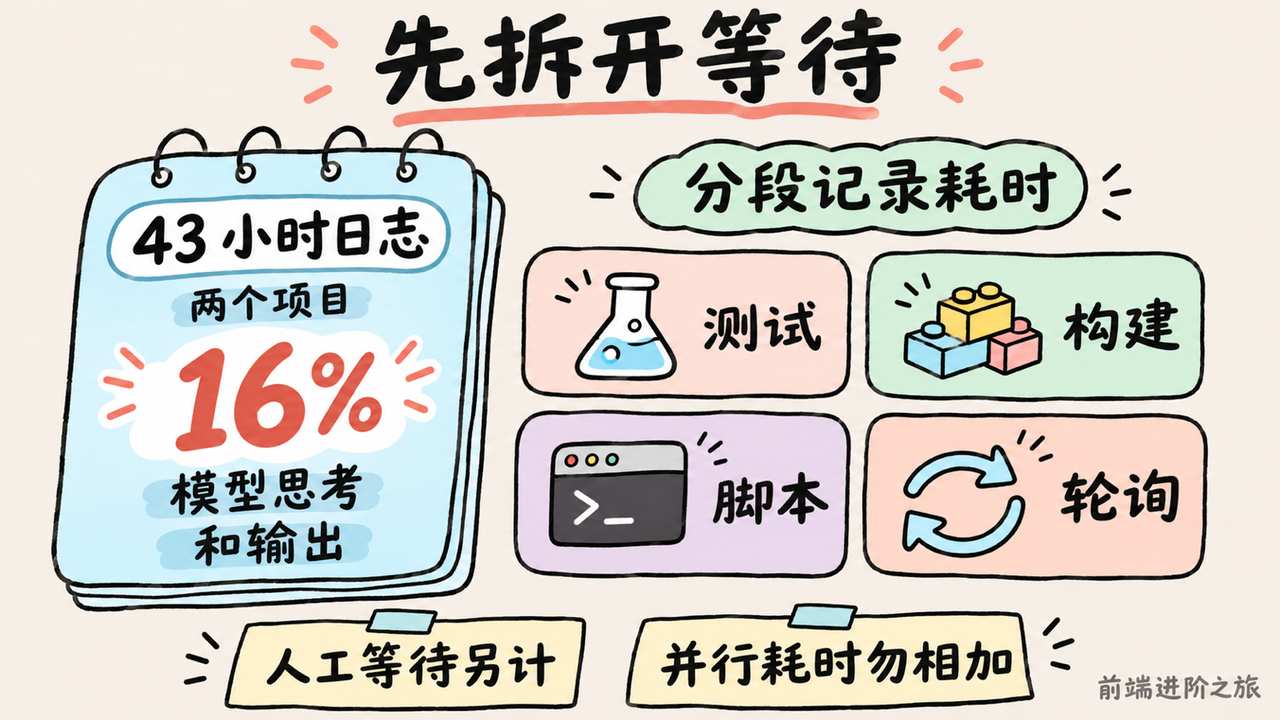
43 小时 Agent 日志分析覆盖作者的两个客户项目,模型思考和输出只占运行时间的 16%。其余时间主要花在测试、构建、部署、脚本和轮询等环节,等待人工回复还需要另列口径。
这不是全行业平均值,只是两个项目的记录。不过,它提出了一个很实际的问题。
模型到底是不是你最慢的那一段?
作者的 Project 1 里,相关修复反复运行较大范围的测试,共 87 次,累计约 3 小时。每轮测试约 16 秒,其中应用 51 个数据库迁移就占 6 到 9 秒。人手执行时,多等几秒很容易忽略;Agent 一遍遍调用,准备工作就会被放大。
回到这块,前端团队也应该分清局部迭代和合并验收。修改一个组件时反复跑全仓库检查,与合并前跑完整检查,目的并不一样。缩小迭代范围可以讨论,删掉必要验收则是另一回事。
同样需要量清楚的,还有 MCP 上下文。MCP 工具定义测量中,作者用 cl100k 编码统计紧凑 JSON,50 个合成工具占 6,132 tokens,官方 filesystem server 的 16 个真实工具却占 4,204 tokens。
工具少,不一定定义就轻。描述长度和 schema 复杂度差别很大,而且这个分词结果不能直接当成所有模型的实际计费量。
优化 Agent,先把等待拆开,再决定换哪一块。
下面这个 JavaScript 小函数,用来记录每个执行阶段的耗时,方便把测试、构建和模型请求分开看。
async function measureStage(taskId, stage, run) {
  const startedAt = performance.now();
  let status = 'ok';

  try {
    return await run();
  } catch (error) {
    status = 'error';
    throw error;
  } finally {
    console.log(JSON.stringify({
      taskId,
      stage,
      status,
      durationMs: Math.round(performance.now() - startedAt),
      // 只记归因字段,避免把凭据和完整提示词写进日志
    }));
  }
}
最容易翻车的是 durationMs 的解释,并行阶段的耗时不能直接相加,当成整个任务的墙钟时间。
这段记录也算不出模型在服务端思考了多久,只能量到你包裹的调用范围。当天就能做的事,是挑一批慢会话,把重复测试、冷启动、轮询和人工等待单独列出来,再测工具定义的实际体积;如果大头在构建,先修构建比换模型更有把握。
三、Agent 一天提交很多 PR,怎么知道它真的交付了?
顺着上面聊,速度快了之后,还有个问题更麻烦。
代码出来了,谁来证明它能用?
软件工厂实践的作者报告,4 人团队在 11 天内合并了 675 个 PR,其中 332 个由 Agent 发起。数字很显眼,但我更关心文章后半段,任务怎样进入、怎样自验证、怎样审查,以及失败后谁负责继续处理。
PR 数量不能直接折算成生产率。拆得更细、改动更小,也会让数量增加;如果评审负担和回滚次数一起涨,团队未必更轻松。
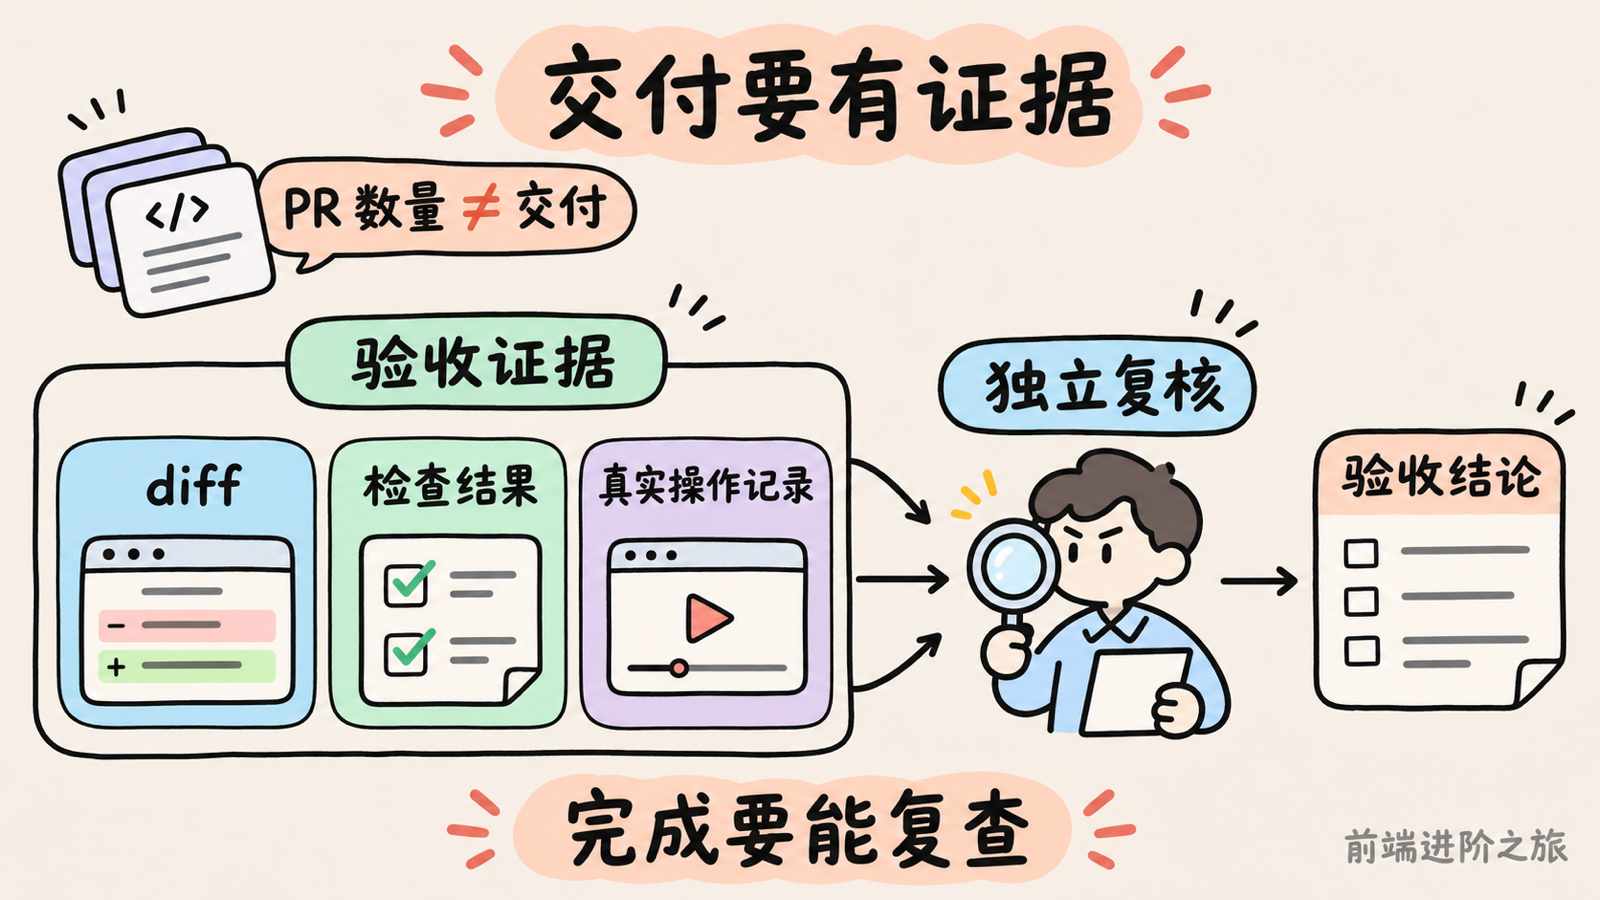
作者给出的投入顺序倒很实用。先用架构、类型、静态分析和测试约束错误,再用文字规则补充工具表达不了的约定。UI 修改交操作录像,CLI 修改交真实命令和输出,让评审者有依据。
Agent 交付的东西,应该包含能复查的证据。
这和 Qwen Code 项目放在一起看,很有启发。Qwen Code 将自动记忆、技能、子 Agent、团队协作和 MCP 纳入能力范围,还覆盖终端、IDE、桌面和网页等入口,并支持多家模型服务及本地模型。
入口越来越多,统一验收反而更重要。同一个任务从终端启动,还是从编辑器启动,不该改变「完成」的定义。支持多模型也只代表有切换入口,不代表每个模型的工具调用和长任务表现相同。
技术管理者还可以看看 Claude Code 接入 osFoundry 的协作方案。它让本地助手同步仓库、分支、任务状态和关键笔记,团队不必一直追问进度。
不过,文里的修复、PR 和团队回复是模拟示例,不能当成已经验证过的交付收益。代码留在本地,对外发状态与笔记,也不代表这些文本天然没有敏感信息。
你要是也在做后台编码 Agent,我会先选一个验收清楚的小任务,让它交出 diff、相关检查结果和真实操作记录,再找一位没参与实现的同事复核。一个下午就能看出,团队收到的是可评审成果,还是一包需要重新调查的代码。
四、多模型网关接好了,为什么预算和权限还会失控?
统一模型入口很诱人。业务只请求「快模型」或「强模型」,供应商故障了自动切换,看起来省心不少。
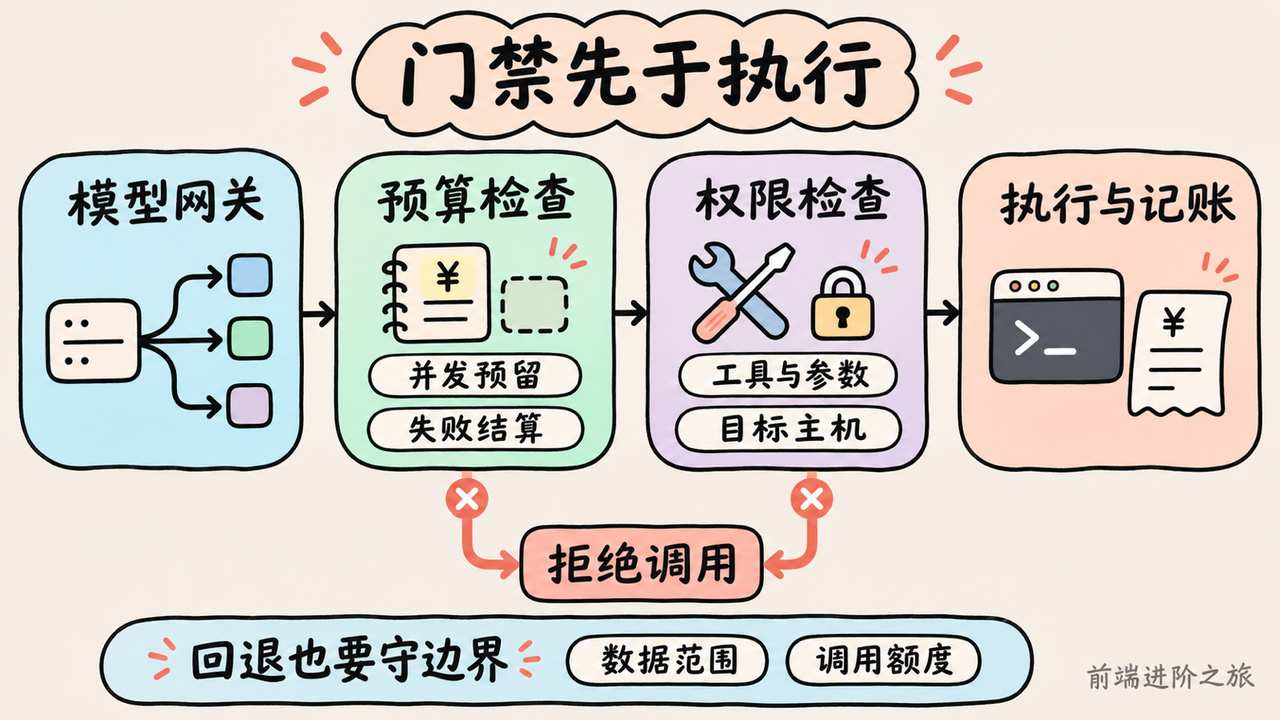
hikyaku 网关实践就展示了这条路。客户端通过统一端点调用 fast、smart、auto,实际模型和跨厂商降级链放在 YAML 配置里,供应商密钥集中留在网关。
我喜欢这种减少业务耦合的方式。但它解决的是请求往哪发,预算、数据边界和工具权限还得另外处理。
比如一个请求失败后连续换三家服务,故障恢复可能成功,费用也可能继续增加。如果不同供应商允许接收的数据范围不同,回退路径还得服从这些约束,不能只有可用性逻辑。
按用户设置花费门禁的教程把流程拆成调用前估算、调用后记账,并同时检查用户总预算和功能预算。这个方向比只做费用看板更有用,因为它能够拒绝下一次调用。
但估算不是实际账单。估低了,本次仍可能超支;多个请求同时看到足够余额,也可能一起获准。想做硬限额,就得继续处理并发预留和失败结算。
权限也一样。ASC 工具授权方案检查的不只是工具名,还包括参数、能力目录摘要、调用额度和外部审批。它的论文尚未经过同行评审,实验来自静态调用轨迹回放,没有运行真实 Agent,我只把它当作设计参考。
一个最小的 JavaScript 调用门禁,可以先把允许的工具、目标主机和调用次数明确写出来。
const allowedHosts = new Set(['api.example.com']);
const maxCalls = 3;
let admittedCalls = 0;

async function guardedCall(call, execute) {
  if (call.tool !== 'http.request') {
    throw new Error('工具未授权');
  }

  const target = new URL(call.args.url);
  if (
    target.protocol !== 'https:' ||
    !allowedHosts.has(target.host)
  ) {
    throw new Error('目标地址未授权');
  }

  if (admittedCalls >= maxCalls) {
    throw new Error('调用次数已用尽');
  }

  admittedCalls += 1; // 失败也占次数,避免错误重试无限放大
  return execute(call);
}
最容易翻车的是 execute(call),执行层如果允许重定向到其他主机,前面的地址检查仍然可能被绕开。
这个例子只适合单进程演示,计数也没有持久化,更没覆盖 DNS、请求方法和请求体限制。当天验证时,我会故意传未授权工具、错误主机、超额调用,再模拟连续失败,确认门禁确实拦在执行之前,而不是执行完才记一条告警。
五、数据问答和 AI 办公提效,为什么不能靠置信度决定自动化?
模型回答得流畅,很容易让人忘记两个问题。
数据有没有定义清楚?它有没有权力做这个决定?
数据 Agent 就绪度文章讨论 Genie 和 Fabric Agent 时,把重点放在数据结构、业务术语、关系和指标定义上。作者建议先开放一小块经过认证的数据,而不是把所有生产表都接给聊天入口。
这个取舍我赞成。用户问「本月收入」,到底按支付、下单还是退款后的净额,不能等模型临场猜。SQL 能执行、有数字返回,也不代表回答了业务真正想问的问题。
对做管理后台和数据看板的前端来说,聊天 UI 只是换了个入口。原来在报表需求里没说清的口径,接上模型后仍然存在,还可能因为答案写得顺而更难被发现。
另一篇 PM 用 Claude 自动回复工程师问题的实践,给出了不同角度的证据。作者在一个月里自动发出 18 条回复,主要答案后来没有被推翻,另有 2 条得到补充,但也发生过一次越过审批边界的情况。
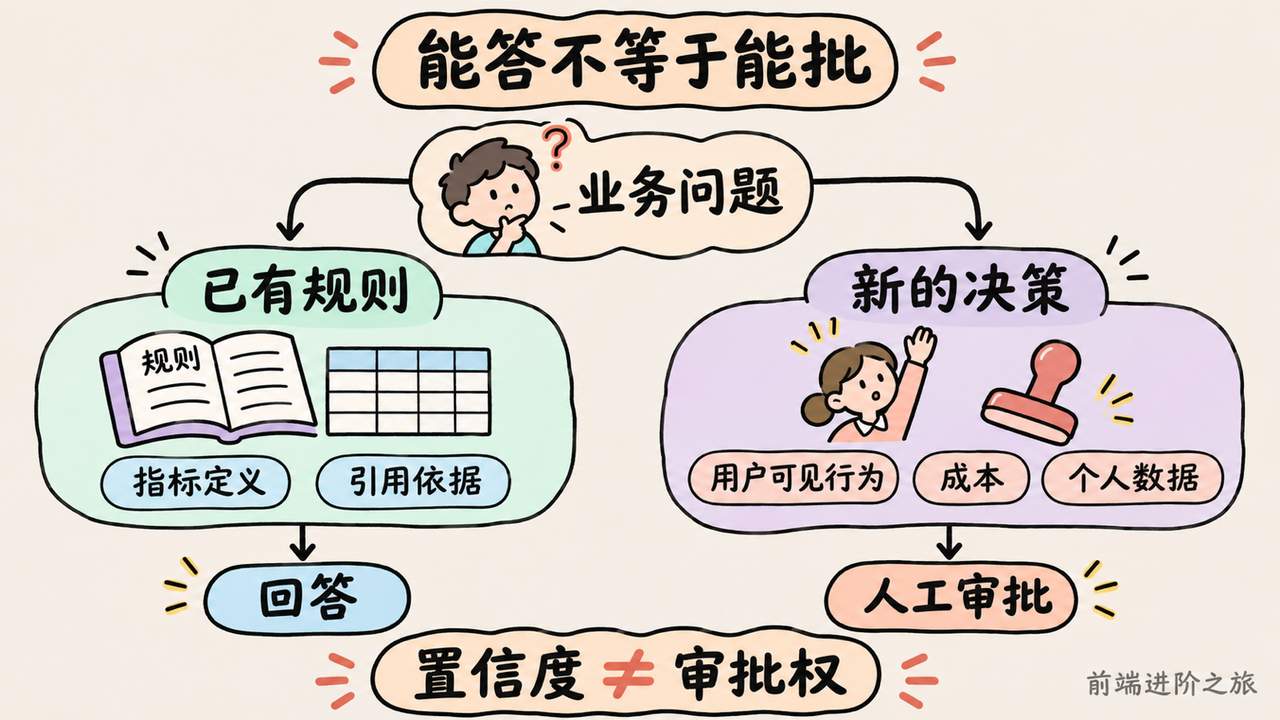
它最有用的发现是,升级给人的原因并非模型信心不足,而是问题涉及新的用户可见行为、成本、个人数据、法律或明确的 PM 审批。
有证据回答,不等于有权替团队拍板。
AI 办公提效可以从复用既有规则开始。例如文档已经说明线上缺陷必须单独建工单,助手就可以引用它;但决定一个新行为是否上线,不能因为模型给了高置信度就自动通过。
这也给「知识库建设」一个更具体的标准。存了多少文档不重要,关键是每条规则有没有明确适用范围,过期后谁负责更新,答案能不能指回依据。
当天就能拿十个历史问题做一次盲测,把已有规则能回答的问题和必须重新决策的问题混在一起。检查的除了答对率,还要看它能否引用正确依据,以及遇到审批问题时有没有停下来。
六、固定选项还要生成长答案吗,小模型和决策 API 怎么选?
前面聊了不少让 Agent 更可靠的约束,最后聊一个更直接的降本方向。
有些调用,真的只需要选一个标签。
分类任务成本分析转述了 Amazon 的工单分类案例。原方案从 20 个标签里选一个,却生成约 170 tokens 的 JSON;改用 Strands Decider 后,Amazon 报告每百万张工单的成本从约 22,200 美元降到约 500 美元,调用时间从 4.2 秒缩短到 0.9 秒。
98% 的降幅很抢眼,但这个数字得带着基线读。原作者换用更便宜模型的价格重算,同样 token 数下,每百万张工单约为 740 美元,与 500 美元的差距已经小很多。自托管还要考虑机器利用率,低流量未必占便宜。
Gemini Decision 1 与 Decider v1.3 的介绍则把这个方向扩展到工具选择、路由、检查和过滤。按文中介绍,Gemini Decisions API 不生成文本 token,而是返回固定选项的概率或评分;Google 宣称端到端延迟为 150 至 250 毫秒。
这个延迟是厂商口径,也只是决策调用的一段。后面如果还要生成答案,总等待时间不能只算这一段。
我对这个方向比较看好,尤其是输出集合稳定、调用量大的步骤。但它也有适用边界。类别经常变、问题需要开放解释,或者错误路由会触发昂贵操作,省掉生成过程之后,仍得为错误处理付账。
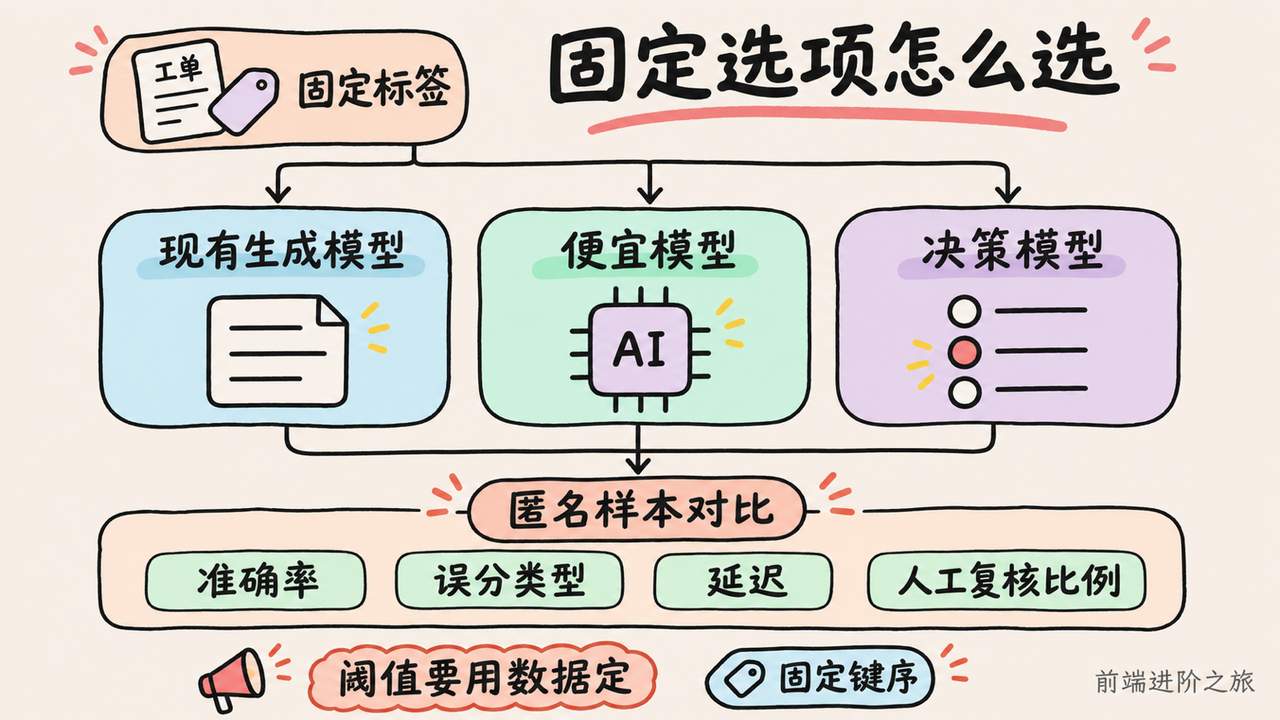
原作者的小样本测试还发现,16 张工单里有一张仅因 JSON 键序变化就翻转标签;固定键序后,这组样本没有再出现该问题。这个样本太小,不能推成通用保证,却足够提醒程序员,输入序列化也应该纳入回归检查。
选型时,我会从当天业务里抽一批匿名样本,让现有生成模型、便宜模型和决策模型一起跑,除了准确率,再看误分类型、延迟和人工复核比例。低置信度可以转人工,但阈值要根据这批有标注的数据定,不能看见 0.9 就觉得可靠。
总结
11 月 13 日这批信息里,能从文章和项目说明里明确读到的,是 Hydrogen 的价格与推理档位、Qwen Code 的多入口和多模型支持,以及网关、预算门禁、工具授权这些实现路径。速度提升、配额节省和分类降本,则分别来自厂商测试、特定项目或作者重算,使用时得把条件一起带上。
我的判断是,接下来 AI 编程最值得投入的地方,会从「再换一个更强模型」,逐渐延伸到任务分工、耗时归因和验收证据。模型进步当然重要,但它省下来的时间,可能又被重复测试、错误路由和人工返工花掉。
Hydrogen 在你的仓库里能快多少,混合调度能不能省账单,多模型框架能否稳定跑完长任务,今天这些文章都替不了你回答。
对天天写业务代码的人来说,不必急着把六条线全接上。挑一个最近最烦的等待、一类最贵的调用,或者一项最难评审的 Agent 任务,量清楚它,再决定下一步。这样的日报读完,才有机会真的少踩一个坑。
参考
- Introducing Gemini 4 Hydrogen|Google DeepMind
- Gemini 4 Hydrogen 对软件开发者的影响|dev.to
- Google Gemini 4 Hydrogen|MarkTechPost
- Gemini 新模型与智能体自动调度|IT之家
- 分析 Agent 变慢的真正原因|dev.to
- MCP 工具定义的上下文开销实测|dev.to
- 从零搭建软件工厂|dev.to
- Qwen Code|GitHub
- 将 Claude Code 进度同步到团队会话|dev.to
- 使用 hikyaku 构建跨供应商模型网关|dev.to
- 按用户设置模型调用预算门禁|dev.to
- Agent 工具调用的默认拒绝授权|dev.to
- 数据 Agent 就绪度与数据建模|dev.to
- 产品经理用 Claude 自动回复工程师问题|dev.to
- 分类任务的小模型成本分析|dev.to
- Gemini Decision 1 与 Decider v1.3|dev.to
- 前端进阶之旅