1.6 万亿参数的 Agent 模型开放权重,每个 token 却只激活约 480 亿参数;数学榜首的测试成本,又能达到另一款模型的 15 倍。看完 2026 年 11 月 15 日这批 AI 热点,我更在意的已经不是模型能多答对几题,而是接进业务之后,谁来管资源、权限和失败。今天沿着模型选型、仓库验收、故障分流、流式交付、工具安全、团队规则六条线聊,给写代码和带团队的同事留几把能直接用的尺子。
一、万亿参数模型开放了,AI 编程选型该看什么?
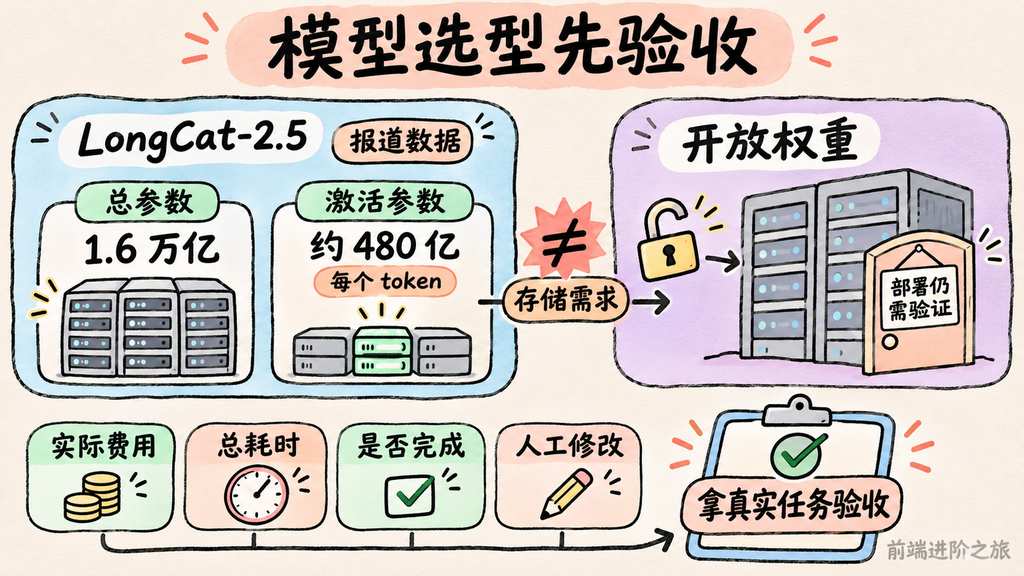
先说结论,美团开放 LongCat-2.5 权重值得关注,但距离我们给项目换一个默认模型,中间还隔着部署、任务适配和验收。
据 The Decoder 的报道,LongCat-2.5 采用 MoE 架构,总参数 1.6 万亿,每个 token 约激活 480 亿参数,完全使用国产硬件训练。报道给出的 Terminal Bench 成绩为 88.4,示例部署使用 194 颗华为昇腾芯片。
这几个数字得分开读。
激活参数描述每次计算调用多少参数,不代表只需要存储这部分权重。示例里的 194 颗芯片,也不能当成所有部署方式的最低配置,不过已经足够提醒个人开发者,开放权重和轻松部署是两回事。
通过 API,它支持最高 100 万 token 上下文、最长 12.8 万 token 输出,并接收文本、图片和视频。对编程 Agent 来说,读更多文件、带着截图分析页面,确实有用。但窗口够大,只能说明装得下,不能证明模型能从大量材料里持续找对重点。
开放权重增加了选择,不等于已经证明可以替换现有编程助手。
同一天另一条模型消息,正好把选型的另一面摆出来。MathArena 相关报道称,Gemini 4 Carbon 排名第一,Claude Fable 5.2 第二;在测试采用的推理设置下,两者成本分别约为 GPT-6.1 Sol 的 15 倍和 40 倍。
这里的倍数是那次测试的成本关系,不能改写成 API 单价。报道也没给出完整分数、领先幅度和成本拆解。Carbon 还出现过启动脚本后运行超过 11 小时、期间没有检查进度的案例。对于要按时交付的程序员,这类行为比多一道数学题更贴近日常风险。
说实话,我愿意为更高的成功率付钱,但得先知道多花的钱买到了什么。数学排名不能替我们回答,模型会不会乱动公共组件、能不能保留测试、是否会及时停掉没有进展的命令。
Opus 5.5 提示指南的报道也在劝用户从 Medium 推理强度起步,再按需要提高。这是厂商基于内部测试给的建议,不能直接套到所有任务,不过很适合提醒我们,推理强度拉满也要算账。
真要判断换不换,我会挑几件当天能验收的小任务,固定仓库版本、权限和测试命令,记录实际费用、总耗时、是否完成,以及人工还改了多少。高难任务可以单独测,别让一次漂亮发挥替整套工作流做决定。
二、AI 编程助手怎么测,才不会被漂亮回答骗过去?
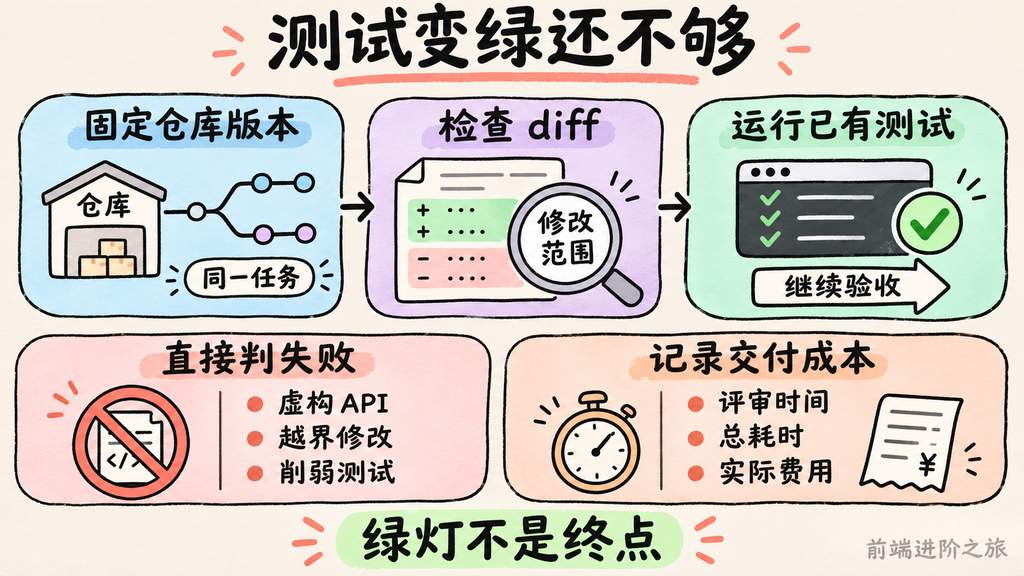
顺着上面聊,选型最容易失真的地方,是我们拿聊天表现判断交付能力。
一个助手能把方案讲得很顺,却可能在提交里新增已有工具函数的替代品;另一个回答很短,改动却刚好符合项目习惯。前者更容易在演示里赢,后者可能更省评审时间。
真实仓库评估文章给的办法比较朴素。在熟悉的仓库里,用独立 Git worktree 或一次性克隆做试验,保留真实目录、测试和工程约定,同时排除密钥、生产连接串等内容。
任务也别全是从零写页面。解释熟悉模块的边界、修复可复现失败、按现有风格做小改动、遵守文件修改禁区,这几类更容易暴露助手到底有没有理解项目。
看结果时,先看 diff 和文件状态,再亲自运行已有测试。虚构 API、跳过测试、越界修改文件,都应该直接算失败。
测试通过只是起点。
这与 LongCat-2.5 的训练设计有个值得对照的地方。其训练任务来自真实 GitHub 仓库的 pull request,也包括重建的失败案例;环境禁止联网,移除 Git 历史和缓存,再检查模型是否取巧。
两者都在处理同一个麻烦,任务显示成功,未必说明模型靠正确方式解决了问题。团队评估时如果允许助手删掉失败断言,那测出来的就是谁更会绕过验收。
再看 dspy-wsp 的实验报道,这种区分同样重要。它让强模型读取小模型权重、编写补丁,再通过有限次数的前向评估检查效果,不使用梯度。报道中的单次运行成本约 5 至 10 美元,但这还是原型,不是花几美元就稳定提升任意模型的服务。
原文引用的研究里,Qwen3.5-0.8B 有明显提升,Gemma 3 270M 的提升却很有限。作者也指出,修改可能解除已有能力的障碍,未必能补出原来没有的能力。拿最佳案例去推整体效果,和拿一次优秀代码生成去定全年采购,问题很像。
我更愿意用一份固定记录比较候选,避免试完只剩一句「感觉挺聪明」。
const evaluation = {
  commit: "固定的仓库提交",
  task: "修复已有复现步骤的分页缺陷",
  acceptance: {
    requiredTests: ["现有分页测试", "现有类型检查"],
    forbiddenPaths: ["src/auth/", "infra/"],
    testWeakeningAllowed: false, // 删断言换通过,直接判失败
  },
  result: {
    testsPassed: null,
    changedFiles: [],
    scopeViolation: null,
    reviewMinutes: null,
    elapsedSeconds: null,
    actualCost: null, // 费用与结果一起看
  },
};
最容易翻车的是 testsPassed,它不能覆盖越界修改和削弱测试,所以这些字段得分别检查。
这份记录也不需要做成大平台。当天拿同一个 commit 跑两三个任务,就能开始比较。任务少时别急着宣布谁更强,先淘汰那些连修改边界都守不住的候选。
三、CI 变红和页面白屏,该重试还是让 AI 改代码?
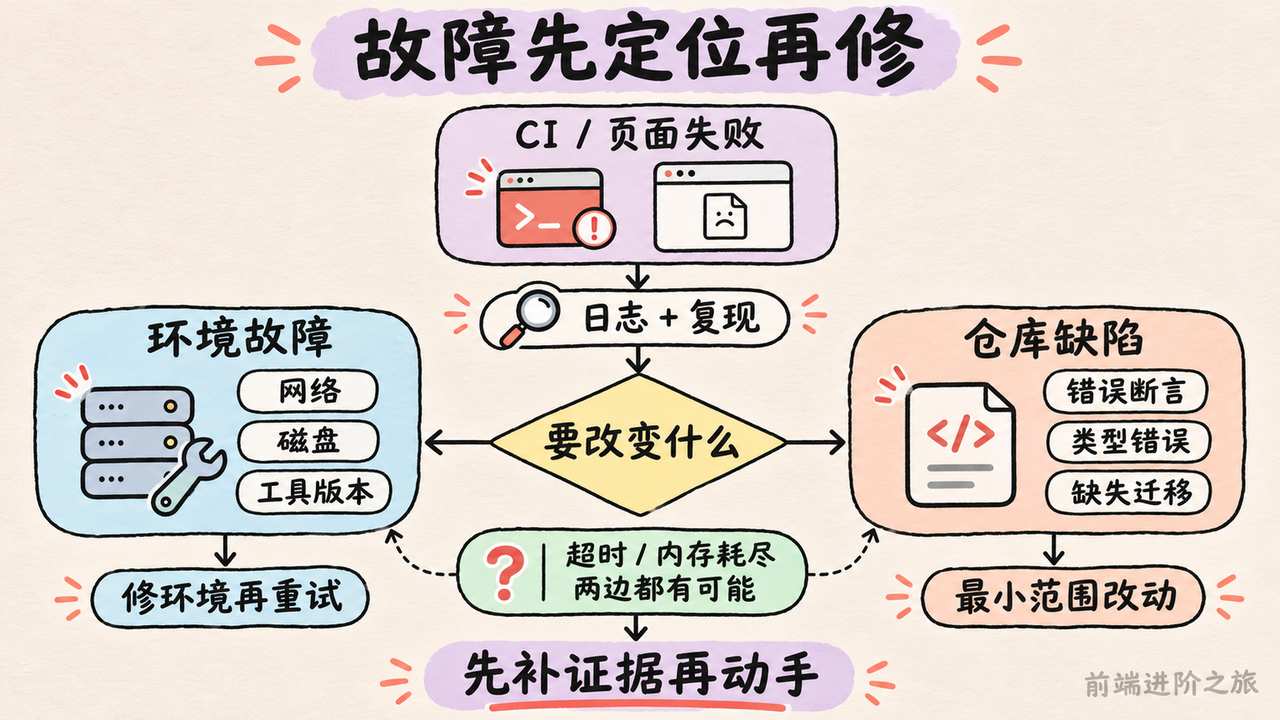
大概率你也遇到过,日志里明明写着依赖下载失败,助手却开始改构建配置;页面请求被拒绝,它又重写了一遍组件。
问题还在原处,diff 多了一堆。
CI 故障分流文章把责任分得很清楚。机器、网络、磁盘、内存和运行环境工具版本出问题,由基础设施层处理;错误断言、类型错误、缺失迁移,以及仓库里的配置缺陷,才需要开发者或 Agent 修改。
判断依据是要改变什么。安装过程碰上网络抖动,修环境再跑同一份代码有意义;测试断言写错,重复运行不会把它变对。
但也别给日志关键词配一个过于自信的分类器。超时可能是 Runner 太忙,也可能是代码进入死循环。内存耗尽可能需要调整执行资源,也可能来自程序持续保留对象。错误名提供线索,复现和上下文才能决定处理方向。
原文引用 CI Doctor 的目录统计,共有 4,555 条故障签名,其中 760 条带环境分类,3,795 条未分类。这个数字统计的是不同错误模式,不是实际发生次数。某种网络错误一个月触发几百次,也仍然可能只占一条签名。
所以不能拿这组计数,推断自家 CI 只有约六分之一的失败来自环境。
Lovable 修复循环的文章讲的是同一种误分派。连续点修复之前,要确认 AI 有没有拿到真实控制台错误、后端日志,以及失败涉及的配置。Supabase 权限策略、缺失的 secret、过期 API key,都可能表现成前端操作失败。
故障没定位,自动修复越积极,可能带来的返工越多。
回到这块,我赞同给盲修设置上限,但不把「试两次」当成普适定律。关键是第二次尝试有没有增加证据。如果只是换句话要求它继续修,往往只是在追加补丁。
这也直接影响成本。调用费是一部分,新增改动的评审、回归和回退也要花时间。一个权限错误诱导出五个页面文件的修改,比报错本身更难处理。
今天就能做的验证,是选一条近期失败的流水线和一个可复现页面错误,让助手先指出故障层、证据和最小修改范围,再允许动手。它如果无法解释为何需要改仓库,就先补日志,而不是继续给修改权限。
四、Agent 接上 SSE,为什么还不能算交付完成?
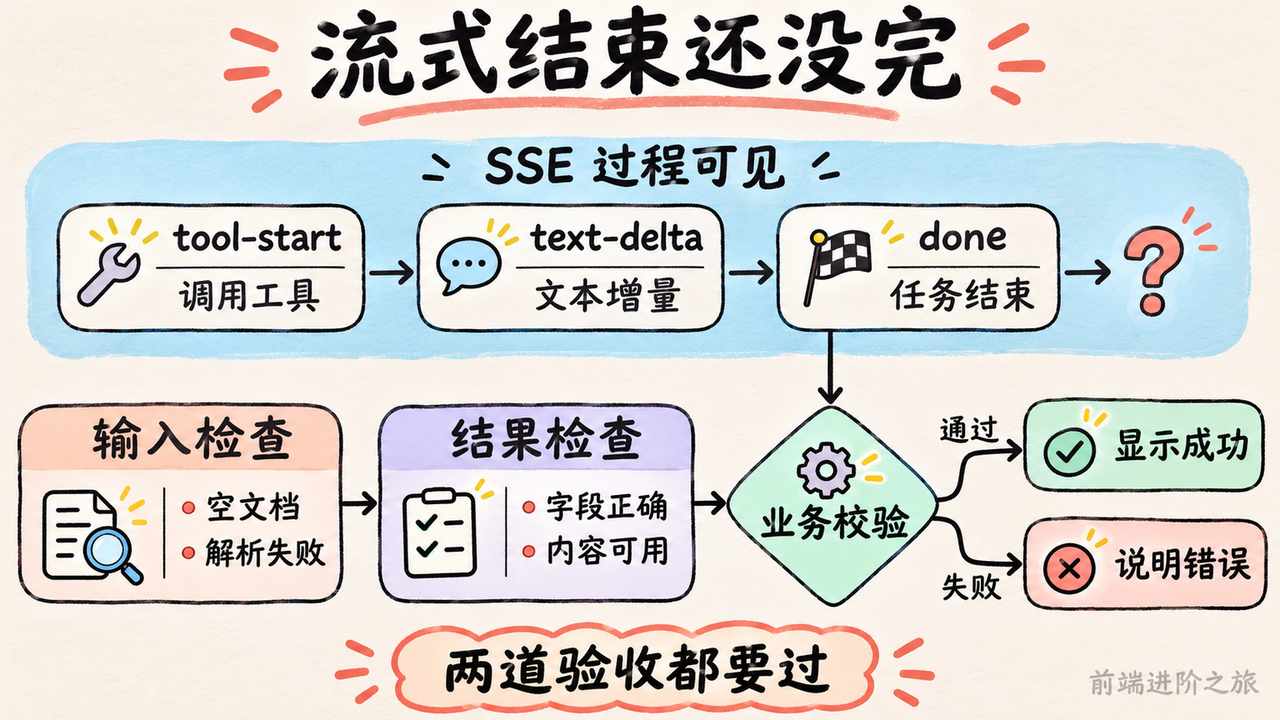
你要是也在做网页里的 Agent,大概很快就会发现,一个转圈的加载图标装不下整个执行过程。
它在查资料、调用工具,还是已经卡住?最终返回一句失败,前端能不能说明是哪一步出了问题?这些问题不只关系体验,也决定用户会不会重复提交任务。
FastAPI 与 SSE 的教程提供了一条服务化路线,用请求模型做校验,以异步生成器持续产出事件,再通过 StreamingResponse 返回事件流。
其中三个事件很适合前端理解,tool-start 表示开始调用工具,text-delta 表示文本增量,done 表示任务结束。界面终于可以分别展示过程,不必把所有等待都写成「正在思考」。
不过,路由写成异步,不代表内部每个依赖都不会阻塞;流式响应配了防缓冲头,也还需要经过实际部署链路检查。教程摘要没有完整部署验证,我会把它当改造路线,不会直接当上线答案。
另一个容易漏的点是,流里有内容,不代表业务上拿到了可用结果。
文档转测验工具的复盘把这个问题讲得很具体。扫描 PDF 可能提取不出文本,文件声明类型可能不可信,解析库升级也可能破坏原接口。输入阶段只判断上传成功,后面就可能把空内容交给模型。
输出也一样。合法 JSON 不保证字段正确,更不保证题目可用。作者仍然要校验结果,并允许用户逐题编辑。这里我很认同,降低修正成本,通常比要求一次生成完美更实在。
过程能流出来,和结果能交出去,是两道验收。
对 AI 办公提效产品尤其如此。用户上传资料、等待生成,最后需要的是可检查的题目、文档或查询结果,不是一段看起来很忙的过程动画。
想先低成本验证数据问答,还可以参考 Datasette 本地模型接入文章。datasette-llm 0.1a11 新增兼容 OpenAI 的接口支持,示例通过 LM Studio 让本机模型驱动 Datasette Agent 查询数据库。接口兼容降低了接入工作量,但不能保证不同模型的工具调用和回答质量一样。
当天做验证,我会把空文档、正常文档、解析失败和中途报错各跑一次,观察页面最终停在哪个状态。done 到来后还要检查结果是否通过业务校验,别让用户对着错误内容看到一个绿色成功提示。
五、工具调用 JSON 修好了,为什么反而更危险?
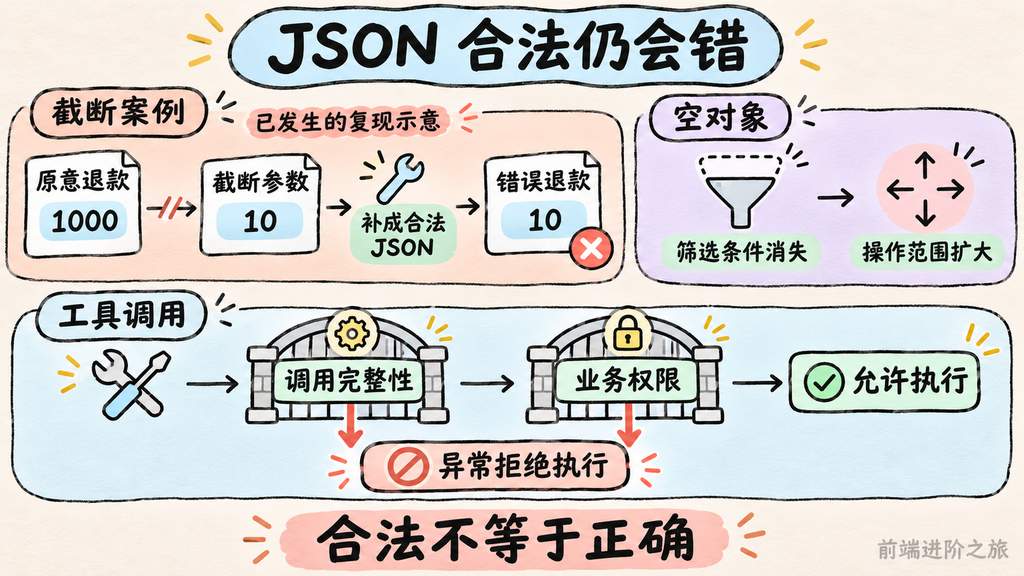
这里有个坑,做普通数据展示时,宽松解析可能帮我们保住半份内容;一旦解析结果要触发退款、发邮件、关闭工单,这种容错就可能替用户做错事。
工具调用截断案例报告了两个开源项目中的问题,相关问题均已修复。一个复现里,模型原本要写退款 1000,参数停在 10 时达到输出上限,JSON 修复器补齐结构后,工具实际执行了退款 10。
另一个复现更麻烦。参数解析失败后,程序用空对象继续调用工具,客户筛选条件消失,带默认参数的关闭工单操作扩大到了所有客户。
不是少执行一点,而是可能执行得更多。
这也解释了为什么只做 schema 校验还不够。截断的 10 被补成合法数字之后,字段和类型都可能正确,错误藏在调用尚未完成这件事里。工具执行前,需要检查接口返回的终止原因,以及调用是否完整。
另一方面,完整调用也可能越权。客服折扣实验里,10% 上限只写进提示词,工具直接接受模型传来的百分比,最终在本地演示中执行了 100% 折扣。这里是虚构商城实验,不能写成真实商家事故,但它暴露的代码缺口很清楚。
我会把完整性和业务权限分两层拦,下面是对应的 JavaScript 校验示例。
function validateDiscountCall(call, order) {
  // 本例只处理使用 finish_reason 的响应结构
  if (call.finish_reason !== "tool_calls") {
    throw new Error("调用未正常结束,拒绝执行");
  }

  // 严格解析,不修补残缺参数
  const args = JSON.parse(call.arguments);
  const percent = args.percent;

  if (!Number.isInteger(percent) || percent <= 0 || percent > 10) {
    throw new Error("折扣超出允许范围");
  }
  if (order.discount !== 0) {
    throw new Error("订单已有折扣");
  }

  return { percent }; // 校验通过后仍需检查订单操作权限
}
最容易照抄出错的是 finish_reason,不同接口的终止字段和正常结束条件不同,不能只判断「不是 length」就放行。
再往外看,文件读取与外发工具实验展示了路径越界读取和任意 HTTP 外发如何组合成泄露通道;隐藏网页指令实验则演示,助手总结页面时,可能执行页面里夹带的邮件发送要求。
这两篇都是受控的虚构应用实验。它们不能说明所有模型都会中招,却足够说明,文件范围、外发目标和发送授权得由代码控制,不能只期待模型遵守提醒。
今天最值得补的测试,不一定是再写十条正常提示词。给工具调用喂一段截断参数、一个空对象、一个超限金额,再让它读一页夹带额外操作要求的内容,确认业务操作有没有被拦住。测试时用假数据和本地接收端,重点看工具实际做了什么。
六、AGENTS.md 写了,为什么团队里的 Agent 还是各干各的?
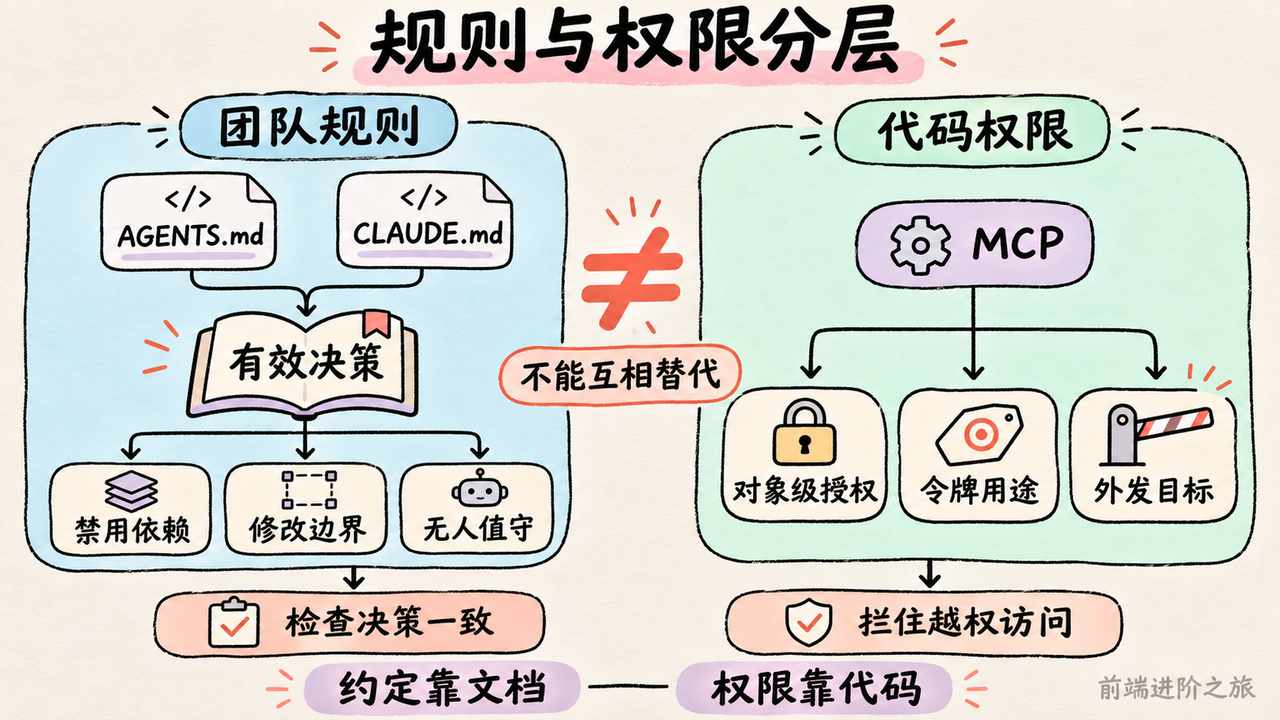
模型、服务和工具都有了,团队协作还可能卡在一件很普通的事上,大家遵守的规则不是同一份。
中型团队编程 Agent 文章用一家 45 人公司的情境展开,多个团队各自配置助手,不同仓库的 CLAUDE.md、AGENTS.md 内容冲突,禁用依赖的决定却只留在会议纪要里。
30 至 70 人这个范围是作者的经验性划分,不是经过对照实验验证的组织规律。不过,规则留在聊天里、入口文件相互矛盾,这种问题不需要等团队长到某个人数才会出现。
我的读法是,入口文件应该告诉 Agent 去哪里找有效决策,别在多个文件里复制整套规则。否则一项约定改了,漏掉一个副本,助手就能拿着过期依据继续干活。
不过,文档统一还解决不了执行权限。
MCP 安全靶场文章把工具描述注入、令牌透传、对象级授权缺失放进同一个可切换实验。尤其是对象级授权,服务器确认调用者是谁之后,还得检查目标记录是不是允许这个人访问。
把「禁止读取其他客户数据」写进仓库规则,不能代替接口里的归属校验。令牌签名有效,也不能代替检查它是否签发给当前服务使用。
工具描述同样需要警惕。它看起来像配置,却也会进入模型上下文。这个靶场中的模拟 Agent 在完成加法、返回正确答案的同时,还可能按恶意描述执行额外行为。作者使用了桩 Agent,所以这部分不能证明真实模型的注入成功率,但非常适合验证调用链路和拦截位置。
团队规则负责说明约定,应用代码负责守住权限。
两边都需要有人维护。前者决定哪些依赖禁用、修改边界在哪里、哪些任务可以无人值守;后者决定用户能读哪条记录、工具能向哪里发数据、谁可以执行有副作用的操作。
我赞同文章里用一个团队、一个仓库试跑的方向,不过别只统计生成代码量。选一个当天能完成的小改动,让不同助手读取相同规则,检查它们引用的决策是否一致;再用测试账号访问一条不属于自己的记录。前一项查规则有没有到位,后一项查规则失效时系统能不能兜住。
总结
这批消息里,具体的变化不少。LongCat-2.5 开放权重,Datasette 的插件新增兼容接口,dspy-wsp 给出了直接修改权重的原型路径。相关报道还给出了模型评测成本、工具调用截断问题,以及多个安全实验。
但这些证据的分量不同。榜单成绩对应特定评测和推理设置,靶场结果对应受控环境,教程路线也还需要经过自己的部署链路。它们都值得看,谁也不能替我们完成项目验收。
我的取舍很明确,模型可以继续试,接入速度也可以继续提,但验收、权限和失败处理要一起往前走。否则省下的生成时间,很容易花回评审、排错和回退里。
万亿参数模型能不能降低你们的交付成本,更高推理强度能不能减少返工,统一仓库规则能不能让团队少吵几次,目前都得拿自己的任务验证。
今天真要动手,我会先拿一个真实小任务跑候选,再给一个有副作用的工具补异常输入测试。前者告诉我们 AI 编程到底帮了多少,后者确认它出错时,业务还守不守得住。
参考
- 美团开放 LongCat-2.5 模型权重|The Decoder
- Gemini 数学登顶与测试成本争议|The Decoder
- Opus 5.5 提示与推理强度建议|The Decoder
- 在自己的仓库评估 AI 编程助手|dev.to · AI
- dspy-wsp 与权重空间编程|MarkTechPost
- CI 基础设施自愈与 AI 代码修复的分工|dev.to · AI
- Lovable 陷入修复循环后如何排查|dev.to · AI
- 用 FastAPI 和 SSE 封装 Agent 服务|dev.to · AI
- 文档转测验工具的输入输出问题|dev.to · AI
- Datasette 接入本地大模型|Simon Willison
- 输出截断后执行残缺工具调用的风险|dev.to · AI
- 折扣上限为何必须由代码校验|dev.to · AI
- 文件读取与 HTTP 外发组合导致密钥泄露|dev.to · AI
- 网页隐藏指令诱导 Agent 外传笔记|dev.to · AI
- 中型研发团队的编程 Agent 协作规则|dev.to · AI
- 可运行的 MCP 安全靶场与修复验证|dev.to · AI
- 前端进阶之旅