把 AI 编程智能体的历史输出删掉三分之一,计算量反而涨了。11 月 4 日读到的一篇研究解读里,提示词累计用量减少 33.3%,未缓存预填充却增加了 608.5%。先别把它读成账单涨了六倍,它测的是特定实验里的重新计算量。但这个反差很适合今天的主题。工具正在学会合盖后继续干活,团队却还得回答几个老问题。到底省没省钱,权限有没有越界,任务算不算完成?今天沿着六条线聊,给前端、全栈和带团队的同事留下一套选工具、算成本和验结果的判断办法。
一、AI 编程 Agent 合盖还能跑,任务该怎么交出去?
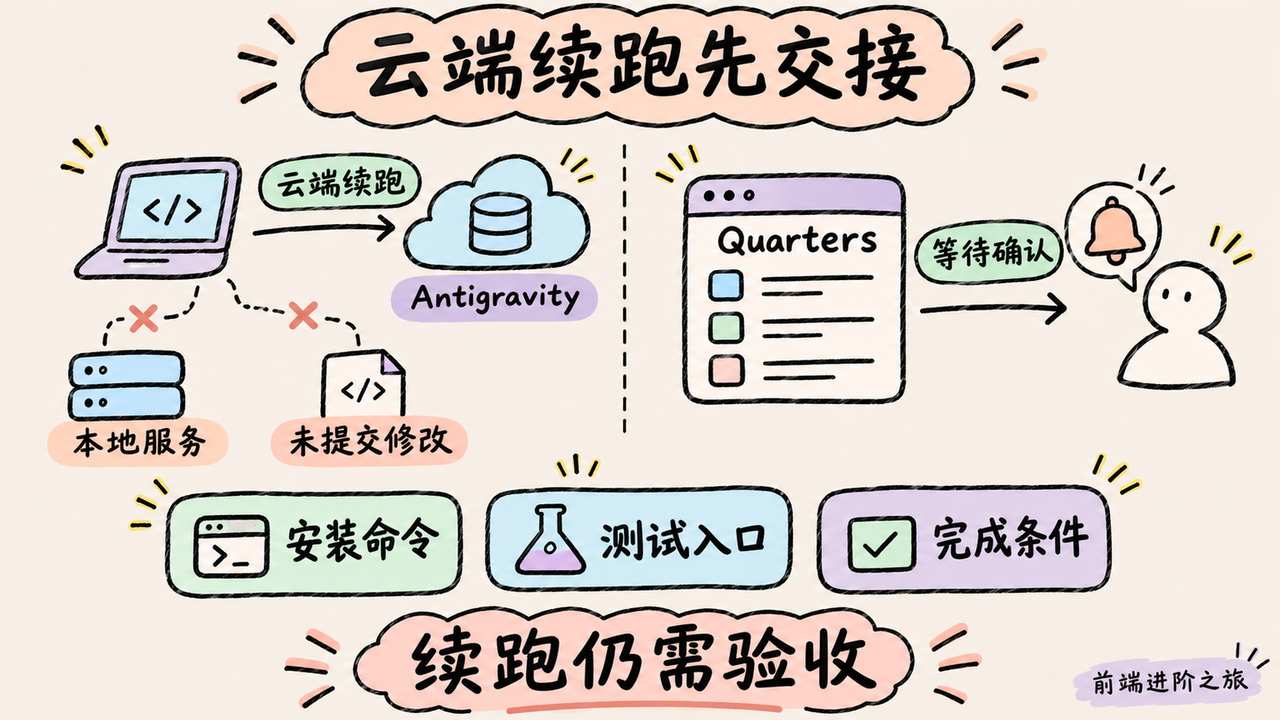
先说结论,我更关心云端 Agent 能接走什么任务,而不是它能连续跑多久。
据 Antigravity 更新解读,Remote agents 把云端项目会话放进 Google 管理的隔离环境。浏览器关掉、电脑休眠,任务仍能继续。资源来自 GitHub 仓库、Google Drive 或上传文件,面向个人 Pro、Ultra 账户分批开放。
这里有个坑。它和远程控制自己的电脑是两回事。
如果需求依赖没提交的组件修改、本地启动的接口服务,或者只存在于电脑里的测试数据,云端环境未必接得上。前端任务尤其容易卡在这里。改 JSX 只是其中一步,启动页面、登录测试账号、看交互效果,经常才是验收的大头。
语音交互也值得留意。更新解读称,Gemini Live 可以接收任务、调整方向,并回应权限请求,结束后保存转录文本。但文中没有语音准确率、延迟和权限确认的实测。我的取舍很简单,需求背景可以口述,文件路径、发布目标和精确约束仍然要在文本里核对。
另一边,Quarters 作者解决的是另一个瓶颈。多个项目各跑一个 Agent,真正麻烦的往往是没人发现它已经停下来等确认。这个免费、MIT 开源的 Mac 应用,把 Agent、终端和 Git 状态按项目保存,用等待标识、快捷跳转和通知提醒人接手。
它没有提供自己的模型,也没有证明多项目管理一定提高多少效率。Claude Code 能拿到更深入的日志和用量信息,其他 Agent 的支持深度不能照搬。
回到这块,后台执行和集中管理解决的是不同等待。前者减少机器必须在线的时间,后者减少人发现请求的时间。两边都做了,任务仍可能因为缺凭据、缺依赖、验收说不清而挂住。
能离开电脑,不等于任务已经具备独立交付的条件。
要我选,我会先拿一个不依赖本地服务的小型仓库任务试云端续跑,把安装命令、测试入口和完成条件一起交过去。再挑两个项目同时运行,记下任务何时停住、何时被人处理,比看它连续工作几个小时更有用。
二、上下文越短越省钱,为什么在长会话里会失效?
顺着上面聊,任务能持续跑,成本就不能只看单次请求。
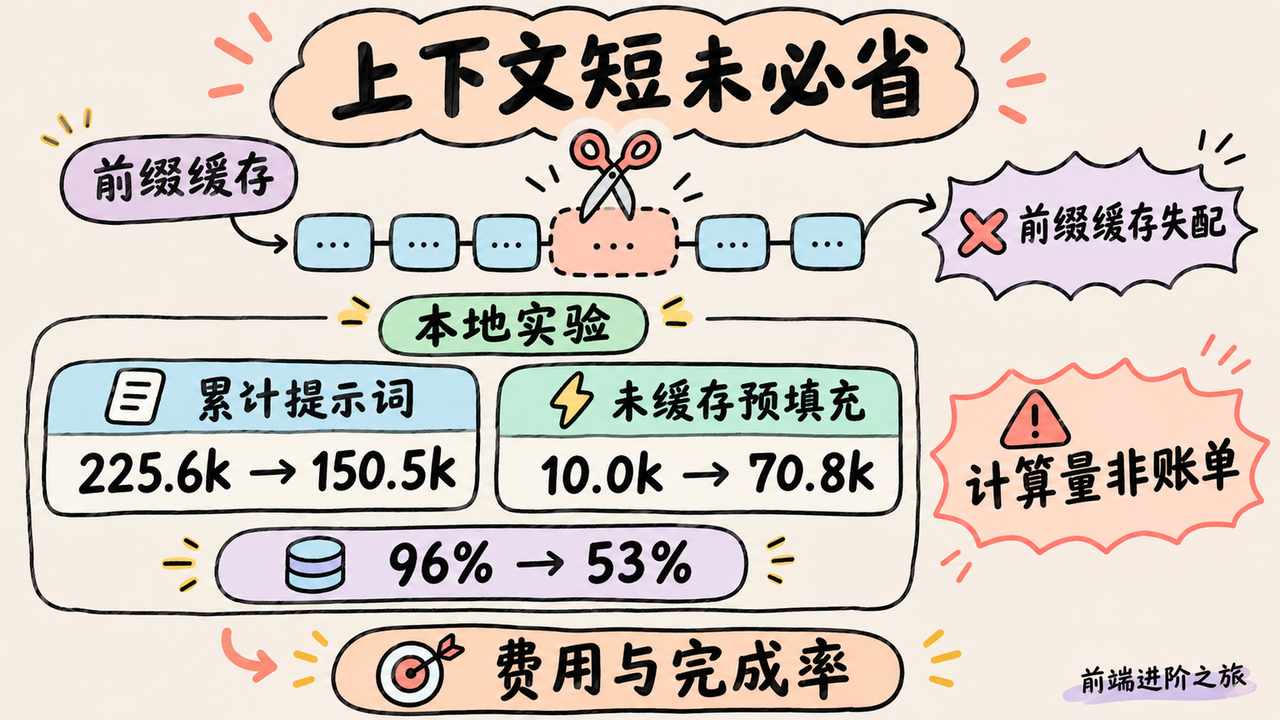
上下文裁剪研究解读援引了一项本地 GPU 实验。mini-SWE-agent 在开启前缀缓存的服务端运行 100 个 SWE-bench Verified 任务,对比保留全部工具输出和只保留最近五次输出。
后者累计提示词从 225.6k 降至 150.5k,减少 33.3%;未缓存预填充从约 10.0k 升到 70.8k,增加 608.5%。缓存覆盖率则从约 96% 降到 53%。
数字看着别扭,原理却不复杂。前缀缓存复用的是前面连续一致的内容。删掉中间一段历史,后面原本可以复用的内容也可能失去匹配;下一轮再删,又重复付出一次重新计算的代价。
省下的是长度,增加的是计算。
不过,这项实验没有直接测 Claude Code 或 Codex 的云端账单,不能把 608.5% 写成费用涨幅。具体收费还取决于模型、缓存读写价格和缓存策略。
一份 Claude Code 用量分析补上了另一面。作者统计约 30 天、192,178 次请求,累计约 445.7 亿 token,其中 97.03% 是缓存读取。按 API 标价折算,缓存读取占成本的 56.6%,子代理占总折算成本的 58%。
作者用的是订阅,约 15,290 美元只是折算金额,不是实际账单。这个样本也重度使用子代理,不能当成普通程序员的月均用量。
但它提醒了一个很实际的问题。缓存便宜,不代表反复读几十亿次还能忽略。常驻指令、启动材料和工具输出,只要留在会话里,就可能被后续请求一遍遍读取。
于是两篇看似矛盾的文章,其实能放在一起读。启动前少带无关内容,和运行中频繁改写已经缓存的历史,不是同一种优化。
TokenCap 的真实提交评测又加了一条约束。九个仓库、100 个任务中,任务包的所需文件召回率为 87%,实际修改行平均覆盖率为 73%;完整读取 grep 匹配文件的文件召回率则有 96%。短了,确实可能漏东西。
上下文优化要同时交代费用、缓存命中和任务完成率。
我会拿仓库里最近十个真实修改,固定模型和验收条件,对比原方案、精简启动材料、裁剪历史三种设置。记录普通输入、缓存读写、总费用和漏文件情况;分析日志时还得按响应 ID 去重,那份 Claude Code 分析里,直接逐行相加会把用量算到约 2.09 倍。
三、模型说「做完了」,业务系统凭什么认账?
你要是也在做 AI 办公提效,创建工单、发邮件、改文章这些操作,比生成一段漂亮回复更值得盯。
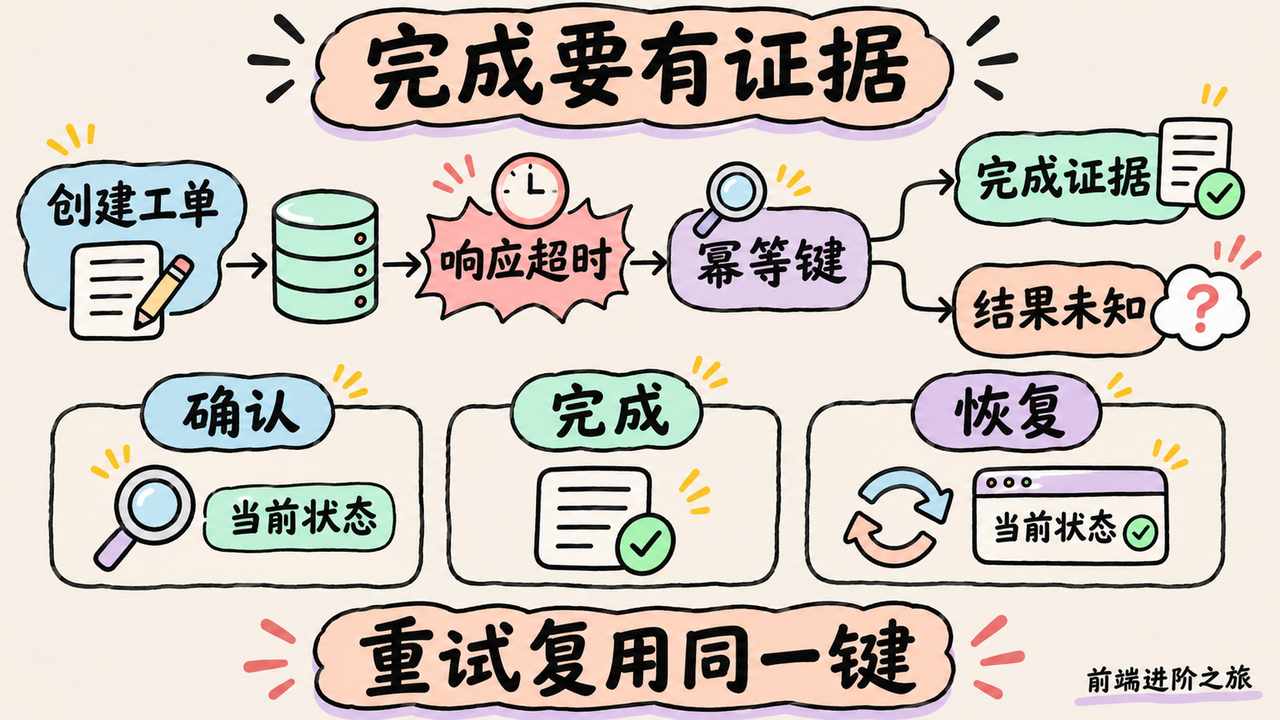
任务完成状态的设计文章举了一个常见场景。Agent 查询订单保修状态,再创建维修工单。模型能提取订单号、选择工具,但是否属于当前用户、能不能创建、工单是否真的写入,都得由应用处理。
最麻烦的是超时。
请求没拿到响应,服务端却可能已经成功写入。模型直接重试,就可能重复建单;直接说失败,也可能误导用户。文章建议用幂等键或业务标识查询状态,但服务端必须真正实现去重,生成一个字符串本身没有保护作用。
邮件验证流程的讨论说的是同一种不确定。注册操作已经触发,验证码还没出现,如果只返回「没收到」,Agent 很容易重复注册或反复重发。
作者建议用 run_id 关联本次操作与邮件,把等待截止时间交给程序控制。文中的 90 秒只是示例预算,并非测出来的通用标准。
这类流程,我倾向于把「结果未知」保留下来,别急着让模型猜成功还是失败。下面是一个工单调用方的简化写法,前提是服务端支持按幂等键去重和查询。
async function createTicket(input, operationId) {
  try {
    const result = await api.createTicket(input, {
      idempotencyKey: operationId, // 重试同一次操作必须复用
    });
    if (result.ticketId) {
      return { status: "created", ticketId: result.ticketId };
    }
  } catch (error) {
    if (!isTimeout(error)) throw error;
  }

  const existing = await api.findTicketByOperation(operationId);
  if (existing) {
    return { status: "created", ticketId: existing.id };
  }

  // 暂时查不到,也可能只是写入尚未可见
  return { status: "unknown", operationId };
}
最容易翻车的是最后一个返回值。unknown 不能被上层翻译成「创建失败,请重新提交」,否则去重设计很可能又被绕回去了。
还有一件事,MCP 文章编辑工具的复盘把它讲得很清楚。作者已经做了修改预览、显式确认和前后状态日志,但目标平台没有文章版本历史,工具仍然缺少安全恢复路径。
确认、完成、恢复,是三件事。
日志里有旧正文,也不能不看当前状态就覆盖回去。期间如果有人继续编辑,粗暴恢复会把新修改一起抹掉。
今天就能做的验证很具体。在测试环境里让写入成功、响应超时,检查系统会不会重复创建;再让写入后出现一次人工修改,检查恢复操作会不会覆盖它。别只测正常返回的那条路。
四、给 Agent 装了命令护栏,为什么还会越权?
大概率你也遇到过,安全提示弹得太频繁,最后大家只想把它关掉。问题是,吵闹不代表有效。
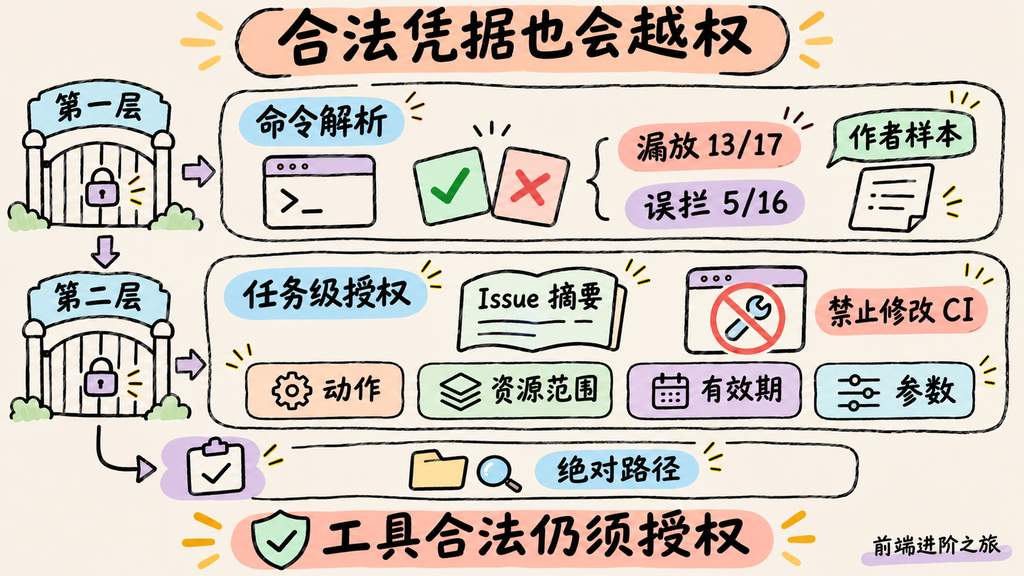
一位开发者的命令护栏测试里,旧钩子在 17 条破坏性命令中漏放 13 条,又误拦了 16 条正常命令中的 5 条。
它会识别某种参数排列,却认不出等价的另一种排列;还把不以 / 开头的目标当成相对路径,漏掉了 Shell 会展开的用户主目录。改用 Shell 语法解析与命令专属规则后,新版本通过了这组 33 条测试。
这不是「从此安全」的证据。作者承认仍有缺口,而且路径、变量值和工作目录都会改变命令含义。某个临时目录能清理,不代表包含变量的所有清理命令都能放行。
我的读法是,危险命令拦截率和正常命令放行率必须一起看。否则全部拒绝就能刷出漂亮的安全成绩,用户却会主动绕开它。
但命令解析只能解决一部分问题。
委托权限边界的讨论举了一个更难拦的场景。Agent 本来负责读 Issue、生成摘要,却也持有创建 PR 的凭据。恶意 Issue 诱导它修改 CI 工作流,调用使用的是合法 token,操作甚至可能完全符合接口规范。
工具没有报错,任务已经越界。
所以我会在工具执行前再看一次当前委托,而不是只问账号有没有仓库写权限。下面这个 JS 对象表达的是任务级授权输入,执行器得逐项检查,放进提示词里不算落实。
const taskGrant = {
  agentId: "issue-summary-agent",
  taskId: "summary-184",
  expiresAt: "2026-11-04T12:00:00Z",
  resources: {
    repository: "team/web-app",
    issueNumbers: [184], // 不能顺手扩大到整个组织
  },
  actions: {
    readIssue: true,
    createPullRequest: false, // 当前任务只需要读和总结
    updateWorkflow: false,
  },
};
最容易翻车的是 actions。如果执行器只检查工具名称,不检查动作参数、资源范围和有效期,这份配置就只是装饰。
再看 AI 编程提交的本机痕迹调查。作者发现,项目记忆文件、调试输出和提交消息中会出现账户名、绝对路径、变形后的路径标识及会话链接。这些通常不属于密钥,常规秘密扫描未必能发现。
搜索样本不是随机抽样,GitHub 总数还大幅波动,所以不能据此推算泄露人数;公开会话链接也没有被证明可以读取完整会话。但把机器环境和跨仓库活动串起来,已经值得处理。
今天可以把护栏测试改成只传命令文本、不执行命令的正反样本测试,再给摘要任务塞一条要求修改工作流的外部指令。顺手检查待提交的记忆文件和 PR 正文,看看有没有不该公开的绝对路径。
五、模型跑分涨六倍,能不能据此替换现有方案?
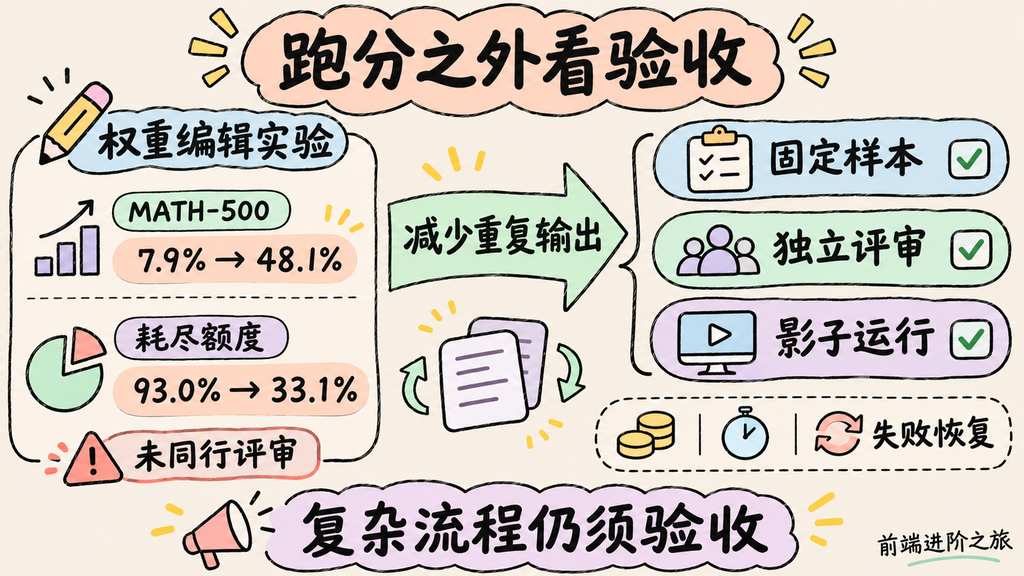
说实话,今天最容易让人冲动的数字,是改掉 0.016% 权重之后,数学成绩涨到原来的约六倍。
据 权重空间编程实验解读,GPT-6 Astra 修改 Qwen3.5-0.8B 的少量权重后,MATH-500 从 7.9% 升到 48.1%。
但更能解释结果的是另一组数。在最多生成 32,768 个 token 的设置下,原模型有 93.0% 的回答耗尽额度,修改后降到 33.1%。它原先经常陷入重复检查和重述,修补后终于更容易把答案写完。
这项工作当时还是博客与预印本,尚未经过同行评审。最佳尝试用了 50 次评估请求和 20.3 小时,其中 4.7 小时在等外部系统故障恢复。另一个原本较少重复的 Gemma 模型,也没有得到被研究团队认定有效的数学改善。
所以我会把它当作模型调试线索。补丁很小,搜索补丁的成本并不小;修复生成退化,也不能直接说成学会了新知识。
科研 Agent RUMI 的独立评审则从另一边提醒我们。系统包含检索、知识图谱、多轮对抗审查,51 次外部评审仍然得到 45 个 C、6 个 F,没有 A 或 B。
这个结果不能代表所有科研 Agent。它的外部评审器也有局限,文中自评均值、外评均值和平均分差还存在未解释的口径矛盾。但长时间运行、多层自审,显然没有自动换来可靠产出。
流程复杂度不能替代独立验收。
回到日常 AI 编程,Agent 质量评估文章给了更实用的办法。用固定样本、独立评审和影子运行观察版本变化,既看答案,也看工具调用、格式错误、延迟和成本。它用的是虚构邮件助手,里面的效果数字不能当成真实产品成绩,方法却能借。
对代码任务,我会保留格式、类型和权限这些硬检查,再重复运行有判断空间的任务。整体通过率之外,还要单独看跨文件修改、异常输入和失败恢复,免得一个类别的退化被平均分盖住。
今天不用搭完整评测平台。拿十个历史任务,把预期改动和禁止操作写清,固定两个候选方案各跑几次,再请没参与生成的人盲看结果。这个小样本不能证明谁全面领先,但足够暴露不少「看着挺会写」的问题。
六、低价 API 和开放权重,哪种才适合团队落地?
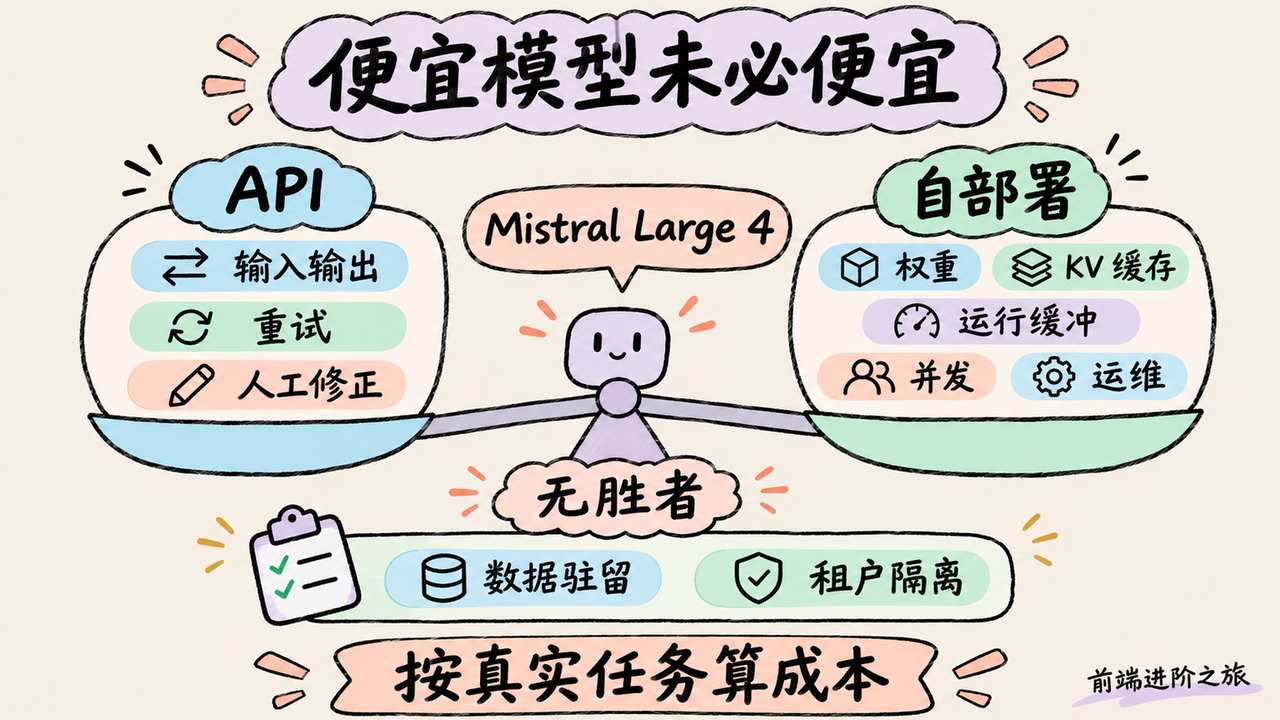
这轮 AI 热点里,Mistral 的价格和开放权重很抢眼。但要我选,我会先算服务成本,再看参数有多大。
据 Mistral Large 4 解读,模型采用约 1.05 万亿总参数的 MoE 架构,每 token 激活约 520 亿参数,支持百万 token 上下文和图文输入。API 标价为每百万 token 输入 0.70 美元、输出 2.10 美元,开放权重约 610GB 至 1.06TB。
只激活少量专家,能减少一部分计算,并不会让其他权重凭空消失。部署预算还得考虑存储、硬件、并发和框架。文中不少成绩来自厂商,独立榜单还有预览版数据,我不会据此直接换掉现有代码模型。
本地模型显存预算文章把同一个问题缩小到单机。显存里除了权重,还有随上下文增长的 KV 缓存及运行缓冲。文中围绕 Qwen3.8 27B 给出量化选择,但数字混合了估算与社区测量,缺少完整运行设置,适合初筛,不适合直接拿去买卡。
多出来的显存,可能主要换来更长上下文,而不是跨进更大模型的门槛。不同架构的缓存需求也不同,不能拿一个 27B 模型的经验套全部同规模模型。
落到团队服务,还得再算一层。LibreChat 多租户架构提案选择每个客户独立部署应用和数据环境,共享控制平面管理开通、计费、限额与升级。
这个方案减少了直接改造 LibreChat 租户隔离的压力,也增加了部署和运维工作。文中缺少生产压测与实际账单,每席 12 美元、75% 毛利这样的目标,不能直接当成已经跑通的生意。
便宜模型,未必便宜服务。
我的判断是,有明确数据驻留和隔离要求,再认真评估自部署;主要诉求是写代码、做内部助手,就先用真实任务算 API 的有效成本。今天拿同一批任务记录输入输出、重试、耗时和人工修正时间,再把自部署需要的常驻资源列出来,通常比争论参数规模更快接近答案。
总结
11 月 4 日这批文章里,最打动我的进展是 Agent 开始脱离本机持续执行,团队也开始把缓存、授权、验收和恢复拆开讨论。后面这些听着不够炫,却决定 AI 编程能不能稳定进日常工作。
数字里有几件事可以说清。命令护栏作者的旧版本确实在那组测试中大量漏拦;上下文实验确实出现了提示词缩短、重新计算量增加;权重编辑实验报告了重复输出减少和成绩提升。它们各自都有明确样本与条件,不能往外随意扩。
我更看好能交出完成证据、失败状态和成本明细的工具。云端续跑是否适合你的前端项目,低价模型能否替代当前方案,多 Agent 是否真的减少交付时间,都还得放进自己的任务里比较。
对天天写业务代码的程序员来说,今天最值得保留的一句话是,别让 Agent 自己定义「省钱」「安全」和「完成」。
参考
- Antigravity 支持云端续跑与语音授权|DEV Community
- Quarters 集中管理多个项目的编程 Agent|DEV Community
- 智能体上下文越短,账单未必越低|DEV Community
- Claude Code 用量分析揭示上下文成本|DEV Community
- 用真实提交检验代码上下文压缩效果|DEV Community
- 智能体任务完成,要由业务系统确认|DEV Community
- 邮件验证智能体需要明确等待预算|DEV Community
- Agent 写入有日志,也未必能撤销|DEV Community
- 用破坏性命令实测编程智能体护栏|DEV Community
- 智能体越权,从委托权限边界防起|DEV Community
- AI 编程提交会泄露哪些本机痕迹|DEV Community
- 直接修改模型权重能否修复推理循环|DEV Community
- 51 次独立评审暴露科研 Agent 自评偏差|DEV Community
- Agent 质量怎么测,样本集、评审与影子运行|DEV Community
- Mistral Large 4 开放权重并下调 API 价格|DEV Community
- 本地大模型显存预算不能只看权重|DEV Community
- 用 LibreChat 搭建多租户 AI 服务|DEV Community
- 前端进阶之旅