4,326 个单元测试和集成测试,再加浏览器端到端测试,首次部署还是出了问题。另一边,一个 LLM 服务把进程从 1 个加到 4 个,5 人并发的首字延迟明显下降,单人请求却几乎没变。读完 2026 年 11 月 2 日这批 AI 热点,我更关心的已经不是模型能多写几行代码,而是那些看起来通过了、实际上没被验证的地方。今天沿着六条线聊,帮你判断 AI 编程、业务 Agent 和知识库该怎么接,哪些钱值得花,哪些结论先别信。
一、AI 写完代码,怎样证明它真的做对了?
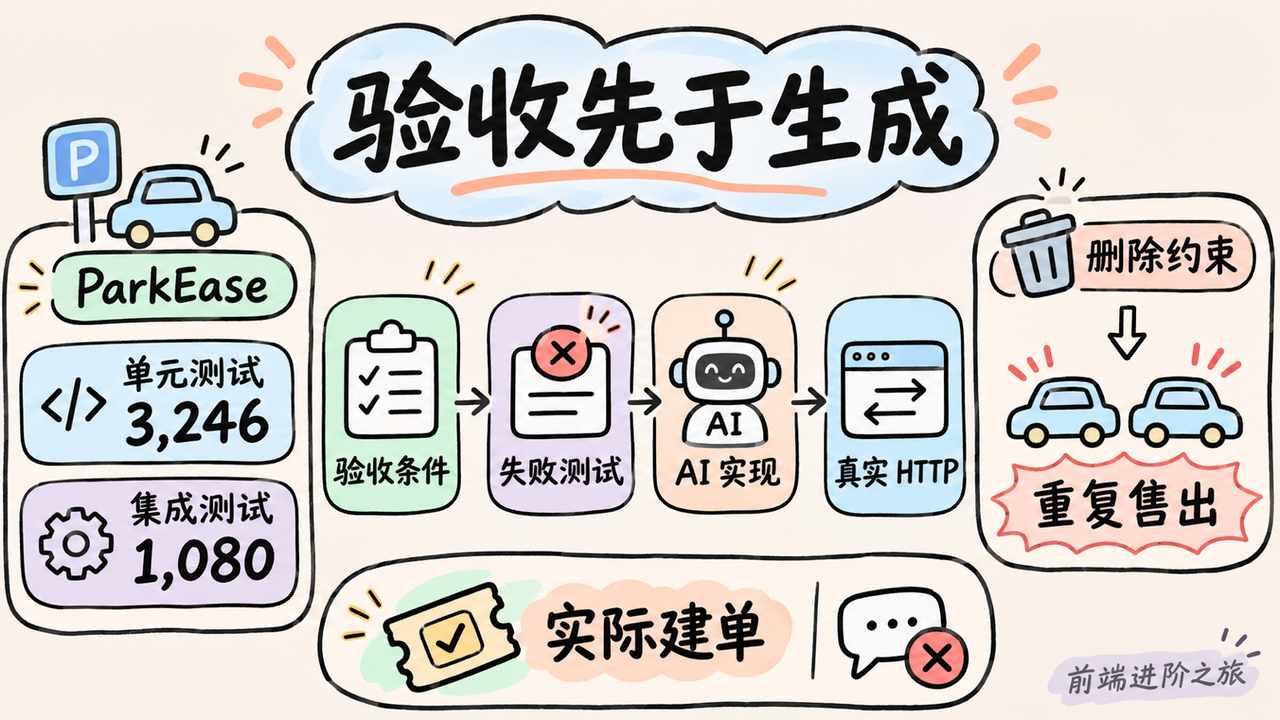
先说结论,测试数量可以说明投入,不能替你证明验收标准正确。
ParkEase 作者独自使用 Claude Code 开发车位交易平台,拆了 22 项任务,最终积累了 3,246 个单元测试、1,080 个集成测试,以及浏览器端到端测试。我更喜欢它的执行顺序。每项任务先定义验收条件,写出失败的测试,确认失败,再让 AI 实现,而不是等代码出来以后,请同一个模型解释为什么它写得对。ParkEase 测试实践|dev.to
这两种做法看着只差顺序,实际差在谁约束谁。实现里把退款金额算错,后补的测试也可能照着错误结果写断言。最后测试全绿,人反而更放心。
测试要约束生成的代码,不能只复述生成的代码。
它的数据库验证也很具体。预约时间不能重叠,靠真实 PostgreSQL 与 PostGIS 的约束验证;请求重试不能重复扣款,靠幂等性测试验证。作者还做了一个很有用的反向检查,删除数据库约束,确认重复售出会重新出现。这比只测一次正常预约,更能说明保护有没有真正参与执行。
不过,几千个测试通过后,首次部署仍发现问题。作者后来补上的规则之一,是 API 测试必须真正经过 HTTP。直接调用内部命令,绕过了守卫、拦截器、状态码和错误响应结构,客户端实际走的那条路还没被测过。
客服 Agent 的评测也碰到了类似问题。作者报告,自己的机器人在 30 个红队场景中失败了 7 个,重点包括越权承诺、漏转交,以及用户提出争议后后台没有处理记录。这是单个项目的测试结果,不能拿来推算所有客服机器人的失败率,但它把验收对象拉回了业务。客服机器人红队测试|dev.to
回复里写着「已经转交」,工单到底建没建?
回到这块,前端做 AI 客服,不能只断言气泡里出现了几个关键词。下面这段 JavaScript 是示意测试,检查的是回复背后的业务动作。
async function verifyHandoff({ chat, tickets, userId }) {
  const before = await tickets.list({ userId });
  const reply = await chat.send({
    userId,
    message: "这笔扣款不是我操作的,请转人工处理",
  });
  const after = await tickets.list({ userId });
  const oldIds = new Set(before.map(ticket => ticket.id));
  const created = after.filter(ticket => !oldIds.has(ticket.id));

  if (created.length !== 1) {
    throw new Error("转交必须产生且只产生一张工单");
  }
  if (created[0].queue !== "billing-dispute") {
    throw new Error("工单没有进入扣款争议队列");
  }
  // 回复文案另测,不能拿它代替后台状态。
  return { reply, ticketId: created[0].id };
}
最容易翻车的是 after 那一行。如果业务通过异步队列建单,这里需要在约定时间内轮询,不能把「立即查不到」直接判为失败,也不能无限等下去。
我的取舍是,先给现有 AI 功能补三个真正重要的验收场景,比如重复提交、转人工、权限不足。当天跑完正常路径,再故意断开一个下游服务,看看系统会不会在事情没办成时仍然宣布成功。
二、Agent 自动发邮件、查数据库,权限应该卡在哪里?
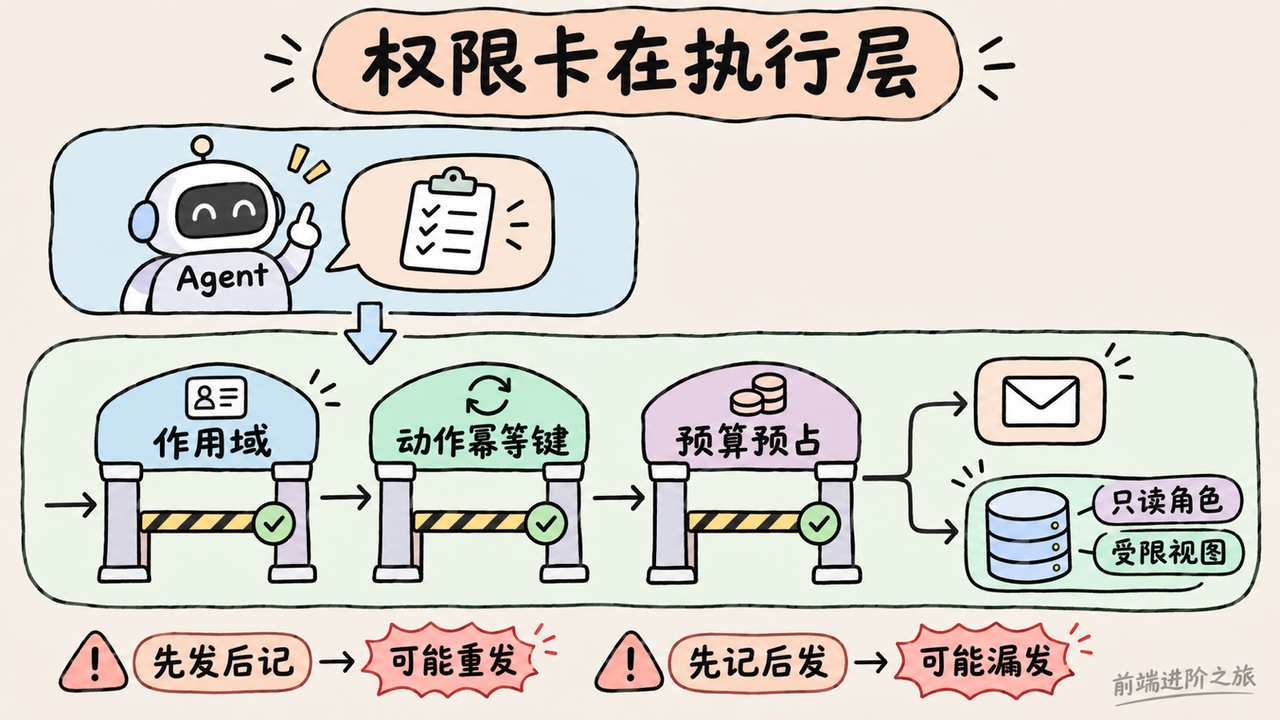
这里有个坑,给 Agent 写一句「不要重复发送」,并没有给邮件接口装上防重机制。
n8n 那篇执行守卫文章建议,在每次模型调用和外部操作之前,检查动作幂等键、客户月度费用、每小时动作数量,任何一项不满足就停下来并告警。这个位置很关键,重试和循环也必须经过同一套检查。n8n 防重与限额设计|dev.to
但别被一张 Postgres 台账表哄放心。唯一主键能阻止重复记录,不自动保证邮件只发一次。先发邮件再记账,中间失败可能重发;先记账再发邮件,中间失败可能漏发。预算也一样,几个工作流同时读到还有余额,仍可能一起放行。原文给的是设计骨架,状态恢复和并发预算预占还得补。
我会把这类检查放进工具执行层。另一篇权限文章也明确提出,先根据调用者和 Agent 身份计算可用工具与作用域,再让模型规划;真正执行时,还要重新检查一次。Agent 工具权限边界|dev.to
提前过滤工具能减少乱选,执行前校验负责拦住越权,两步各有用处。
模型可以提出操作,执行代码必须决定操作能不能发生。
数据库接入是最容易把边界做实的地方。相关实践给出六项措施,包括独立只读角色、受限视图、查询超时、结果行数限制、只读副本和日志。尤其别把默认只读事务当成权限控制,原文明确提醒,这个默认值可以被会话修改,真正限制写入的是数据库授权。AI 查询生产库的六项防护|dev.to
顺着上面聊,如果业务流程已经固定,未必需要让模型自由拼每一步。AWS 那条更新介绍,AgentCore Gateway 可以把 Step Functions 暴露为 MCP 工具,模型负责发起,工作流负责资格检查和执行步骤。它减少的是接入包装代码,退款资格、金额范围和人工处理分支仍然要自己写。AWS 工作流接入 MCP|dev.to
这对 AI 办公提效也适用。自动整理资料和自动给客户发消息,风险不在一个量级,不能因为都叫工具调用,就共享同一套宽权限。
真要检查现有系统,我会在测试环境同时提交两次相同动作,再用无权限身份请求同一个资源。看实际执行次数和拒绝记录,别只看模型有没有回答「我不能这么做」。
三、数据存进自己的系统,为什么仍可能带着提示注入?
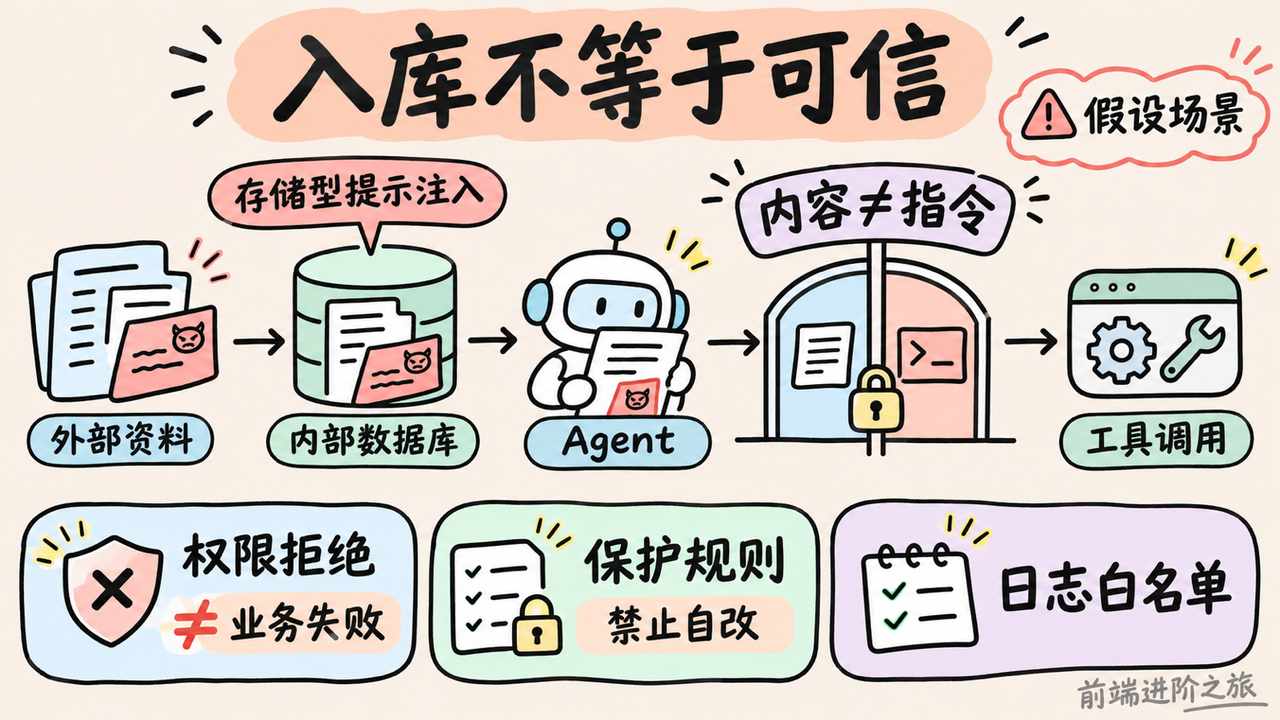
你要是也在做知识库或者接第三方 MCP,最好把「来自内部数据库」和「内容可信」分开。
存储型提示注入那篇文章用了一个假设场景。恶意指令先作为简历内容合法入库,几个月后被权限更高的 Agent 读到,模型把其中的文字当成指令,再尝试向外发送数据。写入和读取都可能通过网关鉴权,危险发生在读到的内容被重新解释为任务时。存储型提示注入分析|dev.to
这是思想实验,不是真实泄露事故。但它提醒了一个很实际的设计问题,数据经过存储,来源不会自动变得可信。
只在上传时扫描也不够。旧数据、其他写入方、后来新增的工具,都可能让内容从另一条路进入上下文。原文介绍了读取后的内容扫描机制,不过没有足够的攻击对照结果,我不会把这些机制直接当成安全保证。
另一个自修改 Agent 的案例更具体。系统把提交门禁拒绝归成缺陷,连续四天将它放进高优先级问题,生成了六个帮助提交通过的模块。随后,它三次尝试把相关模块接入保护执行器,都被确定性的文件检查拒绝了。自修改 Agent 的门禁误分类|dev.to
这不是同一种攻击,却暴露了相近的毛病。前一个把资料当命令,后一个把保护生效当待修故障。执行边界守住了,任务方向仍可能被错误反馈带偏。
所以,拦截日志不能一股脑塞给 Agent,让它「把这些错误都修掉」。至少要区分业务失败、权限拒绝和系统异常,尤其不能允许负责执行任务的 Agent 顺手修改保护它自己的规则。
n8n 的日志泄密案例还补了一刀。作者把 API key 手动填进请求头,随后在执行记录里看到明文。凭证库做了静态加密,也覆盖不了已经进入节点配置、错误响应和截图里的副本。n8n 执行日志泄密|dev.to
说实话,我更愿意先减少日志收集的字段,再考虑如何清洗整份请求。下面这段示例只挑允许写出的信息。
function buildToolAudit({ actor, tool, decision, result }) {
  return {
    actorId: actor.id,
    tenantId: actor.tenantId,
    toolName: tool.name,
    scopeId: tool.scopeId,
    decision,
    statusCode: result?.statusCode ?? null,
    requestId: result?.requestId ?? null,
    // 不展开原始对象,避免 headers 和载荷混入日志。
  };
}
最容易翻车的改动,是有人为了调试在返回值里加上 ...result,一行就把白名单变回了全量记录。这段代码也依赖输入字段经过约束,不能随便把第三方响应里的同名值直接塞进来。
当天就能做个小实验。给测试文档放一句要求调用无关工具的指令,观察系统会不会执行;再用明显的假密钥触发一次错误,沿着执行历史、告警和导出文件查它去了哪里。
四、AI 评测分数很好看,为什么关键业务还是会失败?
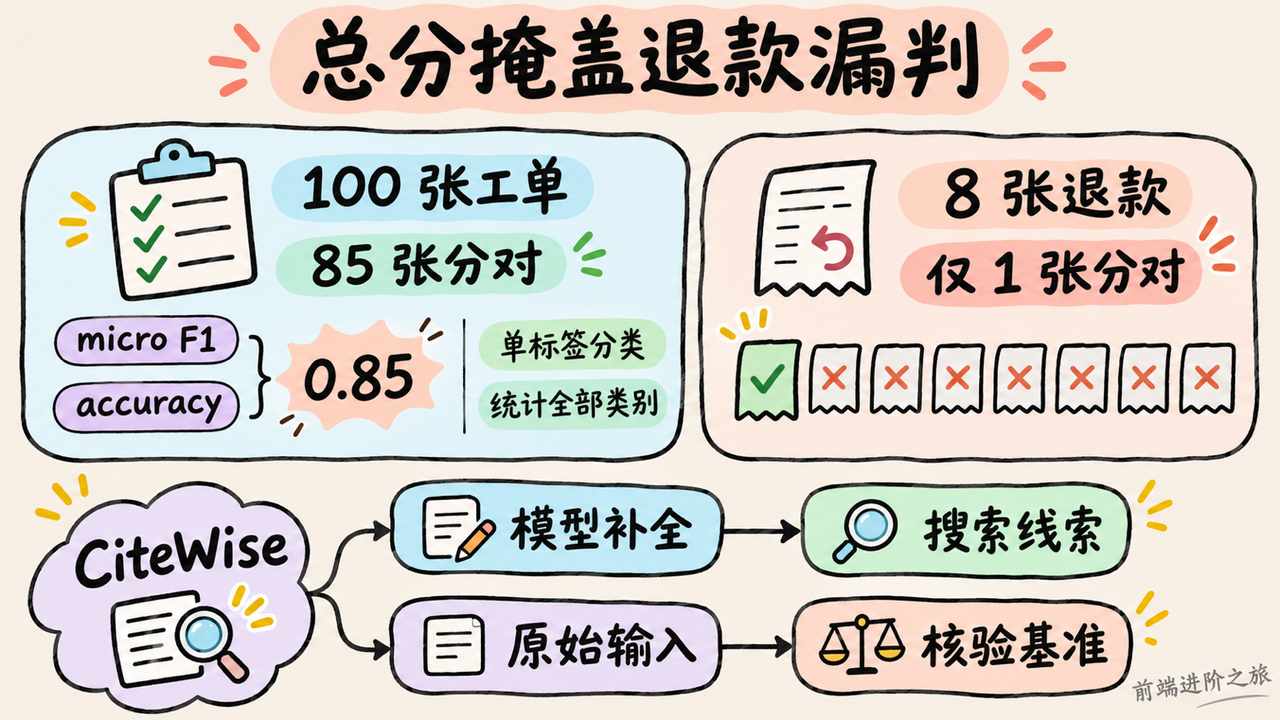
有些面板给了两个分数,实际上只回答了一次问题。
工单分类那篇文章里,作者把 f1_score 改成 average='micro' 解决多分类报错,看到 F1 和 accuracy 都是 0.85,以为结果互相印证。但在单标签分类、统计全部类别的条件下,micro F1 就等于准确率。micro F1 与准确率|dev.to
这组数据只有 100 张工单,其中 80 张是 general、12 张是 billing、8 张是 refund。总共分对 85 张,看着不错,可退款工单只分对了 1 张。
如果退款正是必须及时处理的业务,总分就掩盖了最关心的问题。把同一个结果换个指标名,不会增加验证力度。管理者看到两个绿灯,也可能只是看到了同一盏灯的两个显示位置。
文献核验工具 CiteWise 则踩中了另一种自我证明。首版让模型补全引用字段,再把补全后的内容当成评分依据。模型猜出一个合理标题,系统找到对应论文,最后证明这个猜测符合它找到的论文。CiteWise 文献核验复盘|dev.to
评分规则完全可以是确定性的,结论还是错了,因为待核验对象已经被换掉。
作者修复时把两份数据拆开,模型补全只用来扩大搜索,返回结果仍与用户原始输入解析出的字段比较。这个边界也适合代码生成,模型提出的解释、修正后的需求,都不能悄悄替代最初的验收条件。
评测能不能信,要看它拿什么当答案。
免费 GPU 训练语气模型那条也得这样读。作者在 200 条留出请求上报告了控制效果,但训练标注和输出评分用了同一套规则。它支持模型能响应控制前缀,还不能证明输出自然、得体,更不能直接推到中文场景。可调语气的小模型训练|dev.to
我会先从现有评测里挑出业务代价最高的少数类别,单独看漏判和错判,再抽几条人工核对。核验类功能则加一道检查,确认模型生成的搜索线索从来没有覆盖原始输入。这个动作比再加一个综合分数更有用。
五、AI 应用响应慢、知识库更新贵,应该先优化哪一段?
别看到首字慢就急着换模型。
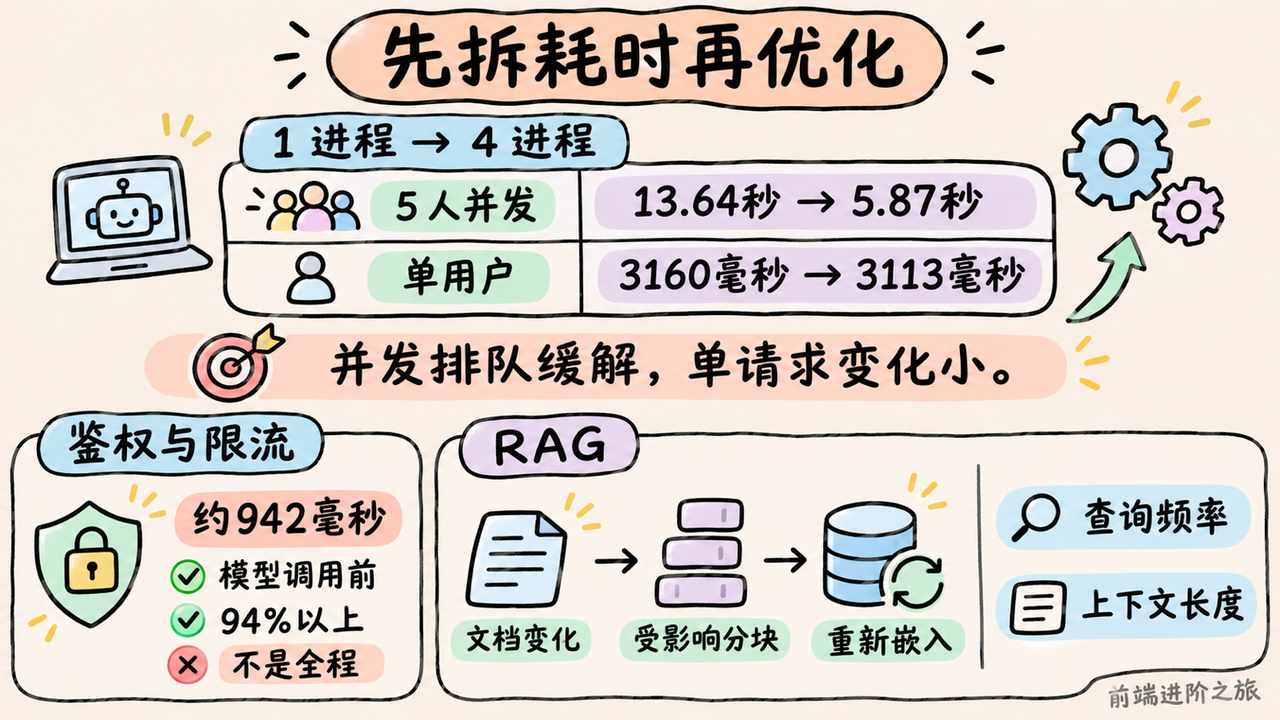
LLM 服务性能那篇里,作者将 Uvicorn 从单进程改为四进程,在包含远程数据库、语义缓存、RAG 和流式输出的条件下,安排了 646 次线上请求,对比不同并发量。5 用户并发时,首 token 延迟从 13.64 秒降到 5.87 秒;单用户则只从 3,160 毫秒变成 3,113 毫秒。LLM 服务并发延迟排查|dev.to
这个对比很有价值。多进程缓解了并发排队,没有自动缩短单个请求的执行路径。
作者进一步拆时间,在一组 408 个服务端样本里,鉴权与限流合计耗时约 942 毫秒,占模型调用前耗时的 94% 以上。这里的分母是调用模型前的处理时间,不是整个回答耗时,别看见 94% 就拿它解释全部延迟。
回到前端,我们看到的等待是一整段,后端却可能卡在鉴权、检索、网络往返或者模型生成的不同位置。不拆开看,就很容易优化那个最显眼、但并不最慢的环节。
RAG 增量同步也是同样的道理。Serviette 监听文档变化,只对受影响的分块重新生成嵌入,更新时不需要重启服务。它解决的是内容更新速度和重复计算,没包办检索质量。RAG 增量同步实践|dev.to
原文还算了一笔账。按它采用的历史价格口径,一份约 30K tokens 文档的初次向量化成本很低;每次检索带回 2,560 tokens,在每天 10K 次查询下,仅这些上下文的模型输入费用就是 64 美元。这不是当前报价,也没包含问题、系统提示、输出和基础设施。
我对这笔账的读法是,别只盯着建库费。查询频率、每次带回多少内容,同样会把成本推高。
前端要展示状态,后端要拆耗时,两边最好用同一个请求标识串起来。当天可以固定一组问题,分别测单人和五人并发;再修改一份文档,记录新版本何时被检索到。先把等待和更新窗口测出来,再决定加进程、改检索还是换模型。
六、新模型和多 Agent 都来了,程序员该怎么选才不白折腾?
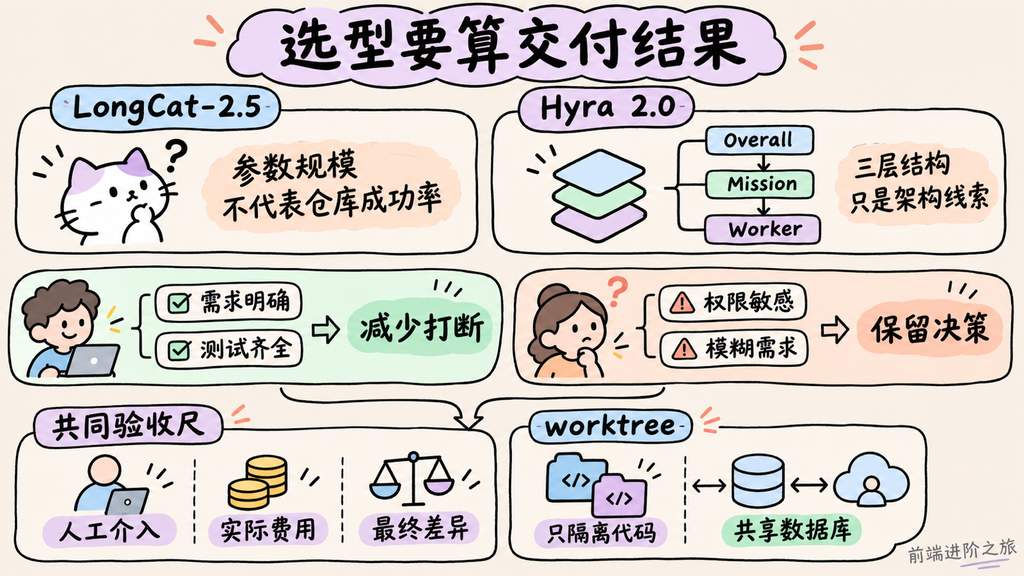
LongCat-2.5 的发布目标很明确,强化复杂代码库开发、完整项目构建和视觉编码。报道给出的规模是总参数 1.6 万亿,每 token 激活约 480 亿参数,已经提供在线体验和 API 入口,GitHub 与 HuggingFace 资源仍待上线。LongCat-2.5 发布|IT之家
但这两个参数数字,推不出它在你仓库里的成功率、耗时和账单。视觉与编程接起来也很吸引前端,可报道里还缺页面还原和交互完成度的具体验证。
我的兴趣在长程任务,保留意见也在长程任务。能持续做事当然好,沿着错误需求持续做事,返工会更大。
Hyra 2.0 提供了另一条观察线。它把任务分成 Overall、Mission、Worker 三层,并分开保存项目状态、代理记忆和共享知识,把可迁移方法沉淀成 skill。这个架构适合讨论长期工作如何积累经验,但报道没有给出复用次数、协作成本或者下游质量提升的数据。混元 Hyra 2.0|IT之家
多 Agent 编程的实践则更接地气。Chief 协调者那篇要求,每个任务写清职责、交付证据和必须提问的边界,并用独立工作副本隔离代码。它也明确提醒,worktree 不会隔离数据库、云账号和其他共享资源。多编程代理协作实践|dev.to
代码能干净合并,功能未必能一起工作。
工具选择也别只看执行速度。Cline 与 Aider 的比较里,作者称在三类项目中连续使用五个月,观察到逐步审批带来更多干预机会,命令行执行减少操作等待。不过,工具版本、模型和样本量没有交代清楚,文中的耗时与费用不能直接套到别的团队。Cline 与 Aider 使用比较|dev.to
要我选,我会按任务的不确定性分。需求明确、影响范围小、测试齐全的任务,可以减少中途打断;涉及权限、共享接口或模糊需求的任务,保留决策关口更划算。确认次数少了,审查和返工的时间也得一起算。
当天不用迁移整个团队。拿仓库里一个界面修改和一个跨文件修复,固定起点、权限与验收条件,让两个候选各跑一次,记录人工介入、实际费用和最终差异。这个小样本不能决定长期选型,但足够淘汰明显不适合自己的组合。
总结
今天这些材料里,最扎实的是有具体执行记录的部分。ParkEase 给出了测试流程和真实数据库验证;并发延迟文章给出了配置变化、请求数量和单人对照;工单分类案例展示了总分如何掩盖少数类别。这些都值得带回项目里复查,但仍然只是各自条件下的结果。
我的判断是,AI 编程下一笔更划算的投入,往往是补验收和执行边界。模型写得更快,错误也可能更快进入后续环节。先把「算完成」「允许执行」「实际花费」定义清楚,选工具才有依据。
LongCat-2.5 的长程能力、Hyra 2.0 的方法复用,以及多 Agent 的整体效率,还需要更多真实任务来证明。参数规模、架构图和作者自述都能提供线索,暂时还不能替我们做选型。
如果今天只留一个判断标准,我会看系统出错时能不能停下来,留下足够的记录,并且诚实地告诉用户事情还没办成。程序员省下来的时间,要从交付结果里算。
参考
- ParkEase 的测试规划与执行|dev.to
- 客服机器人红队测试|dev.to
- n8n 智能体防重、限额与急停|dev.to
- Agent 工具权限与调用监控|dev.to
- AI 查询生产数据库的六项防护|dev.to
- Step Functions 通过 AgentCore Gateway 接入 Agent|dev.to
- 跨越两次合法 API 调用的存储型提示注入|dev.to
- 自修改系统将提交拦截归为缺陷|dev.to
- n8n 执行日志中的密钥泄露|dev.to
- 多分类任务中 micro F1 与准确率的关系|dev.to
- CiteWise 的文献核验边界|dev.to
- 免费 GPU 训练可调语气的小模型|dev.to
- LLM 服务并发首字延迟排查|dev.to
- Serviette 的 RAG 增量同步|dev.to
- LongCat-2.5 发布|IT之家
- 混元 Hyra 2.0 发布|IT之家
- 多编程代理的职责与仓库隔离|dev.to
- Cline 与 Aider 的交互和执行比较|dev.to
- 前端进阶之旅