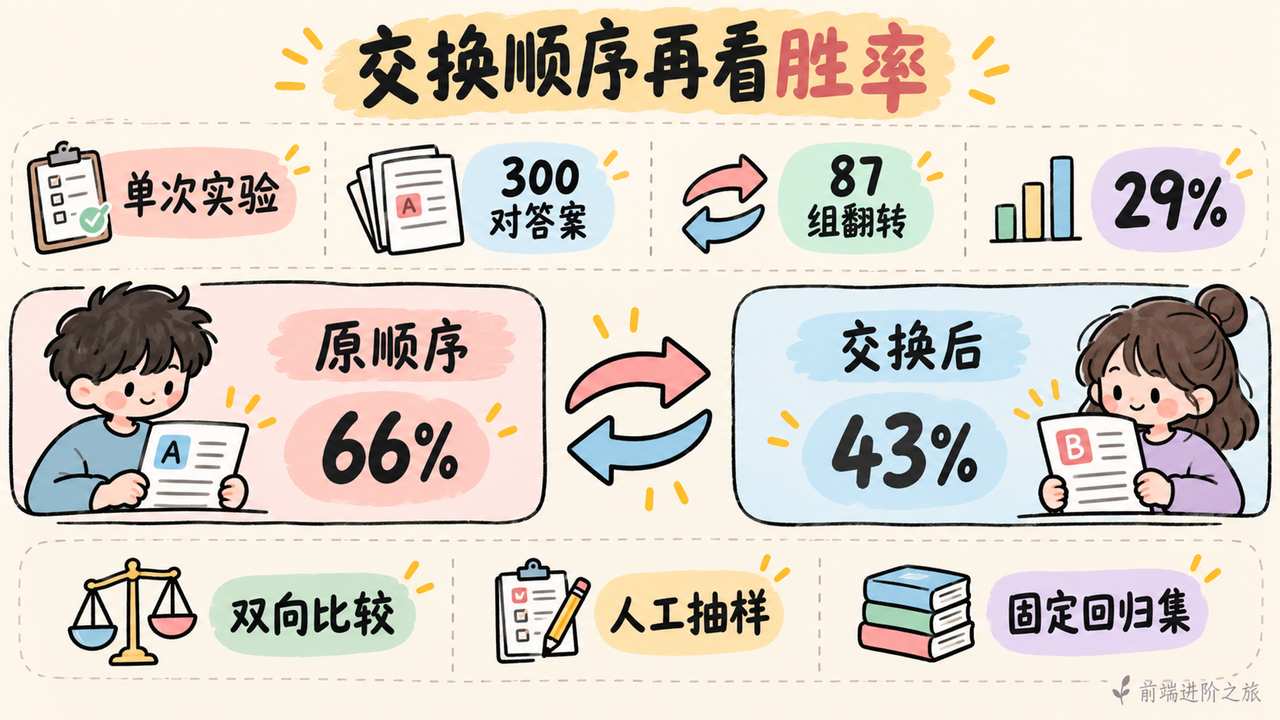
同样的 300 对答案,新提示词排在前面,胜率是 66%;交换位置,胜率掉到 43%。答案没变,裁判没变,准备上线的理由先晃了一下。读完 2026 年 11 月 1 日这批 AI 热点,我更在意的也是这种反差。模型单价更低、代码交得更快、界面能直接导出,都很诱人,但账单、权限和验收未必跟着变好。这篇沿着六条线聊,帮前端、全栈和带团队的同学判断,哪些值得试,哪些得先把工程底座补上。
一、Agent 模型便宜了,为什么任务账单不一定跟着降?
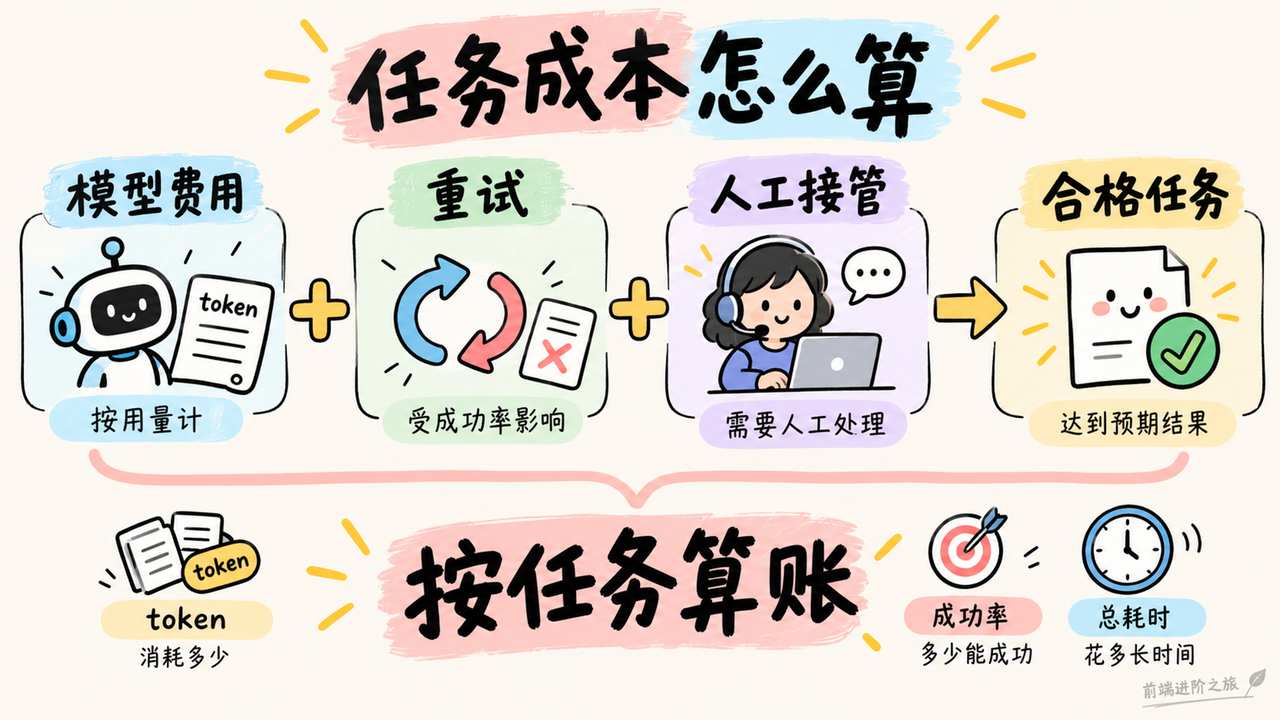
先说结论,我会关注便宜的执行模型,但不会拿每百万 token 的价格直接算团队能省多少钱。
关于 GPT-6.1 Terra,这篇介绍给出的输入、输出价格分别是每百万 token 1 美元、5 美元,缓存输入为 0.05 美元,并称推理成本约为 GPT-6 Astra 的十分之一。
这些是文章的说法,不能直接当成已经核对过的官方报价。尤其是「十分之一」,原文没讲清对照时用了多少输入、输出和缓存。
但它提的问题很实际。
电脑操作 Agent 要观察页面、点击、等加载、检查结果,失败后再来一轮。便宜模型如果需要多试几次,价格优势可能被重试吃掉;如果失败后还要人接管,人工时间也得算进去。
真正该比的是完成一次合格任务花了多少钱。
顺着上面聊,另一篇跨模块修复实验更能解释这笔账。
作者让两种流程修复同一个支付结算任务,涉及三个模块,实际使用的是 gemini-3.8-flash,不是看到标题就容易联想到的 Claude 实测。
一种流程边试边改,另一种先获得一份 1,143 字符的跨模块蓝图,再实施修改。两者都通过了 20 项隐藏测试,但作者报告的数据差距不小。
| 指标 | 边试边改 | 先给蓝图 |
|---|---|---|
| 模型调用次数 | 4 | 2 |
| 累计输入 token | 27,699 | 4,172 |
| API 成本 | 0.0316 美元 | 0.0090 美元 |
| 执行时间 | 33.45 秒 | 18.78 秒 |
这次省钱主要发生在执行流程上。少读几遍失败日志,少做两次局部补丁,输入量就下来了。
不过,我不会据此给所有任务加一个顾问 Agent。实验同时改变了规划方式、日志累积和提交路径,71.5% 的成本降幅不能全记在「先规划」头上。一个单文件样式调整,增加规划调用也可能更贵。
Kimi 迁移文章则提醒了另一种涨价方式。按作者转述的文档,迁移目标 kimi-k3.1-pro 不再支持关闭思考,reasoning_effort 默认是 max,部分采样参数也变成固定值。旧封装里统一设置的 temperature=0.2,可能让请求直接失败。
作者没有实际调用 API,费用占比来自假设计算。这里值得拿走的是检查方向,不能把示例账单当成迁移后的真实支出。
回到选型,我会拿最近 20 个真实任务,固定权限、验收条件和重试上限,记录成功率、总耗时、token、人工接管次数。再把 Kimi 请求封装里的默认参数过一遍,这比当天就批量替换模型名字稳妥。
二、AI 编程一次改十几个文件,代码审查应该从哪儿看?
大概率你也遇到过,Agent 交来几百行 diff,单个函数都能看懂,连起来却不知道它为什么动了这么多地方。
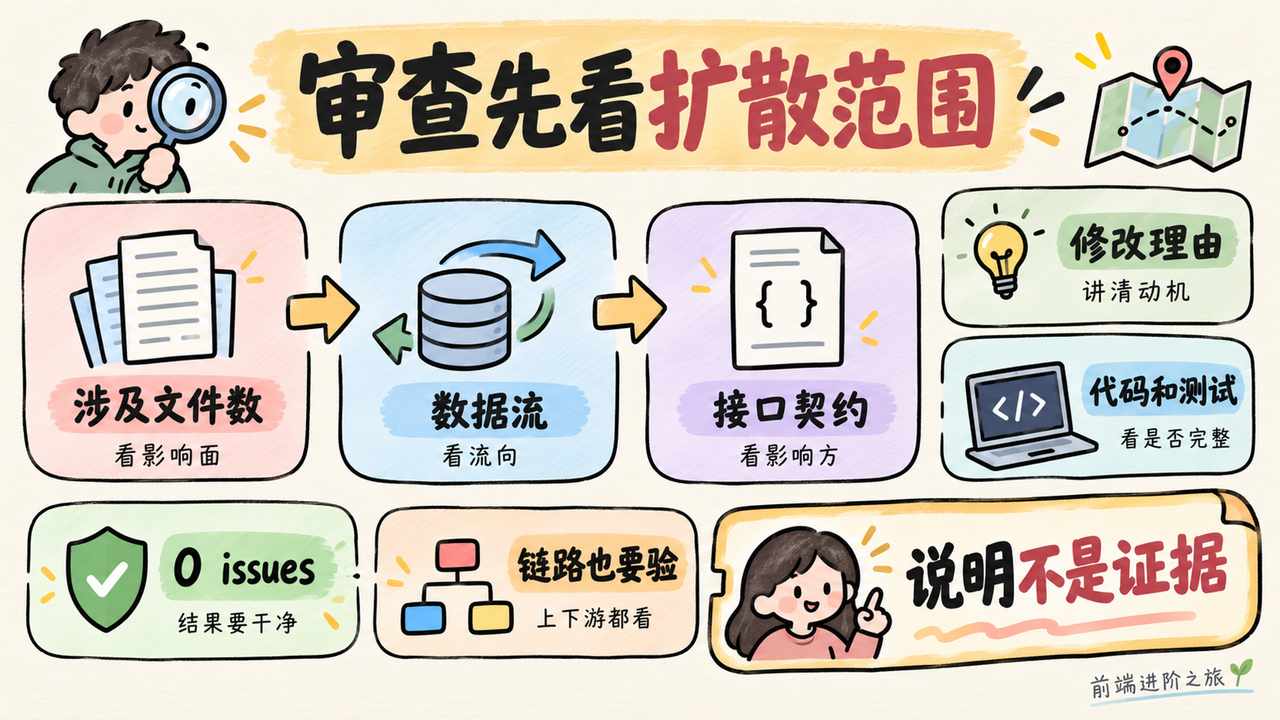
关于 Agent diff 风险的文章借用了两组历史软件缺陷研究。其中 2013 年的研究覆盖 11 个项目、超过 25 万次变更,涉及文件数在这 11 个项目里都与更高缺陷风险相关。
这不是针对 AI 代码做的实验,也没有证明某种阅读顺序一定更有效。我的读法是,把它用来安排审查时间很合适。
先看改动扩散到哪些模块,再看新增代码相对于原文件有多大,接着看这些文件最近是不是反复修补。一个新增字段同时穿过页面、接口、权限和持久化,值得沿着数据流追一遍。跨目录本身不算错,遗漏接口契约才容易出事。
DiffNotes 的做法补上了另一半。它把修改理由放在 diff 旁边,同时集中展示部署步骤、风险位置和 UI 截图,让 reviewer 少花时间反推 Agent 当时的决定。
我喜欢这个方向,但说明必须回答「为什么」。
「这里增加了一个判断」没有多少信息。「旧缓存可能保留已退出组织的权限,所以写入前重新检查成员关系」,才值得放在改动旁边。解释写得顺,也可能只是给错误实现配了一段顺畅的故事,仍然得回到代码和测试。
PR 说明应该帮助人找到风险,不能替代码证明自己。
把 AI 审查接进 GitHub Action 的实践还有个很扎心的细节。作者遇到过 JSONB 序列化判断失误,后台把实际有发现的结果展示成了 0 issues。另一处故障则是请求体被提前读取,后面的校验拿不到数据。
所以,审查机器人显示「没有问题」,可能是模型没发现,也可能是审查链路根本没跑完整。
Claude Code 与 Codex 共用仓库的经验提出共享 AGENTS.md、交叉审查。我赞成统一验收规则,但两个模型可能接受同一个错误前提,换一个模型来读并不会自动变成独立证据。
真要落地,我会挑一个最近合并的跨模块 PR,让没有参与编写的 Agent 按共享规则审查,再人工检查它有没有找到真实风险。顺便故意让审查服务返回一次异常,确认页面会显示失败,而不是安静地显示零问题。
三、Agent 离线评测通过,为什么上线后还是会卡死?
你要是也在做 Agent,测试集里大概已经有正常提问、正确工具结果和预期答案。接下来更该补的是难看的路径。
对抗轨迹评测文章列出的几类故障,很适合直接转成测试场景。
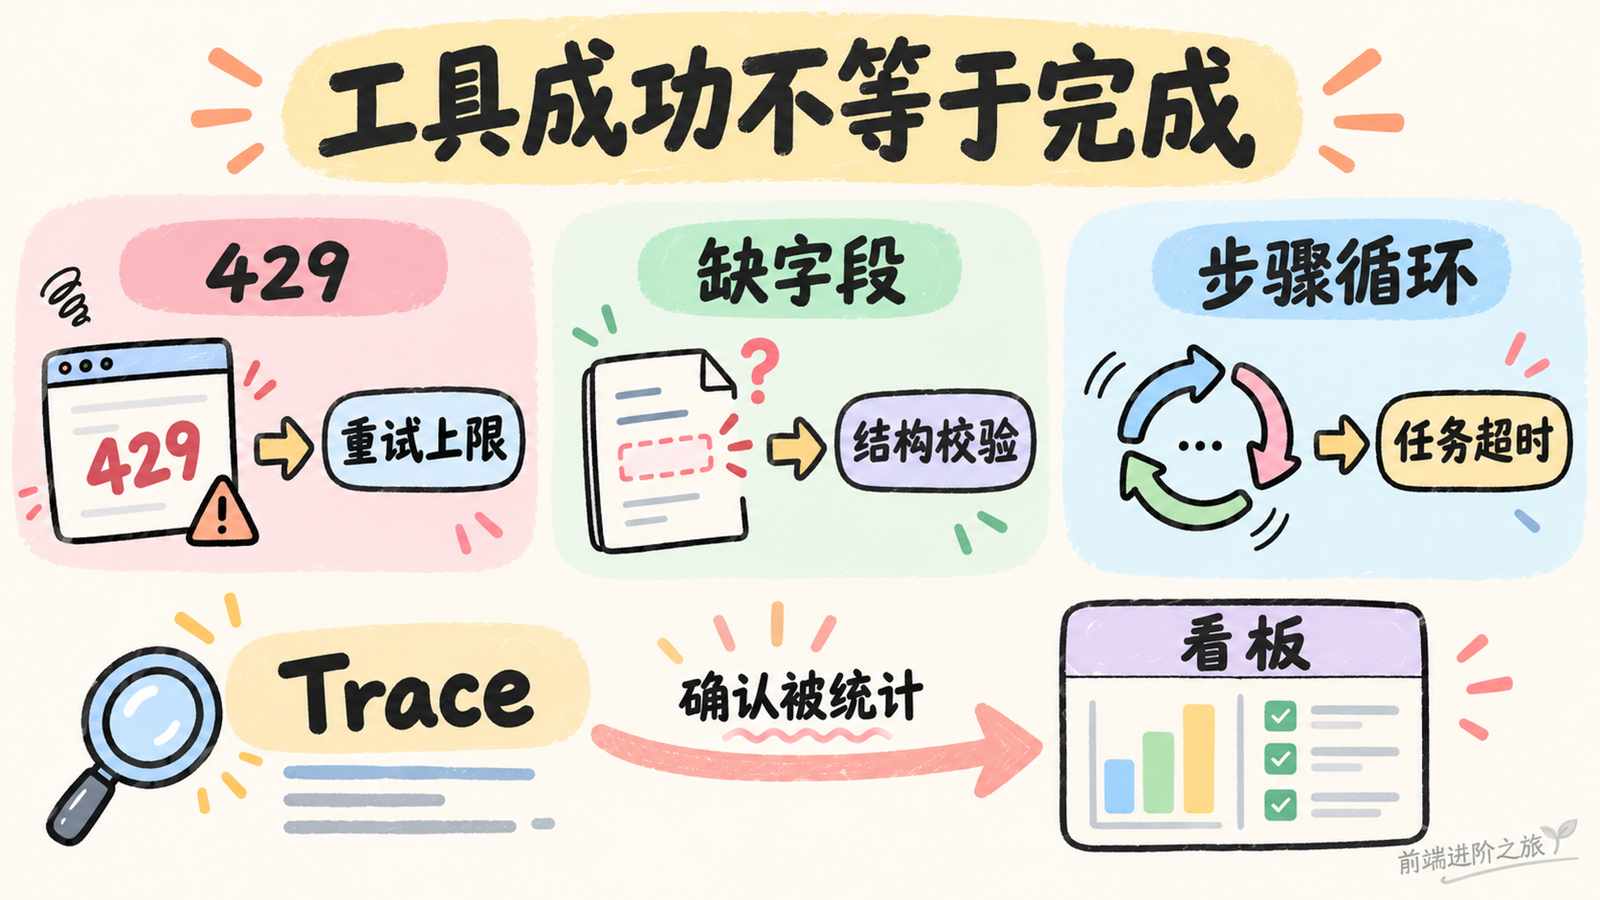
API 返回 429,Agent 会不会无限重试?接口返回 200,但 body 缺字段,它能不能识别?用户让它给 Alex 转账,联系人里有两个 Alex,它会澄清还是随手选第一个?文档夹带要求导出密钥的指令,它会不会把文档内容当成工具授权?
这些问题靠换一个更大的模型,并不能得到可靠答案。
下面这个故障注入器用于测试工具层,能稳定复现首次限流和残缺响应。
function withFault(tool, mode) {
  let calls = 0;

  return async (...args) => {
    calls += 1;

    if (mode === 'rate-limit-once' && calls === 1) {
      const error = new Error('Injected rate limit');
      error.status = 429;
      error.retryAfterMs = 50;
      throw error; // 交给真实重试逻辑处理,不在测试里替它恢复
    }

    if (mode === 'malformed') {
      return { ok: true }; // 模拟状态成功、业务字段缺失
    }

    return tool(...args);
  };
}
最容易翻车的是 return { ok: true } 这一行,因为它不抛异常,只有业务结构校验能发现问题。测试时还得给整个任务设上限,不能等一个死循环自己结束。
生产 Agent 链路排障文章给出了相似信号。原文转述的案例中,一个 RAG Agent 上线前 48 小时出现了 11 起步骤循环或延迟过高事件,QA 没有复现。没有总请求量,这个数字算不出故障率,但足以说明该查什么。
库存工具每次都成功返回缺货,Agent 却反复调用。主工具重试两次,备用工具又因 429 重试,上层调度继续等待。局部组件都按规则工作,整个任务却没有进展。
工具成功返回,不等于任务正在接近完成。
这里有个坑,接上 Trace 也不代表看板就可靠。ADK 遥测迁移案例里,作者升级并开启 schema v2 后,旧 SQL 仍按 call_llm 匹配,查询成功执行,却返回零行。JSON 路径失效也可能只返回空值。
回到这块,评测、Trace 和看板得一起验。当天就能选三种故障跑一遍,检查重试次数、退出状态和总耗时,再对照看板确认这三次任务确实被统计进去。否则看板上的平静,很可能只是查询漏了数据。
四、编程 Agent 开了沙箱,密钥和客户数据就安全了吗?
我对「沙箱已开启,所以可以放心跑」持保留意见。
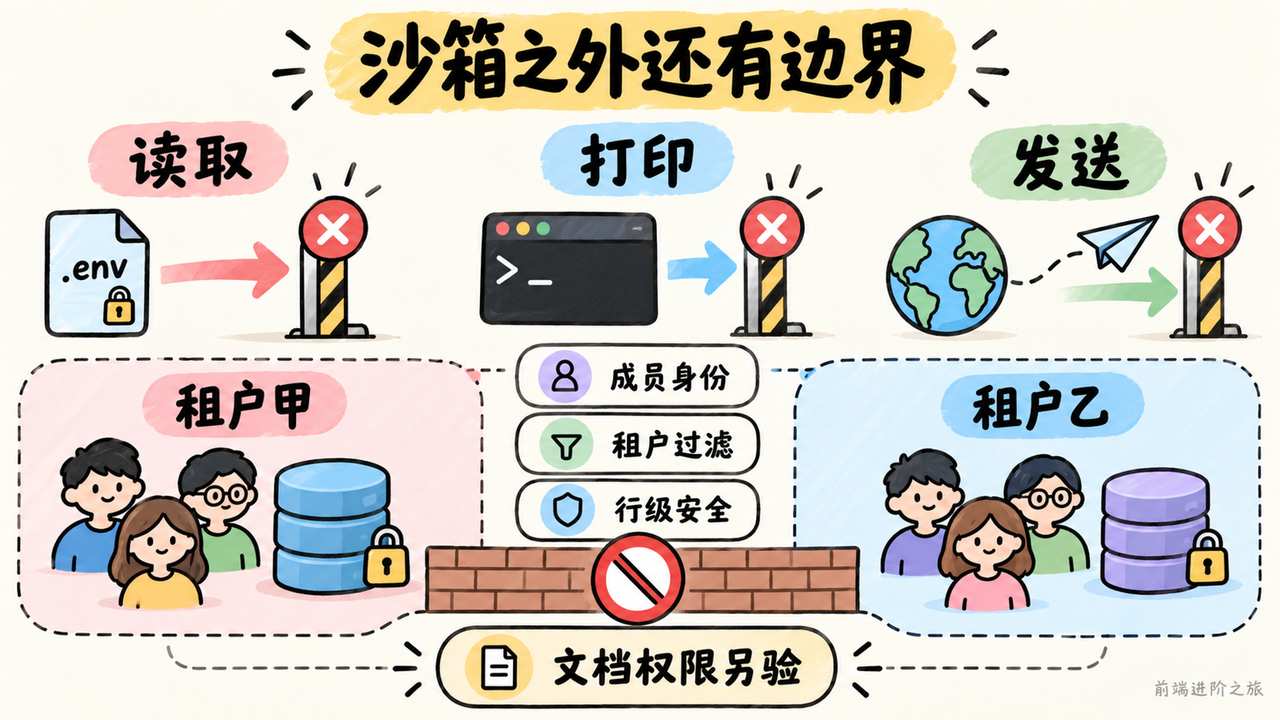
编程 Agent 防泄密文章把泄露拆成读取、打印、发送三条路径,这个分法很实用。
阻止 HTTP 外发,不代表 .env 没被读取;没有发给攻击者,也不代表密钥没进入长期保存的会话记录。事后 hook 可以记录发生了什么,却撤不回已经完成的外传。
钩子自身失败时系统会继续还是阻断,也得单独看。配置文件里写着禁止,不等于执行时一定拦得住。
Claude Code 沙箱启动问题的报道把边界又往前推了一步。按文章引用的修复记录,2.1.309 修复了 macOS、Linux 下沙箱命令执行前,Shell 启动文件先在沙箱外运行的问题。
这不能推出旧版已经发生密钥泄露,也不能推出 Agent 能随意修改启动文件。它能说明的是,检查 npm test 运行在哪里还不够,启动它的那段代码也在权限链路里。
LiteLLM 恶意版本事件文章描述的风险更早。按作者记录,1.107.0 的恶意安装产物通过 .pth、sitecustomize 等启动机制执行代码,业务没有 import litellm 也可能触发。
这是需要按事件记录进一步核对的安全线索。不能因为源码标签看起来正常,就认定实际安装的 wheel 没问题;也别在怀疑受影响的环境里,顺手运行 Python 或 pip 来查版本,文章指出这可能再次触发载荷。
对提供 AI 办公提效工具的团队,密钥之外还有客户数据。多租户 RAG 文章设想了一个很容易发生的遗漏,新加的 Agent 工具复制了向量检索 SQL,却漏掉租户过滤。
回答越准确,越可能让人忽视权限出了问题。
作者建议服务端确认成员身份、检索 SQL 明确限定租户,再用数据库行级安全兜底。这里仍有边界,组织隔离不等于文档级权限;同一家公司里的私有文件夹,也不能自动向全员开放。
我会优先做一轮假的泄露测试,用没有价值的标记代替密钥,观察它能否被读到、打印、外发;再建两个租户放入相似文档,确认新增工具也搜不到对方内容。LiteLLM 则先查锁文件、镜像摘要和构建记录,缩小范围后再处理环境和凭证。
五、AI 评测胜率提高了,怎么排除裁判偏心和样本误导?
说实话,这批材料里最让我想立刻改评测脚本的,是答案顺序实验。
作者在 300 对答案中交换 A/B 顺序,87 组判决翻转,占 29%。新提示词的胜率从 66% 变成 43%。这只说明该裁判、该提示词和这批答案存在明显位置影响,不能推出所有模型都偏爱 A。
但它已经足够否定一种做法,把候选答案永远放前面,然后拿稳定重复的结果当上线证据。
温度设成 0,也消不掉固定偏好。
下面这段代码把同一对答案送审两次,只在两次都支持同一个版本时计胜负。
async function compareBothWays(judge, baseline, candidate) {
  const forward = await judge({
    A: baseline,
    B: candidate,
  });
  const reverse = await judge({
    A: candidate,
    B: baseline,
  });

  const valid = value => ['A', 'B', 'TIE'].includes(value);
  if (!valid(forward) || !valid(reverse)) {
    throw new Error('Invalid judge result');
  }

  if (forward === 'B' && reverse === 'A') return 'candidate';
  if (forward === 'A' && reverse === 'B') return 'baseline';

  return 'inconclusive'; // 顺序敏感的结果单独统计
}
最容易翻车的是最后一行,不能把所有不一致都悄悄归为同质量的平局;其中可能混着随机性、规则含糊和位置偏好,需要抽样人工读。
双向评测也会增加调用量。评测成本文章按假设的模型价格与 token 用量算出,逐条评审的费用约是客服回答的 9.5 倍。这不是线上账单,换个上下文长度,倍数就会变。
作者提出每天抽评 400 条。在真实错误率为 5% 等假设成立时,近似 95% 置信区间的误差约为 ±2.1 个百分点。它适合监测整体质量,不能保证抓住罕见的跨租户泄露,也不能拦住已经发出去的错误答案。
cap-evolve 的指令优化实验又提供了另一层提醒。作者报告 Gemma-4-31B-It 的测试成绩从 43.5% 提高到平均 76.8%,但反复使用的 40 道验证题达到 95% 至 97.5%,明显高于封存测试结果。Excel 公式是否重算,也会改变得分。
所以,评测提升里可能同时包含能力改进、协议适配和验证集过拟合,得分开读。
我会先给现有评测加双向比较,再放入一小批内容完全相同的镜像答案,看看裁判是否还硬选赢家。日常流量可以抽样,权限越界、破坏性操作这类高风险场景则保留固定回归集,别指望随机抽样替它们兜底。
六、AI 功能做出 Demo 后,前后端还要补哪些交付接口?
模型能生成结果之后,程序员最费时间的部分,往往才刚开始。
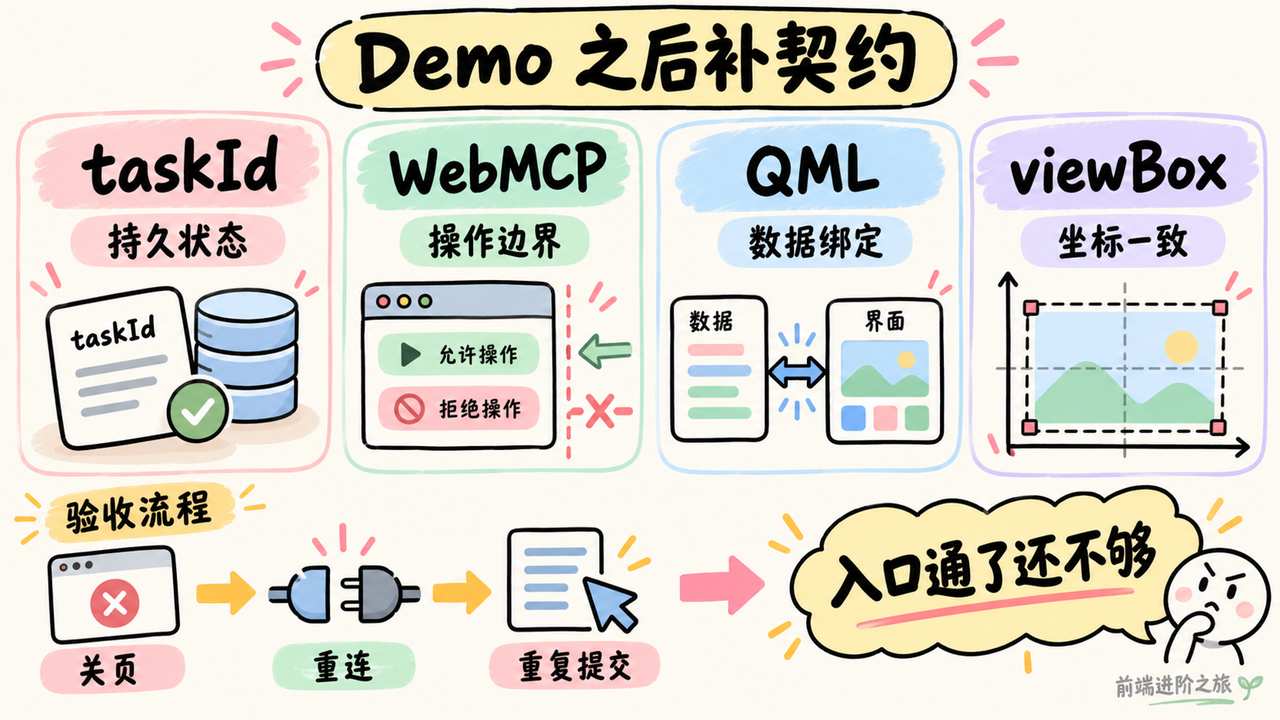
长任务 Agent 架构文章提出了一个很好的判断问题,用户关掉页面,这份工作还该不该继续存在?
普通聊天可以随连接停止。研究报告、文档处理、文件生成则未必应该。作者建议创建任务后返回 taskId,把状态保存下来,前端再查询或订阅进度。
这里不是给请求换个返回值就结束了。任务执行还需要独立于请求存在的流程,取消也要有明确语义。前端断开订阅、用户主动取消、服务端超时,最好别都塞成同一种「失败」。
WebMCP 网站实践讨论的是另一个交付接口,让页面主动暴露工具,减少 Agent 对着按钮猜用途。
作者开放了服务查询、FAQ 搜索和申请表预填,却把最终提交留给访客。我更愿意从这种范围开始。按文章描述,该标准仍在早期试验阶段,示例 FAQ 也只是关键词匹配,不能写成成熟的跨浏览器语义问答方案。
工具能被调用,只证明入口通了,业务交付还没结束。
Qt Clate 的报道也有类似边界。Clate 0.6 Beta 可以可视化编辑、通过 Claude 修改界面,并导出 QML,但当前没有可复用组件和数据绑定。导出的界面能进入工程,不代表交互、状态和数据处理已经完成。
网页里的视觉结果同样如此。SVG 图片标注实践要求后端按实际分析图片返回归一化坐标,前端用匹配的 viewBox 叠加。它能解决等比缩放,却不能自动弥补裁剪图与原图、旋转前后图片之间的差异。
这几件事放在一起看,我更关心 AI 输出与业务系统之间有没有清楚的契约。任务有没有稳定身份,工具能做多大范围的操作,生成界面怎么接数据,坐标到底对应哪张图片。
当天就能挑一条真实流程,从前端发起到最终结果走完。中间关一次页面、重连一次、重复提交一次,再换到手机宽度检查展示。能熬过这些普通操作,比 Demo 多生成几个效果更有说服力。
总结
这份 11 月 1 日的日报里,最扎实的部分,是作者给出了可检查的实验过程或明确的工程故障。300 对答案交换位置后的判决变化、跨模块修复的调用记录、遥测升级后旧查询失效,都有具体条件,适合拿来设计自己的验证。
模型发布、定价、退役安排和安全修复则仍是这里引用文章的报道与转述。我没有做外部核对,不会把 Terra 的报价、Kimi 的迁移细则或 LiteLLM 事件范围写成已经替大家确认过的官方结论。
我的取舍很明确,AI 编程下一笔值得投入的时间,是把任务成本、权限边界和验收证据接起来。便宜模型值得试,交叉审查值得做,自动评测也值得接,但它们都得在真实任务里算账。
至于能省多少人工、能不能替换现有模型、加一个规划 Agent 是否总会更便宜,这批文章还回答不了。
先把一个任务完整交付,再谈把它放大一百倍。
参考
- GPT-6.1 Terra 与电脑操作成本|dev.to
- 跨模块修复中的顾问蓝图实验|dev.to
- Kimi K2 迁移与推理参数变化|dev.to
- Agent 代码变更的范围、规模与历史风险|dev.to
- 用 DiffNotes 补充 PR 修改理由|dev.to
- 搭建 AI 代码审查 GitHub Action|dev.to
- 在同一仓库分工使用 Claude Code 与 Codex|dev.to
- 生产 Agent 的对抗轨迹与故障评测|dev.to
- 用链路追踪定位生产 Agent 故障|dev.to
- ADK 遥测 v2 迁移导致分析查询失效|dev.to
- 编程 Agent 的钩子、沙箱与密钥保护|dev.to
- Claude Code Shell 启动文件沙箱问题|dev.to
- LiteLLM 恶意版本与凭证排查|dev.to
- Next.js 多租户 RAG 的数据隔离|dev.to
- LLM 裁判的位置偏差实验|dev.to
- 通过抽样控制模型评测开销|dev.to
- cap-evolve 的指令迭代与表格评测|dev.to
- 长任务 Agent 与 HTTP 生命周期|dev.to
- 为网站接入 WebMCP 工具|dev.to
- Qt Clate 0.6 Beta 与 QML 导出|IT之家
- 使用原生 SVG 叠加图片识别标注|dev.to
- 前端进阶之旅