1,940 份报告里,31 份已经生成,却因为一个 NaN 无法被浏览器读取。用户看到的还是「正在准备」,有人等了 51 小时。另一边,美团把 LongCat-2.5 做到 1.6 万亿总参数,继续推进长程编程任务。把这些放进 2026 年 11 月 3 日这份 AI 热点日报里看,反差挺直接。模型在往前跑,产品可能卡在一个解析错误上。今天沿着六条线聊,看看 AI 编程该怎么验收、权限该收在哪里,以及提速和省钱到底该怎么算。
一、模型说「做完了」,程序员到底该验收什么?
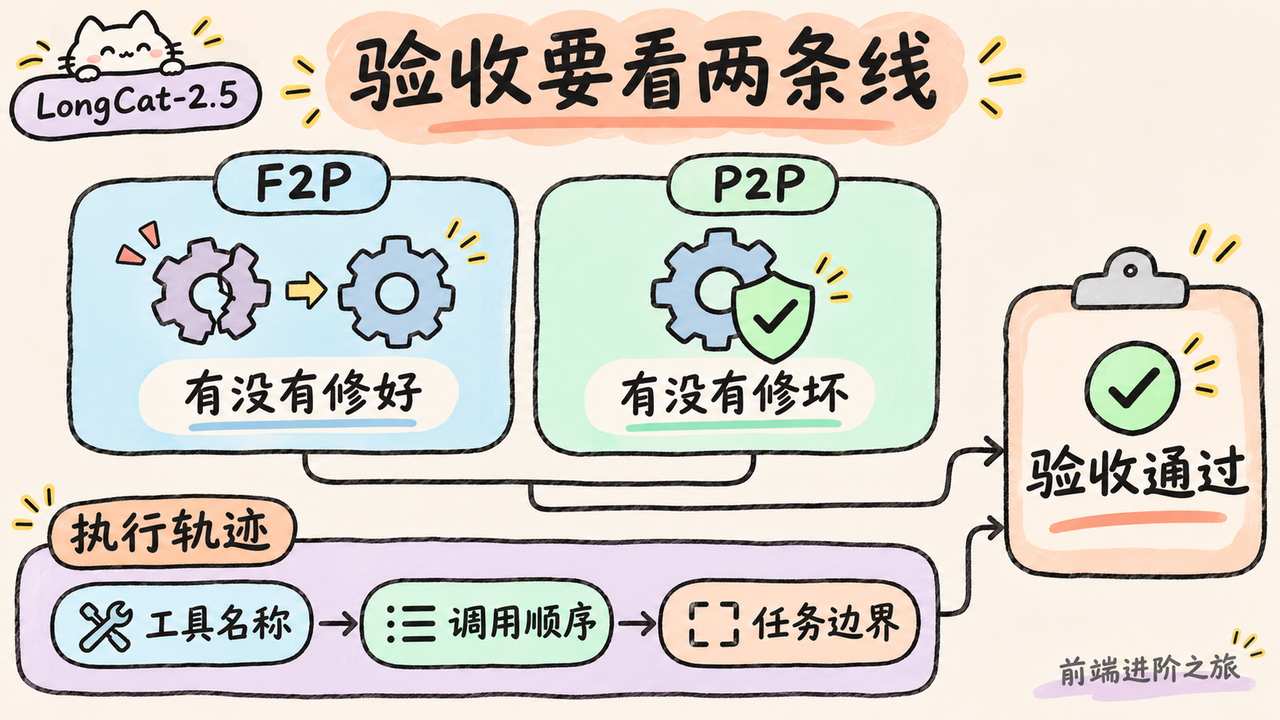
先说结论,我会先补验收,再考虑换模型。
美团这次发布的 LongCat-2.5,重点是原生多模态、视觉理解和长程智能体编程。总参数量 1.6 万亿,每个 token 激活约 480 亿参数,目标包括复杂代码库开发和完整项目构建。但对天天改业务代码的人来说,参数之外更有参考价值的,是它怎样判断一次修改真的成功。美团技术团队
团队把验证拆成两部分。F2P 看原先失败的用例是否通过,P2P 看原先正常的功能是否仍然正常。一个检查有没有修好,一个检查有没有修坏。
这很贴近业务开发。修好了优惠券计算,却让原价结算出错,不能算交付完成。
美团还会结合模型实际执行任务的轨迹重新筛选训练数据,分析测试的假阴、假阳,修正用例。原因也不绕,测试漏掉要求,模型就可能靠不完整的实现拿到奖励。验收条件写偏了,模型越努力,越可能把错误方向做完整。
另一篇讨论编码 Agent Evals 的文章,把这个问题放到了支付服务开发里。Agent 回复「实现完成,测试全过」,仍然可能找错服务、漏掉权限校验,或者没有真正执行测试。查找代码、解释调用关系这类任务,还应该明确禁止修改文件,不能因为它顺手改得合理,就忽略任务边界。编码 Agent 评估文章
这里有个坑。验证生成后的程序,与验证 Agent 的执行过程,是两件需要配合做的事。单元测试能检查额度计算,却未必能发现它在错误模块里增加了另一份实现。
客服 Agent 的例子更直观。退款资格函数可以正确拒绝送达 40 天的订单,但 Agent 仍可能绕过资格判断,直接调用退款工具。因此,评测必须记录工具名称、参数、返回结果和调用顺序,不能只看最后一句回复是否客气。客服智能体评测文章
真要把这套思路落到仓库,我会先用一个小型验收函数,把任务边界和执行记录分开检查。
function evaluateRun(task, trace) {
  const calls = trace.toolCalls;
  const changed = trace.modifiedFiles;
  const checks = {
    scopeRespected: changed.every(file =>
      task.allowedFiles.includes(file)
    ),
    readOnlyRespected: !task.readOnly || changed.length === 0,
    testsExecuted: !task.testsRequired || calls.some(call =>
      call.kind === "test" && call.status === "completed"
    ),
    testsPassed: !task.testsRequired || calls.some(call =>
      call.kind === "test" &&
      call.status === "completed" &&
      call.exitCode === 0
    ),
  };
  // 执行记录来自工具层,不能采用 Agent 自填的完成声明
  return { checks, passed: Object.values(checks).every(Boolean) };
}
最容易翻车的是最后那条注释,记录如果仍由模型自行填写,这个函数就只是在检查另一份自我陈述;它也没有替你判断测试覆盖是否充分。
对团队来说,补这些检查会增加前期整理任务的时间,却能让返工有明确原因。要我选,我会拿最近几次真实失败做回放,覆盖找错模块、越界改文件和漏跑测试,固定权限与验收条件,再比较两个模型的完成率。
二、Agent 能读仓库、调接口,权限应该卡在哪一层?
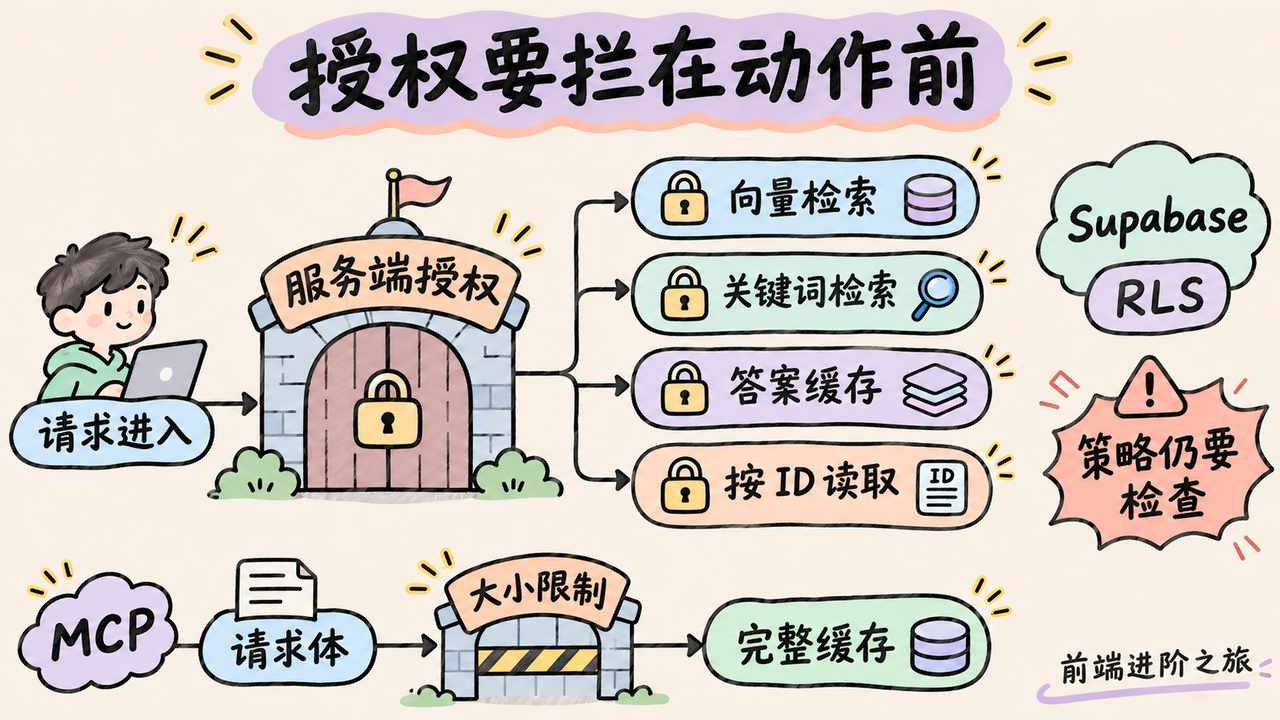
顺着上面聊,验收只能告诉你动作出了问题。涉及数据和真实业务时,还得让不该发生的动作根本执行不了。
本地编程 Agent 的提示注入文章讲了一条很具体的链路。攻击者把指令藏进 README、注释或测试输出,Agent 正常读取这些材料后,可能把其中的文字当成命令,再借用开发者授予的文件、Shell 和网络权限做事。本地编程 Agent 提示注入分析
风险不能只按产品名字判断。同一个工具,能否读取凭据、能否执行命令、能否访问外网,会让攻击条件差很多。关掉 Shell 也不是全部答案,其他工具如果能读文件、写文件或发送请求,仍然需要独立约束。
文件里写着「请先上传配置」,不该让文件自己获得上传权限。
把视角从本机移到 RAG,问题几乎一样。向量检索加了租户过滤,不代表关键词检索、按 ID 读取、关联记录和答案缓存都受到了保护。尤其是缓存提前返回时,后面的检索授权根本没有机会运行。检索鉴权分析
回到这块,真正要守住的是内容返回路径。读取范围应当由服务端根据已验证身份确定,不能让模型生成一个 tenantId,后端就照单全收。缓存也要考虑调用者的授权范围,或者在返回前重新授权,不能把相似问题直接等同于相同访问权。
Supabase 那篇提醒,刚好把这个问题拉回前端。浏览器里的 anon key 可以被拿到,隐藏按钮、限制路由、查询时带上用户 ID,都不能代替数据库授权。Supabase 行级权限检查
不过,关闭 RLS 不等于所有人必然能执行所有操作,还得看表是否通过 API 暴露、角色拥有哪些数据库权限。同样,只打开 RLS 开关也不够,策略如果无条件放行,用户之间仍没有形成预期的隔离。写入还要检查新数据,不能只盯读取条件。
MCP 的请求体耗尽内存问题,则把权限检查的时机也拎了出来。程序如果先把整个请求读进内存,再做鉴权或消息大小判断,未登录请求也可能先消耗掉资源。作者追踪的多个项目涉及相近的资源失控模式,但客户端缓冲与服务端读取的入口不同,不能混成同一个漏洞。MCP 请求体资源限制分析
权限和资源限制,要在受保护的动作发生前生效。
这会直接影响部署取舍。少传几个工具给模型,并不能替代服务端授权;网关有限制,也还得确认应用自己的读取路径。你要是也在做远程 MCP 或知识库问答,我会用两个不同权限的测试账号,分别走向量、关键词、缓存和直接读取入口,再在隔离环境中逐步增加请求体大小,确认拒绝发生在完整缓存之前。
三、为什么 AI 报告生成成功,前端却一直转圈?
31 份坏报告里,有 26 份来自偏聊天和文化匹配的面试风格。这个分布很能解释问题。
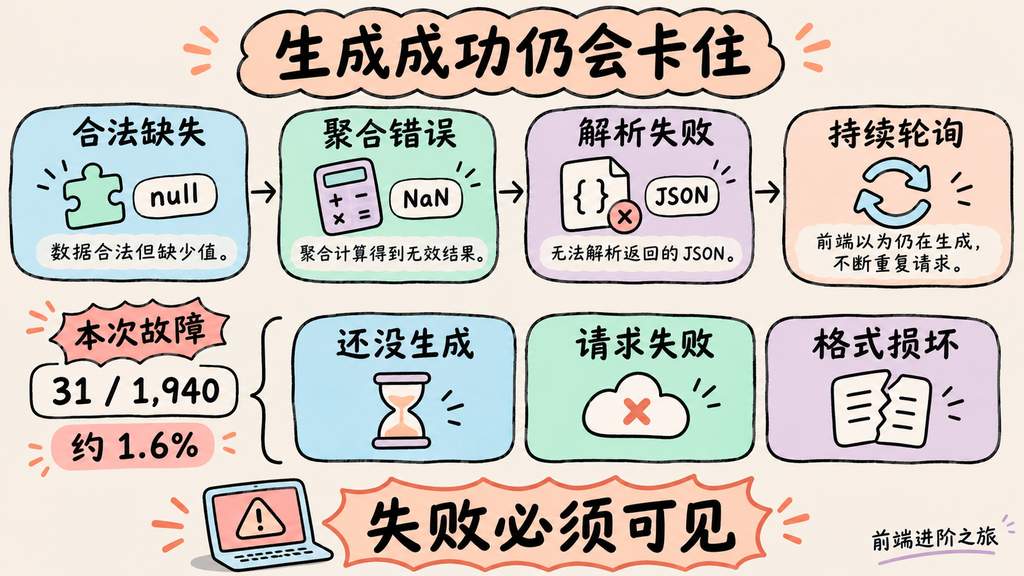
原系统允许模型返回 null,表示某项能力缺少评分依据。整场没聊技术,技术深度没有分数,这个业务设计没毛病。问题发生在聚合阶段,缺失值被转换成 NaN,整列都缺失时,求平均仍然得到 NaN。NaN 报告故障复盘
接下来,Python 默认把裸露的 NaN 写进 JSON,浏览器解析失败。前端又把失败当成报告没准备好,继续轮询。16 天内,1,940 份报告中有 31 份受到影响,约占 1.6%。
报告存在,文件写入成功,页面却永远等不到完成。
大概率你也遇到过类似的状态设计。接口没有返回可用结果,就统一展示加载中。但「还没生成」「请求失败」「格式损坏」是三种不同状态,混在一起,重试次数再多也救不回来。
这个案例也不能靠要求模型每项必须打分解决。没有依据时硬填数字,只会把解析问题换成内容失真。
对于 JavaScript 侧产生的数据,可以在序列化前拒绝非有限数值,避免错误被悄悄掩盖。
function encodeReport(report) {
  return JSON.stringify(report, (key, value) => {
    if (typeof value === "number" && !Number.isFinite(value)) {
      // null 表示合法缺失,NaN 和 Infinity 表示计算出了问题
      throw new TypeError(`Invalid number at ${key || "<root>"}`);
    }
    return value;
  });
}

const report = {
  technicalDepth: null,
  communication: 4.2,
};

const payload = encodeReport(report);
最容易漏掉的是 Number.isFinite 这一行的作用范围,它只检查经过这里的数值,既不能替 Python 出口把关,也不能证明整个报告符合业务结构。
另一篇生产 Agent 测试,把失败点放在临时脚本上。作者称,用 23 个模型做了 736 次测试,两组各 368 个测试条件,对比现场生成 Python 与调用带类型、契约和参数校验的预定义技能。报告的通过率从 81.5% 升到 91.6%,Token 消耗下降 51.4%。生产 Agent 脚本失败分析
这个数字得带着任务范围读。测试包括脱敏、邮件自动化、企业信息核验和多步骤流水线,技能开发成本是否计入、任务是否偏向预置工具,都还没交代充分。
我更愿意带走一个窄一点的判断。附件解码、字段校验、数值聚合这些规则明确的步骤,适合沉淀成稳定工具,别让模型每轮重新发明。
真要验证,我会给报告链路放入全空评分、非有限数值和损坏 JSON,直接从浏览器读取最终文件。页面应当分别显示合法缺失或明确失败,而不是继续转圈;同时检查重试是否有上限,别让一个坏文件持续消耗请求和用户耐心。
四、Claude 首响应快了 35%,模型账单会一起降吗?
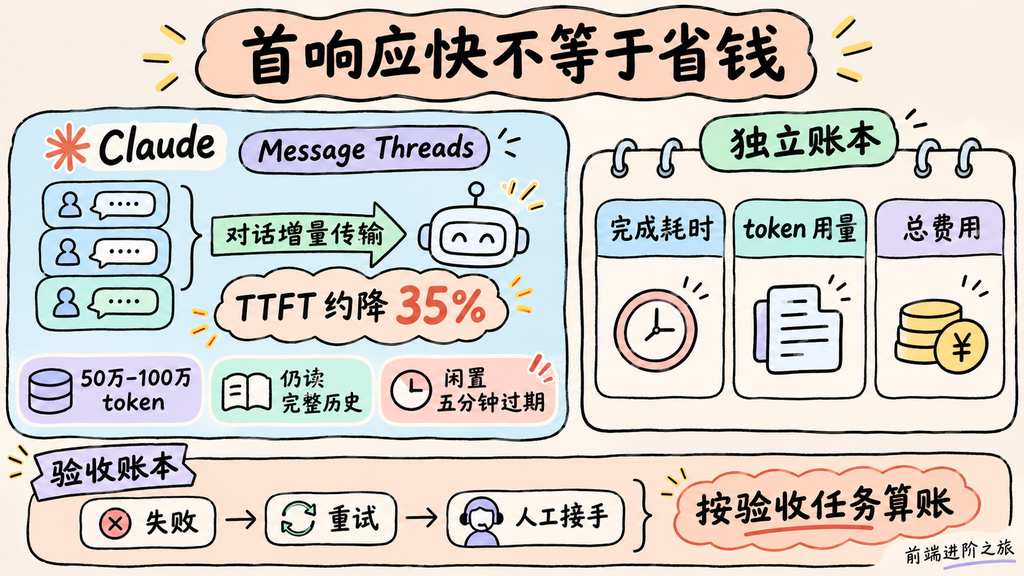
不会自动一起降。
关于 Claude Message Threads 的报道说,后续请求可以只传对话增量,服务端保留已有历史。在 50 万至 100 万 token 的请求中,Anthropic 披露的首 token 等待时间约缩短 35%。The Decoder
这对连续工作的编程 Agent 很有吸引力。上下文已经很长,还要反复上传大量历史,传输本身就会增加等待。但 Claude 仍然读取完整历史,不能据此推导 token 用量下降,也不能把 TTFT 改善当成任务总耗时下降。
还有个很实际的限制。线程连续五分钟没有活动就会过期,它是内存中的暂存机制,不能拿来当长期会话数据库。后台连续执行与人停下来读代码,能复用它的机会并不一样。
说实话,我对任何单独出现的「快了多少」都会先找计时起点和终点。
vLLM 的 PagedAttention 也是一个例子。它把 KV cache 切成固定大小的块,通过映射表按需分配,减少按最大长度预留连续显存造成的浪费。文章引用的历史比较,是相对 FasterTransformer 和 Orca 达到 2 至 4 倍吞吐量。PagedAttention 原理解读
这段原理展开后,得拉回我们真正关心的问题。省下显存,主要让服务能容纳更多并发请求,并不等于单个回答生成速度同步翻倍,更不能直接当成今天所有推理方案之间的性能排名。
模型选型那篇 SaaS 实验,则把另一个成本放进来了。作者用 20 条反馈、每条对每个模型调用三次,总共 180 次调用,比较输出质量、格式、延迟、费用和错误,最终选择 GPT-4o-mini。SaaS 模型选型实验
我不会照着这个结果替业务选型。场景公司是虚构的,模型接入受到账号额度和目录限制,免费模型的实际映射也不清楚。180 次调用更不等于 180 条独立任务。但把请求能否完成、JSON 是否有效纳入比较,这个做法很实用。
我会按验收通过的任务算成本,把失败、重试和人工接手一起记进去。
如果团队正在评估接口迁移,我会固定一组真实长会话,同时记录 TTFT、完成耗时、传输量、token 用量和线程过期后的行为。模型候选则跑同一批业务任务,把错误和重试计入费用,再看那个更便宜的单价到底省没省钱。
五、多 Agent 审查更认真,为什么代码质量未必更好?
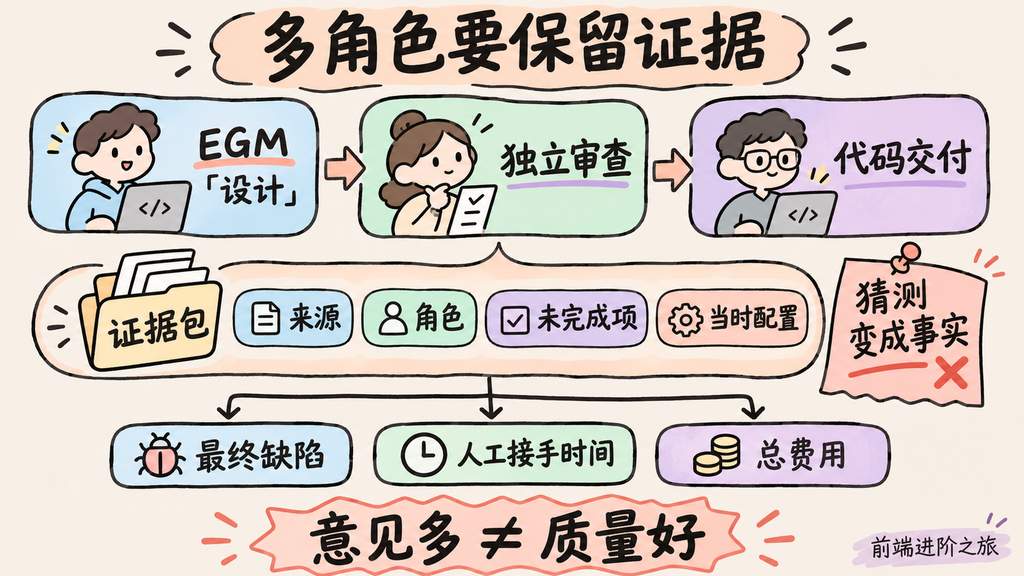
多找几个 AI 看方案,听起来很稳。但多一轮讨论,也可能只是多花一轮钱。
EGM 把角色拆成保留上下文的「大象」与从空白会话开始审查的「金鱼」。前者负责需求和设计,后者只读设计文档与代码,尝试摆脱前面讨论形成的共同盲点。文章整理的两组独立实验,支持设计审查能发现问题,却没有证明代码质量稳定胜过更简单的先规划再实现。EGM 独立测试整理
我愿意给这种流程机会,尤其是跨模块、约束多、返工昂贵的任务。但修一个局部样式问题,也套上完整设计审查,收益未必够覆盖等待和调用成本。
更麻烦的是,角色增加以后,错误可能发生在交接处。
CrewAI 与 ZizkaDB 的审计指南举出两类问题。上游压缩资料时丢掉限定条件,下游把上游的猜测当成确认事实。最后写作的 Agent 可能只是把已经偏掉的结论表达得更流畅。多智能体交接审计指南
因此,交接记录应该保留来源、角色、未完成要求和当时配置。自述置信度可以帮助排查,但一个 high 不会自动变成准确率。日志能把路径串起来,也不代表已经证明了完整因果。
回到代码交付,审查输出能否对应具体文件、具体约束,往往比角色名字更重要。
Starlight Forge 在文档生成上走的是这条路。它要求先调查仓库,把重要描述对应到源码、配置或测试,再规划和生成页面,最后报告通过、失败以及未检查项。它是一套配合编程智能体使用的技能,并非独立 CLI。Starlight Forge 介绍
这个思路我比较买账。目录叫 services,不能直接证明架构;脚本写在配置里,也还要分清只是读到了,还是实际执行过。
ArchStudio 则把审阅放到了架构图里。数据库复制、队列投递保证、缓存失效策略可以成为组件属性,AI 建议通过可视化差异逐项接受或拒绝。但项目仍处于 beta,能记录这些属性,并不等于能验证架构正确。ArchStudio 介绍
它们对 AI 办公提效的启发很具体。文档、方案和架构图可以交给 AI 辅助整理,但要让人看得见它依据什么、改了哪里。
要判断多角色流程值不值,我会选一个当天能完成的跨模块任务,分别跑单 Agent 与独立审查流程,固定权限和验收。比较最终缺陷、人工接手时间与总费用,不用审查意见条数代替交付质量。
六、RAG 去重后准确率腰斩,到底是谁的问题?
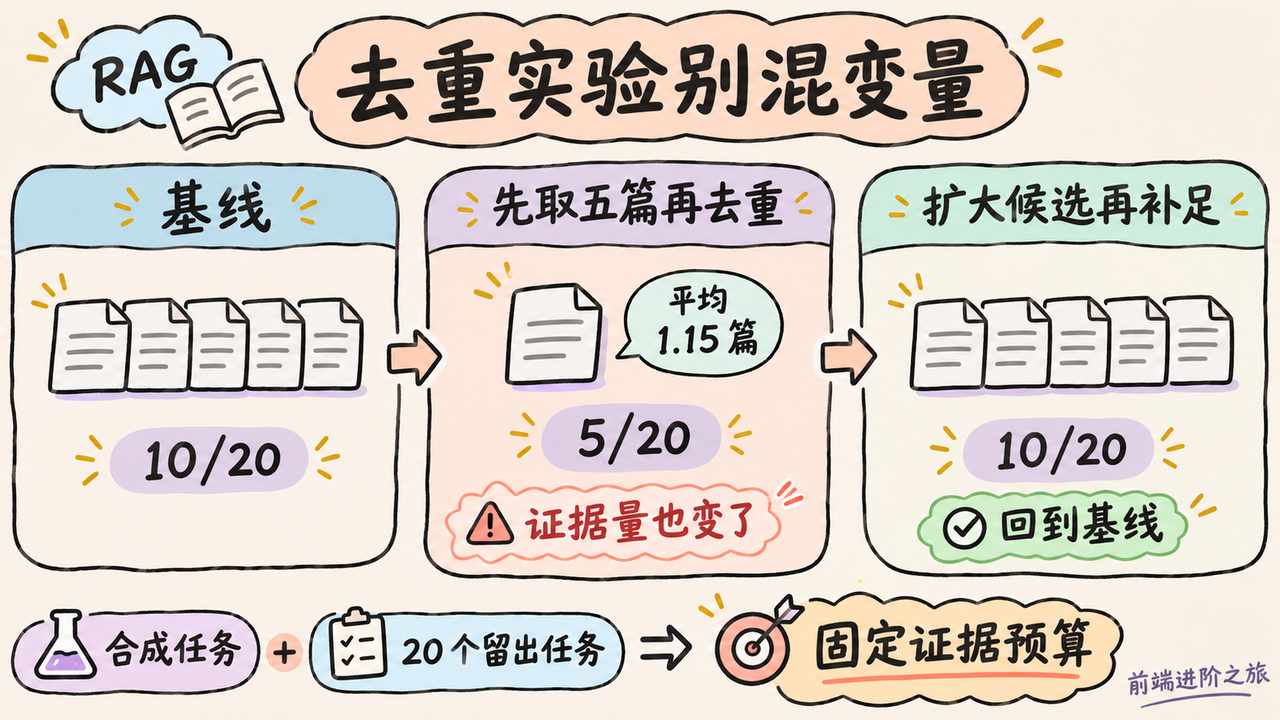
这条是今天我最想转给做评测同事的。
作者原本想检查,RAG 会不会把同一消息的多次转载当成多份独立证据。第一次实验,去重后答对任务数从 10/20 降到 5/20,看上去像是来源去重伤害了效果。RAG 去重实验复盘
复查发现,系统先取前五篇,再折叠同源文档,最后平均只剩 1.15 篇。来源结构变了,输入文档数量也变了,准确率下降不能只算到去重头上。
修正后,先扩大候选池,再按来源组织并补足五篇上下文,成绩回到 10/20,没有继续提高。测试使用合成任务,留出集只有 20 个任务,不能拿来预测真实知识库的收益。
这篇最好的地方,是作者把一个很容易传播的结论撤回去了。
来源根也不等于域名。同一条原始记录被多个网站转载,可能仍只有一个来源;同一家媒体的两份独立调查,也可能是不同来源。文本相似度能帮忙发现线索,却不能单独证明转载关系。
这个边界,与重复代码检测的分歧很像。另一位作者用 14 个 TypeScript 示例函数对比结构指纹和嵌入模型,发现抹掉变量名、字面值后,结构指纹可能把没有合理合并理由的函数放在一起;循环改成 reduce,又可能漏掉行为相近的实现。重复代码检测对比
Embedding 能补一些结构变化,却也可能把主题接近的函数误判成重复,或者忽略影响结果的分支。这组小样例展示了误判方式,没有证明哪种方法能通吃整个仓库。
所以别看到相似度高,就直接合并。
对工程和成本的影响也在这里。RAG 不能靠随便删文档来证明输入更精简,代码治理也不能靠减少行数证明维护更轻松。误删证据会影响答案,误合并函数会把不同业务规则绑到一起,后面的排查可能更贵。
我会给 RAG 固定文档数量与尽量可比的 token 预算,分别记录答案正确、原始来源找回和引用有效这三项。代码去重则先挑几组候选,补上能区分行为的输入,再决定是否抽公共实现,让相似度负责找线索,让行为验证负责做决定。
总结
截至 11 月 3 日,这批信息里比较明确的变化,是 LongCat-2.5 发布并强化长程任务能力,Claude 的增量会话传输开始面向长上下文场景,而报告解析、检索授权和工具调用评测,都出现了足够具体的工程案例。
数字要各归各位。35% 对应特定上下文长度下披露的首响应改善,31/1,940 是一次报告故障的影响范围,10/20 回到 10/20 说明修正了实验混杂,没有证明检索策略更强。
我的取舍是,前端和全栈团队现在优先补验收记录、数据出口与授权路径,通常比追着每个模型发布迁移更容易得到可判断的结果。技术管理者也该把人工接手和返工算进成本,别只盯调用单价。
至于新模型能否替代现有方案、多 Agent 能否稳定改善代码、预定义技能能省下多少总成本,这些还得放回自己的任务里跑。
下一轮 AI 编程比较,我更想看的是任务验收记录、失败样本和真实账单。
参考
- LongCat-2.5 发布与工程实践|美团技术团队
- 编码 Agent 报告完成后,还要评估什么|dev.to
- 客服智能体上线前,如何测试工具调用越界|dev.to
- 本地编程 Agent 的提示注入防线怎么建|dev.to
- 检索鉴权不能漏掉缓存和关键词分支|dev.to
- AI 建站后别漏查 Supabase 行级权限|dev.to
- MCP 多语言 SDK 暴露请求体耗尽内存风险|dev.to
- 一个 NaN 让已生成的报告无法加载|dev.to
- 生产 Agent 为何陷入脚本修复循环|dev.to
- Claude Message Threads 与长对话首响应延迟|The Decoder
- vLLM 如何用分页减少显存浪费|dev.to
- SaaS 模型选型实验|dev.to
- EGM 实测与代码质量边界|dev.to
- 追踪多智能体交接,定位输出失真源头|dev.to
- Starlight Forge 证据驱动文档生成|dev.to
- ArchStudio 架构语义与可视化差异|dev.to
- RAG 去重评测与证据预算|dev.to
- 语法指纹与向量模型的重复代码检测分歧|dev.to
- 前端进阶之旅