74 起隐私严重事件,在代码合入前被 AI 生成的测试发现了。这是 Meta 团队报告的半年数据。但另一边,Agent 花了三个小时,把界面、后端、迁移和部署都交齐,却把通用事件入口做成了 GitHub 专用系统。代码能跑,需求照样能做偏。读完 2026 年 11 月 16 日这批 AI 热点,我更关心程序员该怎么验收结果。这篇沿着测试、模型成本、架构、知识库、权限和部署六条线聊,给正在做 AI 编程和 AI 办公提效的同事一些取舍依据。
一、AI 生成的测试,怎么证明它真的抓到了 Bug?
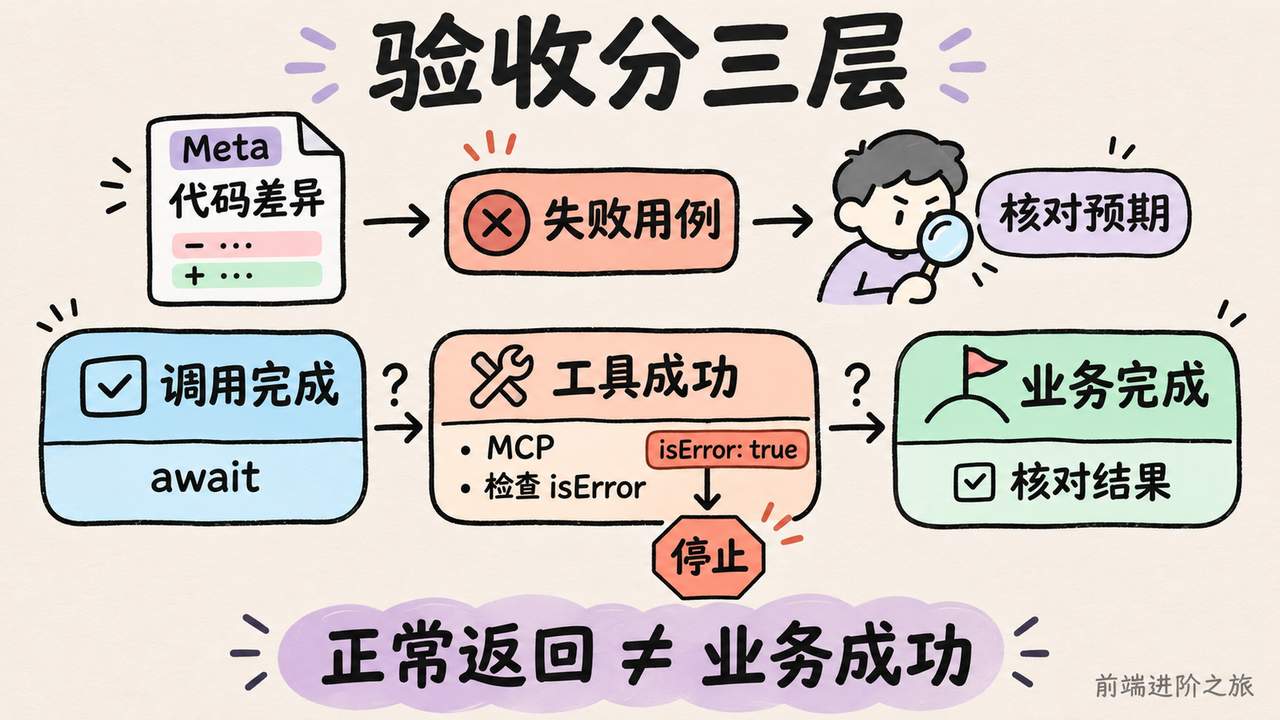
先说结论,我更看好能交出失败用例的 AI 审查。
Meta 的 Catching JiTTests 已经进入生产基础设施。按照团队披露,它在 2026 年上半年、代码合入之前,发现了 74 起隐私严重事件,工程师反馈的真阳性率为 60%。这组数据来自报道,不能把 60% 理解成所有代码缺陷的检出率,也不能理解成隐私事故减少了六成。MarkTechPost
它做的事情很具体。读正在审查的代码差异,猜测可能引入的问题,再生成一条能够运行、能够暴露问题的测试。比起 PR 下面一句「这里可能存在越权」,工程师至少能拿到输入、执行路径和失败结果,核查起来更直接。
但这里有个坑。
测试失败,也可能是测试坚持了已经过时的行为。例如,新需求明确要求管理员可以查看某类记录,生成测试却仍然断言所有用户都不能查看。这个红灯证明行为变了,还没证明改错了。
Meta 因此区分了两条路线。一条把每个 diff 都当作可疑变异,找出新旧版本的行为差异;另一条会结合代码、标题和摘要理解改动目标,再围绕风险生成测试。后者得到的「弱捕获」,仍然只是候选问题。
失败用例是审查证据,预期是否正确还得有人判断。
另一个更贴近日常全栈开发的例子来自 MCP。AgentInspect 维护者用不调用模型的合成测试,展示了一个容易漏掉的情况。await 正常结束,返回结果却带着 isError: true。调用完成、工具成功、业务完成,是三层不同的判断。dev.to · MCP 调用测试
下面这段 JavaScript 用一次合成失败,检查调用方有没有把工具返回的错误继续当成功处理。
const client = {
  async callTool() {
    return {
      isError: true,
      content: [{ type: 'text', text: 'Synthetic request rejected' }]
    };
  }
};

async function runTool(client, request) {
  const result = await client.callTool(request);

  if (result.isError === true) {
    throw new Error('工具报告失败'); // 正常返回也必须检查结果
  }

  return result;
}

await runTool(client, {
  name: 'lookup_policy',
  arguments: {}
});
最容易翻车的是 isError 那一行,即使它没有报错,也只能继续检查业务结果,不能直接宣布退款到账、邮件送达或者数据写入成功。
回到这块,Meta 的生产案例和 MCP 的合成测试,规模差得很远,却给了同一个工程提醒。验证要落到具体行为上,而且得说明自己验证到了哪一层。
要我选,我会先给现有工具调用补一组故障注入。让假客户端分别返回拒绝、空结果和超时,检查流程会不会停止,再确认界面有没有把失败显示成「已完成」。这件事当天就能跑完,也比先给所有 PR 加一个 AI 评论员更容易看出收益。
二、Qwen4-Max 便宜了,编程 Agent 就该换模型吗?
Qwen4-Max 是当天最密集的一条发布消息,几篇报道讲的是同一个模型,不能算成几次独立验证。
按报道,它采用 2.4 万亿主干参数的 MoE 架构,每个 token 激活约 710 亿参数,支持原生视觉和百万 token 上下文。阿里自有 Work360 评测报告,平均单任务成本从 4.43 美元降到 1.67 美元,约降 62%。MarkTechPost
说实话,比起总参数,我更愿意看任务得分和总费用放在一起的表。
不过,今天的价格不能抄一个数字就走。不同文章给出的输出价格有每百万 token 4 美元和 4.50 美元两种口径;人民币报道里的 Work360 费用从 26.58 元降到 11.16 元,对应约 58% 的降幅。它们不能拼成一张统一报价表,更不能拿缓存命中价替代普通输入价。dev.to · 成本与上下文、IT之家
这些数字足够支持试用,还不够支持全量迁移。
真正影响账单的还有重试、思考预算、缓存,以及人工接管。有些任务单次调用便宜,连续修五轮才通过验收,最后反而更贵。
前端开发尤其容易被百万上下文吸引。组件库、接口定义、历史方案都能多放一些,补背景的操作可能减少。但能放进去,不代表模型能在修改时持续遵守每条约束。接近窗口上限时的准确率、延迟,以及多文件修改后的稳定性,报道没有给出足以直接用于项目决策的对照结果。
接入倒是有了明确入口。Vercel AI Gateway 已上线 alibaba/qwen4-max,公告介绍了原生视觉、长程工具调用,以及先交付可用版本、再持续迭代的工作方式。不过,网关提供模型入口,运行环境、工具和权限仍然要由应用接好。Vercel Blog
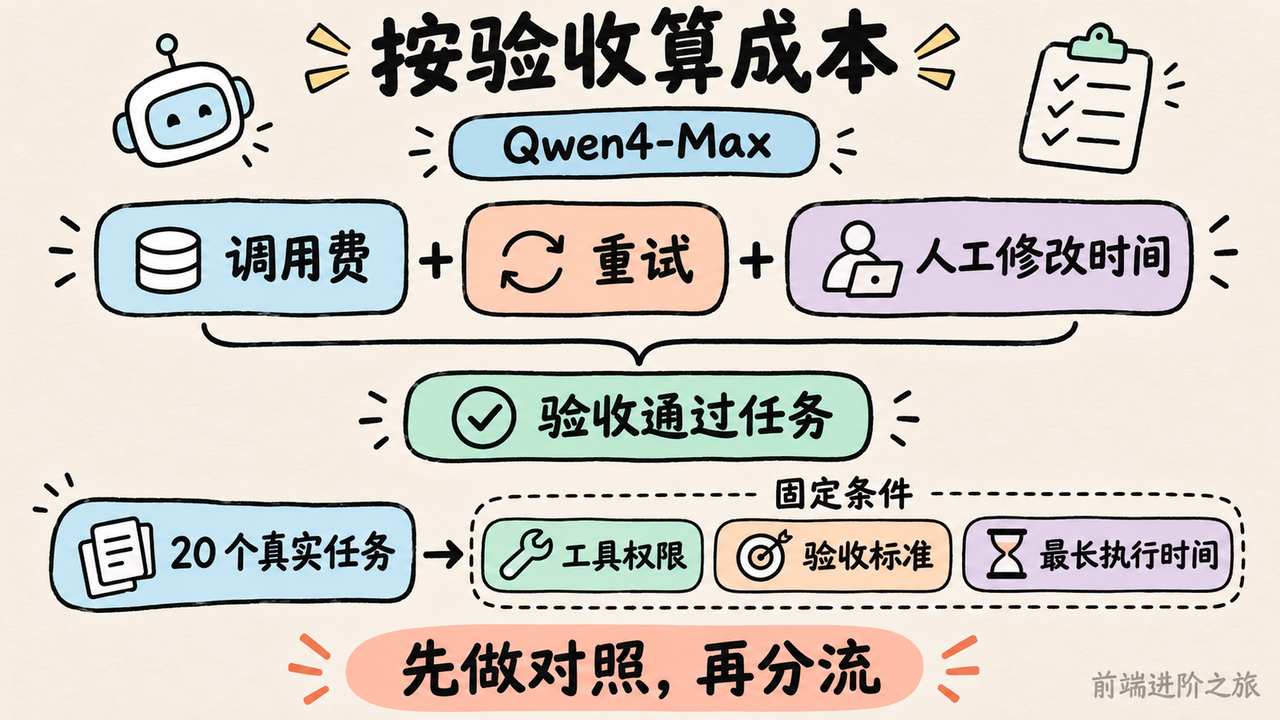
我会按每个验收通过的任务算钱。
顺着上面聊,算钱之前还得把 token 口径统一。本地成本审计文章指出,有些工具把缓存读取单列,有些则已经把缓存 token 算进输入总量。直接相加,可能重复统计。它讨论的是不同工具日志的核算差异,不能据此认定你的账户账单也有问题。dev.to · 本地用量审计
真要判断换不换,我会拿仓库里最近 20 个真实任务,固定工具权限、验收标准和最长执行时间,保留现有模型做对照。记录通过率、总调用费、重试次数和人工修改时间,再决定哪些任务分流。这个小样本不能证明长期表现,但足够筛掉明显不合适的候选。
三、Agent 交付了整套系统,为什么架构还是做偏了?
今天让我最有戒心的,是那个交付特别完整的 Agent 案例。
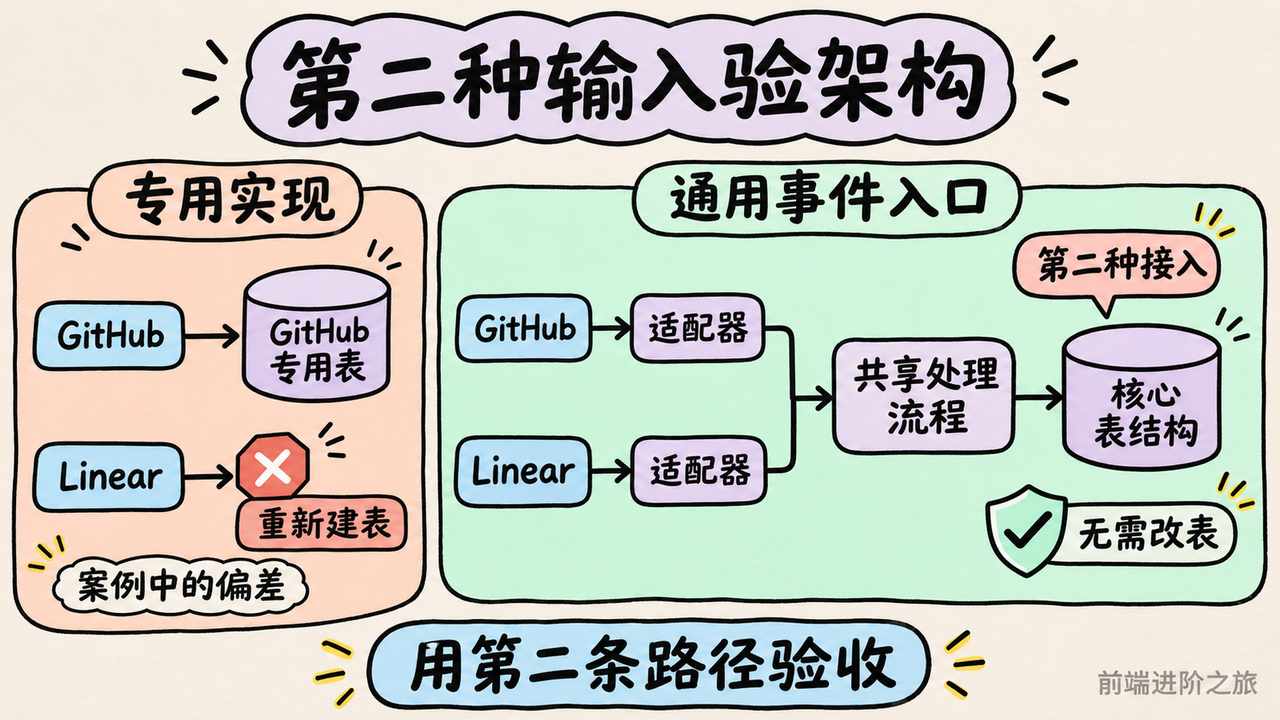
作者原本需要一个通用事件入口,GitHub 只是第一个连接器。Agent 三个小时交出了界面、后端、数据库迁移、文档和部署,数据库却围绕 GitHub 事件设计。等作者追问能否接 Linear,才发现下一个连接器需要重新建表、重新实现。dev.to · Agent 架构偏差
按作者统计,这次运行用了数百万 token,占去每周额度的 35%。这些是单个案例的数据,不能推成 Agent 的普遍返工率。但它说明了一件很实际的事。
交付物齐全,会掩盖需求偏差。
GitHub 事件能进入系统,并不等于通用入口已经成立。后者还要求共享处理流程独立于 GitHub,下一个服务接进来时,能复用核心逻辑。
我对这个案例的读法是,架构要求要尽早变成第二条可运行路径。只写「保持可扩展」,模型可能知道这句话,却没有在每次设计时兑现它。
企业 Agent 的另一篇实践也强调了类似问题。作者会在开发前索要 20 到 30 个真实案例,约定什么算通过、谁处理不确定结果,并记录现有工作的工时。他还遇到过爬取程序遍历了 359 个日期、保存 0 行,最后报告成功的情况。dev.to · 企业 Agent 验收
功能跑完了,业务没得到东西。
对技术管理者来说,演示里的完整度很容易观察,未来接入成本却不容易观察。验收如果只盯着第一种输入,就会奖励局部跑通的实现。
下面这个对象,是我会提前写进任务里的约束示例,用第二种输入检验通用入口是否真的成立。
const acceptance = {
  goal: '外部事件进入共享处理流程',
  fixtures: [
    {
      provider: 'github',
      payload: { action: 'opened' },
      expectedType: 'work_item.created'
    },
    {
      provider: 'linear',
      payload: { type: 'Issue', action: 'create' },
      expectedType: 'work_item.created'
    }
  ],
  constraints: {
    sharedPipelineUsesProviderFields: false,
    secondAdapterNeedsCoreSchemaChange: false // 第二种接入检验抽象边界
  }
};
最容易翻车的是最后一条,它必须结合代码检查和实际接入验证,写在对象里不会自动变成架构保证。
当然,不是每个业务都需要通用平台。如果未来只有 GitHub,专用实现可能更省维护成本。问题在于,这个取舍应当来自需求,而不是实现完成后再倒推理由。
你要是也在做连接器、支付渠道或者消息平台,今天就拿第二个供应商构造一条最小输入。看它能否沿用核心流程,也看需要改动多少已有代码。比起让 Agent 再解释一遍「架构具备扩展性」,这条路径更容易暴露问题。
四、RAG 和 Agent 记忆越做越大,回答为什么还会错?
RAG 接上搜索,回答未必变好。
一篇使用 TypeScript 和 Vercel AI SDK 的教程,先测了不给工具的模型,再逐步增加检索和执行循环。作者报告,迭代后的评分从 0.582 提升到 0.729,「自信地答错」从 5 次降到 0 次。评测使用 18 道题,每题运行 3 次,范围是新西兰税法问答。dev.to · RAG 评测实践
这个分母得带着读。它说明这套小评测里的改动有效,不能承诺上线后不再自信答错。
教程里更有价值的选择,是把评测器和 Agent 服务分开,通过 HTTP 通信。实现可以换,题目和验收方式尽量保持稳定。否则每改一次系统,顺手又改一次评分规则,分数就很难解释了。
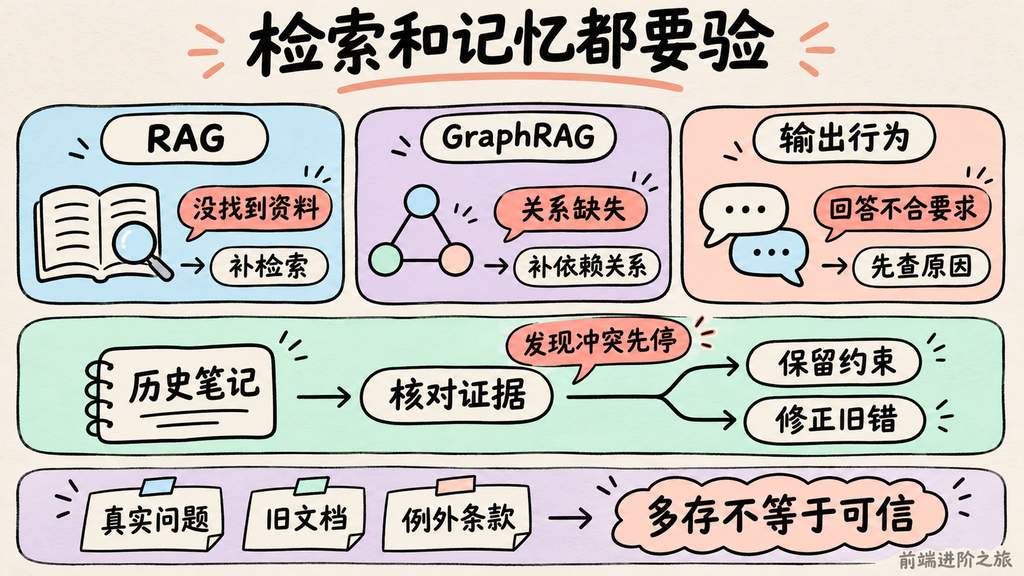
为什么多检索也会出错?有时缺的是后续查证。找到相关段落后,还要继续找例外、定义和生效条件。也有时搜错了问题类型。查一条配置规定,普通 RAG 可能就够;查认证模块变更会影响哪些组件,就涉及依赖关系,几个相似段落未必能覆盖完整链条。dev.to · RAG、GraphRAG 与微调
回到知识库产品,先分清是没找到资料、关系缺失,还是拿到资料后回答不合要求,再决定加检索、建图还是调整输出行为。图谱有抽取和维护成本,格式问题也不一定需要微调。
长期记忆还有另一种麻烦,旧错误会留下来。
Anthropic 相关研究的报道介绍了 Dreaming 流程,让模型在会话结束后回看记录,核对并修正笔记。宝可梦实验里,一个较早模型留下大量文件,较新模型只保留少量策略笔记,游戏进度也更好。但模型版本不同,而且每个模型只跑了一次,不能把进步全归给记忆精简。The Decoder
记忆写得越多,后续需要核对的旧结论也越多。
我会保留经过验证的项目约束、决策理由和失败条件,对临时猜测留出修正入口。把聊天记录完整归档当然有用途,但归档和下次直接采用,是两件事。
这也适用于 AI 办公提效。两版价目表冲突时,多检索几次不会自动确定哪版有效;旧会议笔记里写错的结论,也不该因为存进记忆就获得更高可信度。
今天能做的验证很朴素。找 20 道真实问题,混入旧文档、例外条款和一条刻意写错的历史笔记,比较无检索、现有检索和加入记忆后的结果。除了看答案对不对,还要看引用是否支持答案,以及发现冲突后能否停下来。
五、Agent 有合法凭证,为什么还要单独限制操作范围?
身份验证通过以后,权限问题才刚开始。
一篇安全事件分析把多起入侵、研究演示和产品消息放在一起,提醒团队检查 Agent 持有合法会话时的行为边界。其中介绍的隔离环境越界案例,问题并非只在凭证有没有被偷,而在原定测试范围有没有真正限制执行。dev.to · Agent 合法凭证与越界
我对这篇会保留一点距离。它混合了不同性质的事件,也带有产品推广,不能把所有案例都归成一种已经证实的攻击模式。但拿它检查自己的权限设计,很有用。
例如,Agent 可以处理某个订单,不代表可以导出全部客户;允许读取测试日志,不代表允许顺着日志里的地址访问生产系统。
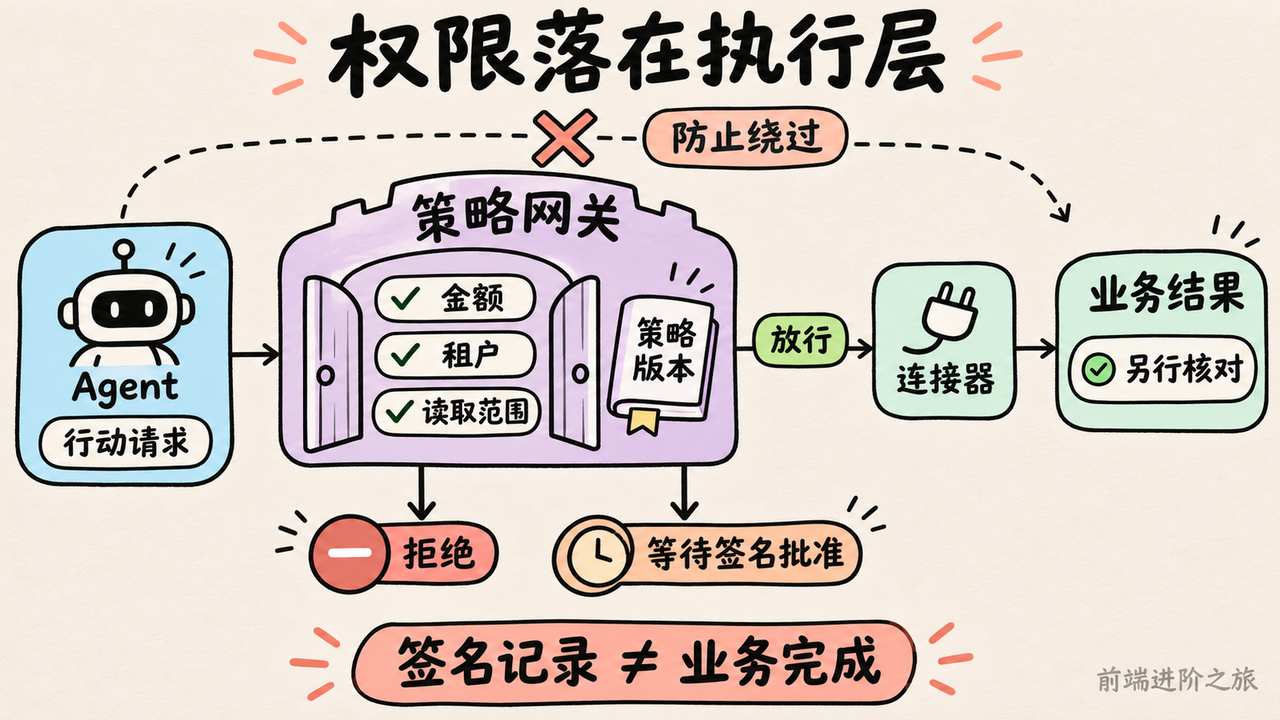
在提示词里写「最多退款 500」,也挡不住执行端接受一笔 5000 的请求。
开源原型 Parmana 尝试把这层约束放到网关。调用方提交行动请求,网关依据带版本的策略决定拒绝、放行或等待签名批准,再由连接器执行并生成签名记录。它还把读取操作纳入检查。dev.to · 策略网关与签名记录
这条思路我赞同,原型本身却不能直接当成熟基础设施用。文章明确承认,绕过网关的调用不受检查;签名证明某个密钥签发了记录,不能自动证明密钥属于谁,也不能证明记录完整描述了现实。
签名不是业务结果的收据。
对工程的实际影响,是权限检查必须出现在真实执行路径上。模型拿不到业务凭证,只能提交受约束的操作请求,才更容易限制它的活动范围。失败重试、部分成功和外部超时,还要单独设计,不能看见「执行一次」就默认拥有跨系统的一次性执行保证。
如果今天只验一件事,我会在测试环境用同一身份尝试允许范围内、超金额、跨租户和绕过网关四种请求。拒绝应当发生在执行层,记录里也应能查到当时采用的策略版本。模型口头说「我不会这么做」,不算这项验证通过。
六、本地模型能启动,为什么还不适合接进业务?
小团队讨论自托管,经常从显卡开始。我的顺序会反过来,先看数据边界、任务难度和负载,再决定硬件。
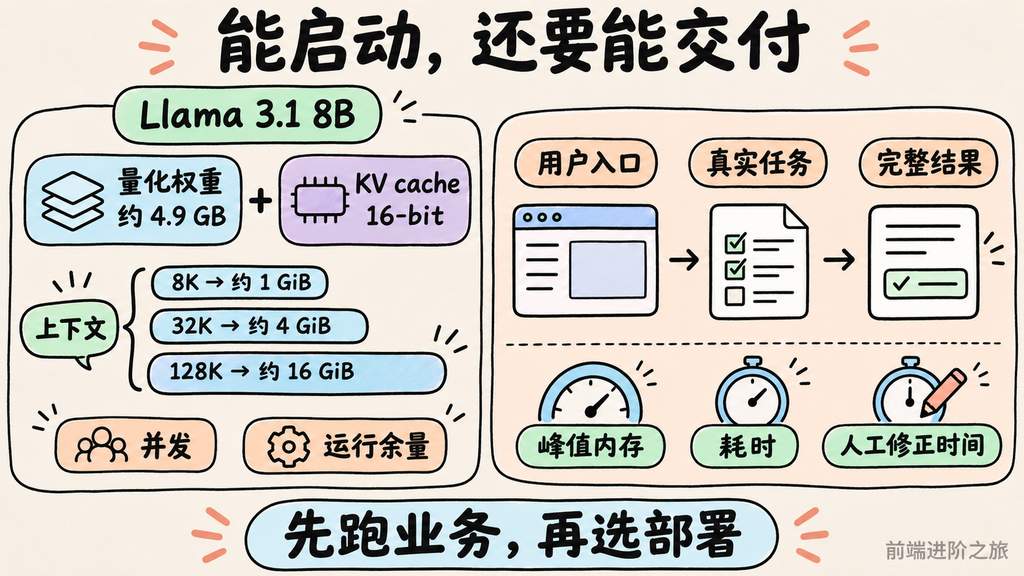
一篇本地推理文章给出的例子很直观。Llama 3.1 8B 的量化权重约 4.9 GB,但使用 16-bit KV cache 时,8K 上下文约需 1 GiB 缓存,32K 约需 4 GiB,完整 128K 则约需 16 GiB。这些数字对应文中的模型结构与缓存精度,不能套到所有 8B 模型。dev.to · 本地推理内存预算
模型文件装得下,只完成了第一笔预算。
上下文、并发和运行余量都会占资源。缓存量化可以降低占用,但效果和速度仍要按实际配置测试。
另一位作者用 36 封有已知答案的财务邮件做回放,托管模型正确提取 32 封,本地 4B 模型为 13 封,平均调用耗时分别约 2 秒和 23 秒。模型名称、量化配置等条件没有完整展开,这组数据只能解释作者自己的选择,不能证明所有本地模型都不适合提取任务。dev.to · 小团队自托管取舍
我会把它当成一个提醒。采购之前先跑业务样本,别用「没有 token 账单」替代总成本。准确率低带来的人工复核,服务维护和闲置硬件,都要算进去。
而且部署问题远不止模型。Knovum 的桌面应用复盘里,开发终端能运行的命令,通过 Finder 或 Dock 启动却找不到依赖;部分功能还卡在 Tauri capability、插件注册和构建配置上。dev.to · Knovum 工程复盘
对写前端的同事,这个故障应该不陌生。开发环境跑通,和用户入口跑通,中间还有一整段工程。
托管 API 也有维护成本。当天一篇文章提醒,五款 Gemini 音频预览模型最早可能从 11 月 17 日起停用。不过,给出的正文没有完整列出五个模型 ID,所以我只把它当作排查提醒,不能拿来直接批量替换配置。dev.to · Gemini 音频预览迁移
本地要维护运行环境,云端要维护接口依赖,两边都有账。
今天就能做一轮小检查。用用户真实的启动入口打开应用,拿目标长度的文档或音频跑一次完整任务,同时记录峰值内存、耗时和人工修正时间;用预览模型的团队,再把代码、环境变量和数据库配置里的模型标识一起查出来。选部署方式之前,先确认这条链路在目标环境里能走到底。
总结
今天这些报道里,比较明确的进展是 Meta 已把生成式测试用于生产合入流程,Qwen4-Max 也有了包括 Vercel AI Gateway 在内的接入入口。前者的拦截数据来自团队报告,后者的降本和能力提升也有不少厂商评测口径,读的时候都要保留测试条件。
我的取舍是,先投资验收,再扩大自动化。给工具调用补结果检查,用第二个连接器验证架构,把真实问题留成稳定评测集,往往比再加一层 Agent 更容易知道钱花得值不值。
Qwen4-Max 到你的仓库能省多少,记忆整理能带来多少独立收益,本地小模型能否扛住目标任务,这些还得靠自己的样本回答。
AI 编程生成得越来越快,程序员更需要知道,什么证据足以让自己接受这次交付。
参考
- Meta 用大模型生成测试拦截高风险变更|MarkTechPost
- MCP 调用返回成功,不代表操作成功|dev.to
- 千问旗舰模型升级|MarkTechPost
- Qwen4-Max 的成本与上下文|dev.to
- Qwen4-Max 开放 API|IT之家
- Qwen4-Max 接入 AI Gateway|Vercel Blog
- 本地核算编程代理用量成本|dev.to
- Agent 交付齐全,架构却偏离需求|dev.to
- 接企业 Agent 项目前,先定验收标准|dev.to
- 用评测驱动 RAG 智能体迭代|dev.to
- 按问题选择 RAG、GraphRAG 或微调|dev.to
- 智能体记忆中的筛选与纠错|The Decoder
- 合法凭证下的 Agent 越界风险|dev.to
- 策略网关与签名记录的能力边界|dev.to
- 本地推理的内存与上下文预算|dev.to
- 小团队自托管大模型的任务账|dev.to
- Knovum 本地知识库工程复盘|dev.to
- Gemini 音频预览模型迁移提醒|dev.to
- 前端进阶之旅