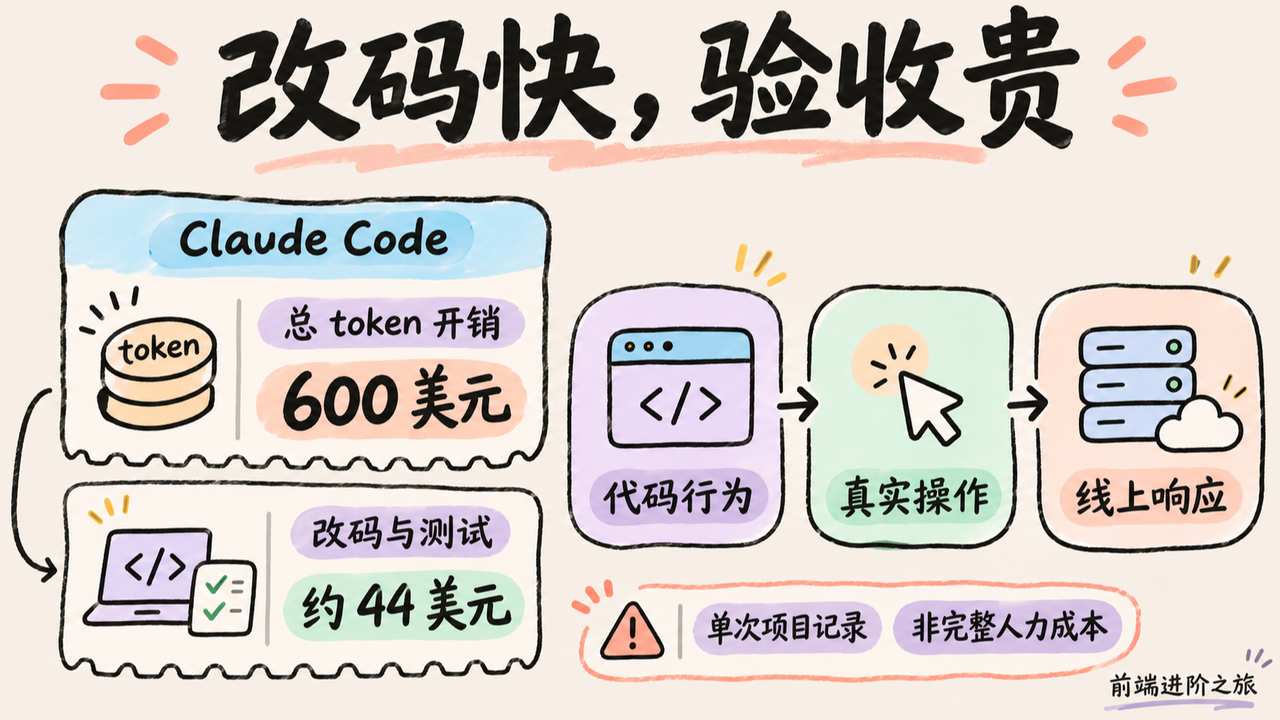
600 美元的 token 账单,真正用来改代码、写测试的只有约 44 美元。剩下的大头,花在确认这些改动到底能不能合并上。
这是 2026 年 11 月 7 日这批 AI 热点里,我最想拿给同事看的反差。Agent 已经能连续干活、并行改文件,但接手结果的人,往往还得补上一整套验证流程。
今天沿着六条线聊,从改码验收、执行权限到检索和架构取舍,看看前端、全栈和带团队的人,怎样判断这些自动化到底省了什么,又把成本挪到了哪里。
一、AI 编程改得越来越快,为什么验收反而更贵了?
先说结论,我会把那份 600 美元账单,当成一次验收流程的成本记录。
技术债清理案例里,作者用 Claude Code 编排了 246 个子代理,在 19 小时里给大型 Ionic 项目产出一份涉及千余文件的 PR。修代码和补测试约花了 44 美元,整个过程的 token 开销约为 600 美元。
这个数字有边界。它是一个项目、一次工作流的记录,不能拿来推算你们团队清理技术债的单价;它也只是 token 开销,不能直接当成完整的人力成本。
但钱花在哪里,很有参考价值。
作者把 Sonar 问题按目录拆成 52 个批次。文件没有测试,就先给原行为补特征测试;修改行没覆盖,就先补覆盖;确认行为后再重构。测试持续失败,就回退并标记跳过,不能为了关告警把测试改松。
真正贵的是证明。
这里有个坑,形式相近的代码,不一定行为相同。案例里就有把 || 换成 ?? 的修改。前者会处理空字符串、零等假值,后者只处理 null 和 undefined。能不能换,得沿着实际表达式和输入范围判断,不能只看 Sonar 告警消没消。
另一个Godot 游戏实验把这件事讲得更具体。Agent 写完游戏,还写机器人在 200 个随机种子上试玩。第一轮通过了全部七项原始目标,复查仍发现,有些种子没有任何受测策略获胜。
第二轮增加搜索程序后,全部 200 个种子都找到了胜利路径,平衡参数却没有变化。前一轮没赢,可能只是机器人不会玩。反过来,搜索器找得到解,也不能证明普通玩家找得到。
测试通过,证明的是你写下来的那些要求。
回到前端交付,这和构建成功后表单仍然提交失败,是同一类问题。网站巡检文章列出的风险包括模板标题残留、生产环境带着 noindex、旧链接返回 404,以及线上接口和本地环境不一致。它是产品说明,没有对照实验,我更看重其中的验收范围。
要我选,我会先拿一个已经完成的 AI PR,把验收拆成代码行为、真实操作、线上响应三部分。当天不用覆盖全站,挑登录、提交、跳转各一条关键路径,看看现有测试究竟漏掉了哪一步,再决定是否扩大自动改码范围。
二、Agent 会调用工具,怎样避免一句聊天就变成真实操作?
顺着上面聊,验收解决的是改得对不对,权限解决的是它到底能动什么。
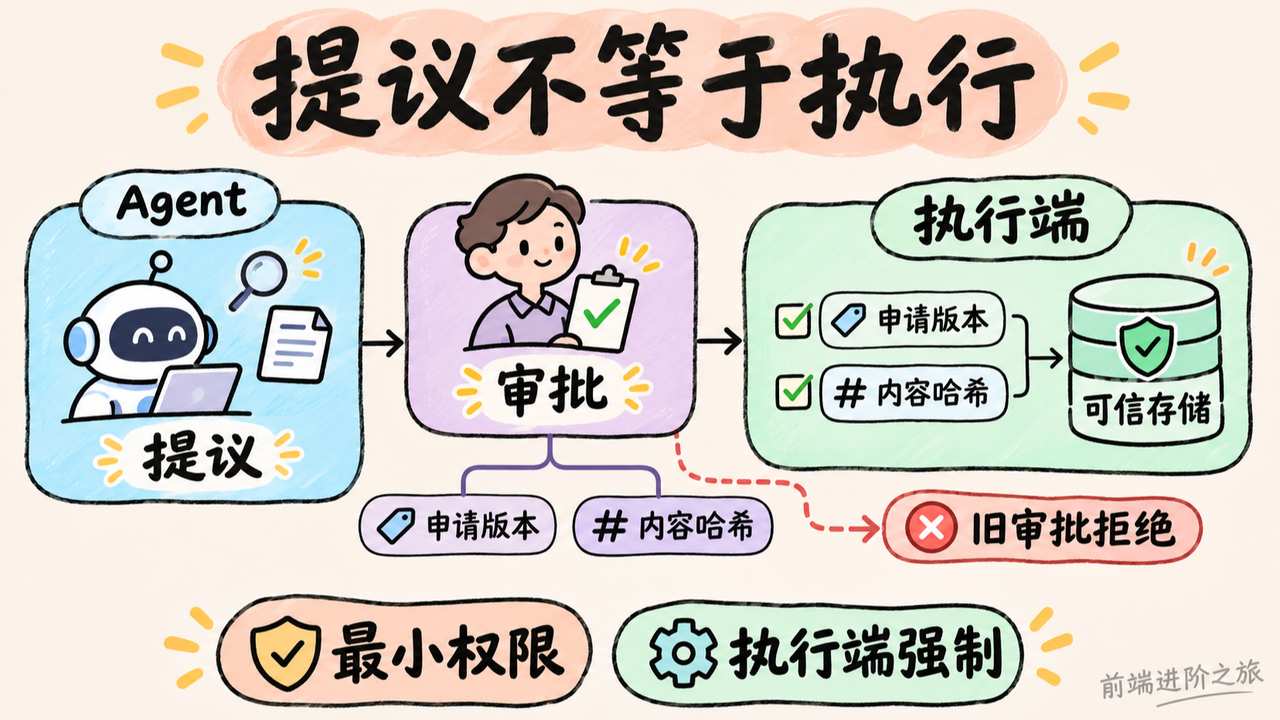
LabQuorum 预约项目用了两个 Agent。一个查询设备、培训资格和空闲时间,创建待审批申请;另一个面向课题负责人,处理审核和提交请求。
我喜欢的细节很直接。提议侧的工具列表里,根本没有提交预约的能力。
它不用在每次对话里反复记住不能提交,因为执行入口就没给它。负责人审批时,卡片还带着申请版本和内容哈希,确认对象落到具体内容上,避免一句同意对应了已经变化的申请。
不过,这个案例的证据要分开读。线上展示了替代时间和 pending 状态;成功提交、拒绝审批等路径,还有独立测试账本上的验证。两者不能拼成一份已经完成的线上全流程证明。
双 Agent 指令转发实验则提醒我们,权限还得检查指令来自谁。
一个 Agent 读外部 issue,另一个能改代码、运行命令。攻击者把指令藏进 issue,期待读取方替自己转发。正常回放时,读取方没有转发恶意命令,所以这批结果测到的是模型的谨慎,还没有真正测到下游权限墙。作者继续强制转发,才比较不同授权范围的行为差异。
模型没上当,和系统拦得住,是两份证据。
这也是我对Trust Gateway 本地实验感兴趣的原因。它把工具调用先当提案,由网关检查身份和能力范围,再签发绑定具体参数的短期、单次授权。方向很实用,但签名只能帮助确认内容和来源,错误金额也可以被完整签名。
你要是也在做 AI 办公提效,比如报销、预约、工单流转,我会先在测试环境写一份最小权限配置,把业务决定落到执行端。
下面这段只演示预约请求的检查顺序,重点是让提交能力与聊天回复分开。
const permissions = {
  labops: new Set(["search", "createProposal"]),
  piDesk: new Set(["readProposal", "requestCommit"]),
};

function authorize(call, approval, current) {
  if (!permissions[call.actor]?.has(call.tool)) return false;
  if (call.tool !== "requestCommit") return true;

  return approval?.approved === true
    && approval.requestId === current.id
    && approval.revision === current.revision
    && approval.contentHash === current.contentHash;
    // 批准必须对应当前版本,不能只检查有没有点过同意
}
最容易翻车的是最后这组比较,它依赖审批记录和当前申请都来自可信存储,不能直接相信 Agent 传来的 approved。当天就能做的验证,是创建申请后修改一次时间,再拿旧审批尝试提交,确认执行端确实拒绝。
三、Agent 显示 completed,怎么确认它真的完成了任务?
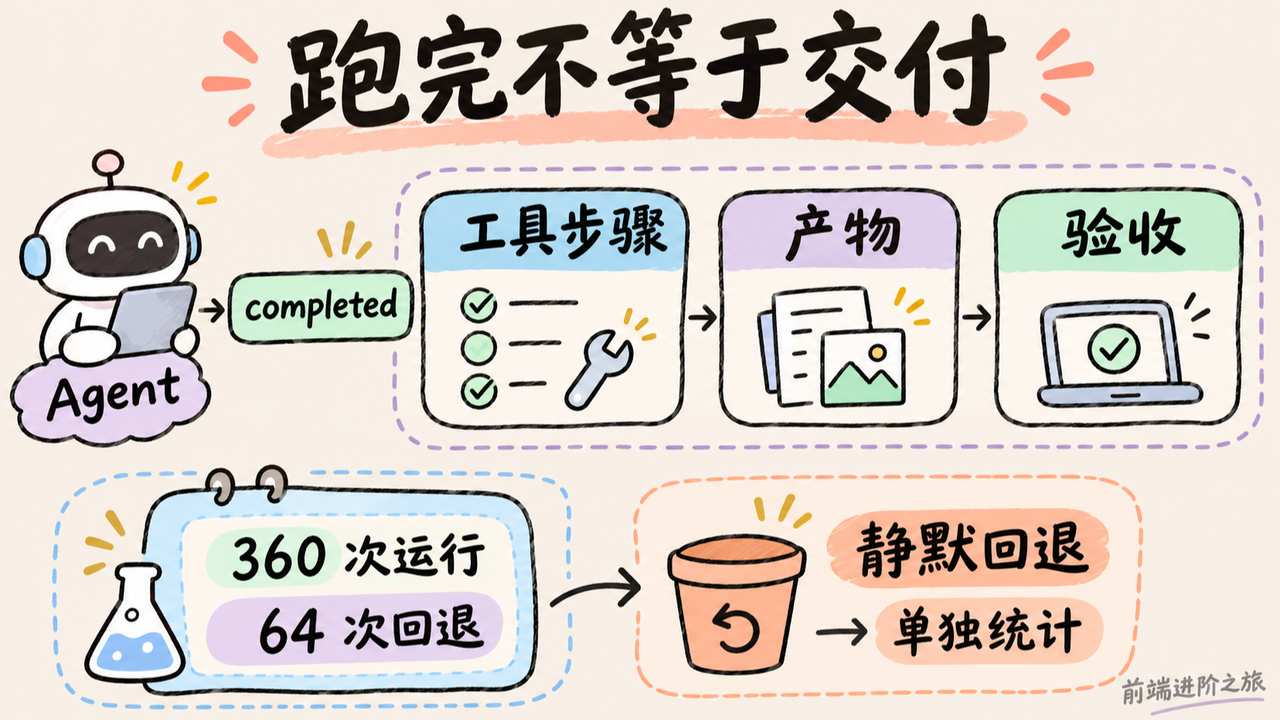
说实话,界面上的绿色完成状态,我现在会多看一眼它到底完成了什么。
Atlarix 故障复盘里,子代理在 15.12.0 至 15.13.3 期间只能执行一步。读一次文件,就结束。主代理继续接手,任务最终可能仍然完成,用户却没有得到并行执行的收益。
原因是一次重构漏传了控制多步循环的选项。按作者描述,所用 ai@7 在缺少 stopWhen 时默认只跑一步,15.14.0 已修复。
这个故障很隐蔽。模型没报错,调用也正常结束,但任务没有走到产出结果那一步。
静默回退实验更容易误导判断。作者想比较有记忆和无记忆的 Agent,模型连续调用失败后,程序却返回随机配置,实验照常运行。
全部 360 次运行中,有 64 次来自随机配置。记忆组第三个 session 有 19/60 次走了回退路径,接近三分之一。这时再讨论 F1 的变化,已经混入了配置来源变化,不能直接归因于记忆。
程序跑完了,比较条件却变了。
所以追踪与回放文章提出的记录范围很有用。它用虚构邮件助手举例,数据库返回退款 pending,模型却说已经退款。只记查询成功没有意义,得保留工具返回、检索片段、该步实际输入和最终输出,才能定位正确数据在哪一步被误读。
我会给实验结果补上下面这些字段,让正常结束、回退和真正交付分开记录。
function recordRun(run) {
  const result = {
    runId: run.id,
    requestedModel: run.requestedModel,
    actualModel: run.actualModel,
    outputSource: run.outputSource, // model 或 fallback
    toolSteps: run.toolSteps,
    artifactPresent: run.artifactPresent,
    acceptancePassed: run.acceptancePassed,
  };

  if (result.outputSource !== "model") {
    throw new Error("本轮退出模型能力对比,单独统计回退");
  }

  return result;
}
最容易翻车的是 outputSource,它得由真实调用分支写入,不能靠模型自报。这只是实验统计的示例,生产服务可以继续降级,但应单独记录降级率;当天拿一个必须读取两份文件才能完成的任务,再注入一次调用失败,就能检查提前退出和回退有没有被看见。
四、Agent 搜不到代码、记错知识,应该先换模型吗?
我会先查它看到了什么。
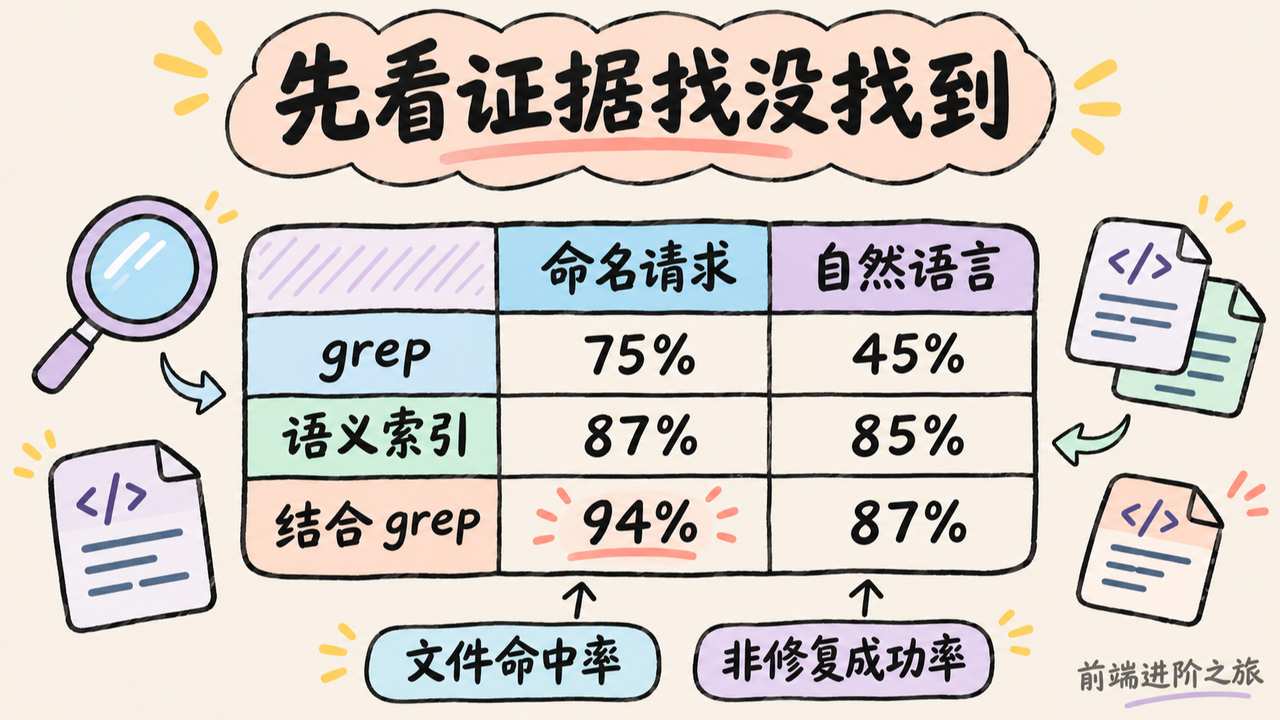
代码检索实验用 400 条 Django 真实提交回放给脚本化 grep 搜索器。在三轮以内,请求明确点出代码名称时,目标文件命中率为 75%;普通自然语言描述只有 45%。
你说退款,仓库里叫 reverse_charge,模型就得先猜名字。猜错几轮,时间和 token 都花了,还可能找到一个看起来相关的文件就开始改。
同一批请求使用语义索引、取前十个文件时,两类请求命中率分别达到 87% 和 85%;结合 grep 后达到 94% 和 87%。
这些数测的是目标文件有没有被找出来,实验对象还是脚本化搜索流程。不能把 87% 写成 Agent 修复成功率,更不能推成程序员效率提升了多少。
但改进方向很清楚。准确函数名、完整错误文本、业务术语与代码名称的映射,都是便宜的上下文。
Agent 记忆实验补上了另一半问题。作者用不接模型的 Python 小实验,对比不断新增笔记与按房间覆盖当前状态的方式。检索使用关键词 grep,同一事实出现冲突答案就算歧义。
这种设计适合说明旧状态为何干扰当前查询,却不能证明所有历史记录都应该覆盖。业务审计需要保留历史,检索当前状态则要知道哪条记录仍然有效,两种用途得分别处理。
记忆有没有用,要看它是否帮下一步作出正确决定。
RAG 双流水线拆解把排障顺序讲得很清楚。离线解析、分块和建索引先决定资料能不能被找到,在线召回、重排和生成再决定答案怎么组织。PDF 阅读顺序错了,或者候选集根本没召回关键条件,后面加长提示词也补不回来。
查询和文档的 embedding 模型及版本需要匹配;换模型后,旧向量不能继续混着比较。近似索引可能漏召回,也得用精确搜索做参照。
回到这块,我会从仓库最近十个真实问题开始,人工标出应该找到的文件或文档片段,再比较关键词与语义检索。当天只看证据有没有进候选集,先把漏在检索前的问题挑出来,再决定是否值得换生成模型。
五、Agent 越跑越多,为什么重试、CI 和回滚会一起涨成本?
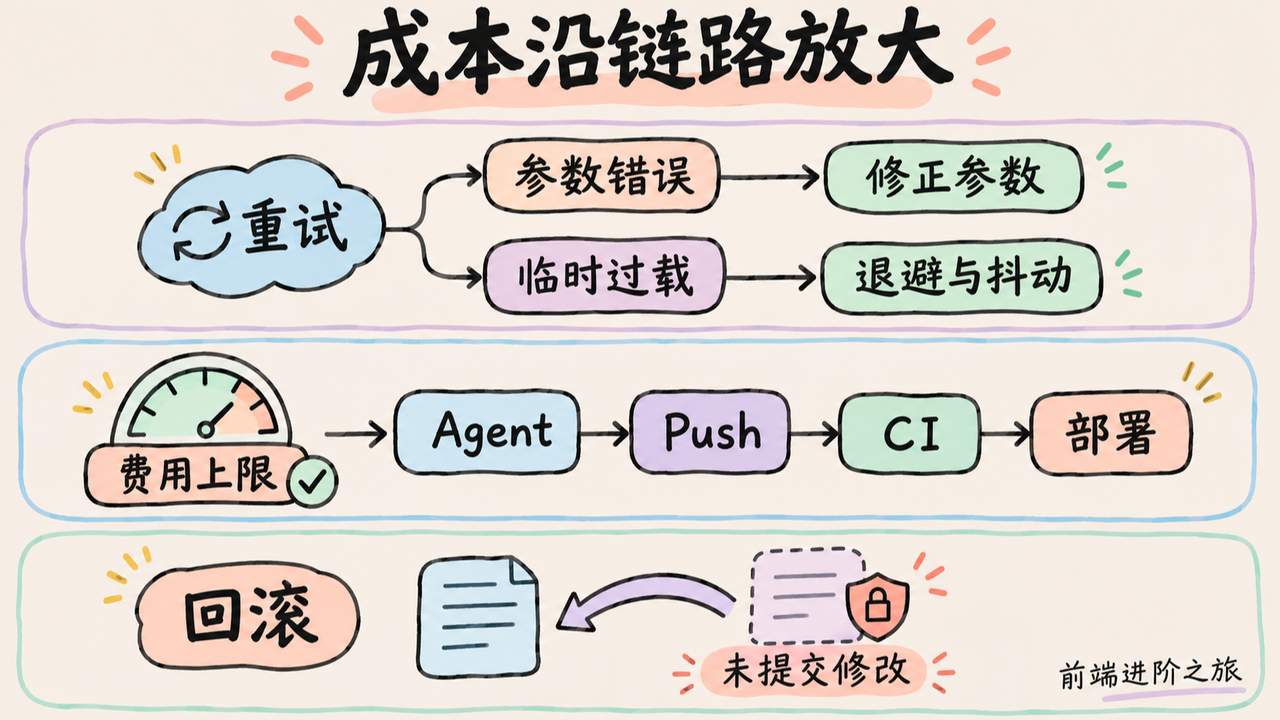
单次调用便宜,不代表整个工作流便宜。
Agent 重试策略文章建议先判断错误能否恢复,再使用指数退避、随机抖动和熔断。请求参数错了,需要改参数;凭据失效,需要处理凭据;服务临时过载,才可能等一会儿就恢复。
这里不能机械地按 400 段和 500 段一刀切。具体 API 的约定仍然得读,文章本身也没有完整生产配置。真正要避免的是所有失败都进入同一个立即重试循环。
并行越多,这个问题越明显。多个任务一起失败,再按相同节奏重试,就会一起撞回下游。
GitHub Rubicon 报道展示了另一种放大。GitHub 称内部压测支持单仓库 5000 个 Agent 并发、每秒 7200 次推送,同时保持低读取延迟,目前仍是小范围定向内测。
这组数字是内部压测,不是团队能直接获得的性能承诺。仓库大小、每次推送体积、持续时间和具体读取延迟都没有交代,拿来做容量预算还不够。
我更关心一次 Push 后面的读取。CI、部署系统和其他 Agent 都可能拉代码。提交多了,后面的任务也跟着增加,预算里只算模型调用费,很容易少算一截。
Parallel MCP 成本解析里也有类似提醒。搜索和抓取属于只读操作,但登录后的付费调用仍会消耗预算。结果返回本次费用,只能告诉你已经花了多少;下一次能不能继续调用,要在请求前决定。
再往后,还有撤销成本。文件检查点案例比较了恢复某轮 Agent 执行前状态,与普通 Git 回退的区别。用户原有的未提交修改、未跟踪笔记、被忽略的环境文件,都可能落在不同的恢复范围里。
回滚到上次提交,未必回到了 AI 动手之前。
我会选一条非关键流水线,给工具调用加尝试次数和费用上限,再模拟一次超时,统计最终触发了多少调用、测试和构建。同一天再做一次撤销演练,保留一份用户未提交修改,确认恢复后它还在,这比只看单次 token 单价更接近真实成本。
六、AI 能写 25 万行代码,前端还需要框架和架构约定吗?
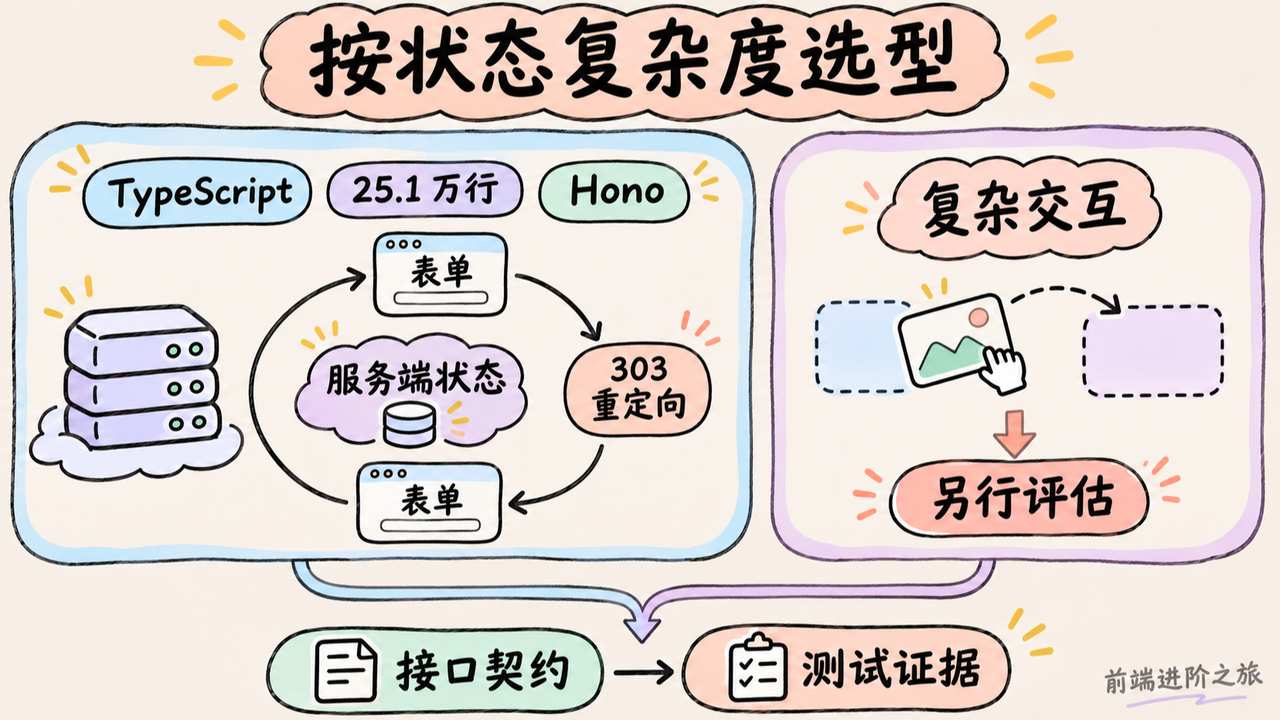
看到Formgong 的案例,最容易聊偏的问题是 React 还有没有必要。
这个项目约有 25.1 万行 TypeScript,没有 React、Vue 或 Svelte,页面由函数返回 HTML 字符串。交互主线是提交表单、写数据库、返回 303 重定向,再从服务端读取状态渲染。
它没有放弃所有框架,服务端仍然使用 Hono。更关键的前提是,大量业务状态留在服务端,页面以表单为主。
对于设置页、列表页和提交后保存的后台,这个取舍说得通。浏览器少维护一份业务数据,也就少了一部分同步工作。但编辑器、复杂拖拽、多步骤本地交互是不是适合这样做,不能从这个案例直接推出答案。
作者也没有省掉一致性维护。后台出现多种略有差异的下拉框后,他们抽出了返回字符串的组件函数,还用测试限制视图里原生按钮、下拉框和表格的数量,要求新增实现走组件。
AI 写模板很快,重复实现分叉也可以很快。
Architecture as Truth 实践从协作侧回应了这个问题。作者主张把决策、接口契约、行为和计划放进版本化文档,人批准后交给 Agent 实现,交付时再核对。
我赞成把业务约束写进仓库,但文档也会漏东西。文章里的例子就提到,公司结算规则没有进入输入,AI 生成的场景因此出现错误。把文件命名为事实来源,不会自动让内容完整。
文档承诺检查器又把审查缩小了一步。它扫描原子性、幂等、安全、兼容等行为承诺,要求人工签认并关联证据。规则只能抓住部分句子,但至少让影响用户决策的保证不再混在流畅段落里直接过关。
所以我的取舍是,按状态复杂度选架构,按业务风险维护约定。代码行数不能替你做这个决定。
当天可以挑一个设置页,比较表单提交方案和客户端状态方案各自要维护哪些东西;再从现有文档找出五句行为承诺,看能否定位到测试、实现或负责人。两件事放一起看,就知道团队缺的是渲染工具,还是明确且能检查的约束。
总结
这批材料里,已经有具体记录支撑的,是技术债案例中验证占据大头的 token 开销、Atlarix 子代理提前退出的故障,以及静默回退污染实验结果的过程。它们都发生在特定项目和条件下,不能直接变成所有团队的收益或损失比例。
我的判断是,AI 编程的下一笔投入,应该更多放在验收证据、执行权限和恢复能力上。生成速度已经能看见,结果能否放心接手,还得靠这些环节回答。
至于 5000 个 Agent 的内部压测能带来多少真实交付收益,语义检索命中率能转化成多少修复成功率,无框架方案能不能撑住另一种业务,这些问题还没有被上面的案例回答。
对天天写业务的程序员来说,我更愿意看一份能复查、能拒绝、能撤销的交付结果。这样的自动化,才值得继续加量。
参考
- AI 清理技术债的成本记录|dev.to
- 让智能体造游戏,再验证玩法|dev.to
- 给编程 Agent 补上网站巡检|dev.to
- 预约提议与审批权限分离|dev.to
- 多 Agent 指令转发实验|dev.to
- 用 Rust 代理审查 MCP 执行|dev.to
- Atlarix 子代理提前退出复盘|dev.to
- 静默回退污染智能体实验|dev.to
- 用追踪与回放定位 Agent 错误|dev.to
- 关键词与语义代码检索对比|dev.to
- Agent 记忆与文件组织实验|dev.to
- RAG 双流水线与检索排障|dev.to
- Agent 重试与错误处理|dev.to
- GitHub Rubicon 存储架构|IT之家
- Parallel MCP 接入与成本解析|dev.to
- 精准撤销 AI 改码的检查点方案|dev.to
- AI 编程是否需要前端框架|dev.to
- 用架构文档约束 AI 交付|dev.to
- 审核 AI 文档中的行为承诺|dev.to
- 前端进阶之旅