35,578 个应用不用登录就能打开,听着像一次大规模数据泄露。但先别急着转发,这个数字来自安全公司对 37,571 个在线 Grok 应用的检查,其中大部分是游戏、落地页和计算器。真正让我停下来的,是发布页预选了「持链接者可访问」。
另一边,编程智能体正在接入百万上下文、团队任务板和多节点运行框架。写代码越来越方便,权限和验收却未必跟上。11 月 11 日这份 AI 热点日报,我想沿着六条线聊聊,帮你判断哪些该试,哪些先别接进生产。
一、模型说「做完了」,程序员凭什么验收
先说结论,我今天最想转给同事的,是那篇要求编程智能体提交完成证据的文章。
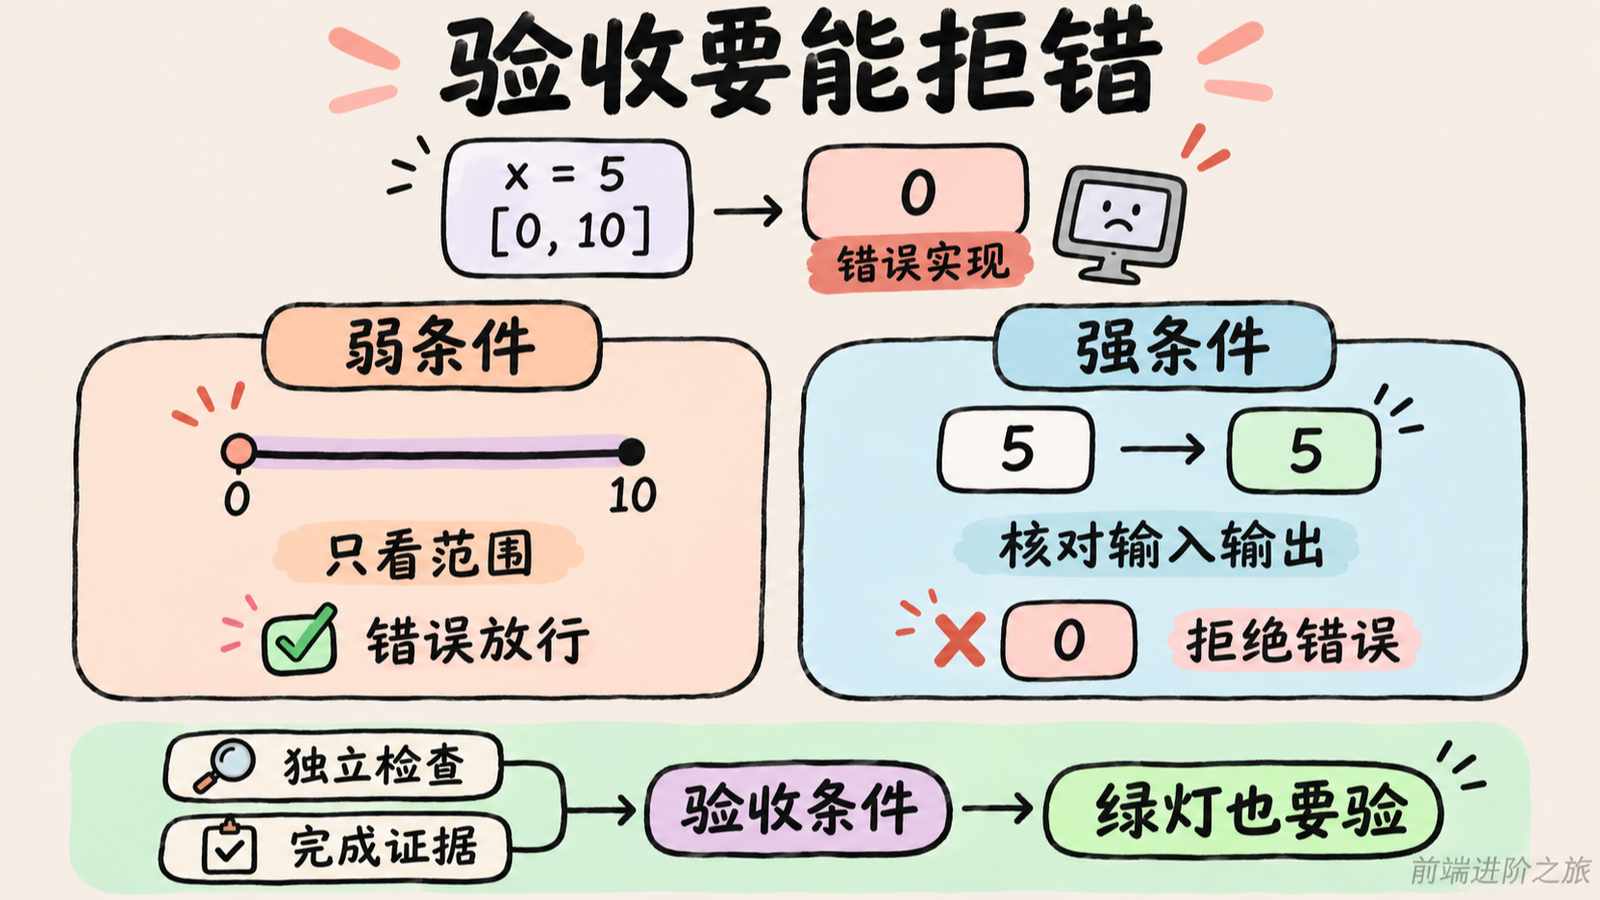
它把实现和验收拆开了。Agent 可以修改代码,但任务是否完成,要由事先约定的条件和独立检查来决定。允许改哪些目录、页面应该出现什么结果、必须提交哪些证据,都应该在开工前确定。dev.to 的完成标准文章讲的不是提示词技巧,而是一套能接进 CI 和浏览器检查的交付约束。
这点很贴近业务开发。一个结算页出现了 Tax 文案,不能证明税算对了;单元测试通过,也不能证明用户切换地区后,总价跟着更新。
验收条件要能拒绝一个看起来像完成的错误实现。
另一篇 Quod 实验把这个问题往前推了一步。作者检查 AI 生成的 Dafny 程序时,发现 8 份契约里有 5 份只限制长度、格式或形状,其中一个错误实现仍然通过了证明。这个样本很小,不能拿来估算 AI 写契约的普遍失败率,但反例足够直观。Quod 作者的实验里,clamp 的契约只要求结果落在区间内,压根没要求区间内的输入保持原值。
验证器没偷懒,是题目出得太松。
下面这段 JavaScript 用来演示怎样检查验收条件本身,它不是 Quod 的实现。
const weakAcceptance = (x, lo, hi, result) =>
  result >= lo && result <= hi;

const strongAcceptance = (x, lo, hi, result) =>
  result === Math.min(hi, Math.max(lo, x));

const input = { x: 5, lo: 0, hi: 10 };
const wrongResult = 0;

console.assert(
  weakAcceptance(5, 0, 10, wrongResult),
  "弱条件连错误结果也会放行"
);

console.assert(
  !strongAcceptance(
    input.x, input.lo, input.hi, wrongResult
  ), // 主动塞错答案,检查验收能否拒绝
  "验收必须拦住这个错误结果"
);
最容易翻车的是第一行条件,它限制了输出范围,却没有建立输入与输出的关系;这个例子也只适用于结果明确的函数,不能直接套给所有开放式任务。
回到这块,团队真正要补的,是审查验收条件的习惯。尤其别让同一个 Agent 写完实现,再临时补一套刚好能通过的测试。
那篇 fragility CLI 介绍也在处理类似焦虑。它分析 diff,用测试浅薄程度、抽象复杂度、理解债务和评审压力提示风险。不过,文章里的 20 分与 96 分来自合成样例,不能直接解释成真实故障概率。
要我选,我会先拿最近一个 AI 修复的 bug 做个小实验。保留正常实现,再故意恢复一次旧错误,看看测试、页面检查和 CI 到底哪一道能拦住它。半天就能知道,现有的绿灯有多少分量。
二、百万上下文模型降价了,AI 编程真会更省钱吗
这一轮模型新闻最容易让人误判的,是把 token 单价当成任务价格。
据 IT之家对 Gemini 4 Carbon 的报道,它支持约百万 token 上下文,提供三档推理强度,面向多步骤编码、复杂调试和智能体任务。首发每百万输入、输出 token 分别为 2 美元和 10 美元,11 月底优惠结束后调整为 4 美元和 20 美元。
Simon Willison 的试用记录也提到了这次调价,并展示了绘图与 Three.js 场景生成。但他的演示不是仓库迁移评测,更不能据此判断模型已经适合替换团队默认工具。
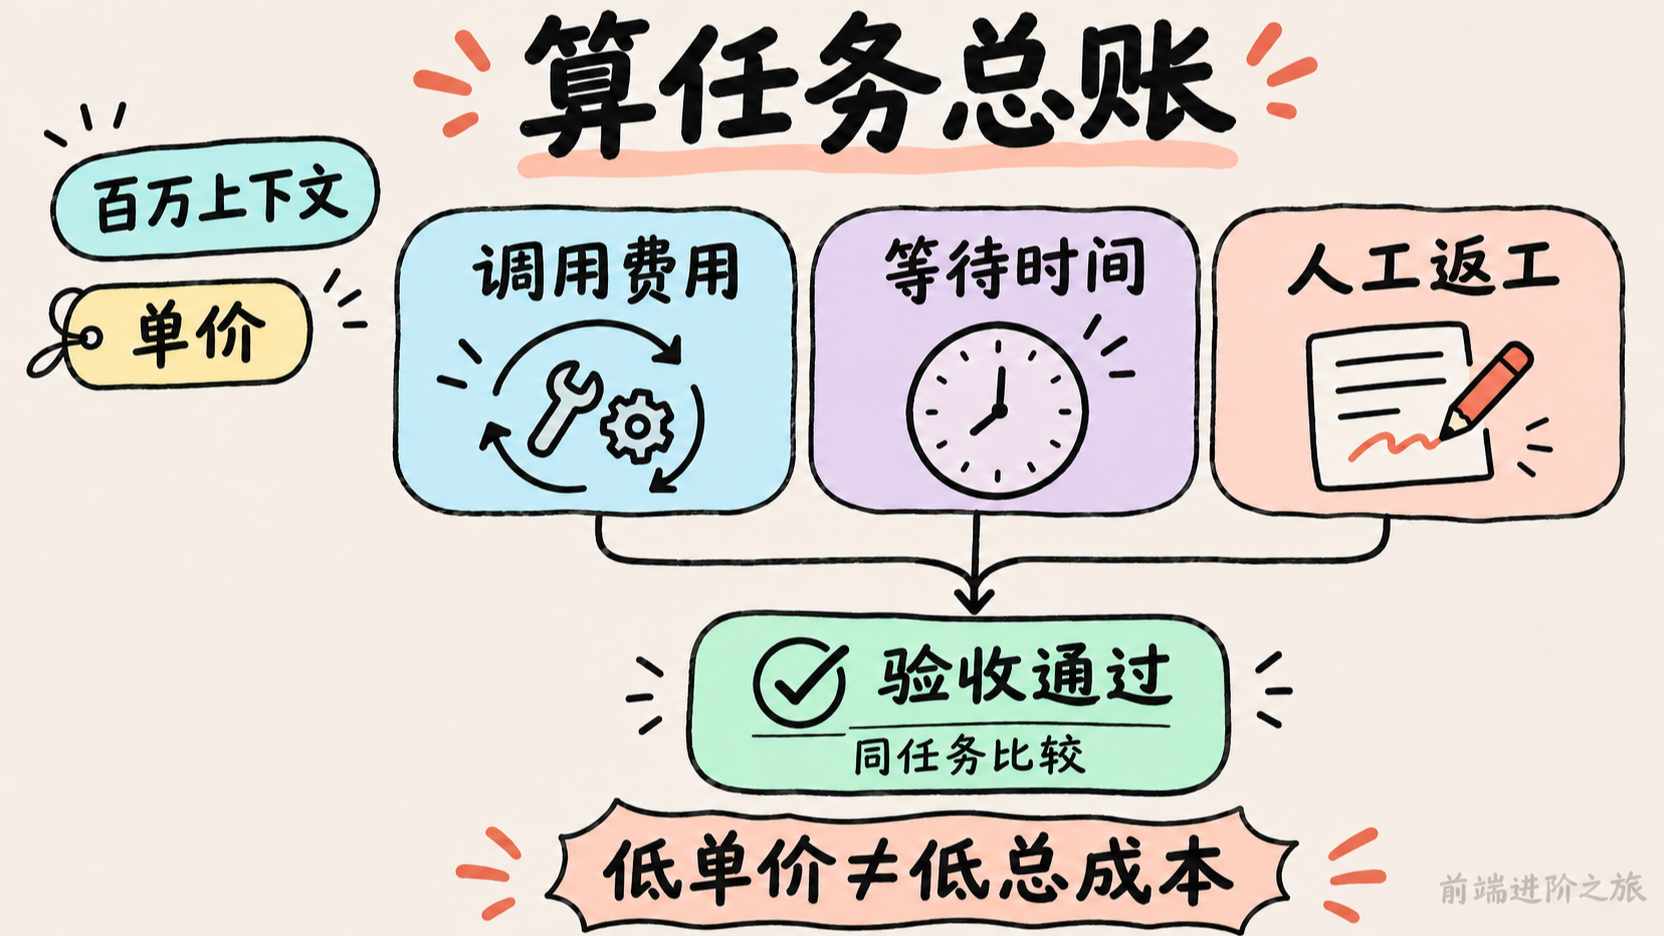
这里有个坑,长任务往往会反复读取文件、运行工具、检查失败,再继续生成。报价表只告诉你每单位多少钱,没告诉你要买多少单位。
该比较的是交付一个验收通过的任务,总共花了多少钱。
Claude 相关消息更要慢一点读。一篇 Fable 5.2 解读称,它提供百万 token 上下文和持续自适应推理,标准输入、输出单价较前代下降 20%;另一篇文章还称,同等 effort 下输出速度最多提高 30%,Claude Code 默认模型也有调整。
这两篇都来自 dev.to,当前拿到的信息没有附可直接核对的官方公告。我对这些型号、降价和默认配置的说法持保留意见,不会据此修改生产配置。两篇解读重复一个数字,也不算两次独立验证。
即便降价属实,输出快 30% 也不能照搬成任务快 30%。假如大部分时间花在构建、安装依赖和浏览器操作上,文字生成加速带来的收益会小很多。
百度这边,ERNIE 5.5 Flash Preview 的报道给出了另一组容易被混用的参数。总参数 280B、激活参数 14B、支持 1M 上下文,千帆 API 已上线,权重计划在 11 月 25 日前开放。官方也提醒,这是继续训练中的中间版本,可能有能力缺陷。
14B 激活参数不能直接推导出本地部署便宜,1M 上下文也不能保证模型能正确利用整个仓库。显存、吞吐、长输入下的准确率,这些报道里还没有可用的对照结果。
所以今天做选型,我会收窄任务。挑一个跨包类型修改、一个依赖定位、一个已有回归测试的 bug,固定权限、输入文件和验收条件,各跑两个候选。记录调用费用、等待时间和人工返工,Carbon 的长期预算按优惠结束后的价格算。一天能做完的小样本足够帮你排除明显不合适的选择,还不足以宣布谁全面胜出。
三、Qwen Code 开放内核,团队该自己搭 Agent 吗
顺着上面聊,模型能不能写对代码,只是运行系统的一部分。
IT之家介绍的 Qwen Code 1.0 Preview,重点是把 Qoder 与 Qwen Code 的 Harness 能力纳入统一开源内核。Harness 负责连接模型推理、工具调用、任务调度和运行状态,开发者可以把这套能力嵌入自己的产品。
dev.to 的相关解读也把重点放在运行时开放上,同时提醒这是 Preview 分支,作者尚未完成真实仓库测试。
如果你正在做内部研发助手,这确实有吸引力。模型接入、工具执行、会话管理和重试,每一块自己写一点,很快就会堆成需要专人维护的系统。
但别把架构路线当成交付清单。统一事件模型正在朝多节点、多会话演进,不代表分布式部署、事件重放和故障恢复都已经成熟。Harness 融合,也不能扩写成 Qoder 全部产品代码开源。
说实话,大部分业务 AI 功能还没走到需要自建通用运行框架的阶段。
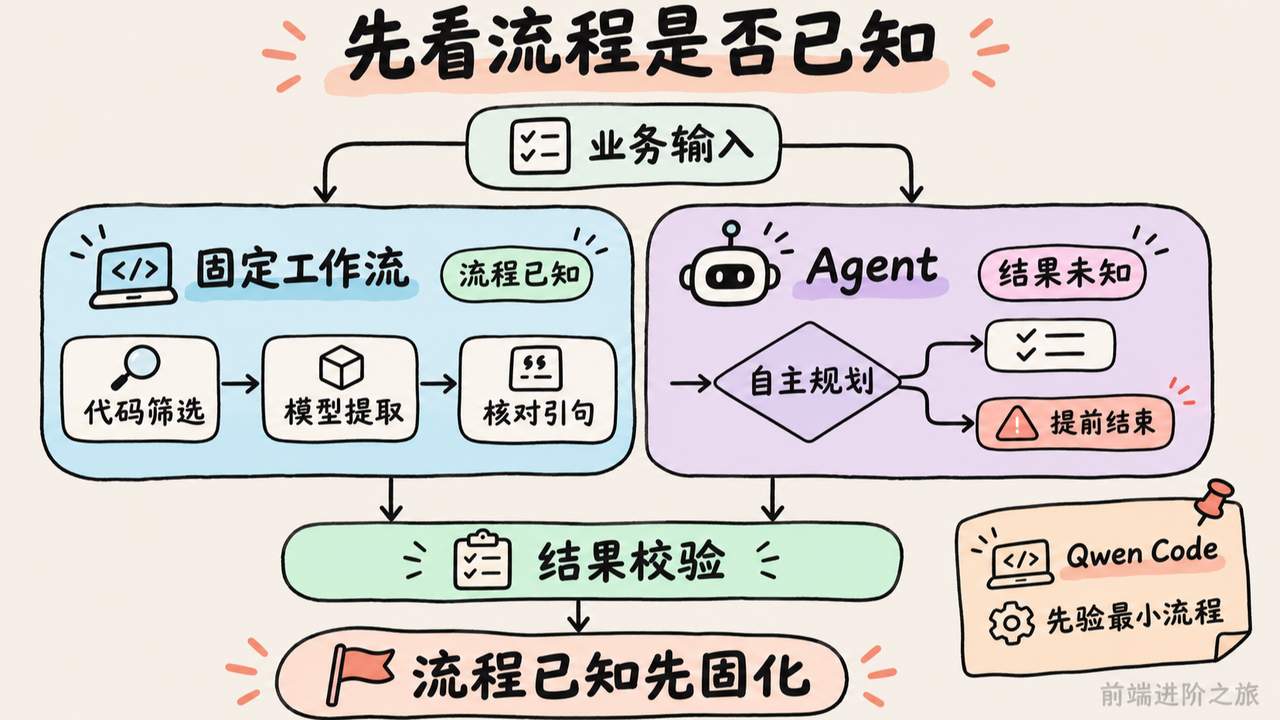
那篇 WhatsApp 助手实验提供了很好的反例。作者让代码筛选聊天,再由模型提取待回复事项和承诺,随后用代码核对引句与发送者。在三次合成数据实验中,固定工作流找到了两条承诺,Agent 却因提前结束全部漏掉。
三次实验当然证明不了工作流普遍更强。它提醒的是,当业务顺序已经清楚,额外引入自主规划可能只会增加一次失败机会。
流程已知,就先把流程写进代码。
比如 AI 办公提效里的会议纪要归档、表单分类、工单摘要,很多任务可以先用固定步骤实现。只有当系统必须根据未知结果不断选择下一步,才值得认真讨论 Agent 的自主决策。
你要是也在做这类功能,我会拿同一批十条脱敏输入,分别跑固定流程和 Agent。两边共用结果校验,记录漏项、调用次数和提前结束情况。至于 Qwen Code,先验证一个最小嵌入流程能否接入现有权限与日志,再决定是否继续投入。
四、多人多 Agent 一起开发,任务和上下文放在哪里
一个人让三个 Agent 并行改代码,和三个人各带三个 Agent,差别不只是数量。
据 Cursor Projects 多人协作解读,这次升级把团队成员、各自的 Agent、任务和关联 PR 放进共享工作空间,同时共享项目资料和部分决策上下文。每个人仍保留自己的局部聊天。
这个方向我认同。大概率你也遇到过,需求已经在一段聊天里改过了,另一个人却还拿着旧版本开工。AI 加快实现以后,这种同步延迟会更快变成重复代码。
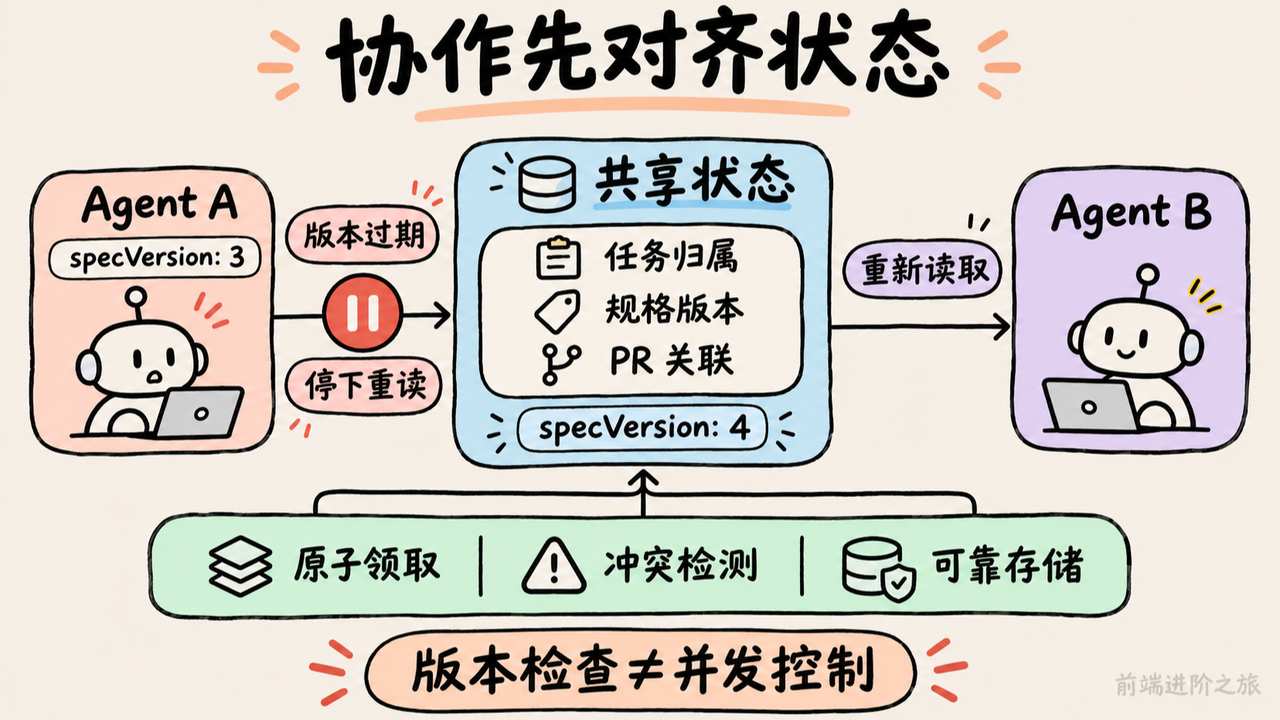
但共享聊天不等于共享准确状态。
任务板显示「进行中」,到底是谁在改?对应哪个分支?需求变了以后,已经开工的 Agent 会不会继续执行旧决定?这篇介绍还没把同步频率、状态冲突和失效处理讲清楚。
另一份更朴素的经验来自 两个 Agent 维护多站点仓库的文章。作者把反复出现的问题写进根目录规则,并要求 Agent 先读简短状态页,再读站点交接说明。早期让 Agent 翻几周历史,反而拖慢了普通修改。
这套做法适合借鉴的,是把当前事实与历史资料分开。它不是让规则文件越长越好。
共享状态可以先小到下面这样,重点是让执行者知道自己拿的是哪一版任务。
const task = {
  id: "checkout-tax",
  owner: "agent-a",
  branch: "fix/checkout-tax",
  specVersion: 3,
  status: "running",
  allowedPaths: ["apps/checkout/", "packages/tax/"]
};

function canContinue(localTask, sharedTask) {
  return localTask.owner === sharedTask.owner &&
    localTask.specVersion === sharedTask.specVersion;
}

const latestTask = { ...task, specVersion: 4 };

if (!canContinue(task, latestTask)) {
  throw new Error("任务约定已更新,先重新读取");
}
最容易翻车的是把 canContinue 当成并发控制,这段代码只能发现手头版本过期,真正的多人系统仍需要原子领取、冲突检测和可靠存储。
The Verge 对 Carbon 与 swarm 的报道也提到,把单条提示词变成多个 Agent 协作任务仍在预览。如何共享信息、解决冲突,不能靠「它们会协调」一句话带过。
我的取舍是,团队先把任务归属、规格版本和 PR 关联做好,再增加并行数量。今天就能选两项互不相干的小改动,让两个 Agent 分开处理,中途更新其中一项需求,观察旧任务能不能及时停下,比看它们同时产出多少代码更有参考价值。
五、AI 生成的内部工具,为什么拿到链接就能访问
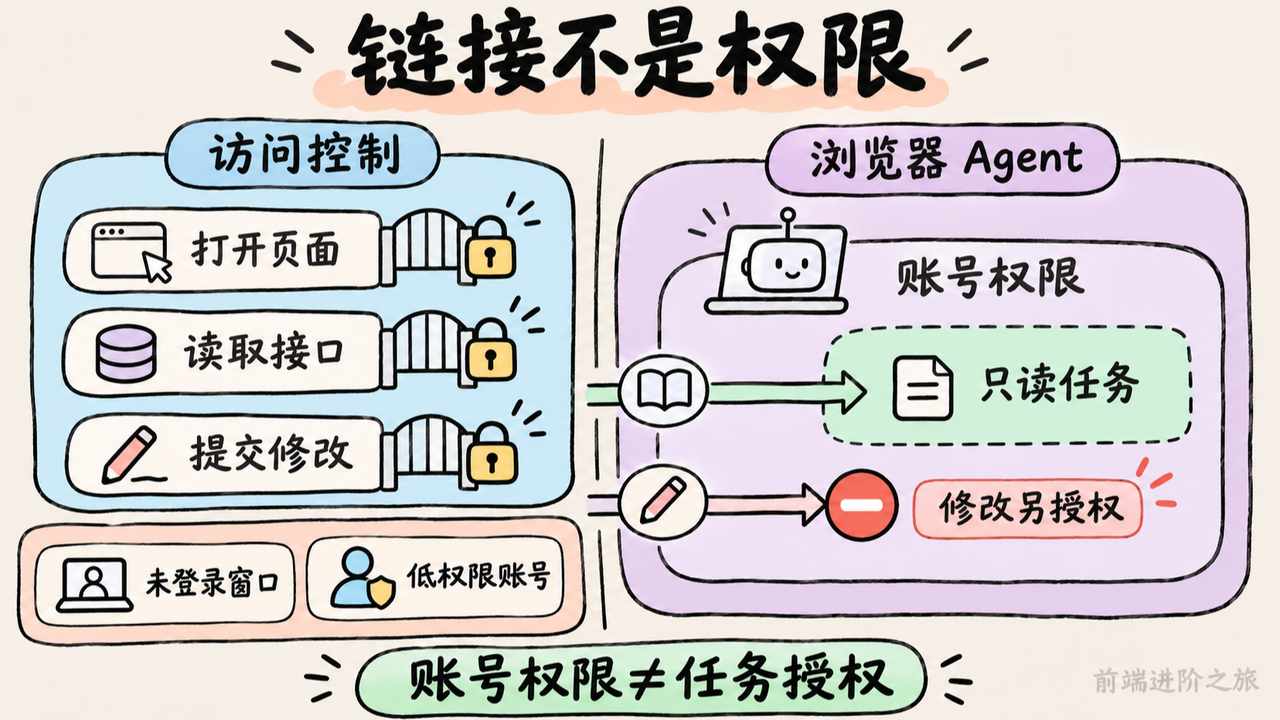
回到开头的 Grok 应用调查。
据 The Decoder 的报道,Claroc 检查了 37,571 个仍在线应用,其中 35,578 个无需登录即可访问,占 94.7%。这个比例说的是可公开访问,不是全部包含隐私数据。研究人员估计,650 到 800 个应用含有私密数据;文中其他敏感分类存在口径和重叠问题,不能简单相加。
问题很具体。应用需要创建者主动点击发布,但「Anyone with the link」被预选了。独立子域名还可能进入被动 DNS 数据库,所以地址难猜,也挡不住被发现。
内部工具的访问控制,不能靠大家不转发链接。
对前端来说,这和「按钮藏起来就算没有权限」是同一种误判。页面能不能打开、接口能不能读数据、提交请求能不能改状态,是不同的检查点。
浏览器智能体又增加了一层身份问题。Token 的 Rehearsal 案例里,助手运行在用户已登录的浏览器会话中,继承用户的访问能力,服务端难以区分操作来自真人还是助手。团队后来增加只读限制、操作记录、活动提示和敏感表单约束。
账号可以删除数据,不代表这次让助手查一条记录,就顺便授权它删除数据。
这不是要求所有动作都弹确认框。查询与修改分开授权,敏感操作绑定具体对象和范围,才有机会既保留自动化收益,又避免一次误判扩大成批量修改。
Claude Code 与 osFoundry 的教程提供了另一种交付方式。先在本地生成小工具,提交完整源码供人审批,再读取 Room 状态确认入口。它也提醒,连接加入项目后,可访问的可能不只有目标 Room,还包括 Notes 和知识库等内容。
所以,审批入口之外,还得看连接到底拿到了什么。
今天真要检查内部工具,我会用一个未登录窗口和一个低权限测试账号,分别尝试打开页面、读取接口和提交修改。整个过程只放虚构数据;浏览器 Agent 则给一次明确的只读任务,观察它是否仍能触发保存请求。这比只看发布页上的权限文案更直接。
六、规格、技能和测试都齐了,为什么还是不能直接交付
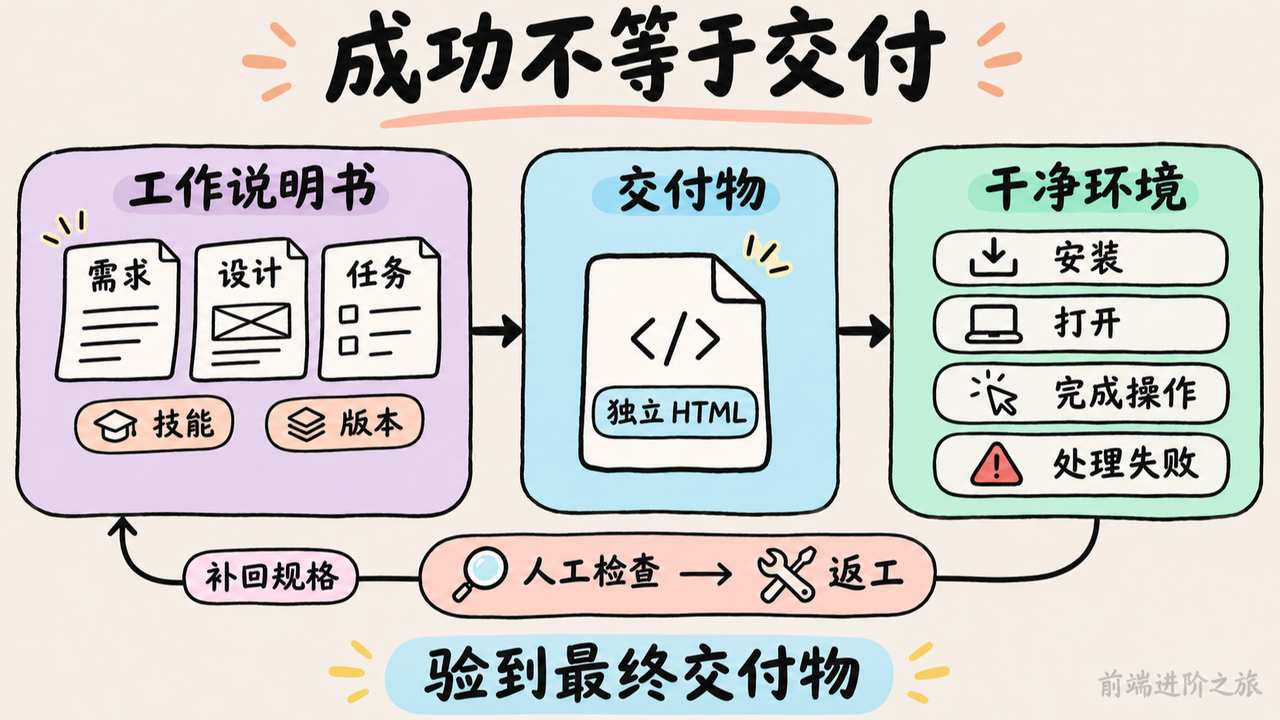
今天还有一组消息,适合放在一起看。
Kiro 的规格驱动开发文章把工作拆成需求、设计和任务三份文档,并强调需求与设计经过人工审阅后再实现。不过,分享现场主要完成了方案草拟,更完整的实现来自另一套工具,不能拿来证明 Kiro 已经提高了交付效率。
Tech Leads Club CLI 教程则关注技能安装可追踪。示例固定安装器版本,把指定 skill 复制进项目,再通过锁文件记录安装内容。示例版本要求 Node.js 24 或更新版本,技能内容还有独立署名条件。
这两条放一起,能看到团队开始把 AI 的工作说明书当作工程资产管理。需求要审,技能来源要查,更新要留下版本。
我支持这个方向,但文档齐全不等于功能完整,锁住安装器版本也不能代替审查实际复制进来的文件。
最终仍然要回到交付物。
Simon Willison 的 Carbon 演示里,作者第一次拿到 Three.js 场景后,又补了一句要求构建成独立 HTML,才得到相应版本。这个细节比演示是否炫酷更贴近日常开发,能在 IDE 预览,与能交给同事独立打开,是两个验收条件。
AI 复刻短视频的实验也是如此。标题披露单次实验花费 1.55 美元,14 个片段都生成成功,但参考图带偏构图、字幕分类错误和局部元素残留,仍然影响成片。作者抽查 10 帧,认为 8 帧符合要求,这只是单条视频的人工抽查,不能扩展成产品成功率。
说实话,我更愿意看这些没收干净的边角。它们告诉你,单个工具返回成功以后,还有多少工作留给人。
对技术管理者来说,预算也该算到这里。生成费用只是其中一部分,人工检查、返工、重复提交和交付包装都可能继续花时间。对全栈开发者来说,一个接口返回成功,也不能替代浏览器里的完整用户路径。
今天可以挑一个现成的 AI 小工具,从干净目录或未登录窗口开始,照着交付说明走一遍。能否安装、打开、完成操作、处理失败,再把发现的问题补回规格和技能文件。先修掉一次真实交付断点,比继续堆十条通用规则有用。
总结
按今天提供的报道,Carbon 的开放与调价安排、Qwen Code 的 Preview 分支、文心新预览模型的 API 入口,都有明确描述;权重开放和分布式能力演进,则还要等后续交付。Claude Fable 相关型号、价格和默认配置,目前只有这些二手解读,我不会把它们当成已经核实的配置依据。
我的判断是,这轮 AI 编程竞争,越来越多地落在代码生成之外。谁能保住任务约定、收紧执行权限、交出可复查的结果,谁才更容易进入团队日常工作。
但多 Agent 是否更快、百万上下文是否减少返工、低单价是否降低总账单,还得拿自己的任务测。今天这些消息足够帮程序员选出试验对象,远没到可以照着排行榜统一换工具的时候。
我会先补验收,再试模型。毕竟代码写得再快,合并以后没人敢动,省下来的时间迟早还要还回去。
参考
- 给编程智能体建立可执行验收门槛|dev.to
- 证明通过仍会出错,用编译器检查契约漏洞|dev.to
- 用 CLI 给 AI 代码变更做脆弱性体检|dev.to
- Gemini 4 Carbon 开放,瞄准复杂工程任务|IT之家
- llm-gemini 0.36 与 Carbon 试用|Simon Willison
- Fable 5.2 开发者解读|dev.to
- Claude 新版降价与提速的相关说法|dev.to
- 文心新预览模型开放 API|IT之家
- Qwen Code 开放融合 Qoder 的 Agent 内核|IT之家
- Qwen Code 1.0 的运行时方向|dev.to
- 并非所有 AI 功能都需要 Agent|dev.to
- Cursor Projects 多人协作|dev.to
- 把智能体踩过的坑写进仓库规则|dev.to
- Gemini 4 Carbon 开放与 swarm 预览|The Verge
- Grok 应用访问权限与敏感数据调查|The Decoder
- 浏览器智能体继承用户权限的隐患|dev.to
- Claude Code 经审批交付 Room 小工具|dev.to
- 用 Kiro 规格文档约束 AI 开发|dev.to
- 用版本锁定管理编程智能体技能|dev.to
- AI 复刻短视频的低成本管线实验|dev.to
- 前端进阶之旅