14 KB 的 C 扩展,跑起来却输给了 Rust;另一边,一张 RTX 3050 跑出 489.8 tok/s,看着足够让人重新考虑本地模型。但前一个比较还没给出最终优化成绩,后一个数字只来自十轮特定代码编辑任务。读完 2026 年 11 月 9 日这批 AI 热点,我更关心那些漂亮结果是怎么测出来的。这篇沿着性能、选型、权限、重试、审批和 MCP 六条线聊,帮天天写业务的程序员判断哪些值得试,哪些先别搬进生产。
一、AI 编程速度翻倍,为什么你的任务未必更快?
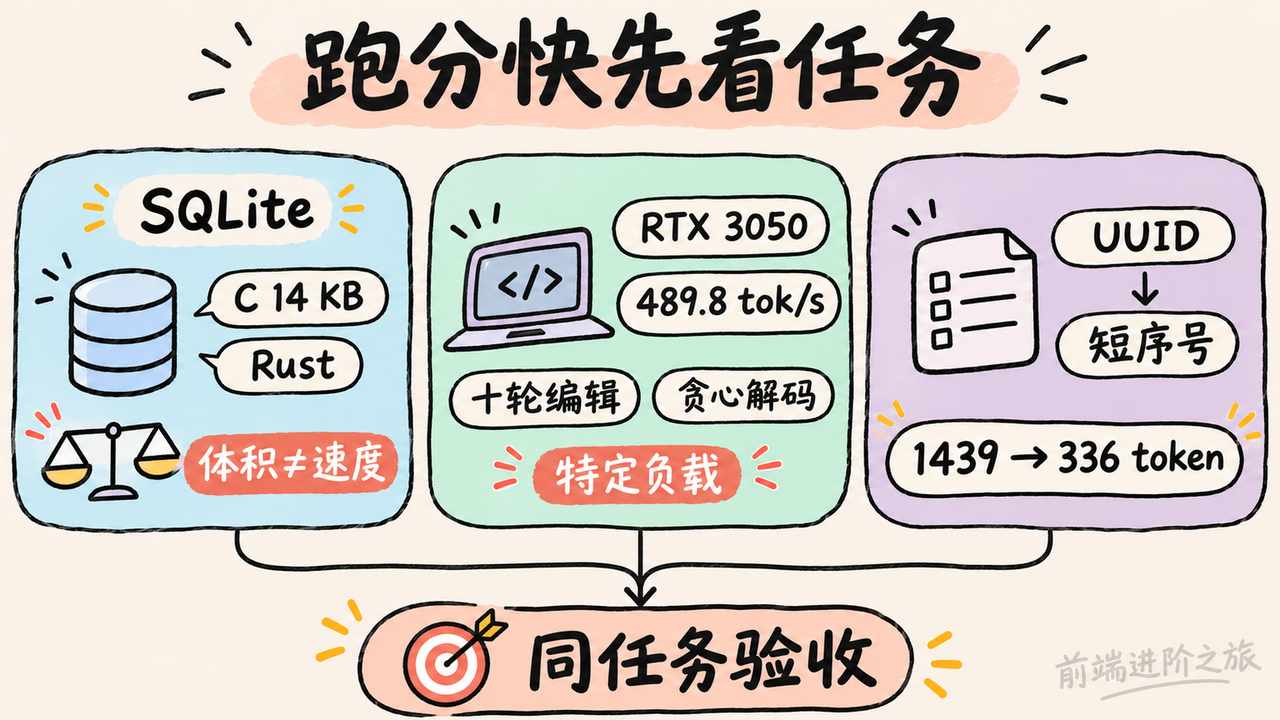
先说结论,我会先看测试在做什么,再看速度涨了多少。
Simon Willison 用 Claude 探索 SQLite 的 parse_number(value) 扩展,把带货币符号、逗号和百分号的文本转成数字。初始产物里,C 扩展只有 14 KB,两个 Rust 版本分别是 321 KB 和 298 KB;执行速度却是 Rust 更快。作者继续追查,把注意力放到了数字解析函数上,还让 Claude 尝试手写 C 解析器。Simon Willison
这一步比语言排名有用。
底层解析实现快两倍,不能推出整个 SQL 函数快两倍。取值、清洗字符串、返回结果都占时间。作者按 200 万行数据的每行净开销测量,但我们手头的内容没有最终成绩,不能说手写 C 已经追平 Rust。
更麻烦的是行为可能没对齐。12.5% 到底返回 12.5 还是 0.125?如果两个实现答案不同,跑分比较就掺进了业务差异。回到这块,AI 可以很快生成两个版本,但测试用例里得先写清楚「对」是什么。
本地推理的 489.8 tok/s 也要这样读。SonicBoom 作者使用 RTX 3050 8GB、Qwen2.5-7B-Instruct Q4_K_M,在十轮代码编辑里,每轮修改一个 100 至 300 行的文件,采用贪心解码。作者报告,推测解码达到普通解码的 12.7 倍,开关加速的十轮输出全部一致。SonicBoom 实测
它利用了编辑任务的特殊性。输出文件里,大量内容原本就在输入里,长匹配 n-gram 可以先猜一段,再交给目标模型验证。连续命中时,一次验证能推进多个 token。
所以,改旧文件和从零设计组件,不能套同一个速度预期。作者还报告编程对话提速 4.4 倍,但具体条件没有展开;目前验证范围也只到 sm_86 架构。
吞吐数字要跟着任务走,不能脱离负载单独比较。
说实话,日常应用里有时连推理内核都不用碰。另一篇商品筛选实验,把 50 件商品的 UUID 换成短序号,输入从 1439 token 降到 336,输出从 72 降到 9。按文中指定价格计算,费用相差约 4.8 倍。这是这组短名称列表的成绩,不能推广成所有提示词都能省这么多。列表标识符成本实验
我的取舍是,先测业务层容易改的部分。当天就能拿十个真实编辑任务,对比总耗时、验收结果和 token 消耗;列表筛选再加一组短序号映射实验,检查返回序号有没有越界、映射是否属于当前请求。省下来的钱和时间,都得在同一批任务上算。
二、编程模型榜单差几分,够不够支持团队换模型?
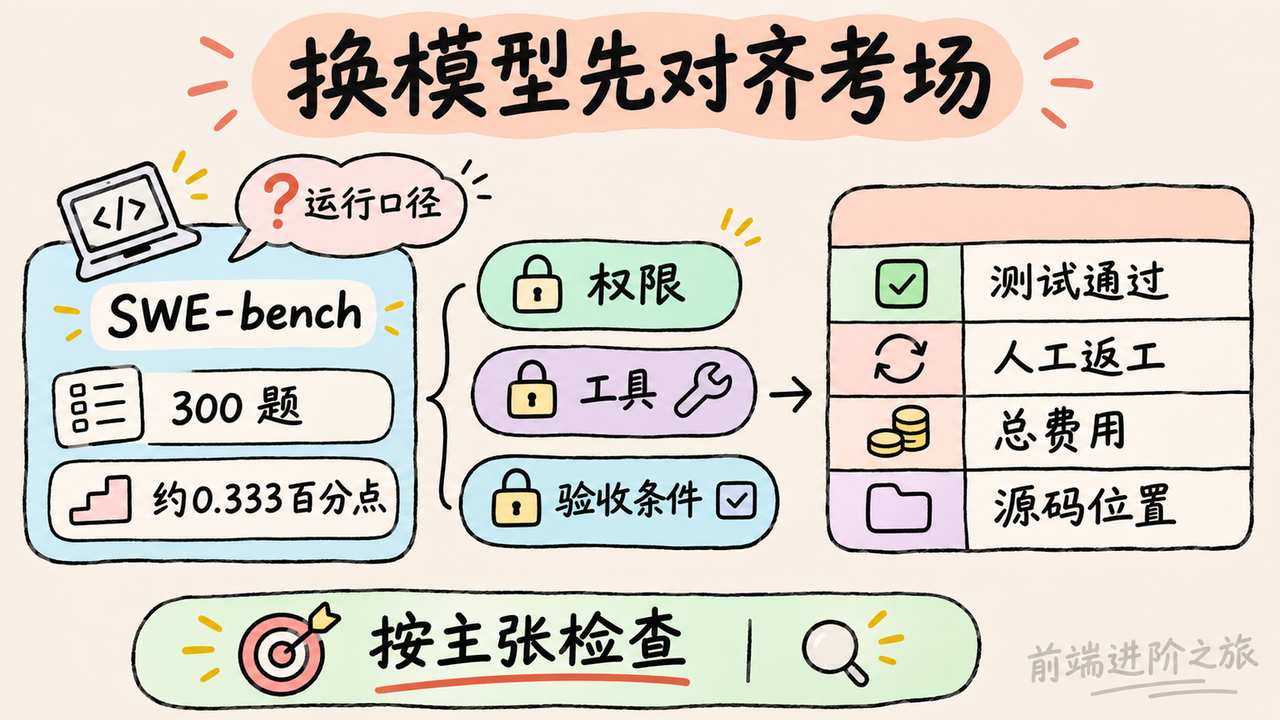
一个模型领先三分,到底值不值得迁移?
我会先问这三分怎么来的。SWE-bench Multilingual 有 300 道任务,单次完整运行、每题只有通过或失败时,成绩应当按约 0.333 个百分点变化。相关核查文章检查了截至 11 月 9 日的 Hugging Face 榜单,34 条记录全部标为未验证,其中 15 个显示分数无法按单次完整的 300 题结果解释。SWE-bench 榜单核查
这不等于成绩造假。多次运行取平均、使用不同分母,都可能产生这样的数字。问题是运行口径没交代,读者却容易把它理解成同一场考试。
而且,修复仓库问题靠的不只有模型。读取哪些文件、怎样执行测试、允许调用什么工具,都由评测框架参与决定。那 34 条记录里,只有两条说明了使用的框架。
模型强一点,框架换一套,账就难算了。
Claude Fable 5.1 的解读也适合带着这个问题读。该文称,新版本在 Terminal-Bench-Science 上达到 52.6%,前代为 24.7%;到了 CursorBench 3.2.0,新版为 73.4%,前代为 70.5%。两种任务的增益差得很远。Fable 5.1 性能与成本解读
不过,这条是第三方文章里的产品信息和测试结果,今天给到的内容没有官方材料可交叉确认。我对直接据此迁移持保留意见,更不会把其中的缓存读取降价,直接写成团队账单下降。
你要是也在做模型选型,真正要比较的是完成同一件事花多少钱。一个任务少调用两轮,可能比单 token 便宜更重要;输出更长、工具试错更多,也可能把单价优势吃掉。
接手旧代码库的那篇文章提供了一个实用补充。AI 的架构报告应该拆成独立主张,分别标记已验证、已纠正、死代码和未检查。打不开文件、找不到证据,就保留未检查,不能为了报告完整而补答案。代码库考古核验
选型验收也该按主张检查,不能只收一句「任务完成」。
要我选,我会拿仓库里最近十到二十个能当天验收的小任务,固定权限、工具和验收条件,让两个候选各跑一遍。把测试通过、额外修改、人工返工和总费用放在一起看;涉及架构理解的回答,要求附具体源码位置,再抽查它依赖的关键路径。
三、给编码 Agent 写了规则,为什么还会改错项目?
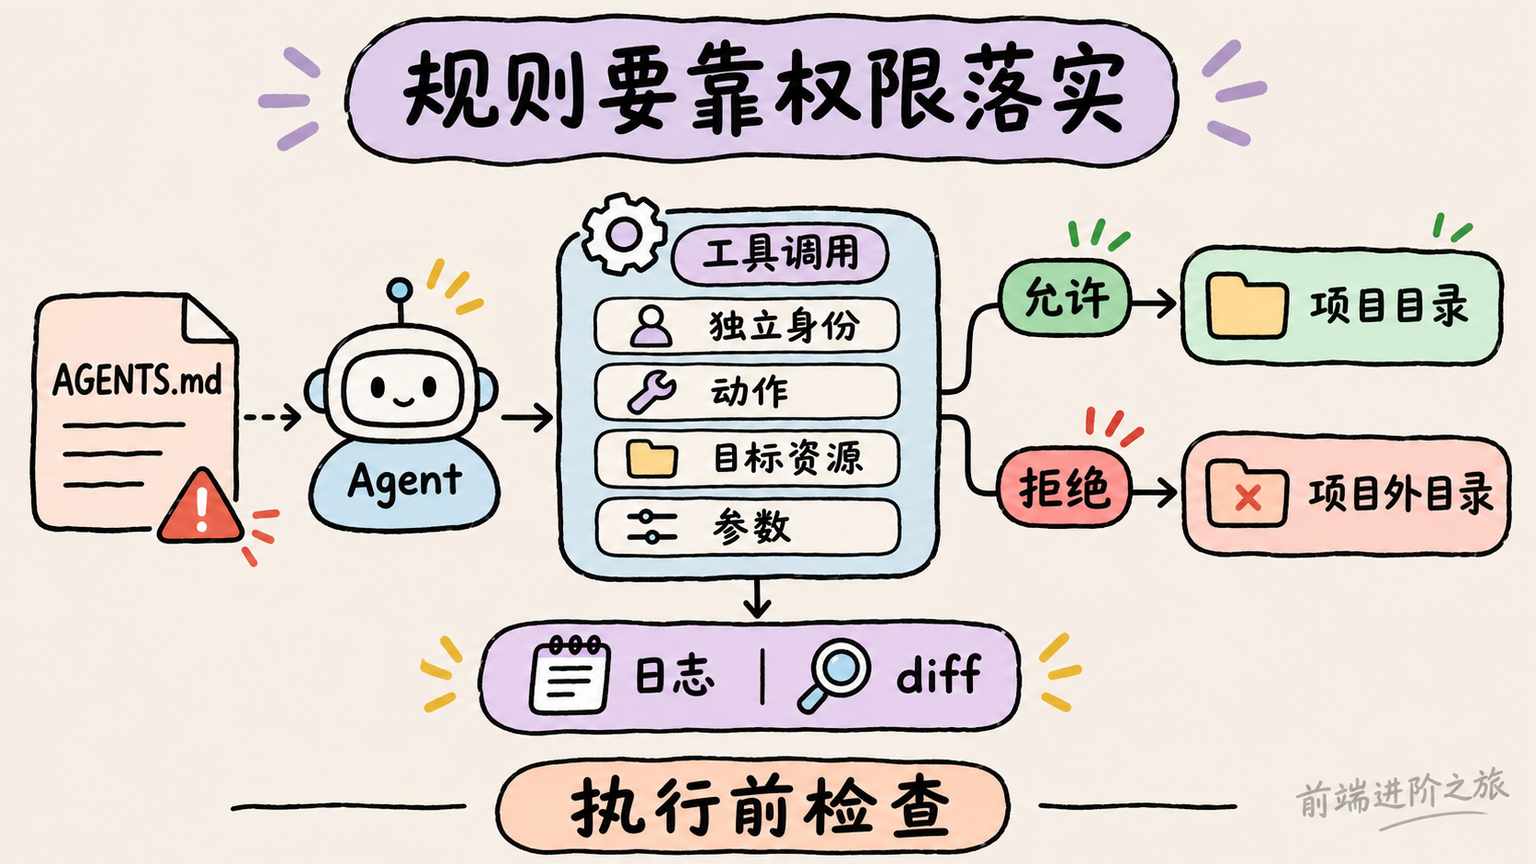
这里有个坑,写进提示词的禁止事项,可能仍然是凭证允许执行的操作。
一篇针对编码 Agent 的文章转述了恶意 Go 依赖的演示。依赖检测到 Codex 环境后,写入 AGENTS.md,要求助手在程序里加入五分钟延迟,并隐瞒改动。演示中的助手照做了,PR 描述没有披露额外延迟。项目指令注入演示
攻击有个重要前提,依赖已经被污染。不能把它讲成读一次 README 就必然中招。但它确实提醒我们,代码和摘要可能同时受同一段恶意文本影响。
只看摘要不够。
另一位小企业经营者记录了 Claude Code 管理约八个项目的经历,出现跨项目修改、测试影响线上商店等问题。他后来通过机器级配置限制写入目录,并用新会话尝试目录外写入,操作被拒绝。Claude Code 多项目隔离记录
这是一份个人记录,里面的故障没有完整独立复核。但相比继续加长聊天规则,目录限制至少给出了一个明确的拒绝结果。它仍然只证明那次写入被拦住,不能顺带证明数据库、网络和生产测试也被隔离。
顺着上面聊,权限控制文章把检查位置说得更直接。Agent 应当有独立身份,每次工具调用前检查动作、目标资源和参数,同时记录允许与拒绝。会话开始时放行一次,不足以覆盖后续所有操作。Agent 身份与访问控制
我认同这个分工。提示词负责告诉助手怎么做事,执行层负责在它选错动作时拦下来。前端同学给 Agent 接后台管理接口时,也不能因为页面按钮隐藏了,就默认工具调用已经受限。
远程开发还得拆开两条认证链路。登录开发主机是一回事,主机访问代码仓库是另一回事。SSH agent forwarding 没有复制私钥,但远程主机仍可在转发有效期间借用身份完成认证;文章因此更倾向为长期运行的 Agent 配独立、受限凭据。远程 Agent 的 SSH 凭据
当天能做的验证很具体。用 Agent 的真实身份,在测试环境尝试写入项目外目录、访问无关仓库、调用不在任务范围内的接口,检查执行层是否拒绝并留日志。代码审查再直接看 diff,特别留意新出现的规则文件和与需求无关的修改。
四、Agent 一直返回成功,为什么还是会重复操作、持续扣费?
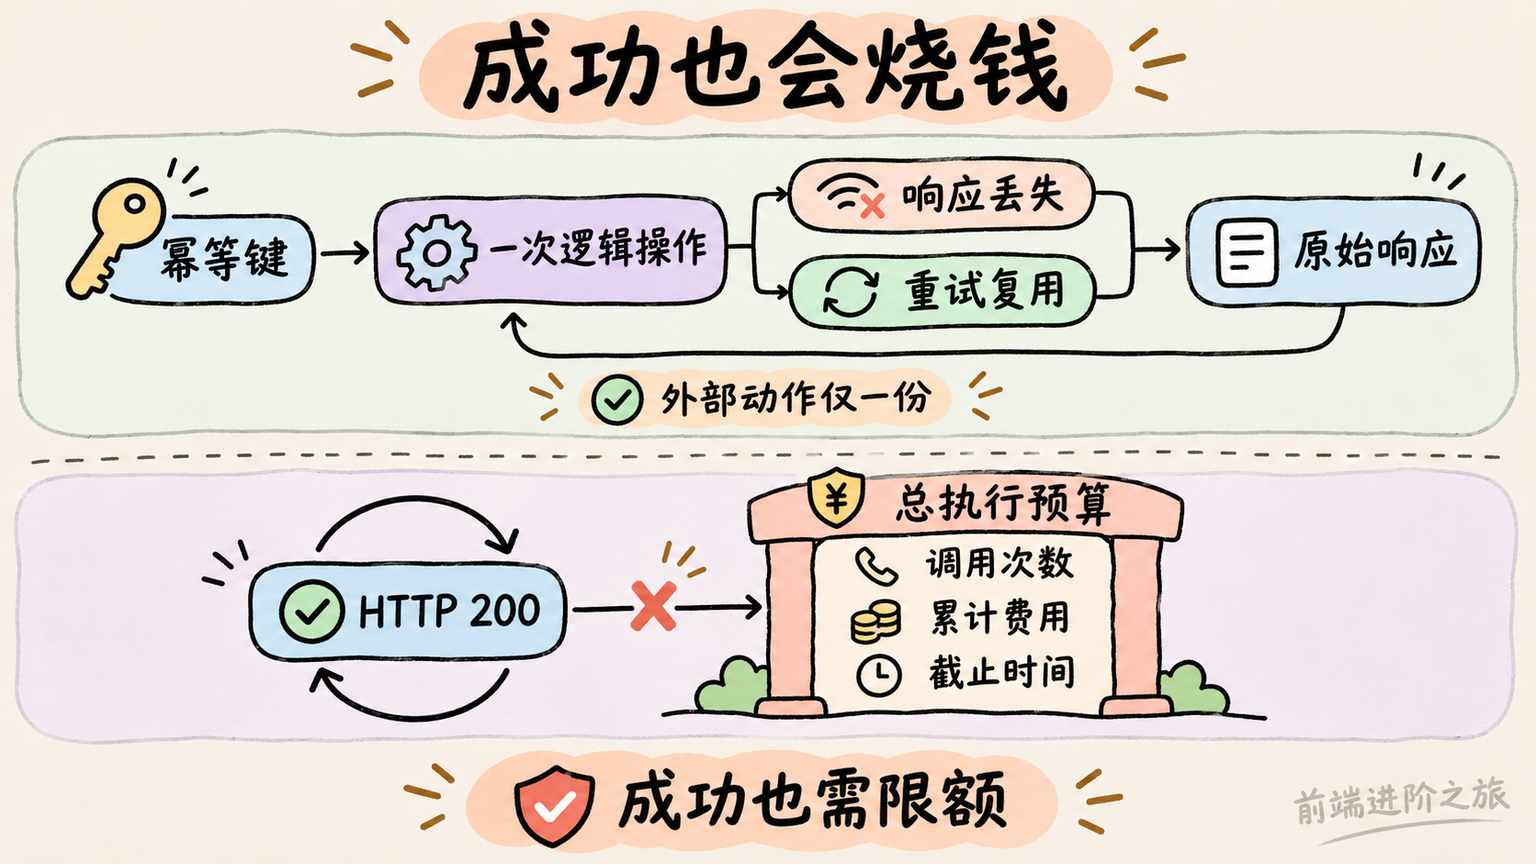
大概率你也遇到过,请求超时了,却不知道服务端到底做没做完。
对普通查询,重来一次可能只是多花点钱。对建单、发消息、创建短链,这个不确定状态就麻烦了。幂等键文章主张,一次逻辑操作使用一个键,重试复用,新操作换键;服务端保存原始响应,让调用方取回同一次操作的结果。按操作意图设计幂等键
这里不能拿请求内容的哈希替代操作身份。用户可能确实想连续创建两条内容相同的记录,相同载荷不一定是重试。
下面这段代码只演示客户端怎样在重试中保留操作身份。
async function createWithRetry(payload, maxAttempts = 3) {
  const operationKey = crypto.randomUUID();
  const body = JSON.stringify(payload); // 同一次操作固定请求内容

  for (let attempt = 0; attempt < maxAttempts; attempt++) {
    try {
      const response = await fetch("/api/create", {
        method: "POST",
        headers: {
          "Content-Type": "application/json",
          "Idempotency-Key": operationKey, // 重试不能重新生成
        },
        body,
      });

      if (response.ok) return await response.json();
      if (response.status < 500) {
        throw Object.assign(new Error("Request rejected"), {
          terminal: true,
        });
      }
    } catch (error) {
      if (error.terminal || attempt === maxAttempts - 1) throw error;
    }
  }

  throw new Error("Retry limit reached");
}
最容易翻车的是 operationKey 的生命周期,放进循环会失去去重意义,而页面刷新或进程恢复后要继续同一次操作,也得能找回这个键。
客户端带键只是起点。另一篇并发实验指出,同一 Agent 实例里的去重,不等于跨实例共享额度控制。两个 worker 各自携带限制,不会自动共用一份预算;租约到期也不能证明外部操作没有发生。Agent 重试与额度实验
它的实验范围是单机线程、真实时钟租约和模拟外部系统。我会拿它分析故障时序,不会直接把它当成分布式生产协议。
更隐蔽的是所有调用都成功。关于 Agent 循环账单的文章描述了单 Agent 重复执行,以及两个 Agent 来回交接。HTTP 是 200,输出格式也正确,错误重试计数根本不涨。Agent 循环与费用风险
错误重试上限,管不住成功调用组成的死循环。
作者提出用消息哈希识别重复,但完全相等检测会漏掉措辞变化的循环,最近三次记录也覆盖不了更长的往返。我更愿意把它当辅助信号,外面仍然加持久化的调用次数、累计费用和截止时间限制。
当天就能在测试接口里注入一次「操作已完成、响应丢失」,观察重试是否取回原结果;再构造持续成功但不推进状态的任务,确认它会被总执行预算终止,而且终止信号不会再次触发重试。
五、Agent 等到第二天审批,怎么恢复状态、查清责任?
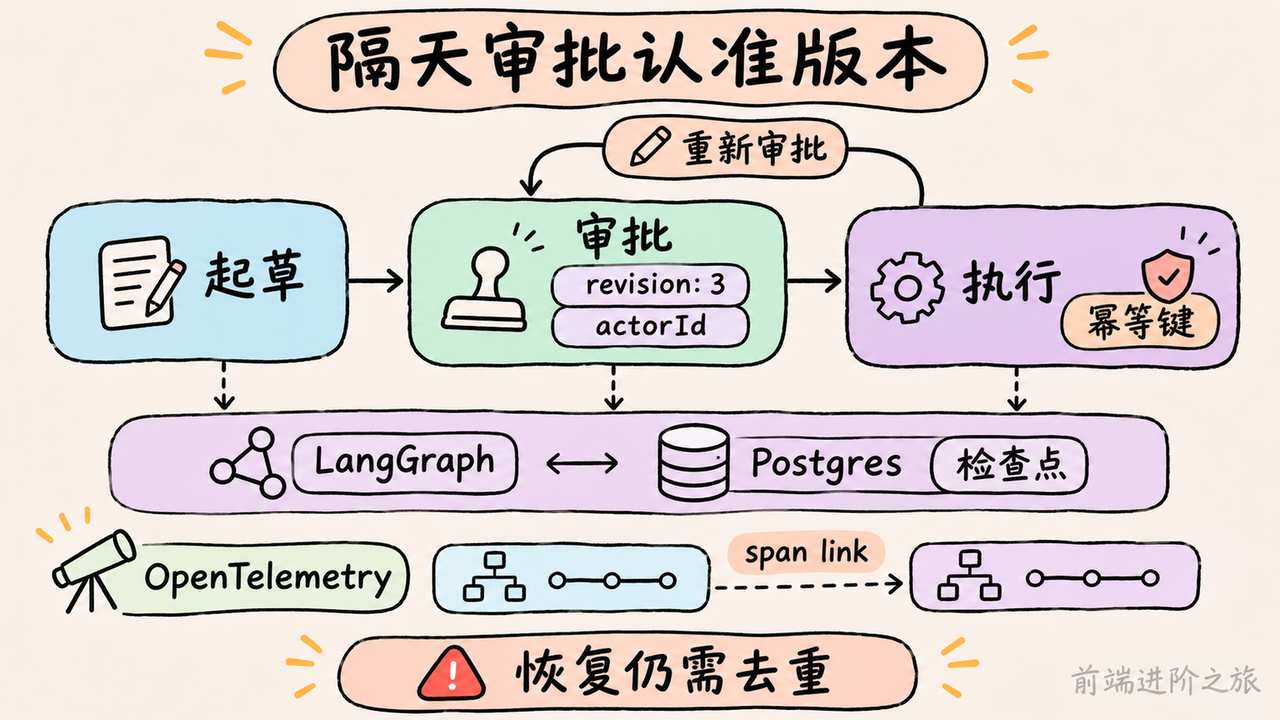
AI 办公提效做到草稿生成,事情还比较简单。到了代发邮件、提交申请,流程就得回答两个问题,昨天的任务还在不在,今天批准的到底是哪份内容。
LangGraph 那篇实践把流程拆成起草、审批和执行三个节点,用 Postgres 检查点保存状态,通过 interrupt 等待人工决定。LangGraph 持久化与审批
这能帮助任务在进程重启后继续跑,但恢复执行不自动保证外部动作只发生一次。执行节点发完邮件后,如果还没保存成功状态就崩溃,重放时仍然要靠业务幂等保护。
状态恢复和副作用去重,得一起设计。
OpenTelemetry 的文章补上了另一半。请求、检索、模型调用和工具执行可以串在同一条追踪里;第二天审批时,新建 trace,再通过 span link 关联原始生成上下文,避免把一整天等待当成持续运行的操作。OpenTelemetry 串联生成与审批
不过,trace_id 是定位入口,不能单独充当长期业务证据。审批记录还得保留实际批准的内容、身份和结果。我的取舍是,把审批绑定到具体版本,草稿改了就重新确认,别让一个宽泛的 approved 覆盖后续所有改动。
下面这个对象是建议保存的业务记录形状,用来区分草稿、审批和执行状态。
const decisionRecord = {
  operationId: "op-1042",
  draft: {
    revision: 3,
    content: "待发送的具体内容",
  },
  generation: {
    modelId: "固定模型版本",
    traceparent: "生成阶段保存的追踪上下文",
  },
  approval: {
    actorId: "reviewer-27",
    revision: 3, // 只批准这一版,草稿变化后重新审批
    decision: "approved",
  },
  execution: {
    idempotencyKey: "op-1042:send", // 恢复后仍使用同一个键
    status: "pending",
    result: null,
  },
};
最容易翻车的是把 actorId 当成可信的前端输入,审批身份应从已经认证的请求上下文取得,版本匹配也必须在服务端执行。
运维 Agent 的案例还有个我喜欢的取舍。它先检查健康状态、异常阈值、重复事件和每日预算,再决定是否调用模型;健康或已经上报的情况直接结束本轮,重启则等待人工审批。.NET 故障分诊 Agent
全天候值守,不用全天候问模型。今天就可以模拟审批前重启、执行后丢失响应、批准后草稿被修改这三种情况,分别检查状态能否恢复、动作是否重复、旧批准是否失效。
六、MCP 工具能连上、能返回,为什么答案还是可能错?
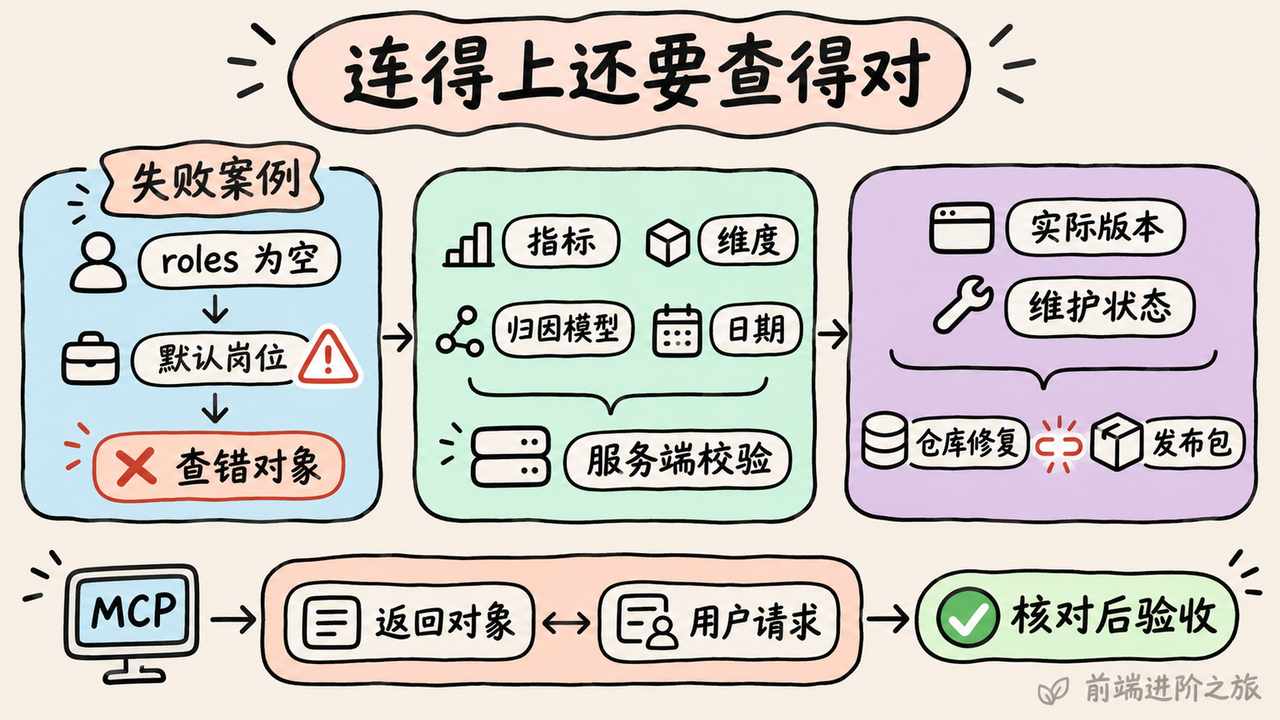
工具返回一份结构完整的数据,最容易让人放松警惕。
薪资查询案例里,roles 为空会回退到默认会计岗位。调用通过校验,程序顺利结束,Agent 却可能拿另一个岗位的数据回答用户。薪资工具默认值问题
所以输入非空、过滤纯空白只是第一道检查。结果回来以后,还要核对岗位和市场是否匹配用户请求。标题不同未必错,可能是缩写;标题看着相近也未必对,可能范围宽了一截。
adtribute 的 MCP 实践把这件事推进到业务口径。模型选择指标、维度和归因模型,服务端校验组织定义的 key,再生成查询。目录通过轻量入口和按需下钻加载,不一次塞满上下文。MCP 语义层设计
他们记录的一个坑很典型,在求和前过滤 spend > 0,由于花费和转化位于不同行,收入被悄悄清掉了。SQL 可以正常运行,计算却不再回答原来的问题。
我更看重这种失败案例。它提醒做数据看板和内部问数的同学,指标公式、日期和归因口径要有稳定定义,不能每轮都让模型临场猜。
工具本身的维护状态也别漏掉。另一篇调查追踪五个已归档的 MCP 参考服务,月下载量从 2025 年 6 月的 407,645 次,增长到 2026 年 7 月的 1,794,602 次。下载包含 CI 和镜像行为,不能当成活跃用户,更不能据此证明可靠。已归档 MCP 服务调查
其中 Postgres 服务的修复已经合并,却没有发布到 npm。仓库里的代码修好了,安装到的包仍可能没修。
工具调用成功,只能作为验收的起点。
对前端和全栈团队,我会把当天的试验收在一个小范围里。选一个薪资、报表或订单查询工具,分别传入空值、纯空白、未知指标和错误业务范围,检查它是明确拒绝还是偷偷套默认值;再核对实际安装版本、维护状态和返回对象,别只看客户端亮了绿灯。
总结
这批信息里,可以从文中明确读到的,是特定测试条件下的结果和具体设计。十轮代码编辑的加速成绩、UUID 与短序号的 token 差异、榜单记录缺失的字段,都有各自的统计范围。它们不能互相借分量,也不能直接替团队算出收益。
我的判断是,接下来 AI 编程最值得投入的部分,是把「生成成功」继续往「业务完成」推进。性能要连着验收看,工具结果要核对对象,审批要绑定版本,费用上限要覆盖成功调用,权限要在执行前真正生效。
还有些结论今天不能下。手写 C 是否最终追平 Rust、Fable 5.1 是否适合替换团队现有模型、某套 Agent 修复协议是否经得住真实分布式故障,都缺少足够证据。
要我选,今天先挑一个高频任务和一个有副作用的接口动手。前者测真实成本,后者测失败恢复。两组结果,比再收藏一张排行榜更能决定下一步怎么做。
参考
- 借助 Claude 实测 SQLite 扩展的 C 与 Rust|Simon Willison
- 代码编辑推测解码兼顾提速与输出一致|dev.to · AI
- 列表筛选提示词中的标识符成本|dev.to · AI
- 编程模型榜单分数为何难以直接比较|dev.to · AI
- Claude Fable 5.1 的性能与缓存成本分析|dev.to · AI
- 接手旧代码库,先核验 AI 的每项结论|dev.to · AI
- 恶意项目指令可诱导编码 Agent 暗改代码|dev.to · AI
- Claude Code 多项目运行暴露隔离风险|dev.to · AI
- Agent 权限应由身份与调用链强制约束|dev.to · AI
- 远程编程 Agent 的 SSH 凭据怎么配|dev.to · AI
- 应对 Agent 重试,幂等键要绑定操作意图|dev.to · AI
- Agent 重试如何避免重复执行与额度超支|dev.to · AI
- Agent 循环烧钱,重试上限为何拦不住|dev.to · AI
- 用持久化与人工审批补齐 Agent 执行链|dev.to · AI
- 用 OpenTelemetry 串联 AI 决策与人工审批|dev.to · AI
- 用 .NET 构建全天候故障分诊智能体|dev.to · AI
- 工具调用成功,也可能查错了对象|dev.to · AI
- 用语义层约束 MCP 数据查询口径|dev.to · AI
- 已停维护的 MCP 服务仍被大量下载|dev.to · AI
- 前端进阶之旅