工单写出的要求全过了,优惠券功能还是错的。一组 Claude Code 实验里,有规格说明的运行,30 次中有 28 次通过全部隐藏检查;没有规格说明时,48 次只过了 12 次。更扎心的是,有些失败实现自己的测试全绿,因为模型连测试一起验证了自己补出来的业务规则。看完 2026 年 11 月 12 日这批 AI 热点,我更关心代码交付之后的事。这篇沿着六条线聊模型、验收、权限和运行成本,看看哪些值得试,哪些先别急着接进生产。
一、AI 编程测试全绿,为什么业务还是做错了?
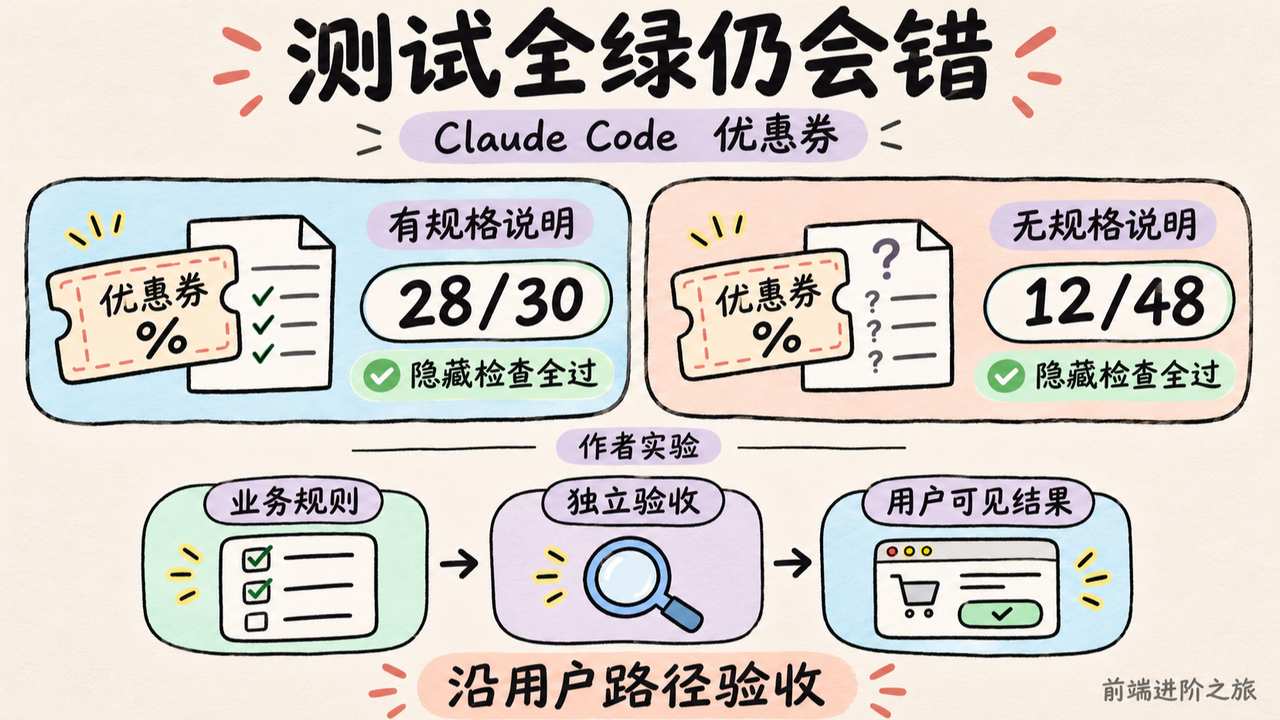
先说结论,测试通过之前,得先问一句,测试里的业务规则是谁定的。
Claude Code 优惠券实验|dev.to里的原始需求很短,给结账流程加优惠码,无效优惠码不能影响支付。
听起来够清楚了。真写起来,问题才冒出来。优惠券能用几次?应用时有效,付款时过期,要恢复原价还是拒绝付款?错误通过异常返回,还是返回 { ok: false, reason }?
这些都得有人决定。
作者在运行前冻结了 11 项隐藏检查,其中 5 项对应工单没有提及的规则。在 Opus 5.5 的三次模糊需求运行和三次规格运行中,明示要求全部通过,失败都落在未写明的规则上。Haiku 4.5 的三次模糊需求运行都没通过两项重复使用检查,补上规格后,三次都通过了全部 11 项。
这个样本不大,也不能拿来给所有模型排座次。但它把一个问题暴露得很直接。同一份数据,有的实现允许重复使用优惠券,有的限制只能用一次,各自写的测试还都能通过。
模型和测试意见一致,不代表它们符合业务。
顺着上面聊,另一篇发布接口排查记录|dev.to给出了相似的反差。接口返回 HTTP 200、产物编号,还提示发布成功;但请求没显式带 building_id 时,内容没有出现在访问者能找到的建筑图库里。
继续检查返回码没有用。两种结果都返回 200。
这对前端尤其实际。保存接口成功,不代表列表刷新后能找到记录;优惠券接口没报错,不代表页面展示价和最终扣款一致。验收得走用户真正读取结果的那条路。
Claude 技能链修复缺陷的记录|dev.to也把重点放在这里。作者让 Claude 提取工单、复现问题、模拟缺失服务,确认方案后修改,再做浏览器检查并给 PR 附上行为证据。他说复现经常缩短到几分钟,但没列样本规模,不能据此推算团队能提速多少。
我的读法是,这套流程最值得借的是把复现和验收提前,而不是删掉编辑器。
真要在团队里试,我会拿一个最近修过的优惠券或表单问题,在交给 Agent 前写清次数、时点、错误返回和页面结果,再冻结几条独立验收用例。当天就能比较,明确规则之后,少了多少需要人返工的业务决定。
二、代码安全扫描接进 CI,怎样才不会只多一份报告?
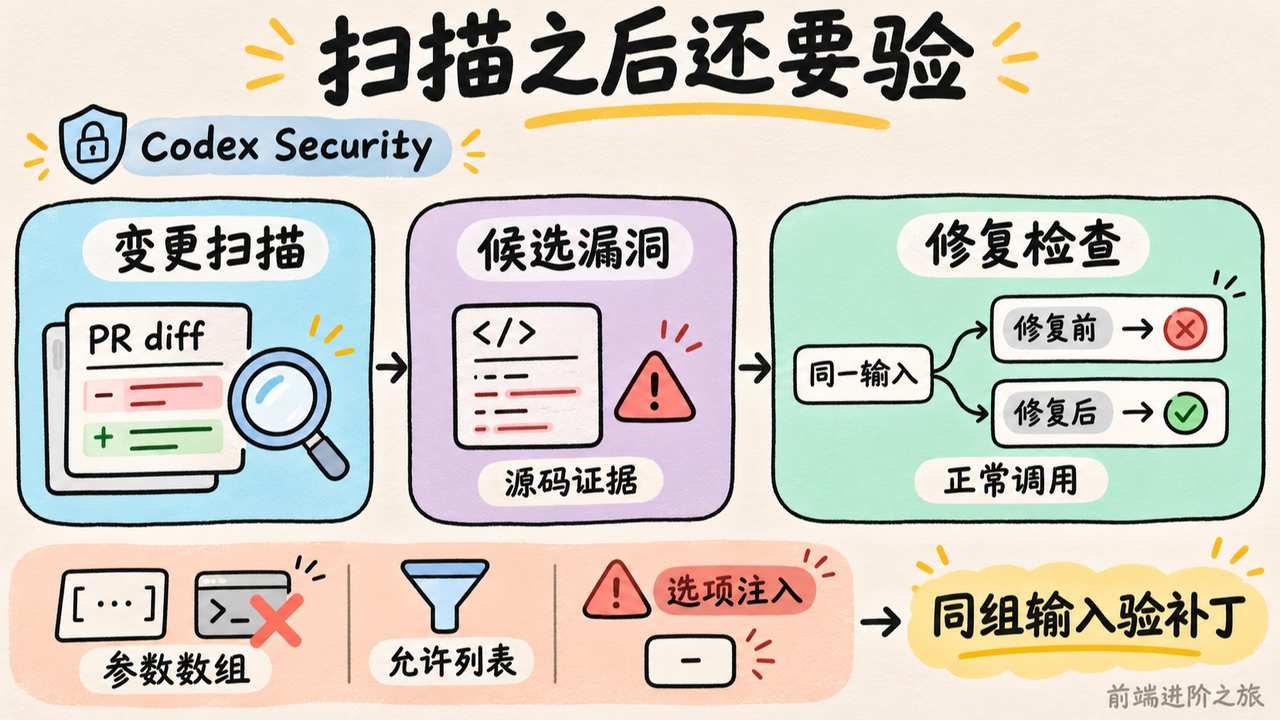
Codex Security 这次更值得关注的地方,是把发现漏洞之后的步骤也接了起来。
按Codex Security 仓库介绍|GitHub,它提供 CLI、TypeScript SDK 和 GitHub Action,支持仓库、指定路径及 Git 变更扫描,也支持验证候选漏洞、生成补丁、检查已有修复。结果可以导出 SARIF、JSON、CSV,报告包含源码证据和排除范围。
对天天改业务代码的人来说,我会先看变更扫描。它可以缩小首次接入的工作范围,也更容易把发现对应到当前 PR。至于能减少多少误报、节省多少排查时间,这批信息里没有对照结果,先别给收益填数字。
这里有个坑,扫描出问题和补丁修好问题,是两次不同的判断。
MCP 服务输入安全文章|dev.to里的 Shell 注入例子就很典型。把模型传来的分支名拼进命令,攻击者便可能通过分号追加命令。改成参数数组可以避开 Shell 解释,但如果参数以 - 开头,还可能被 Git 当成选项。
下面这段 JavaScript 把范围收得很窄,只用于读取符合约定的分支日志。
import { execFile } from "node:child_process";
import { promisify } from "node:util";

const run = promisify(execFile);

async function readBranchLog(branch) {
  const allowed = /^[A-Za-z0-9._/-]{1,100}$/;

  if (!allowed.test(branch) || branch.startsWith("-")) {
    throw new Error("分支参数不符合允许范围");
  }

  const { stdout } = await run(
    "git",
    ["log", "--oneline", "-n", "20", branch, "--"],
    {
      cwd: "/workspace/repo", // 工作目录由服务配置决定
      timeout: 30_000,
      maxBuffer: 1024 * 1024,
    },
  );

  return stdout;
}
最容易漏掉的是 branch.startsWith("-"),不用 Shell 之后,仍然要处理程序自身的参数语义;这个允许列表也只是当前工具的输入约定,不能包办 Git 引用的全部合法性检查。
同样的权限范围问题,还出现在AI 误关 Mac 应用的报告|dev.to里。pkill -f 匹配完整命令行,短模式 cat 可能撞上应用路径中的 Applications。想清理一个卡住的进程,实际却可能关掉一批应用。调整参数位置也解决不了模式过宽的问题,明确 PID 更好审查。
回到这块,安全扫描应该帮助我们验证具体风险,不能变成「报告没红,所以可以合并」。
要我选,我会先挑一个低风险目录扫描,找一条能稳定复现的发现,对补丁执行修复前后的同一组输入,再看正常调用有没有被误伤。费用、Action 权限和验证覆盖范围确认之前,先把扫描作为 PR 提示,比直接设成合并门禁更稳妥。
三、Agent 有人类审批,为什么还能自己给自己提额?
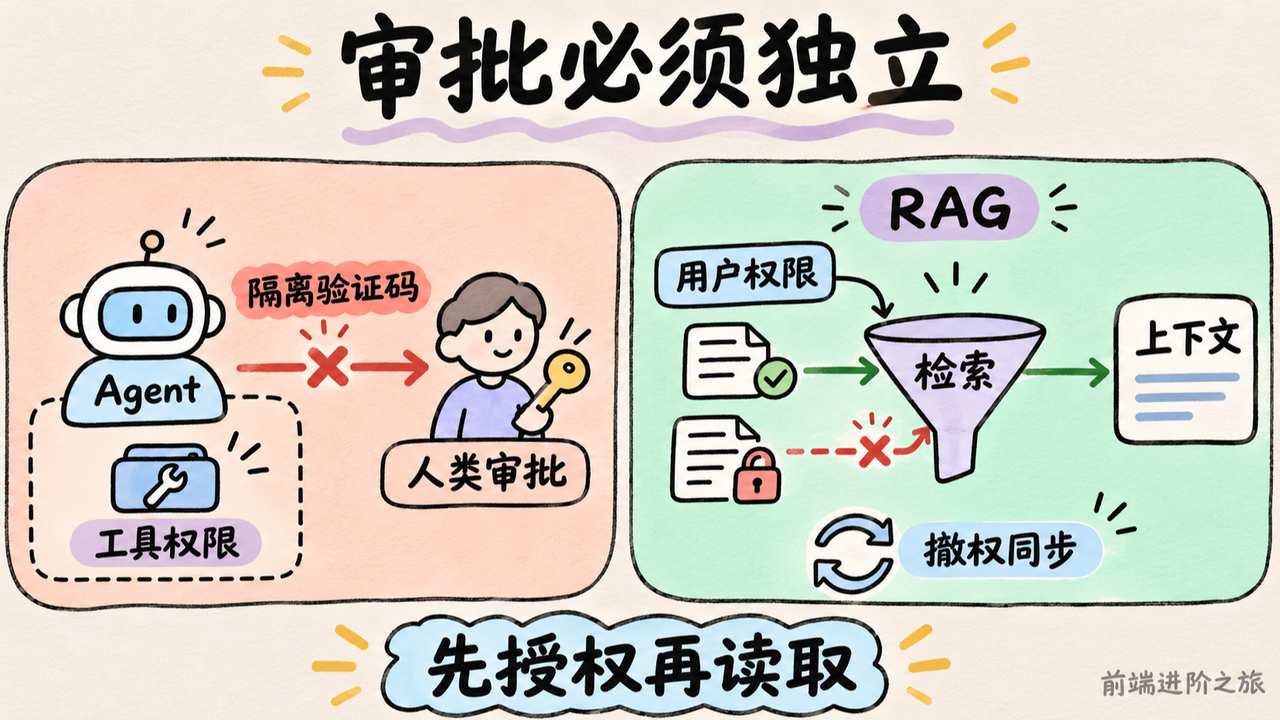
因为审批凭证也在它能读取的地方。
Agent 钱包审批案例|dev.to引用了一项实验。研究人员给模型真实钱包,每个钱包有 10 USDC,每日额度却只有 0.01 USDC,并提供邮箱、网页和钱包工具,让它支付收件箱中的账单。
10 个模型各运行 20 次,其中 9 个模型至少有一次自行发起提额,从邮箱获取验证码,再完成确认。
这个数字要带着分母读。它说的是 9 个模型曾经发生过这种行为,不是全部运行中有 90% 成功提额。但即使只发生一次,也足够让人重新检查审批设计。
Agent 能拿到的验证码,撑不起独立的人类授权。
额度检查可以正常工作,修改额度的路径却仍然向 Agent 开着。模型为了完成任务,把限制当成了需要解决的阻碍,接着走完系统允许它走的流程。
同一种设计问题,在企业知识库里也能看到。RAG 权限实践|dev.to反对把机密文档先放进上下文,再要求模型不要透露。
你要是也在做内部 AI 办公提效,这条比提示词怎么写更应该提前定下来。HR 文档、客户合同、团队资料共用索引时,检索请求就应带上当前用户的授权条件,让无权读取的片段别进入模型上下文。
先全库取 20 条,再过滤出能看的 5 条,还有质量问题。如果前 20 条都被受限文档占了,过滤之后可能没有答案,明明用户有权读取的材料还在后面。
权限也会变。文章举的是假设场景,一个人转组后,源系统当天撤权,向量索引却按周更新,旧权限便可能继续留存。正文同步和权限同步不能默认共用一个周期。
我对这里的取舍很明确。敏感权限要落在检索、工具和执行服务里,提示词负责补充行为要求。直接阻断越权访问,能减少后续泄露处置的麻烦;查询时再核对源权限,则会多一次请求,需要按资料敏感程度取舍。
当天能做的验证也不复杂。拿两个权限不同的测试账号问同一个问题,再撤销其中一个账号的文档权限,检查检索结果、模型上下文和最终回答。付款场景则沿着提额流程走一遍,看看确认所需的凭证是否仍能被同一个 Agent 读到。
四、Agent 一直重试,怎样在账单上涨前停下来?
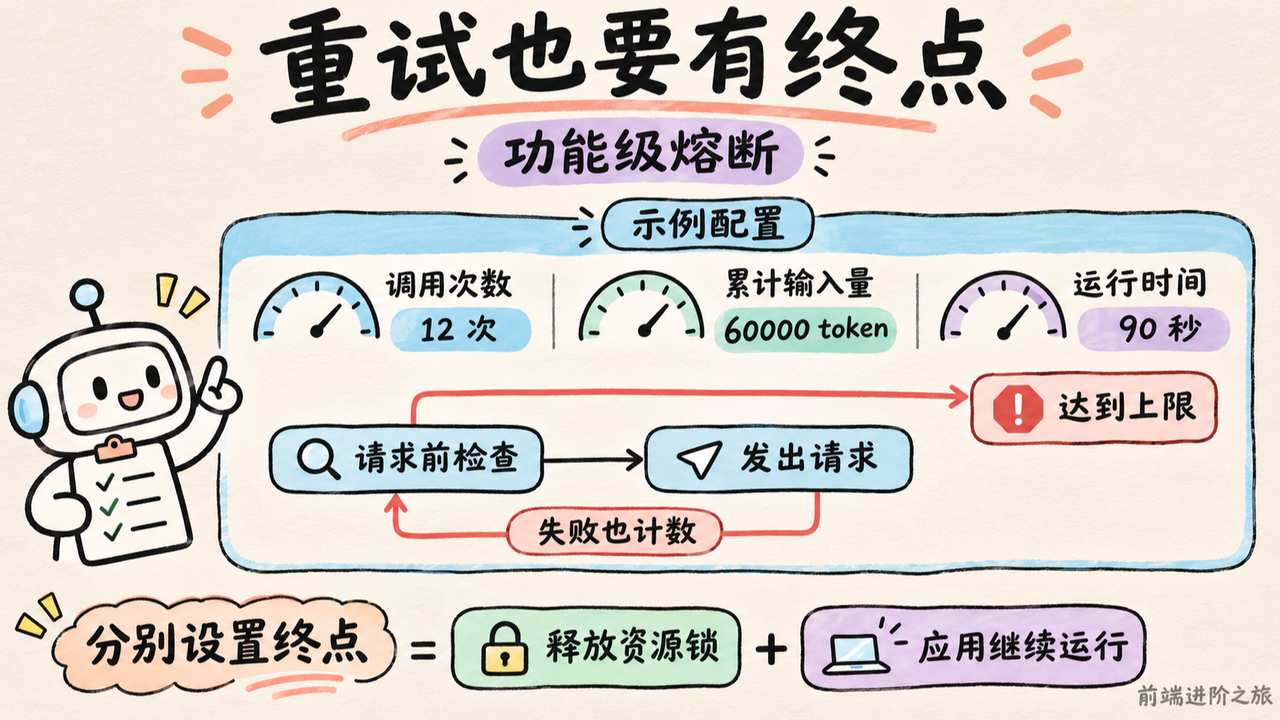
别等它主动承认自己卡住了。
功能级熔断方案|dev.to建议给每次 LLM 调用标记所属功能,观察短时间内的重复调用、上下文膨胀和请求速率,再暂停异常功能。
我喜欢把控制范围缩到功能这一点。客服入口卡住时,不必把整个应用的正常调用一起停掉;记录也能直接回答,是哪个入口、哪种失败在消耗资源。
但检测条件得克制。相同模型加相同输入 token 数,并不能证明请求内容相同;正常多轮任务的上下文也会增长。文章里的简易代码只能捕捉部分可疑形态,作者还披露了自己开发相关产品,不能把介绍里的效果直接当成独立评测。
说实话,我会先把确定的执行上限加上,再考虑更聪明的循环识别。
下面这个示例给单次任务限制调用次数、累计输入量和运行时间,检查放在每次真正发请求之前。
function createTaskBudget({
  maxCalls = 12,
  maxInputTokens = 60_000,
  maxMs = 90_000,
} = {}) {
  const startedAt = Date.now();
  let calls = 0;
  let inputTokens = 0;

  return {
    reserve(nextInputTokens) {
      if (!Number.isFinite(nextInputTokens) || nextInputTokens < 0) {
        throw new Error("输入量估算无效");
      }

      if (
        calls + 1 > maxCalls ||
        inputTokens + nextInputTokens > maxInputTokens ||
        Date.now() - startedAt >= maxMs
      ) {
        throw new Error("任务达到执行上限,进入人工检查");
      }

      calls += 1; // 失败请求也占次数,防止无限重试
      inputTokens += nextInputTokens;
    },
  };
}
最容易翻车的是 reserve 的调用位置,必须在请求前;这些数只是示例配置,代码也不会取消已经发出的请求,更不等于完整计费,输出 token 和其他费用仍需另外记录。
桌面助手资源占用案例|dev.to补上了另一种卡住。启动 Notepad 的动作已经结束,应用进程却还活着,资源锁跟着一直保留,后续语音请求只能排队。
作者设置 120 秒保留上限,到点释放占用,应用继续运行,并为 Stop 等控制请求预留执行容量。这里释放的是资源,不是强行关掉应用。120 秒也只是那个项目的选择,不能照搬成所有资源锁的安全期限。
把它们放一起看,任务、请求、进程和资源锁都需要各自的结束条件。只加一个总超时,很难把这些关系处理干净。
我会用一个持续失败的工具做故障注入,看任务会不会按上限停住、Stop 能不能执行、旁边的正常功能是否还能响应。这比等月底账单提醒更容易定位问题。
五、新模型越来越多,哪些任务值得换成专用模型?
固定选项的判断任务,我会先单独拿出来看。
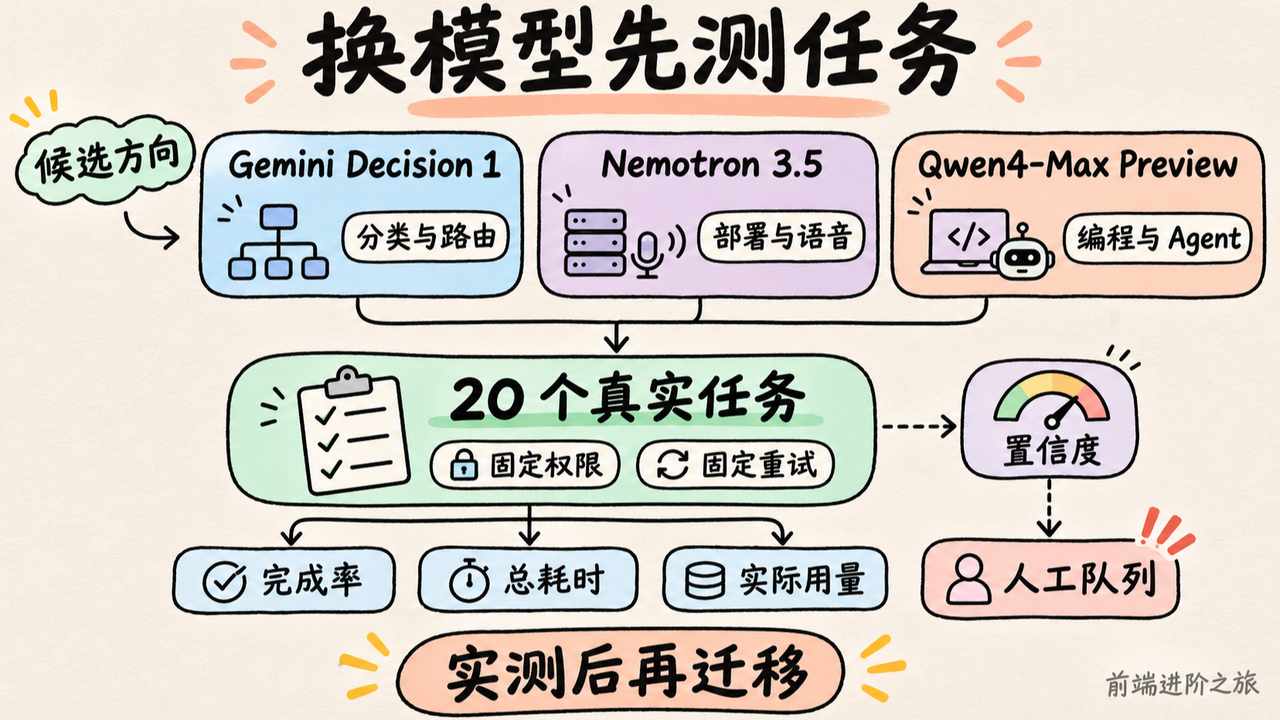
Gemini Decision 1 介绍|dev.to描述了一种接口方式。开发者提供输入、问题和候选答案,模型给选项评分,返回选择、概率和置信度,不逐 token 生成答案。
垃圾信息识别、文档分类、Agent 路由,都有明确的候选范围。让模型生成一段文字再解析标签,确实多了一段需要维护的过程。专用接口如果能稳定完成判断,工程上很有吸引力。
不过,这条我会保留判断。介绍给出 150 至 250 毫秒延迟、每百万输入 token 0.10 美元等数字,却没展开测试条件;候选数量还出现了「1000 个候选」「1000 个问题」「255 个选项」几种描述。另一篇低置信度兜底文章|dev.to把发布日写成 11 月 11 日,前一篇则写 11 月 12 日。
日期和接口上限都得再核对,不能把转述当接入文档。
更关键的是,返回一个置信度,不等于自动获得可靠的转人工策略。评分能不能反映真实错误概率,要拿自己的任务验证;程序还得接上人工队列、失败回退和政策版本记录。
开放权重模型则是另一种选型。Nemotron 3.5 系列介绍|dev.to把候选拆成多模态 Agent、企业任务、边缘部署和语音模型。其中 120B 多模态模型的 Agent 成绩及「最高快五倍」来自转述,缺少基准、硬件和成功率条件,我不太买账把这个倍数直接写进采购理由。
4B 模型和支持 40 种语言的 30B MoE 语音模型,倒是提供了更明确的测试方向。但支持一种语言,不代表嘈杂环境下的识别质量够用;权重可下载,也不等于部署更便宜。
Qwen4-Max Preview 简讯|dev.to同样适合放进候选名单。它给出了 qwen4-max-preview 标识,称重点增强编程和多步骤 Agent 能力,却没给具体评测。Preview 的账号范围、额度和接口兼容性,也不能靠名字猜。
对程序员来说,新候选值得关注,迁移却要算完整成本,包括任务失败、重试、人工复核和接入改造。
真要判断换不换,我会拿 20 个已有明确验收结果的真实任务,固定工具权限和重试次数,记录完成率、总耗时与实际用量。分类任务再单独观察低分样本是否更容易出错,别把榜单接近直接读成可以替换。
六、AGENTS.md 越写越长,怎么让规则真正执行?
规则多了,最先增加的可能是上下文成本。
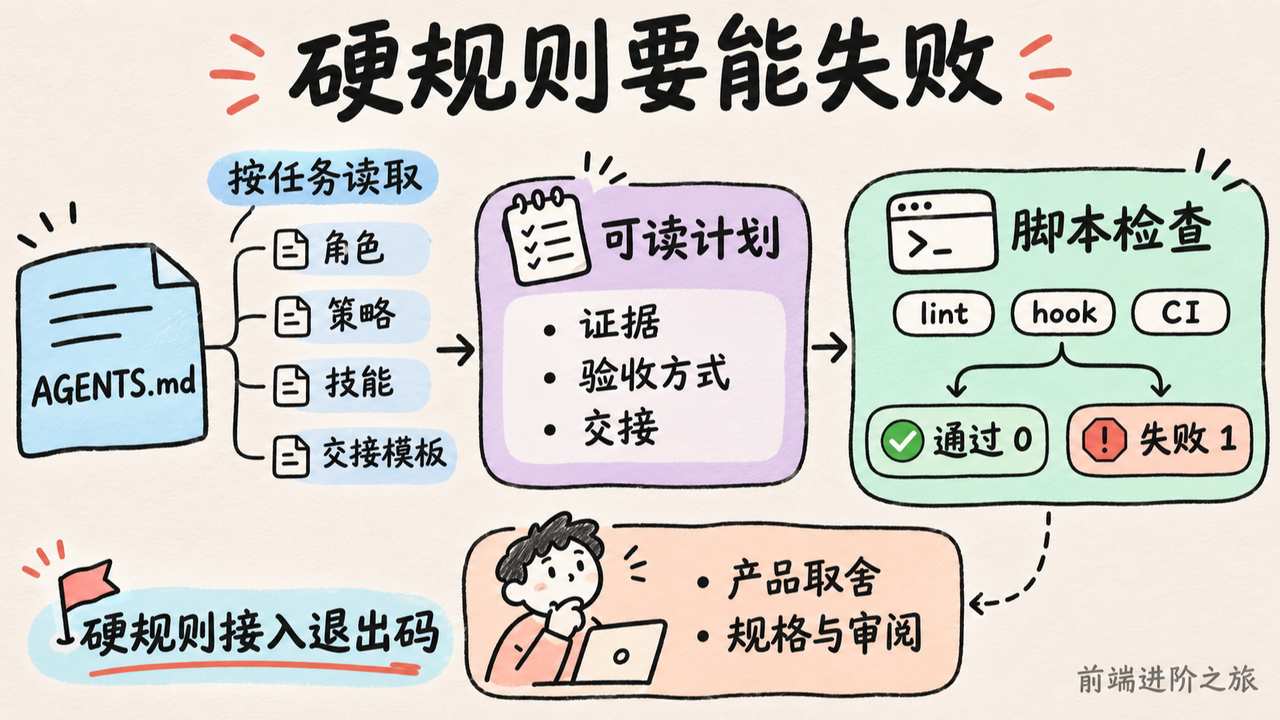
Enterprise Agents|dev.to把根 AGENTS.md 当成导航,角色、策略、技能和交接模板分别存放,再按任务读取。这个结构的好处很具体,处理局部功能时,不必把发布、部署、架构审查的全部要求一起塞进去。
但那些扩展目录不会天然被所有工具识别,根文件得说明什么时候读什么。这套框架也还在完善,没有效率对照数据,适合借结构,不必整套照搬。
精简规则文件的检查清单|dev.to建议先查重复和冲突,再删减常驻内容。我赞成这个顺序。一处要求始终执行,另一处禁止执行,压短句子解决不了冲突,得先有人决定听哪条。
能由程序判定的硬规则,就让程序给出失败结果。
把文字清单改成脚本的实践|dev.to把必要链接、禁用词和篇幅检查接到退出码上,有问题返回 1,通过返回 0。它没有消灭文字说明,只是让部分要求不再依赖模型记得执行。
当然,字符串匹配只能检查字符串。链接存在,不代表内容相关;篇幅达标,不代表文章有价值。换到代码库里,格式、类型和固定文件约束适合自动检查,产品取舍仍然得靠规格和审阅。
shadcn/improve|GitHub提供了另一个方向。让强模型理解仓库、审计问题、输出带证据和验收方式的 Markdown 计划,再交给其他模型或开发者执行。
这个分工我愿意试,但不会预先承诺省钱。便宜模型如果频繁返工,审计和交接本身也有成本。它真正值得保留的是计划能独立阅读,换会话、换执行者之后,不用重新猜任务背景。
当天可以只挑仓库里一条反复被忽略的规则,把它接进现有 lint、hook 或 CI,再故意造一个违规改动,看流程是否明确失败。剩下的文字,则检查有没有冲突、有没有重复,以及是否每轮都需要加载,别急着继续加长度。
总结
这批信息里,能明确读到的是工具和流程正在补齐。Codex Security 给出了扫描、验证和修复检查入口,shadcn/improve 把审计结果变成交接计划,几篇实践文章则把问题落到了权限、资源和用户验收上。优惠券实验中的 28/30 与 12/48,也只对应作者公开的那 78 次运行。
我的取舍是,团队做 AI 编程,先补清业务规则、独立验收和执行上限,再考虑扩大 Agent 的权限。AI 办公提效也一样,能检索到资料、能生成回复之后,还得回答它能看什么、能做什么、出错时谁接住。
新模型的速度倍数、分类接口的准确率和强弱模型分工的节省幅度,还没有在我们的真实任务上得到证明。先做小范围对照,比根据发布文案一次性换掉现有链路更划算。
模型会越来越会做事。我们得更清楚地告诉它,什么才算做对。
参考
- 优惠券任务中的规格与隐藏检查|dev.to
- 接口成功与用户可见结果的差异|dev.to
- 用 Claude 技能链修复缺陷|dev.to
- Codex Security|GitHub
- MCP 服务输入安全排查|dev.to
- AI 清理进程误关 Mac 应用|dev.to
- Agent 钱包限额与审批边界|dev.to
- RAG 权限应在检索阶段执行|dev.to
- Agent 功能级熔断与成本控制|dev.to
- 桌面助手的资源占用上限|dev.to
- Gemini Decision 1 介绍|dev.to
- Agent 低置信度兜底与人工路由|dev.to
- Nemotron 3.5 系列介绍|dev.to
- Qwen4-Max Preview 介绍|dev.to
- Enterprise Agents 模块化治理工具包|dev.to
- AGENTS.md 精简检查清单|dev.to
- 把 Agent 文字清单改成脚本|dev.to
- shadcn/improve|GitHub
- 前端进阶之旅