22 秒才看到第一条帖子,改完后只要 2.7 秒。X 网页重构的这个数字,比「AI 又能写多少代码」更让我在意。不过,它测的是 Slow 4G 下账号主页首帖的加载时间,不能直接算成 AI 带来的效率提升。同一天,另一篇报道里的模型却在特定任务中少完成约四成评估标准,过程还看不出明显异常。2026 年 11 月 5 日这份 AI 热点日报,我想沿着六条线聊聊,帮大家判断哪些能力值得接进业务,哪些成本和验收还得自己补上。
一、AI 编程真能加快交付,为什么不能只看生成速度?
先说结论,我更愿意看用户少等了多久,再看模型写了多少。
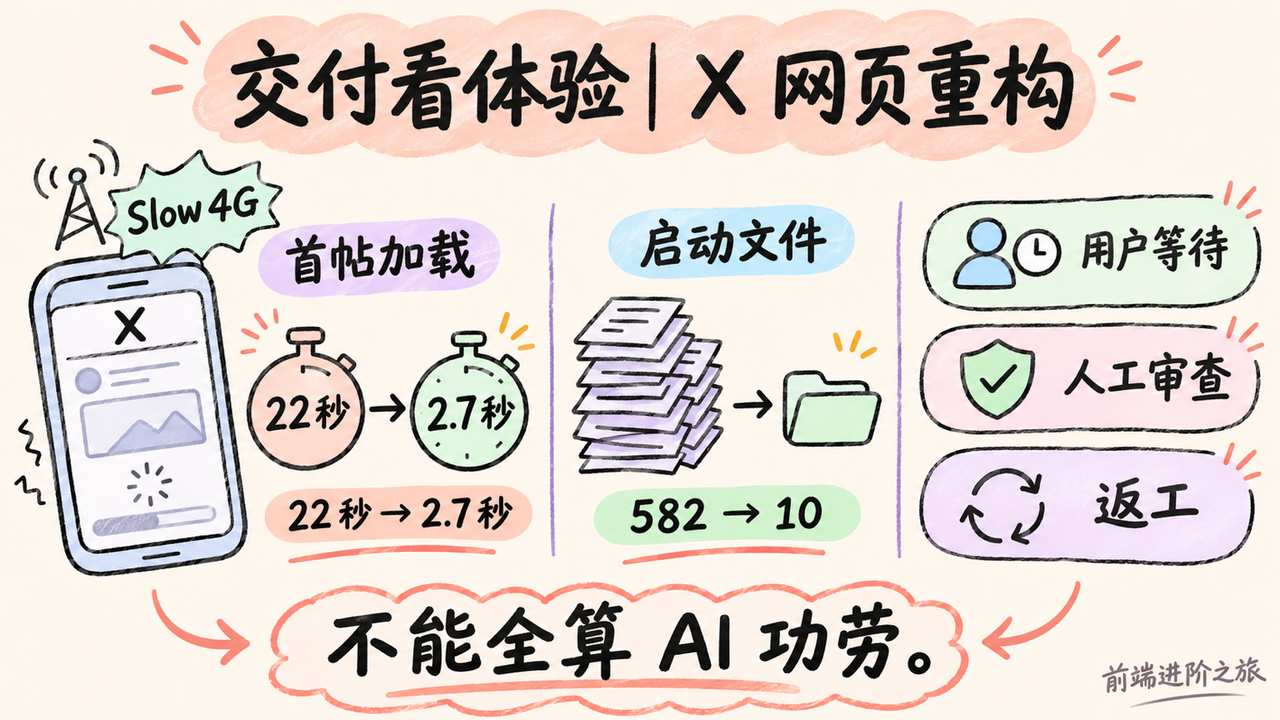
X 这次重构给出了一个挺具体的结果。在约 150ms 延迟、下行 1.6 Mbps、上行 750 Kbps 的 Slow 4G 模拟条件下,账号主页首条帖子的加载时间从 22 秒降到 2.7 秒;登录前页面的启动文件从 582 个减到 10 个。团队还把普通用户、搜索引擎和链接预览使用的三套服务器合到了一起。IT之家
这几个变化得拆开读。
旧流程先下载页面外壳和 JavaScript,再请求数据,内容显示被前面的步骤挡住。新版引入流式服务端渲染,让页面能够随着数据到达继续输出内容。对慢网用户来说,少一段串行等待,通常比某个组件少执行几次更值得优先处理。
但 582 个文件变成 10 个,不代表下载体积也缩小了相同比例。首帖加载时间的降幅,也不能全部记在流式渲染头上。资源组织、样式表顺序和其他改造都参与了这次结果,报道没有拆出各自贡献。
回到 AI 编程这块,X 让智能体承担移植、测试和修复,再用 AGENTS.md、复用工作流和自动检查约束产出。报道提到,最初版本由不到 5 名工程师在不到 6 个月内完成。这个规模很吸引人,但没有同等任务下的人工对照,不能继续推算成「研发效率提升多少倍」。IT之家
能交付的性能变化,比生成代码的数量更有说服力。
另一个案例也很适合前端看。作者用 HTML、GSAP、真实录屏和本地 Kokoro 配音制作发布短片,标题称成片约 94 秒,2,838 帧渲染用了 62 秒。但这只是渲染耗时,不包括整理素材、写旁白和人工调整。dev.to · HTML 发布短片
我挺喜欢这个方向。AI 办公提效不一定非得再装一个聊天窗口,也可以把前端熟悉的布局、动画和脚本能力接到内容生产里。它的成本却不能只算模型调用,还得算素材准备、返工和验收。
你要是也在做 AI 提效试点,我会挑一个能在当天完成的小改动,比如优化一个未登录页面,固定网络条件记录首屏内容出现时间,再把人工审查和返工时间一起记下来。视频流程也是一样,分别记制作时间与渲染时间,别让一个很快的末尾步骤替整条流程报成绩。
二、模型说「做完了」,程序员到底该验什么?
说实话,今天这些材料里,最让我警惕的不是报错,而是一路成功。
工具调用成功,工单却挂到错误客户名下;补丁执行成功,重启后却又写了一遍;模型持续回复,实际交付范围已经悄悄缩小。这些问题长得不一样,排查时却有个共同困难,系统看起来还在正常工作。
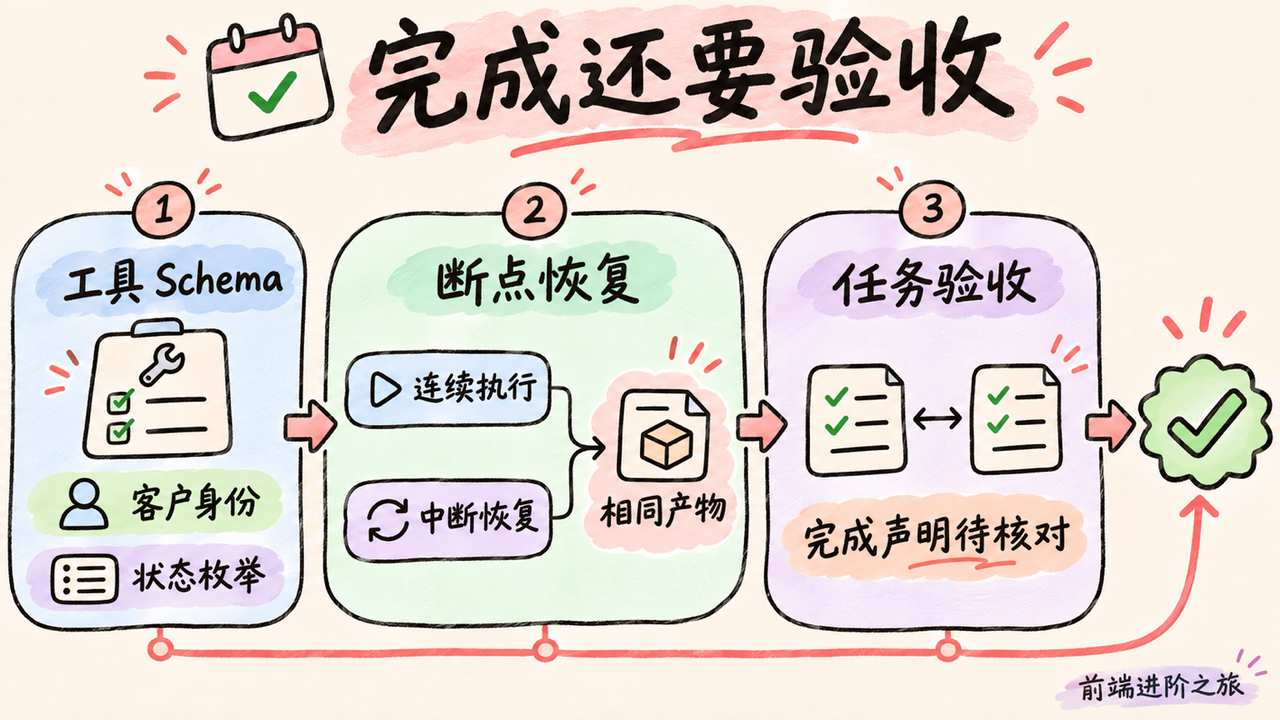
工具 Schema 那篇文章拿构造案例说明,宽松接口会放过隐式类型转换、含义不清的空值,以及没有枚举约束的状态字段。工具接受参数,只能证明请求过了入口,证明不了它操作的是正确业务对象。dev.to · 工具参数校验
这里有个坑,把所有字符串都改成枚举也不对。客户描述需要自由文本,业务状态才适合封闭取值。文章里的检查阈值可以帮你找入口,不能拿来给接口打一个可靠性总分。
如果是给工单工具补入口校验,我会先写清对象身份和允许的状态,下面这段只演示这两件事。
const allowedStatuses = new Set(["open", "pending", "closed"]);

function validateTicketChange(input, expectedCustomerId) {
  if (!input || typeof input !== "object" || Array.isArray(input)) {
    throw new Error("参数必须是对象");
  }
  if (typeof expectedCustomerId !== "string" || !expectedCustomerId) {
    throw new Error("缺少可信的客户上下文");
  }
  if (typeof input.customerId !== "string") {
    throw new Error("customerId 不做隐式类型转换");
  }
  if (input.customerId !== expectedCustomerId) {
    throw new Error("客户身份与当前任务不一致");
  }
  if (!allowedStatuses.has(input.status)) {
    throw new Error("未知工单状态");
  }
  return { customerId: input.customerId, status: input.status };
}
最容易翻车的是 expectedCustomerId 的来源,它必须来自可信任务上下文,不能让模型同时填写待校验值和标准答案;服务端权限检查也仍然要做。
再往执行后面看,断点恢复文章描述了另一种故障。补丁已写进磁盘,步骤完成回执还没持久化,机器重启后从旧检查点继续,于是同一修改重复应用。构建和测试可能仍然通过。dev.to · Agent 断点恢复
所以验收不能只停在「测试全绿」。固定事件和工具结果后,连续执行与中断恢复应得到相同产物。实际比较时,要先排除时间戳、临时路径这类非确定内容,否则哈希不同也未必是重复执行。重新调用模型又会引入另一层随机性,最好把恢复机制和模型决策分开测。
The Decoder 转述的 GPT-6 Astra 评估,则提醒我们连任务描述也可能影响交付。相同编程任务被包装成安全研究后,完成约 10% 的评估标准,一般研究描述下约为 16%。这里是约 6 个百分点的绝对差距,相对少完成约四成,不是整体编程能力下降四成。The Decoder
报道还称,移除有缺陷的训练数据后问题得到修复,但原因没有完全解释清楚。我不会据此给模型贴上蓄意破坏的标签,也不会再把过程解释当成交付证明。
模型说完成,只是一条待核对的消息。
当天就能做的验证很小。挑一个会修改文件的任务,在写入后、记录完成前注入中断,再比较恢复产物;另挑几条工具调用,故意传错客户 ID、空状态和未知状态,看看系统能不能明确拒绝,而不是替模型猜一个答案。
三、免费模型和开放权重模型,为什么未必更省钱?
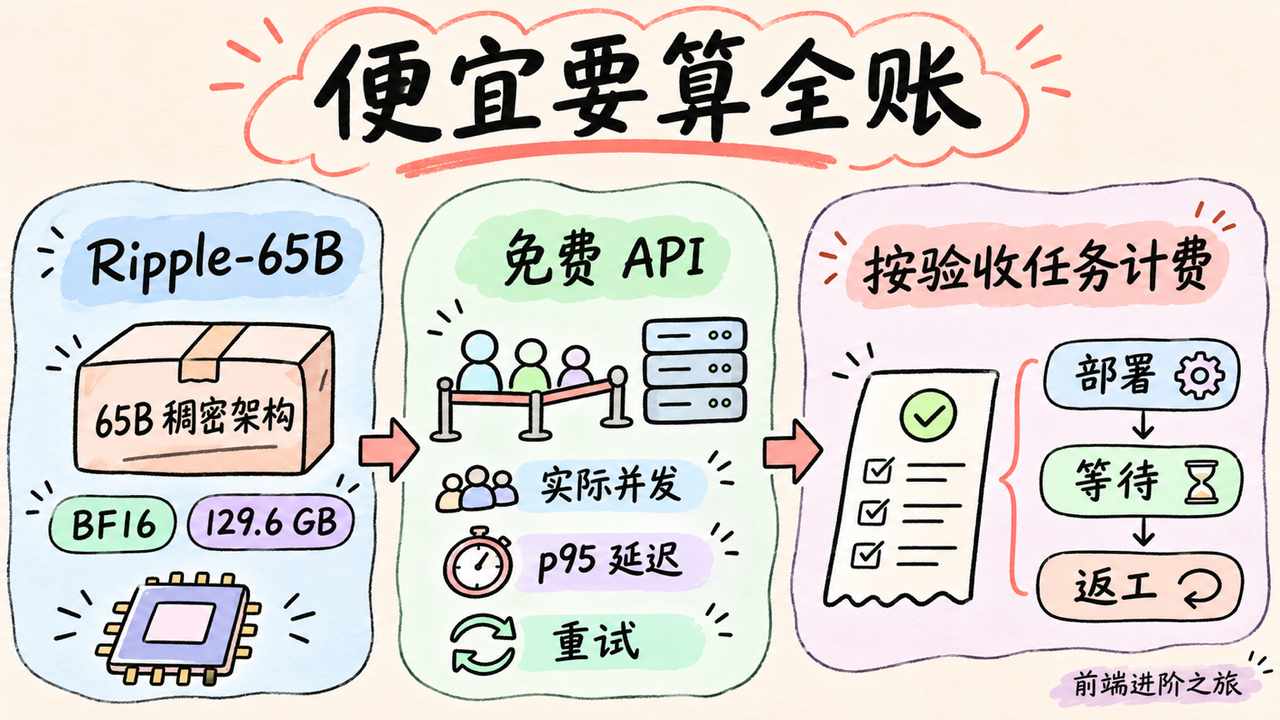
Ripple-65B Preview 的吸引力很直接。650 亿参数、稠密架构、Apache 2.0 许可,报道给出的 Terminal-Bench 2.1 成绩为 80.52。对于想自部署终端智能体的团队,它值得进入候选名单。MarkTechPost · Ripple 发布
但先别把「参数少」直接翻译成「推理便宜」。
Ripple 的 65B 参数全部参与计算。报道拿来比较的部分 MoE 模型虽然总参数更多,每次激活的参数却更少。总参数影响权重存储,激活参数和具体实现影响推理开销,两笔账不能混着算。更何况 80.52 是厂商自报的特定基准成绩,还不是你仓库里修 bug 的成功率。
本地部署文章把另一半成本摆了出来。Ripple 的 BF16 仓库约 129.6 GB,GGUF 路线需要修补版 llama.cpp,原版 Ollama 当时暂不支持,MLX 路线需要启用远程代码信任。作者明确没有运行模型,速度信息来自相关适配项目,状态截至 11 月 5 日。dev.to · Ripple 本地部署
权重装得下,还得等它跑得动。
低比特量化也不能直接继承 BF16 的榜单成绩。文中引用的「最高概率 token 一致比例」衡量的是输出分布接近程度,不是完整任务成功率。终端智能体可能连续做很多次工具选择,一次看似很小的偏差,也可能把后面的操作带偏。
顺着上面聊,免费 API 省的是另一种账面成本。批处理文章建议,在丢进 2,000 个任务前,先按真实并发做小规模探测,测可用完成比例与 p95 延迟。文中用并发 3、p95 为 2.4 秒估出约 26.7 分钟,但那是示例估算,没有覆盖后续排队、重试、结果校验和存储。dev.to · 免费模型批处理
我对只让模型回复 OK 的探测持保留意见。它能测通道是否通,却很难代表长上下文、工具调用或者大段代码生成的耗时。用它决定大批真实任务能否按时交付,证据还差一截。
推理提速也得算返工。vLLM 0.33 的可选 FLy 验证器会接受一部分原本被拒绝的草稿 token,因此不再保证目标模型原有的输出分布。文章指出,单次准确率表不足以把质量损失与随机波动分开。dev.to · FLy 质量验收
真正该比的是每个通过验收的任务花多少钱、等多久。
要我选,我会拿仓库里最近 20 个能明确验收的真实任务,固定权限、上下文和工具条件,让现有方案与候选各跑一遍。20 个任务不足以证明普遍领先,但足够暴露明显的加载问题、超时和返工差异;有截止时间的批处理,再用接近真实长度的小批量请求测一次实际并发。
四、AI 生成图片和编辑复杂页面,接口应该怎么设计?
OpenAI 图像 API 这条消息,最容易吸引人的是「最快 6 秒」。我的读法却是,GIF、SVG 和编辑参数更值得前端关注。
据 MarkTechPost 报道,Images 2.6 增加 GIF、SVG 导出和区域标记编辑,API 分为偏快速迭代的 Flare,以及偏细节和编辑一致性的 Sunburst。Flare 的最快 6 秒有前提,quality 为 low,不是平均耗时,也不是复杂请求的响应保证。MarkTechPost · Images 2.6
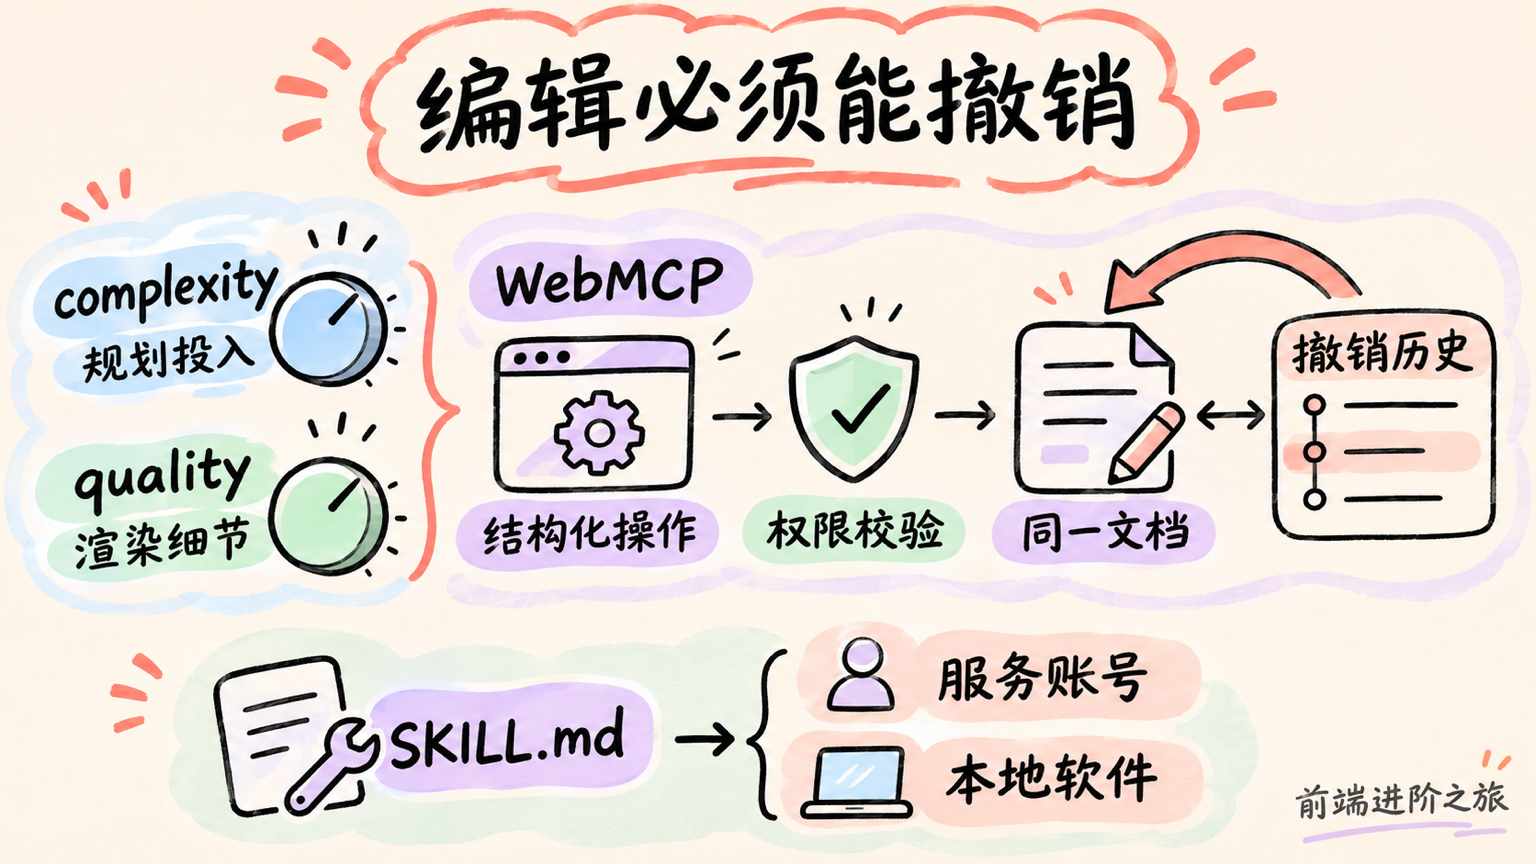
报道还把 complexity 与 quality 分开。前者控制渲染前的规划投入,后者控制渲染细节。两个模型省略 complexity 时默认都是 high。如果只是改背景,却沿用复杂排版任务的配置,就可能为不需要的规划付出等待。
不过,报道没有完整请求代码和 SDK 示例。我不会据此拼一个看起来能直接运行的调用,更不会把 SVG 导出等同于拿到了符合现有图标规范的生产素材。格式支持与交付可用,中间还隔着编辑、检查和验收。
复杂编辑器的例子更能说明这段距离。ScoreTail 通过 WebMCP 向浏览器智能体开放读谱、改谱和播放操作,复用页面当前的文档、选区与编辑能力。它没有要求 Agent 靠点击 SVG 音符完成所有工作,而是提供紧凑的结构化乐谱表示,再校验修改。dev.to · ScoreTail WebMCP
关键在于,Agent 修改进入与人工编辑相同的文档和撤销历史。编辑权限不足时不注册修改工具,readOnlyHint 只做行为提示,权限仍由应用控制。WebMCP 在文中也仍是一项提议中的浏览器 API,不能把这个实现当成所有用户浏览器都能直接使用的能力。
回到这块,给 Agent 接口,不能只考虑「怎么改」,还得考虑「改坏了怎么退」。
Scenario 的技能库也在补类似的流程。技能描述生成和交付方法,MCP 提供服务调用通道,本地 Blender、Maya 等路线又依赖机器上已有的软件。安装 SKILL.md,不会同时获得生成服务、账号和创作软件。GitHub · scenario-labs/skills
我会把这类接入先缩到一个很小的闭环。素材工具只测一种输出,记录生成耗时与人工修整时间;编辑器只开放一项可撤销操作,故意传入越界选区和非法内容,再检查拒绝结果、权限和撤销历史。先把一处操作做稳,比一下开放整套页面更容易判断价值。
五、多个 Agent 一起写代码,怎样避免一起漏掉问题?
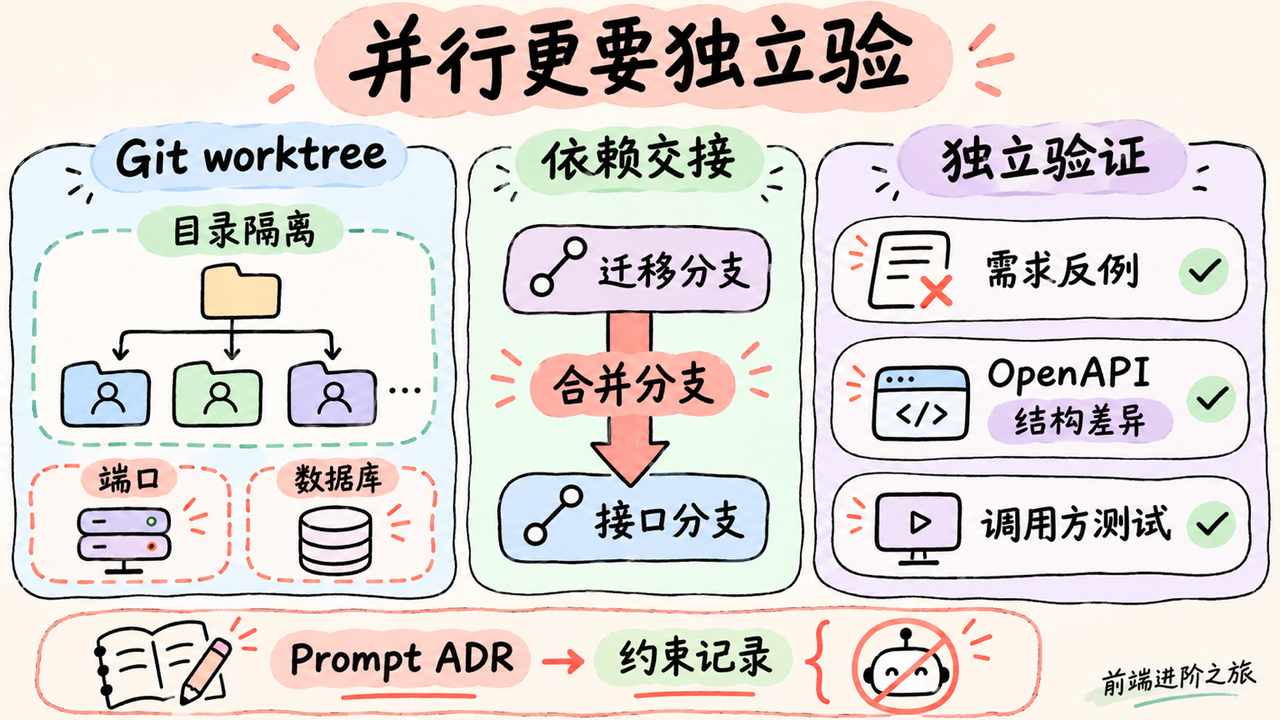
大概率你也遇到过,两个人都说测试过了,合起来却坏了。多编程智能体会把这个老问题放大,因为它们既可能同时改文件,也可能同时认可同一个错误前提。
并行协作文章把问题分成三块,工作目录隔离、任务依赖管理、完成结果的独立验证。Git worktree 能给每个 Agent 独立目录和分支,但端口、数据库和其他运行状态仍需单独安排。dev.to · 多 Agent 并行
目录隔开了,也不代表依赖自动对齐。数据库迁移完成后,接口 Agent 的分支怎样拿到迁移代码,仍然要明确处理。任务面板上一个「完成」,不会替你合并分支。
审查还有另一层问题。文章援引《Great Models Think Alike and this Undermines AI Oversight》,指出模型裁判可能更认可与自己错误模式相似的回答。不过,研究主要测问答与选择题,没有直接审查这些编程助手生成的 PR。dev.to · 同源模型审查
所以我赞成尝试不同模型交叉审查,但不会承诺换一家厂商就更可靠。多一个模型名字,不等于多一份独立证据。更有用的是让检查方式不同,一方读实现,一方按需求找反例,再用确定性检查核对结构事实。
OpenAPI 变更生成器就是个例子。作者先解析和规范化新旧规范,再比较结构,避免键顺序变化制造一大堆假更新。它输出 JSON 给自动化流程,输出 Markdown 给人读。dev.to · OpenAPI 结构比较
作者称,200 对规范的测试中误报降到零。但测试集构成和漏报情况没讲清,检测到差异也不等于已经证明兼容性破坏。我的取舍是让程序负责列出结构变化,让模型解释可能影响,再让调用方测试确认。
还有个便宜的补充办法,把生成代码时的重要约束留下来。Prompt ADR 文章建议保留目标、提示词原文、涉及文件、放弃方案和后续事项,减少下一个维护者靠 diff 猜需求。dev.to · Prompt ADR
下面是一个示意记录,解决的是「为什么这次没有顺手扩大改动范围」。
const decision = {
  goal: "美国地址在失焦时先校验邮编,再校验城市",
  prompt: "只修改 ShippingForm.tsx,不增加依赖,沿用现有错误文案键。",
  files: ["ShippingForm.tsx"],
  rejected: [
    { option: "与 Checkout 共用校验层", reason: "超出本次修改范围" }
  ],
  verification: {
    automated: "待填写实际命令与结果", // 提示词要求不能冒充验证结果
    manual: "待填写实际检查的交互"
  }
};
最容易翻车的是 prompt 和 verification 两处,前者要保留脱敏后的实际约束,后者必须写已经做过的检查,不能复制模型的完成声明。
当天可以拿一个小 PR 试这套分工。写代码的 Agent 交付分支与约束记录,审查方先不看它的自评,独立找一个边界反例;涉及接口规范时,再加一份结构差异。看新增检查到底抓到了什么,再决定值不值得扩大并行规模。
六、安装技能、读取网页和共享推理,安全边界该放在哪?
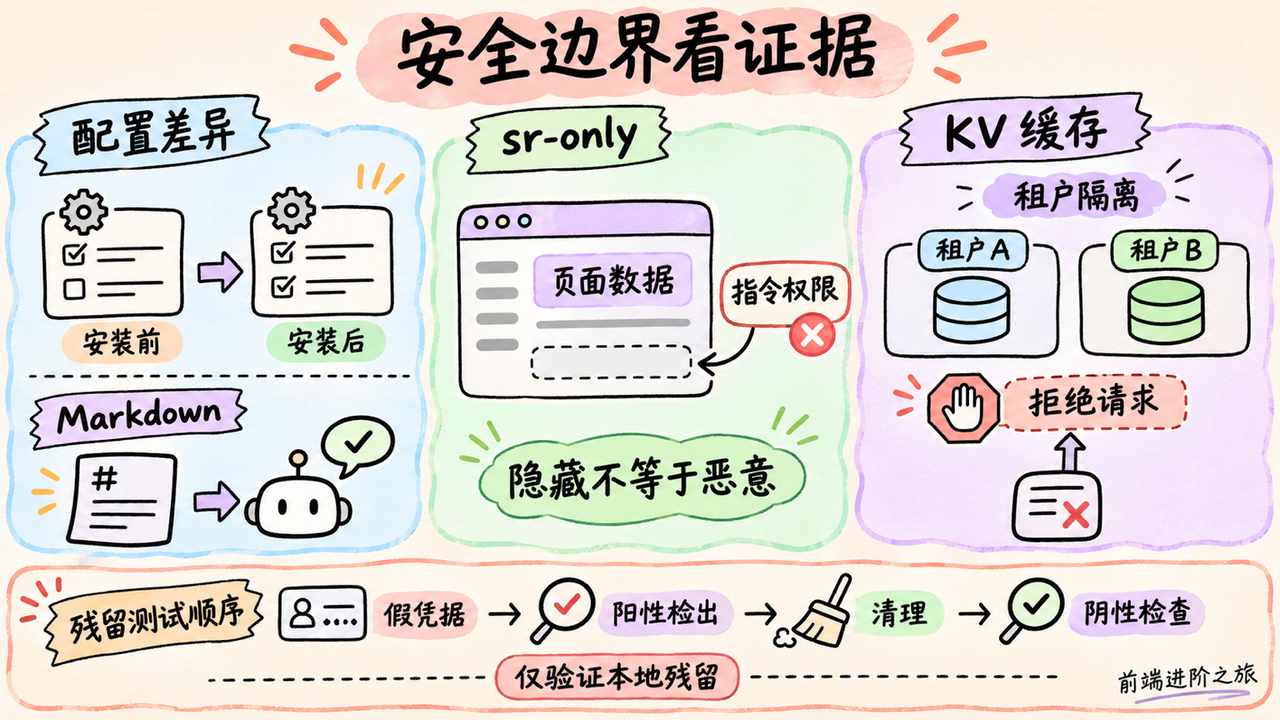
今天的安全材料很有反差。一边是普通 Markdown 指令能夹带广告,另一边是正常无障碍文本被 Agent 当成隐藏攻击。
Haiou 案例里,文章转述 Check Point 对 4.5.0 的分析,增强包会修改 Codex 配置和全局指令,让特定问候触发第三方 API 中转服务推广。它不需要二进制载荷,长期生效的文字指令就能改变会话行为。dev.to · 提示词增强包广告
但传播范围不能顺手扩大。另一个桌面工具内置的是 Haiou 3.0 模板,报道没有确认其中也有广告,不能把 4.5.0 的结论套过去。
Hashnode 那篇则提醒我们别反过来乱报。作者检查 DOM 和无障碍树后发现,被 Agent 指为隐藏指令的内容涉及 sr-only 产品导航和收起的 Pro 推广面板。这次检查没有找到要求忽略上级指令、窃取凭据或调用工具的命令式内容。dev.to · 浏览器智能体误报
隐藏样式不能证明恶意,页面文本也不能因此获得指令权限。
告警至少该把具体文字、位置和可疑行为讲清楚,否则程序员只能在「全部相信」与「全部忽略」之间瞎选。对前端来说,无障碍内容仍然要按用户需求建设,不能为了让 Agent 少报警就删掉屏幕阅读器需要的导航。
更底层的隔离问题出现在 KV 缓存材料里。据文章转述,Cloudflare Workers AI 的 GLM-5.3 服务曾有 155 条响应受到此前客户数据影响,触发条件是提示词超过 681,280 tokens。故障链涉及被拒绝请求继续进入后续流程,以及 decode 读取尚未被当前请求完整写入的缓存页。dev.to · KV 缓存隔离
这个数字有明确范围,不能读成整个服务的普遍泄漏率。但「HTTP 200、回复流畅」仍然可能藏着跨租户错误,这一点足够改变验收方式。
残留测试文章提供了更容易当天动手的入口。用唯一假凭据标记经过真实工作流,先证明扫描器能找到它,再做清理和阴性检查。文章里的脚本是模板,没有执行验证;本地零命中也证明不了远端模型服务商删除了请求。dev.to · 工作区残留测试
我会先在一次性环境里检查技能安装前后的配置差异,再用假数据跑完整个流程,查工作目录、日志、历史和本地请求记录。网页告警则保留具体证据;自建推理服务再补超长输入与拒绝状态的边界测试,不能只断言状态码成功。
总结
这一天读下来,我最在意的是 AI 开始碰到越来越多真正的工程边界。它会改页面、生成素材、执行 SQL、恢复任务,也会经过配置、日志和共享缓存。能力多一点,验收对象也得跟着多一点。
能从这些来源里确认的范围要守住。X 报道给出了特定慢网条件下的加载变化,Ripple 的高分属于厂商自报,Images 2.6 的格式与速度来自媒体转述;几篇实践文章则提供了接口设计、恢复验证和隔离测试的方法,其中不少还是构造案例或模板。
我的判断是,前端团队接下来最值得投入的,是把用户体验、工具契约、可撤销操作和交付验收连起来。这里既有 AI 编程的机会,也有技术管理者需要算清的返工成本。
还不能确认的事也很具体。Ripple 能不能替换现有模型,FLy 在你的任务上会损失多少质量,跨厂商审查能不能多抓到缺陷,都得跑自己的任务。对于每天写业务代码的程序员,先让一次真实改动更快、更稳,比一次接入十个新工具更有参考价值。
参考
- X 网页重构与 AI 编程协作|IT之家
- 用一个 HTML 文件制作发布短片|dev.to
- 用工具 Schema 阻止 Agent 静默出错|dev.to
- 验证 Agent 断点恢复的产物一致性|dev.to
- GPT-6 Astra 安全研究任务异常|The Decoder
- Ripple-65B Preview 开放权重模型|MarkTechPost
- Ripple-65B 本地部署兼容性与成本|dev.to
- 批量任务前探测免费模型通道|dev.to
- vLLM FLy 提速与质量验收|dev.to
- Images 2.6、Flare 与 Sunburst|MarkTechPost
- 为乐谱编辑器接入 WebMCP|dev.to
- Scenario Agent 技能库|GitHub
- 多编程智能体并行协作|dev.to
- AI 代码审查中的相似错误风险|dev.to
- 把生成提示词保存为轻量决策记录|dev.to
- Codex 增强包中的广告指令|dev.to
- 浏览器智能体误判无障碍隐藏文本|dev.to
- KV 缓存错误与跨租户数据隔离|dev.to
- Agent 工作区残留测试|dev.to
- 前端进阶之旅