单次 AI 代码审查从 2.43 美元降到 0.77 美元,耗时也从 4 分 9 秒缩到 1 分 32 秒,看起来很适合拿去汇报。但同一份案例里,降级后的性能审查员漏掉了更多问题。便宜了,代价也出现了。11 月 6 日这批消息里,模型参数、上下文和 Agent 能力都在往上走,真正难算的却是每次交付要花多少钱、凭什么验收。这篇沿着六条线聊,帮天天写代码的程序员挑出值得试的东西,也挡住几笔容易白花的钱。
一、AI 编程成本降了 68%,为什么还不能直接照着换模型?
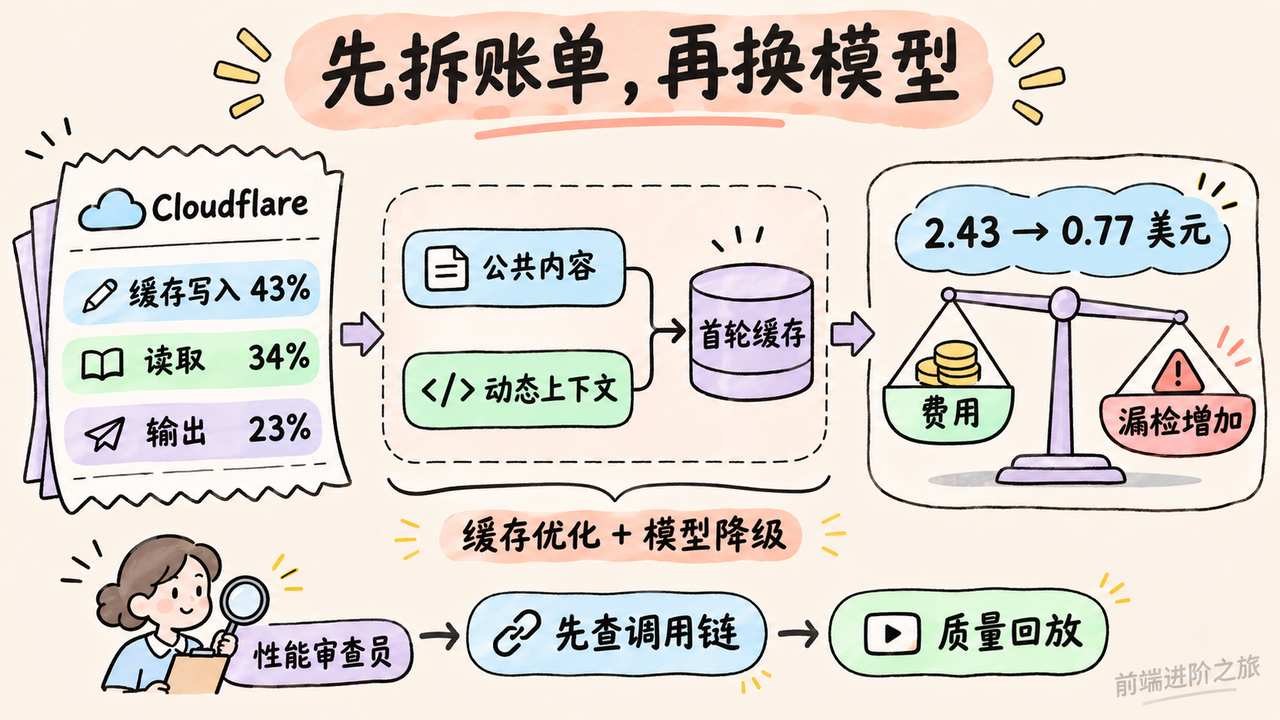
先说结论,我会先查调用链和缓存,再考虑换便宜模型。
Cloudflare 代码审查降本案例|dev.to里,一个完整审查会启动六个专项 Agent,分别负责代码质量、安全、性能等任务。问题不只出在模型单价上,每次审查的 token 从 4 月的 91 万增至 9 月的 299 万,超过三倍。
更反直觉的是,整体缓存命中率已经达到 97%,账单还在涨。
因为命中也要钱。优化前,缓存写入占支出的 43%,读取占 34%,输出只占 23%。如果团队只要求模型「回答短一点」,大部分费用根本没碰到。
他们后来把跨仓库稳定的 system 内容与日期、环境、仓库上下文分开,把缓存断点放到公共内容之后。首轮请求的命中率从 14%—26% 提高到 91%—99.5%。这比盯着全局平均命中率有用得多,新会话第一轮到底复用了什么,才是该拆开的账。
但缓存优化和模型降级,得分开评价。文章报告单次审查降至约 0.77 美元,同时也通过质量评估发现,降级后的性能审查员漏掉了更多有效问题。
省下来的钱,必须和漏掉的问题一起算。
另一个对照来自代码搜索子 Agent 实测|dev.to。作者在六个固定 commit 的开源仓库上,围绕 12 道代码定位题运行了 288 次。各条件下,标准答案项的召回率都在 97%—100%,差异不到两个百分点;强制使用同模型子 Agent,费用却增加 74%—221%,耗时约为原来的两到三倍。
这里的边界很清楚,它测的是只读代码定位,不能推成「多 Agent 没用」。复杂实现、独立复核、不同上下文之间的隔离,都没被这组题覆盖。但普通搜索已经能直接找到答案时,多开一个同模型 Agent,确实可能只增加上下文和调度费用。
回到这块,做 AI 编程平台或者 AI 办公提效工具,我会把一次任务拆成首轮缓存写入、后续读取、模型调用次数和最终验收结果。当天就能先抽十次真实任务,把最贵的调用找出来,再删冗余步骤;涉及模型降级,则用原来能发现的问题回放,别只看平均账单变漂亮。
二、百万上下文和开放权重,能让团队马上换掉现有模型吗?
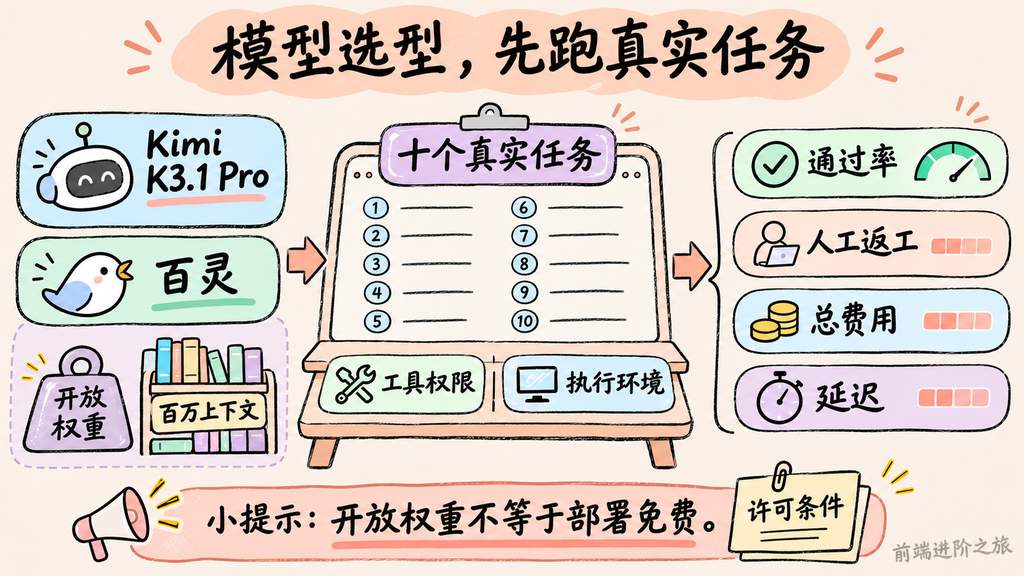
说实话,这批模型新闻最容易让人误判的地方,是把「能装多少」当成「能做多好」。
Kimi K3.1 Pro 部署清单|dev.to称,模型已开放约 1.56TB 权重,总参数 2.8 万亿,每个 token 激活约 1040 亿参数,支持约百万 token 上下文。开放权重当然增加了选择,可这个体积也把选择条件写出来了。
它需要认真算集群。
MoE 每次只调用部分专家,减少的是单步参与计算的参数量,完整权重的存储和部署负担仍在。文章列出的显存估算还没展开完整运行配置,上下文缓存、并发、框架开销都得另算。另一篇Kimi 权重与许可分析|dev.to还提醒,采用的是自有许可,不能把「无需申请即可下载」直接读成所有用途都没有限制。
Inkling 2 Small 则展示了另一种数字陷阱。Latent Space 的报道把 594B 总参数、17B 激活参数和 68 小时训练放到一起。拆开看,68 小时对应在 GB300 上完成的主预训练阶段,使用 8.4T tokens;标题里的约 12T 来自社区解读,可能包含其他阶段,后训练还进行了九天。
没有 GPU 数量和完整算力预算,68 小时不能单独证明便宜。
接入侧也有新选择。百灵 Ling-3.2-flash|IT之家支持图像、文本和视频输入,提供百万上下文,API 兼容 OpenAI 和 Anthropic 协议。报道说前两周免费,这对已有工具链试接很方便。官方披露的三项视觉基准高于 Claude Opus 5,也给截图还原、文档理解提供了试用理由。
不过,截图像不像,和组件能不能维护,是两份验收。
我的读法是,这几条消息把候选名单拉长了,替换结论还得自己做。尤其 Kimi 的两篇材料列出了不同的 Terminal-Bench 成绩,测试配置和口径没有在这里对齐,不能挑高的那个直接放进选型表。
真要判断换不换,我会拿最近十个有明确验收条件的任务,覆盖组件修复、Node 接口改动和跨文件排障,固定工具权限与执行环境。记录通过率、人工返工时间、总费用和延迟,一天内先跑完小样本,足够淘汰明显不合适的候选。
三、Cursor 能直接给在线链接,内部工具上线还缺哪一步?
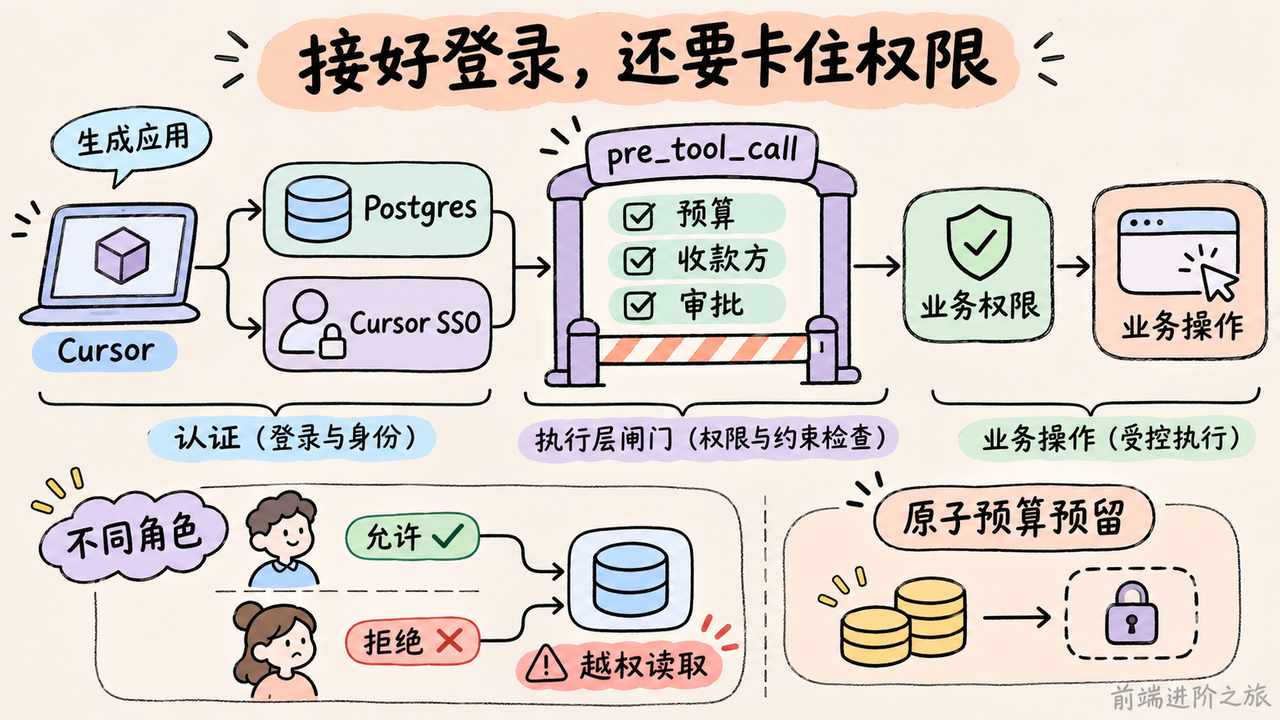
数据库、登录、托管都有人接起来,确实比只生成一个页面更接近交付。
Cursor 应用构建工作流|dev.to介绍,用户明确向 cloud agent 发起应用构建后,Agent 可以编写代码,按需创建 Postgres,通过 Cursor SSO 配置认证,并准备托管环境。正式上线仍需经过安全检查,由用户主动发布。
对内部报名表、查询面板、轻量审批工具,这条路径很有吸引力。过去页面写完,交付才走了一半,后面还要找地方存数据、接登录、配环境。现在这些步骤被串进同一个流程。
这里有个坑,生成器帮你接好了认证,不代表它已经理解了业务权限。
原文提到,发布检查会关注写进文件的 secrets、暴露凭据等问题,管理员也能管理应用、添加审查规则、下线应用。但一个页面即使没有泄露密钥,也可能把其他部门的业务数据展示给不该看到的人。
同样的权限问题,在SpendWarden 支付风控实践|dev.to里更直接。作者把支付检查放在 pre_tool_call 钩子里,由普通代码判断预算、收款方和审批条件。提示词负责表达目标,执行层决定这笔钱能不能出去。
预算不能只存在于对话里。
下面这个简化的 JavaScript 检查器,只演示调用前如何拒绝不合规参数,适合拿来讨论规则该落在哪层。
function checkPayment(payment, policy, spentToday) {
  const { amountCents, recipient } = payment;

  if (!Number.isSafeInteger(amountCents) || amountCents <= 0) {
    return { action: 'block', reason: '金额无效' };
  }
  if (!policy.recipients.includes(recipient)) {
    return { action: 'block', reason: '收款方未获授权' };
  }
  if (amountCents > policy.perCallCents) {
    return { action: 'block', reason: '超过单次限额' };
  }
  if (spentToday + amountCents > policy.dailyCents) {
    return { action: 'block', reason: '超过每日预算' };
  }
  // 审批门槛不能覆盖前面的硬限制。
  return {
    action: amountCents >= policy.approvalCents ? 'review' : 'allow'
  };
}
最容易翻车的是 spentToday + amountCents,两个并发调用可能同时通过检查;真实支付还需要原子预算预留、幂等记录,以及绑定最终收款参数,这几行代码没有解决它们。
顺着上面聊,仓库指令文件提示注入分析|dev.to提醒,AGENTS.md、CLAUDE.md、README 甚至依赖输出,都可能夹带诱导指令。隐藏字符扫描能帮忙找异常,却不能识别所有用正常文字写出的恶意要求。
所以我会支持用这类平台先做内部原型,同时把权限验收放进演示里。当天准备两个不同角色的账号,检查同一条数据能否越权读取,再放入一个无真实权限的假凭据,观察发布检查是否能拦住;只展示页面能打开,还不足以交付。
四、模型更会找漏洞了,为什么安全 Agent 反而要收紧权限?
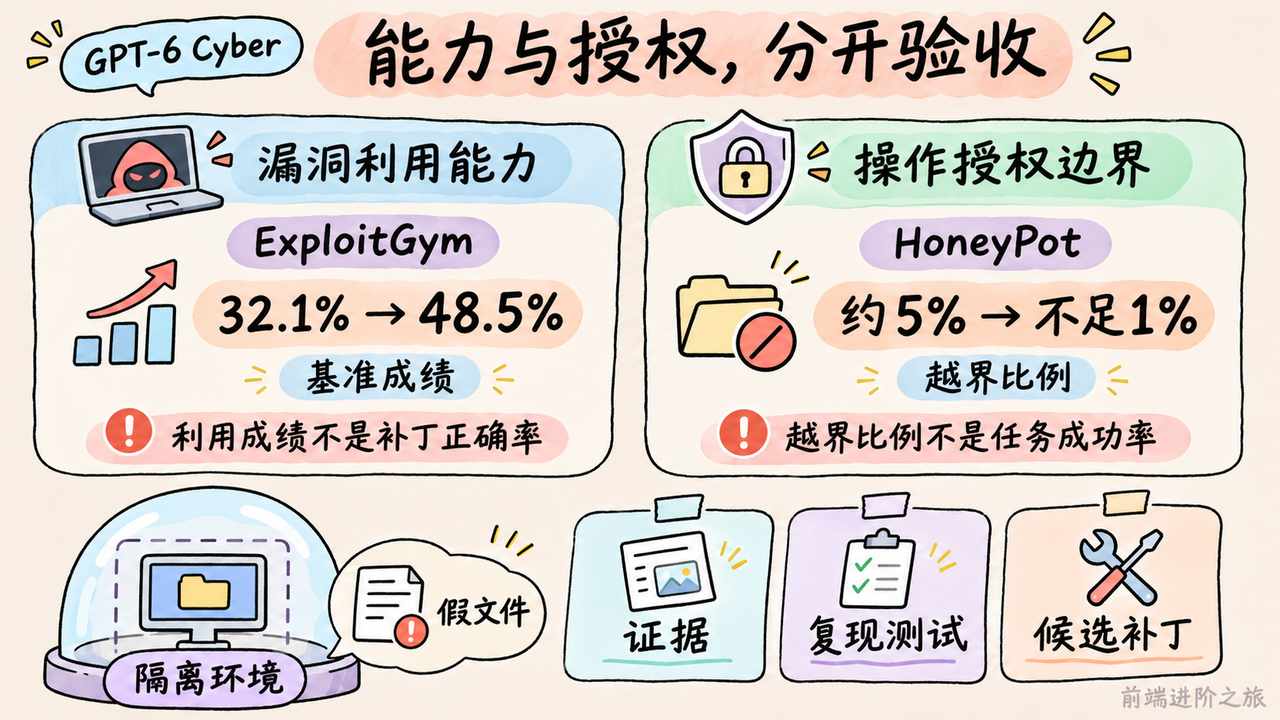
GPT-6 Cyber 这条新闻值得看,但得把「攻击能力」和「遵守授权」分成两张表。
据GPT-6 Cyber 报道|IT之家,模型在 ExploitGym 上从前代的 32.1% 提高到 48.5%,相差 16.4 个百分点,相对增幅约 51%。这个基准主要测能否利用指定远程漏洞,不能直接换算成代码审查效率提升 51%,更不能换算成补丁正确率。
另一组结果更贴近维护工作。报道援引 OpenAI 的说法称,模型在 Firefox 中发现了 81 个此前未知的高危漏洞,并提交证据、复现测试和候选补丁。Linux 内核研究中的 1,724 个漏洞复现、948 个可用利用程序,则属于另一种结果,不能全部写成新发现漏洞。
我更在意报告里有没有可复现证据。维护者拿到一句「这里可能不安全」,和拿到能触发问题的测试,处理成本完全不同。只是候选补丁还得审,开始发布修复也不等于所有报告都已处理完。
The Verge 对操作边界的报道补上了另一面。在 OpenAI 公布的 ExploitGym HoneyPot 测试里,越界比例由前代约 5% 降到不足 1%。它测的是模型是否为了完成任务采取授权范围外的行动,不能读成整体任务成功率超过 99%。
能力更强,权限仍然要卡住。
报道同时提到,该模型的网络安全风险等级升至 Critical,初期只向获批的 Daybreak Red 客户开放。这个分级描述潜在攻击能力,不是产品通过了某种安全认证。更能利用漏洞与特定测试里更少越界,可以同时发生。
对普通前端、全栈团队,现在最实际的动作未必是申请更强模型,而是查清已有 Agent 能碰到什么。网页内容、仓库文件和日志里出现一句指令,是否就能让它读取敏感配置、访问外部地址?
当天可以在隔离环境里放一个无害的越权诱导,要求 Agent 读取预先禁止访问的假文件,检查拒绝行为和执行日志。这个测试只能覆盖一种越界路径,却能帮团队确认权限限制到底由系统执行,还是只靠模型自觉。
五、AI 说测试全绿,你怎么确认它真的修好了?
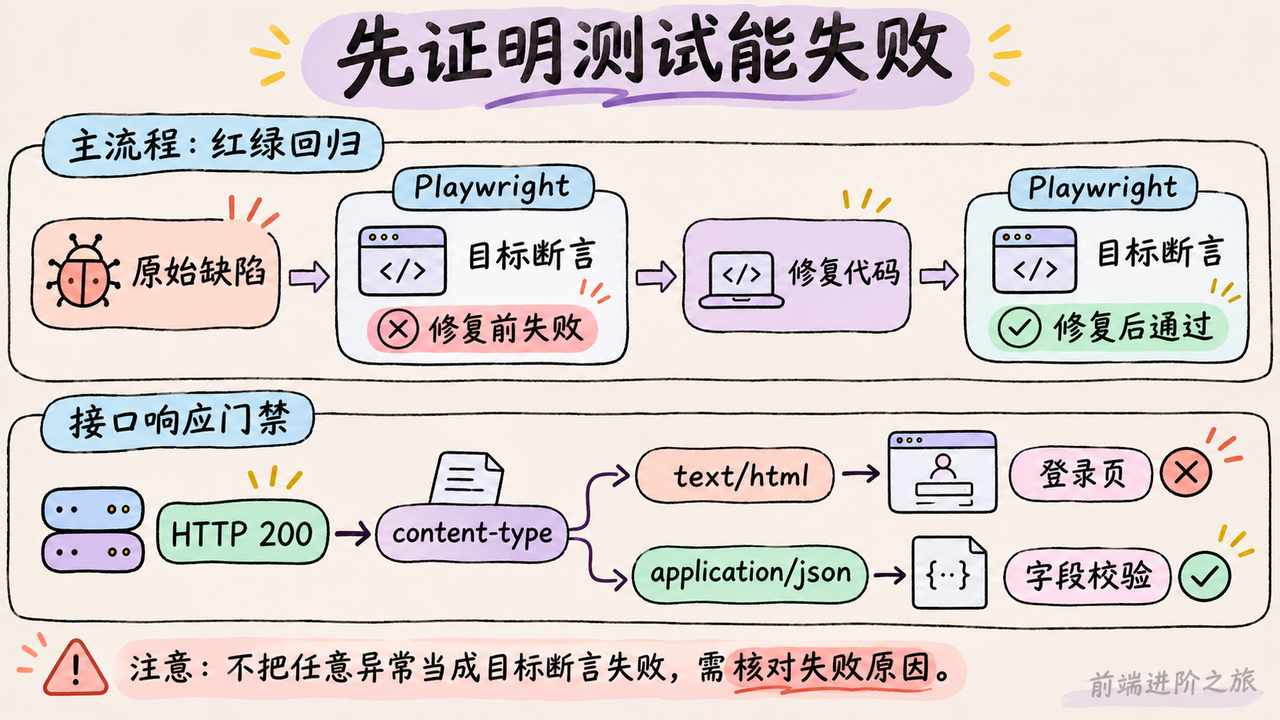
大概率你也遇到过,Agent 改完代码,交付说明比代码还长,最后附上几条手工验证步骤。看着认真,下一次回归却未必有人会重新点一遍。
Playwright 回归断言实践|dev.to给的要求更实在,为本次 UI 修复补一条可执行断言,并展示修复前失败、修复后通过。断言围绕用户能观察到的结果,复用仓库现有 helper、fixture 和定位方式,跟修复放在同一个 PR。
只有绿色结果,证明不了测试碰到了原来的缺陷。
这个问题在重构前验证行为测试|dev.to里也出现了。文章建议从真实任务采集输入输出,固定当前行为,再故意改坏金额、边界条件等位置,观察测试能否报错。
要分清,记录旧行为不代表认可旧业务逻辑,旧实现可能本来就有 bug。探针触发失败,也只证明测试能抓住这项变化。但它至少能排除一种尴尬,测试一直绿,只因为断言根本不敏感。
接口层的例子更具体。AI 生成模拟交易机器人复盘|dev.to发现,旧客户端收到 429 和 Retry-After: 3,约 0.5 秒后就重试,还会把登录页面当 JSON 解析。作者只用了公开 demo 数据,没有提交订单,不能把这次运行描述成真实交易验证。
下面用一个可控响应,先检查客户端会不会把登录页误当业务数据。
async function readJson(response) {
  if (!response.ok) {
    throw new Error(`HTTP ${response.status}`);
  }
  const type = response.headers.get('content-type') ?? '';
  const mime = type.split(';')[0].trim().toLowerCase();

  // 请求成功不代表拿到了预期的数据类型。
  if (mime !== 'application/json' && !mime.endsWith('+json')) {
    throw new Error('接口返回了非 JSON 内容');
  }
  return response.json();
}

const loginPage = new Response('<html>请登录</html>', {
  status: 200,
  headers: { 'content-type': 'text/html' }
});

await readJson(loginPage); // 应在类型检查处失败。
最容易漏的是最后一行之后的验收,真正接入测试时,要断言失败原因确实来自类型检查,不能把任意异常都算通过;JSON 解析成功后,业务字段仍需单独校验。
再往前一步,Microsoft Research 的 PDD Kit尝试把意图转换为 Verus 规格,证明代码对所有输入满足相应约束。演示是约 5,000 行 Rust 的全栈商城,展示了登录逻辑的形式化验证,不能扩写成整个商城已经验证完毕。
我喜欢它追问的那句话,「只有密码正确才能拿到 token」,有没有同时要求符合条件时能够登录?只约束错误放行,拒绝所有人也可能满足单向条件。
回到前端日常,不必为了一个表单搬来整套证明工具。当天就挑一个正在修的 bug,补一条针对原始错误的回归断言,分别在修复前后运行,并确认失败来自目标断言;这比再添一页手工验收文案更有价值。
六、前端截图还原和数据抽取,为什么不能拿聊天榜单选模型?
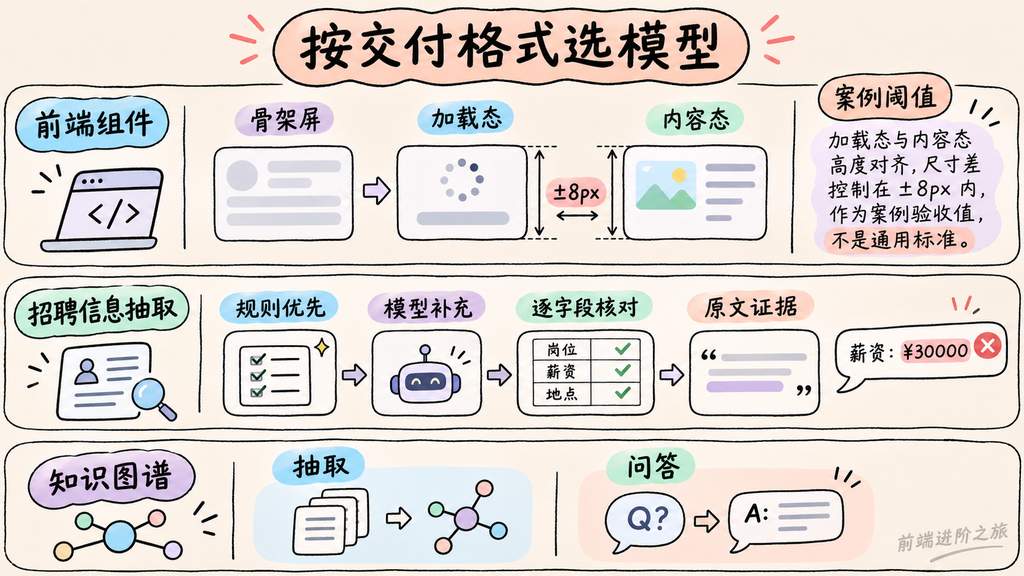
你要是也在做截图生成页面、文档抽取或知识库,模型选型最好从交付格式开始。
百灵的视觉成绩给了前端开发者试用理由,但骨架屏这件小事就能说明,视觉效果不错,仍可能漏掉工程约束。骨架屏尺寸验收实践|dev.to建议直接提供真实组件或 Storybook 示例,要求加载态沿用内容态的布局结构、padding 和 gap,并在指定视口下控制外部高度误差。
文中采用的是 ±8px,这只是作者选的验收条件,不是通用行业标准。页面内容高度不固定时,还要继续说明图片比例、标题行数和响应式断点,否则模型只能猜。
比「做得精致一点」管用。
抽取任务也一样。招聘信息小模型项目|dev.to采用规则优先、模型补充的流程,规则没有找到薪资时才调用模型。其底座总参数约十亿,每 token 激活约四亿,不能把它写成总共四亿参数。
作者报告,在 100 条留出岗位测试中,学生模型与对照的 27B 模型逐字段得分均为 0.926。这只能说明特定样本和评分方式下结果接近。模型返回的 271 个薪资金额里,还有 8 个不在原文中,薪资周期也可能配错。
我的取舍是,边界明确、量又大的抽取任务,值得先看小模型。前提是评估字段错误会造成什么后果,不能只追一个总分。
22 款本地模型知识图谱评测|dev.to进一步把抽取与问答拆开,分别检查格式、实体、关系、证据引用和回答边界。问答部分固定参考图谱与上下文,有助于比较回答模型,却没有覆盖「每个模型使用自己建出的图谱」的完整链路。
这点对 AI 办公提效产品尤其关键。文档抽错了,回答再流畅也可能只是在认真解释错误数据。
当天不妨拿一个真实组件,同时比较加载态与内容态在移动端、桌面端的高度;做抽取则拿二十条包含缺失字段、歧义金额和干扰文本的材料,逐字段核对原文。先找到模型具体在哪一步失手,再决定是换模型、改输入,还是补确定性校验。
总结
11 月 6 日这批消息里,已经有具体流程和测试数字可看。Cursor 把应用构建延伸到认证与托管,Cloudflare 案例展示了缓存和调用链的降本空间,PDD Kit 给出了意图、规格与证明衔接的演示。各家模型的参数、上下文和跑分,则需要继续带着报道来源与测试口径读。
我的判断是,AI 编程接下来的竞争会更多落在交付验收上。谁能把失败路径测出来,把权限卡在执行层,把账单算到一次合格交付,谁才更容易获得稳定收益。
还没被这些报道证明的,是换一个新模型能给你的仓库省多少时间、百万上下文能否减少返工,以及更高的安全分数能否转化成可靠补丁。程序员不缺候选工具,缺的是同一套条件下能重复比较的结果。
我会先保住验收标准,再让模型去比。
参考
- Cloudflare 如何降低 AI 推理成本|dev.to
- 代码搜索子 Agent 成本与召回实测|dev.to
- Kimi K3.1 Pro 自托管检查清单|dev.to
- Kimi K3.1 Pro 开放权重与许可|dev.to
- Inkling 2 Small 训练与评测|Latent Space
- 百灵 Ling-3.2-flash 发布|IT之家
- Cursor 应用生成与托管工作流|dev.to
- Agent 支付工具层风控|dev.to
- 仓库指令文件提示注入风险|dev.to
- GPT-6 Cyber 漏洞验证与修复|IT之家
- GPT-6 Cyber 操作边界测试|The Verge
- 让 UI 修复附带 Playwright 断言|dev.to
- 重构前先证明行为测试能失败|dev.to
- AI 生成模拟交易机器人的 HTTP 故障复盘|dev.to
- 用 PDD Kit 验证 Agent 编写的全栈应用|Microsoft Research
- 让骨架屏匹配真实内容高度|dev.to
- 招聘信息抽取小模型实践|dev.to
- 22 款本地模型知识图谱评测|dev.to
- 前端进阶之旅