
8.0
热点
AI SCORE
技术实践2026-10-14 02:30
长任务 Agent 如何保存和恢复工作状态
dev.to · AI#Agent#记忆架构#上下文管理
Editor brief · 编辑速览
文章讨论长期运行的 Agent 如何跨会话保留任务状态与关键决策,避免重复调查和重走失败路径。指出完整对话回放增加 token 开销,摘要也可能遗漏细节或保留过时假设。
想象一下,一个 coding Agent 在周一开始迁移某个服务。它发现一个不兼容的依赖,记录了替代方案,然后暂停任务,准备第二天继续。到了周二,Agent 恢复运行时却完全忘了之前的决定,又做了一遍调查,还再次尝试最初的迁移路径。
问题不在于模型的推理能力,而在于系统没有保存并恢复继续执行任务所需的信息。设计合理的 LLM 记忆架构,可以解决这类故障:把 Agent 记忆当作一项需要系统设计的工程问题,而不是事后补上的功能。
上下文窗口容量有限,会话结束后,对话上下文也会消失。重放完整的对话记录会增加 token 消耗,还会引入无关噪声。摘要虽然能压缩内容,却可能遗漏重要细节,或保留已经过时的假设。对话历史记录了发生过什么,但无法可靠地确定任务当前处于什么状态。
记忆应该保留有用的连续性,而不是保存 Agent 接触过的每一个 token。设计时需要回答三个问题:Agent 应该记住什么,把这些信息存在哪里,以及如何决定检索哪些内容?
这三个概念彼此相关,但不能混为一谈。混淆它们,会导致系统丢失关键的任务进度,或者用无关历史塞满上下文窗口。
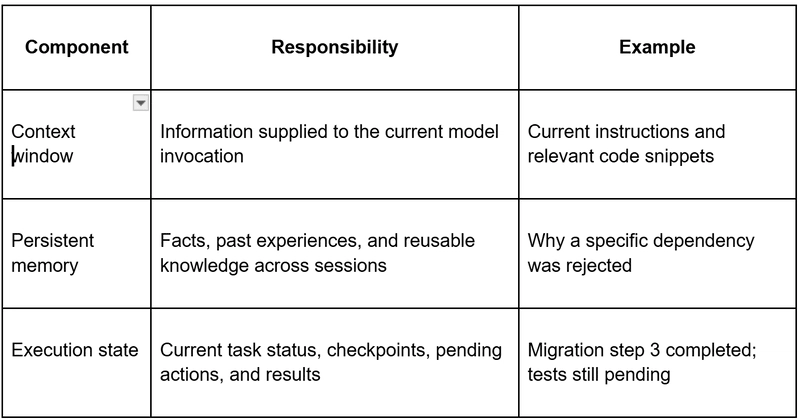
在实际设计中,这种区分意味着:
摘要可能只会说“尝试过部署”。执行记录则必须明确说明:部署成功了、失败了,还是结果尚未确认。Agent 重启时,这个区别至关重要。
理解记忆时,最好把它看成一组逻辑职责,而不是要求每种记忆都部署一个独立数据库。每种记忆的预期用途,应该决定具体的实现方式。
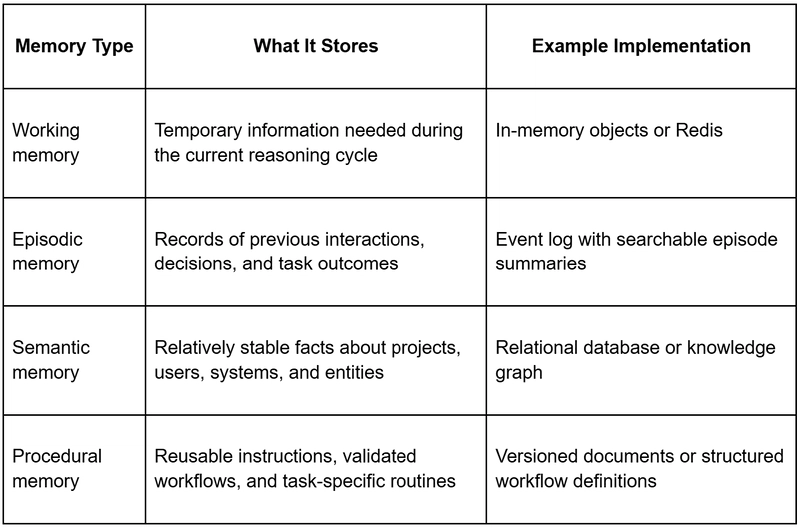
工作记忆针对即时访问进行优化,丢失后通常可以重建。它保存的是 Agent 在单次执行周期内进行推理所用的临时工作区。
情景记忆保留历史证据,帮助 Agent 从先前的运行中学习。比如,coding Agent 上周遇到过 staging 环境缺少 secret 的问题,这段经历就可以在类似故障发生时,作为上下文被检索出来。
语义记忆支持事实查询,例如某个 endpoint 属于哪个服务,或者哪个团队负责某个 repository。这些事实变化不频繁,适合保存在结构化、可查询的存储中。
程序性记忆描述的是如何执行任务,而不只是记录任务曾经发生过。经过验证的部署检查清单,或经过测试的回滚流程,都属于这一类。
一个基于 PostgreSQL 的系统,就可以同时存储结构化事实、任务事件和工作流定义,再用向量索引对选定记录提供语义检索。向量数据库是一种检索机制,并不天然就是所有事实的权威来源。
每种记忆的存储设计,都应该由查询形式、一致性要求、更新频率、持久性、访问控制和保留需求来决定。
并不是模型生成的每句话,都值得成为持久化知识。写入流水线通过五个阶段,将原始交互转化为可靠的记忆:
下面是一个已存储记忆记录的示例结构:
{
  "memory_id": "mem_1042",
  "type": "episodic",
  "entity_id": "project_42",
  "content": "Migration failed because the staging secret was missing.",
  "source_event_id": "event_884",
  "created_at": "2026-10-12T10:30:00Z",
  "confidence": 0.92
}
source_event_id 将记忆关联到提取它时所依据的证据,便于后续审计或纠正。confidence 表示提取系统的评估结果,并不能证明这条陈述一定属实。生产环境的设计还需要包含租户范围、有效期、版本管理、保留规则和纠正状态。
关键的工程决策包括:对延迟敏感的场景采用异步提取;同步持久化关键状态转换;让写入操作具备幂等性,避免重试后产生重复记录;始终保留来源引用,让提取出的记忆可以追溯。
检索流水线决定了存储的信息如何在推理时送达模型。在任何严肃的 AI Agent 编排框架中,记忆都是通过这条流水线,才从“被保存的信息”变成“有用的信息”。
New request or scheduled task
              ↓
Resolve identity and active task
              ↓
Fetch authoritative execution state
              ↓
Retrieve candidate memories
              ↓
Filter, rank, and deduplicate
            ↓
Apply freshness and access policies
             ↓
Fit results to the context budget
             ↓
LLM reasoning and tool execution
每个阶段都需要有意识地做出设计选择:
一个关键区别是:如果任务依赖当前部署状态或账户余额,就应该查询权威记录系统。历史记忆可以解释之前发生过什么,但绝不能覆盖事实来源提供的当前状态。
当记忆持续保存数周或数月时,就会出现短期对话历史从未遇到的问题。
如果现实世界的变化快于记忆更新,事实过时就不可避免。为每条记录附上时间戳和来源信息。对于环境配置、团队分工等频繁变化的信息,应用过期规则或重新验证规则。
当多个来源或会话生成相互矛盾的记录时,就会出现事实冲突。根据来源权威性、版本和时间先后,定义优先级规则。不要自动认定模型最新生成的陈述就是正确的。
随着已完成的历史事件和低价值细节不断堆积,记忆会逐渐膨胀。对已完成的任务序列生成摘要,归档细粒度细节,并保留指向原始事件的链接,以便需要时仍能访问完整历史。
纠正和删除操作必须同步到主存储、缓存和搜索索引。明确规定如何将已删除或已被替代的记录排除在检索结果之外,避免 Agent 再次呈现已经明确撤回的信息。
摘要必然会丢失信息。如果未来的调试、审计或验证可能需要精确细节,就应该保留原始证据。
记忆是一个需要持续维护的信息系统,而不是一组只能追加、可以无限期信任的事实。
持久化记忆只有与可靠的执行保障机制和访问控制结合起来,才能改善 Agent 的任务连续性。缺少这些措施,记忆就会成为过时状态错误、未授权数据访问和重复副作用的入口。
生产环境的检查清单应该包括:
来看一个具体的故障场景:worker 重启后,Agent 应该先检查已持久化的任务状态和外部工具记录的执行结果,再决定是否重试部署。如果结果未知,就应该核实并协调该操作的状态,而不是盲目重复执行。一个因为忘记上次尝试而再次发起支付的 Agent,造成的不是记忆问题,而是生产事故。
围绕真实的跨会话工作流构建评估套件,而不是只做孤立的检索基准测试。真正重要的指标,应该衡量记忆是否改善了任务结果:
测试时,应包含预先植入的事实、相互矛盾的更新、会话之间的长时间间隔,以及被中断的工作流。将任务结果与不使用持久化记忆的基线进行比较。
优化目标应该是正确完成任务,而不只是快速完成相似度搜索。
可靠的 LLM 记忆架构,会将当前上下文、持久化知识、过去的经历、可复用流程和当前执行状态划分为不同职责,并为它们配备合适的存储与检索策略。
从能够满足工作负载的最小设计开始:持久化任务记录、带有明确来源的结构化记忆,以及有针对性的检索。只有当评估证明能带来可衡量的收益时,再引入向量搜索、专门的存储层,或更复杂的冲突协调机制。对于构建生产级 Agent 系统的团队,与经验丰富的 AI Agent 开发服务团队合作,可以帮助他们在记忆债务积累之前,把架构设计好。
目标不是让 Agent 记住一切,而是帮助它在正确的时间,凭借正确的信息,继续正确的工作。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。