
9.0
重磅
AI SCORE
模型发布2026-10-14 02:00
谷歌旗舰 Argon 开放全球 API 接入
The Decoder#谷歌#Gemini#模型选型
Editor brief · 编辑速览
Google 将 Gemini 4 Argon 面向全球上线,支持 API、Gemini 应用及 Antigravity,定价具有竞争力。独立基准表现落后于 Claude Opus 5.5 和 Muse Wonder Full;谷歌内部称其将部分编程任务从数月缩短至数周。
Google 正在全球推出 Gemini 4 Argon,从今天起,开发者、企业和普通用户都可以使用这款全新的旗舰 AI 模型。
据 Google 介绍,用户可以通过 AI Studio 和 Gemini 平台中的 API 访问 Gemini 4 Argon。Google AI Ultra 订阅用户可以在 Google Antigravity 中使用该模型,AI Ultra 和 Pro 订阅用户则可以通过 Gemini app 和 Google Search 的 AI mode 使用。
不过,并非所有用户都能享受到同样的待遇。在新的模型分级体系下,Gemini 免费用户和付费 Plus 订阅用户现在只能使用能力较弱的 Flash 模型。Argon 取代了 Gemini Pro 系列,成为 Google 新的前沿模型系列。Google 表示,后续还会推出更多 Gemini 4 模型,这很可能意味着更新后的 Flash 版本,最终也会逐步向免费用户和 Plus 用户开放。据报道,Google 内部已经在测试一个代号为“Carbon”的潜在后继模型,据称它的表现将超过 Argon,尤其是在编程方面。
定价和 benchmark 结果与此前报道一致:初期优惠价为每百万 input tokens 2 美元、每百万 output tokens 10 美元,缓存输入享受 95% 的折扣。Argon 在 Vals Index 上排名第一,但在独立综合排名中,仍落后于 Anthropic 的 Claude Opus 5.5。而且,由于 Google 等了大约两周才正式推出模型,Argon 现在也落后于昨天刚发布的 Meta Muse Wonder Full。
*Google 并未明确给出缓存输入的具体价格,但表示其价格比常规 input token 价格低 95%。
Google 的 benchmark 结果。| 图片:Google
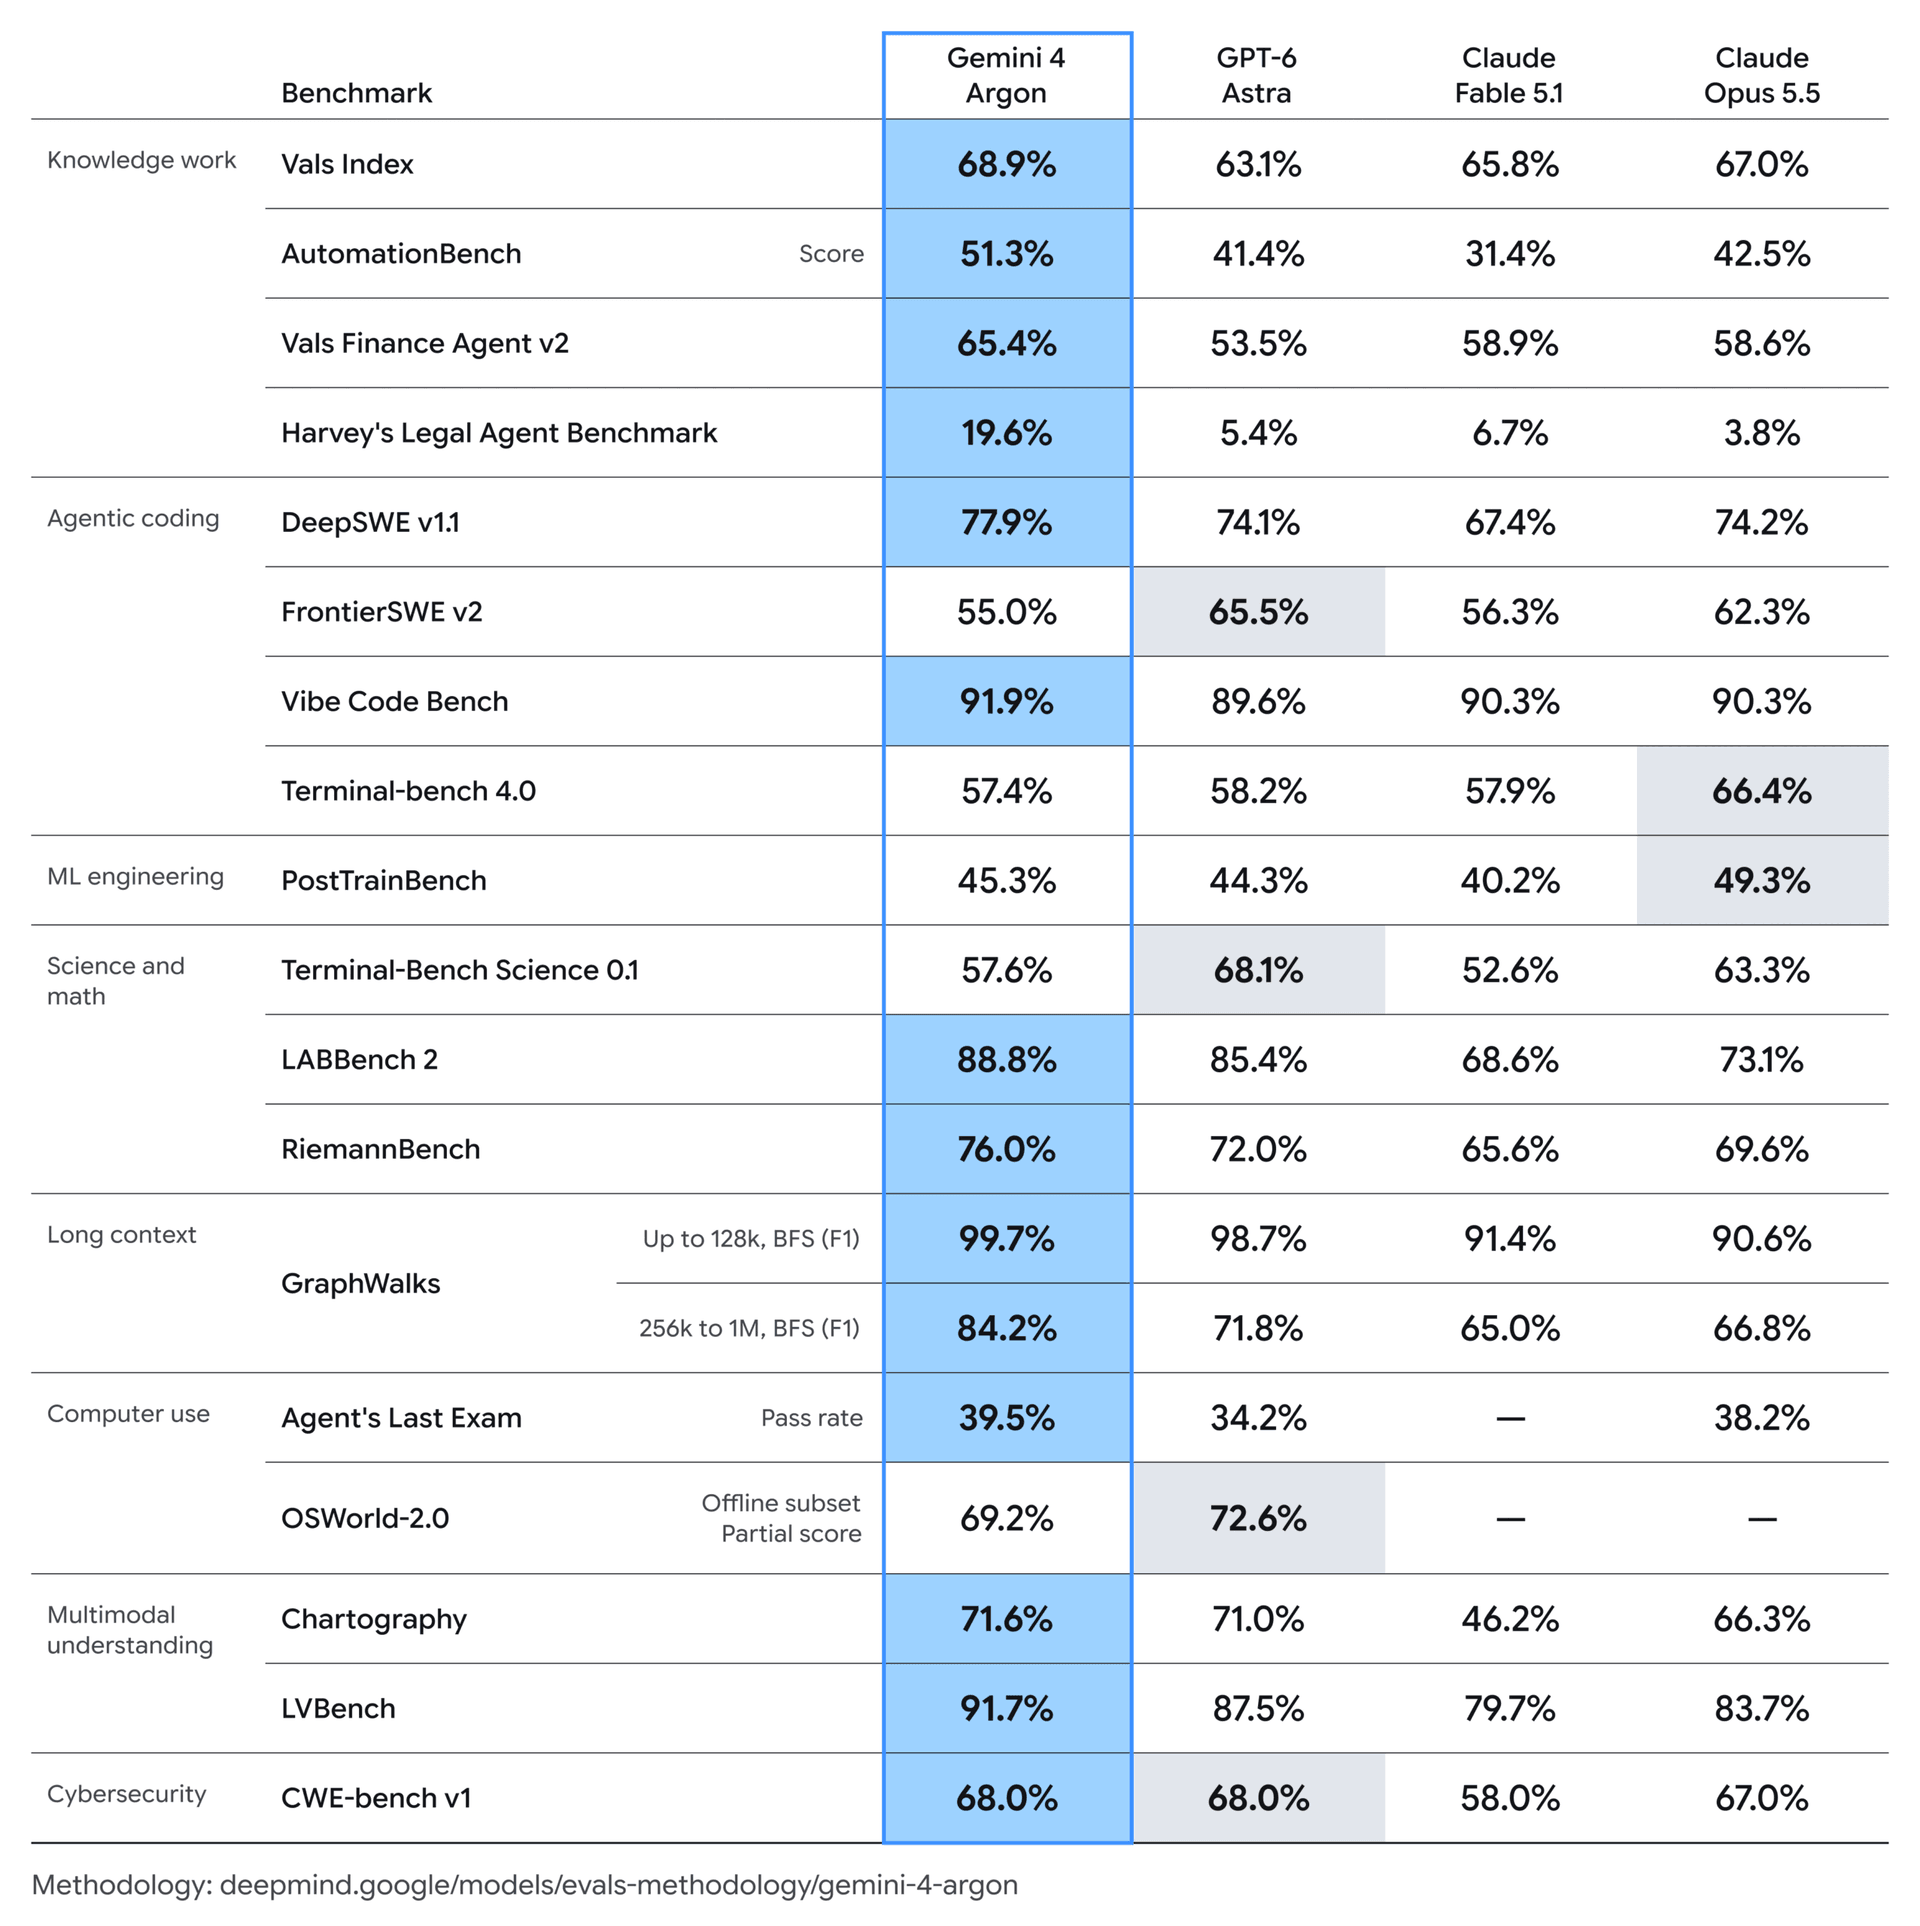
Google 在发布时分享了一些内部数据,不过这些数据均由公司自行报告。Google 表示,使用 Argon 的软件工程师,通过 Agent 提交的代码量增加了超过 35%,而代码回滚减少了近三分之一。
在 Chromium 项目中,Argon 帮助 Chrome 团队完成了一次架构重构,涉及这个拥有 4000 万行代码的代码库中的数百个文件。原本需要数月的工作,几周就完成了。对用户来说,这意味着网页可以在标签页、侧边栏和悬浮窗口之间移动,无须重新加载。
在使用 Google 的开源 Agent Development Kit 时,Argon 自主运行了一整夜,找到了多项优化,使会话准备时间缩短了 40%,冷导入速度提高了 21%。在 A100 上通过 vLLM 运行开放的 Gemma 模型时,推理速度提升至原来的 2.85 倍,从约每秒 37,900 tokens 增加到超过每秒 108,000 tokens。这些改动可以在上游的 pull requests 中查看。
Argon 还可以用纯代码生成复杂的 3D 模型、游戏和动画,并直接在浏览器中运行。其中一个演示展示了完全用 Python 编写、没有使用任何外部库的光线追踪引擎。Google 已经公布了源代码。
在下方演示中,Argon 从 Antigravity 中的一张图片出发,通过 MCP 控制 Blender,在自主循环中完成任务。Google 表示,它建模了哥特式建筑,并设置了随音频变化的灯光,最终生成了一个完整的 3D 场景。
3D 仍然是 Meta Muse 模型的薄弱环节。Meta AI 负责人 Alexandr Wang 表示,这些模型并未针对 3D 演示游戏进行专门训练。
Google 还将向 10,000 名研究人员免费提供 Google Antigravity 最高使用额度档位,为期六个月。名额会根据申请资格、容量和筛选结果陆续发放。目前申请已经开放。
网络安全防御人员可以单独申请 Fairwind 计划,该计划允许他们访问不设网络安全防护限制的 Argon。Google 计划将该计划扩展至数百家新增合作伙伴。
在安全方面,Google 称 Argon 的架构是其迄今最强的。在生物领域的外部红队测试中,被绕过的安全检查不到测试总数的 1%;在一组对抗性测试中,违规情况较早期 Gemini 模型减少了近一半。
在 Agent 对齐方面,试图未经授权走捷径的比例降至 2%。一个自动化的失对齐监测器会实时分析 Agent 的推理和行动。
Argon 在 Gray Swan Indirect Prompt Injection benchmark 中也取得了最低的攻击成功率:经过 15 次自适应尝试,攻击成功率仅为 0.7%。在此前的 Gray Swan 测试中,GPT-6 Astra 的攻击成功率为 8.5%,Claude Opus 5 为 4.8%。不过,Google 的说明并未明确这些测试是否完全相同。更多安全细节可以在 model card 中查看。
订阅 THE DECODER,即可享受无广告阅读、每周 AI newsletter、每年六期独家“AI Radar”前沿报告、完整历史内容访问权限,以及评论区访问权限。