
8.0
热点
AI SCORE
技术实践2026-10-14 02:35
128GB 苹果芯片 Mac 的 oMLX 部署调优
dev.to · AI#本地推理#苹果芯片#模型部署
Editor brief · 编辑速览
教程介绍 oMLX 在 M5 Max 128GB 上的安装与配置,其提供连续批处理、内存与 SSD 两级 KV 缓存,以及兼容 OpenAI 和 Anthropic 的 API。文中讨论用 3.5 位 KV 缓存量化支持聊天、Agent 和 IDE 并行使用。
oMLX 是基于 MLX 构建的 LLM 推理服务器。MLX 是 Apple 于 2023 年 12 月为 Apple Silicon 推出的框架。oMLX 在此基础上增加了连续批处理、两级 KV 缓存(RAM + SSD),以及兼容 OpenAI 和 Anthropic 的 API。
在配备 128 GB 统一内存的 Mac M5 Max 上,借助 KV 缓存的 TurboQuant 3.5 位量化,你可以同时驻留三到四个大型模型,足以并行支持聊天、智能体和 IDE。本指南汇总了 2026 年 5 月测试过的配置,帮助你充分发挥这套组合的性能。
应该使用哪个版本的 oMLX,如何安装?使用 0.6.4 版(2026 年 8 月 29 日发布,采用 Apache 2.0 许可证)。最直接的方式是从 GitHub Releases 下载 .dmg,打开后将应用拖入 Applications。也可以通过 brew tap jundot/omlx https://github.com/jundot/omlx 和 brew install jundot/omlx/omlx 安装。
首次访问 http://localhost:8000/admin 面板时,系统会提示输入 API 密钥。完整的 Homebrew 安装流程,包括自动启动的服务,见《使用 Homebrew 安装、更新和卸载 oMLX》。
128 GB 内存适合使用什么 TurboQuant 设置?3.5 位。vLLM 于 2026 年 5 月 11 日发布的独立分析表明,3.5 位量化可以达到全精度的质量,同时将 KV 缓存的内存占用降至约四分之一。在 M5 Max 上,这让 128k 上下文从“远超可用 RAM”变成了“可以与其他已加载模型一起放进内存”。
使用 0.6.4 的高级设置能提速多少?2026 年 9 月 15 日通过 API 测得,代码生成速度提升至 1.19–1.88 倍,在上下文包含 15,000 个 token 时提升至 1.07–1.47 倍。提升最大的是在 Qwen3.8-27B oQ4e 上启用 Lightning MTP,速度从 21.1 tok/s 提高到 39.7 tok/s;这要求模型构建版本保留 MTP 头。详情见高级设置部分。
128 GB 内存可以同时加载哪些模型?
主模型:unsloth/Qwen3.6-35B-A3B-MLX-8bit(37.7 GB,MoE,每次激活 3B 参数)。快速辅助模型:Qwen3-14B-Instruct-mlx-4bit(8 GB)。视觉模型:Qwen2.5-VL-32B-mlx-4bit(18 GB)。
嵌入模型:BGE-M3-mlx(1.2 GB)。重排序模型:ModernBERT-base-mlx(150 MB)。总计约 65 GB,仍有充足余量。
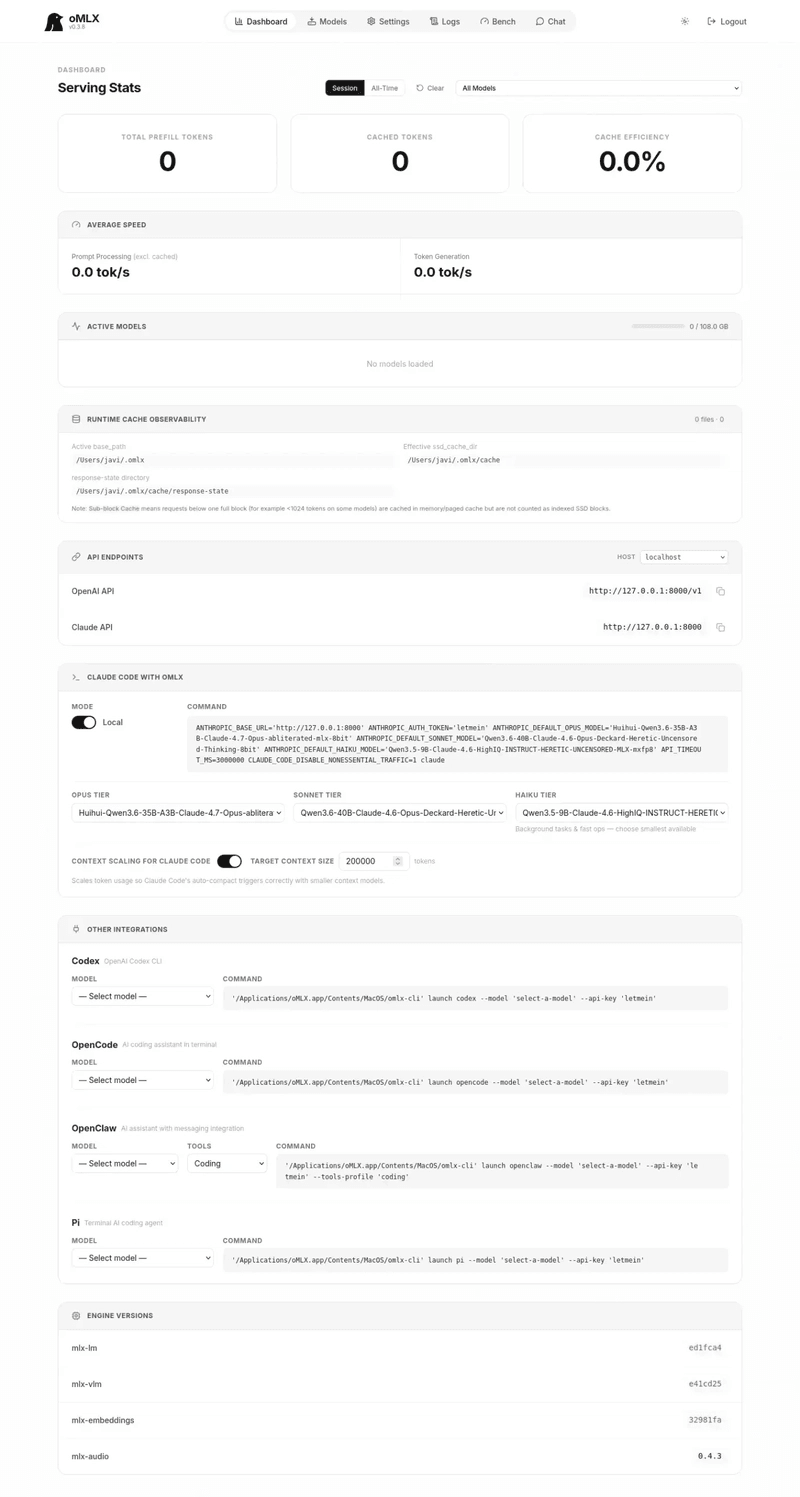
如何让 Claude Code 连接本地端点?从 0.5.0 开始,最简便的方式是运行 omlx launch claude,它会替你导出所需变量。手动配置时,需要设置 export ANTHROPIC_BASE_URL=http://127.0.0.1:8000、ANTHROPIC_AUTH_TOKEN=<your_api_key>,以及三个 ANTHROPIC_DEFAULT_*_MODEL 变量(Opus/Sonnet/Haiku)。
使用 claude --bare 启动,可以将系统提示词缩减到约 1,795 个 token。控制面板中的“Claude Code with oMLX”部分会替你拼好完整命令。
这能替代 Claude Opus 4.7 吗?不能完全替代。Claude Code 针对 Claude 的工具调用格式做了优化;如果端点背后接入的是非 Claude 模型,智能体循环的可靠性会下降。它适合离线工作、处理不应离开 Mac 的敏感数据,或在 api.anthropic.com 对你限流时作为备用方案。
最简单的安装方式:从 GitHub Releases 下载 .dmg,打开后将应用拖入 Applications。服务器会在后台启动,并在菜单栏显示图标。
也可以通过 Homebrew 安装:
brew tap jundot/omlx https://github.com/jundot/omlx
brew install jundot/omlx/omlx
omlx start
omlx serve --model-dir ~/models
首次访问 http://localhost:8000/admin 时,系统会提示输入 API 密钥。oMLX 默认未设置 API 密钥(字段为空),用于本地测试没有问题。如果实例仅监听 127.0.0.1,这样是安全的;一旦将它开放到局域网,或准备共享端点,就应进入 Settings → Auth & Info,设置一个足够长的随机字符串。该设置支持同时配置多个密钥。
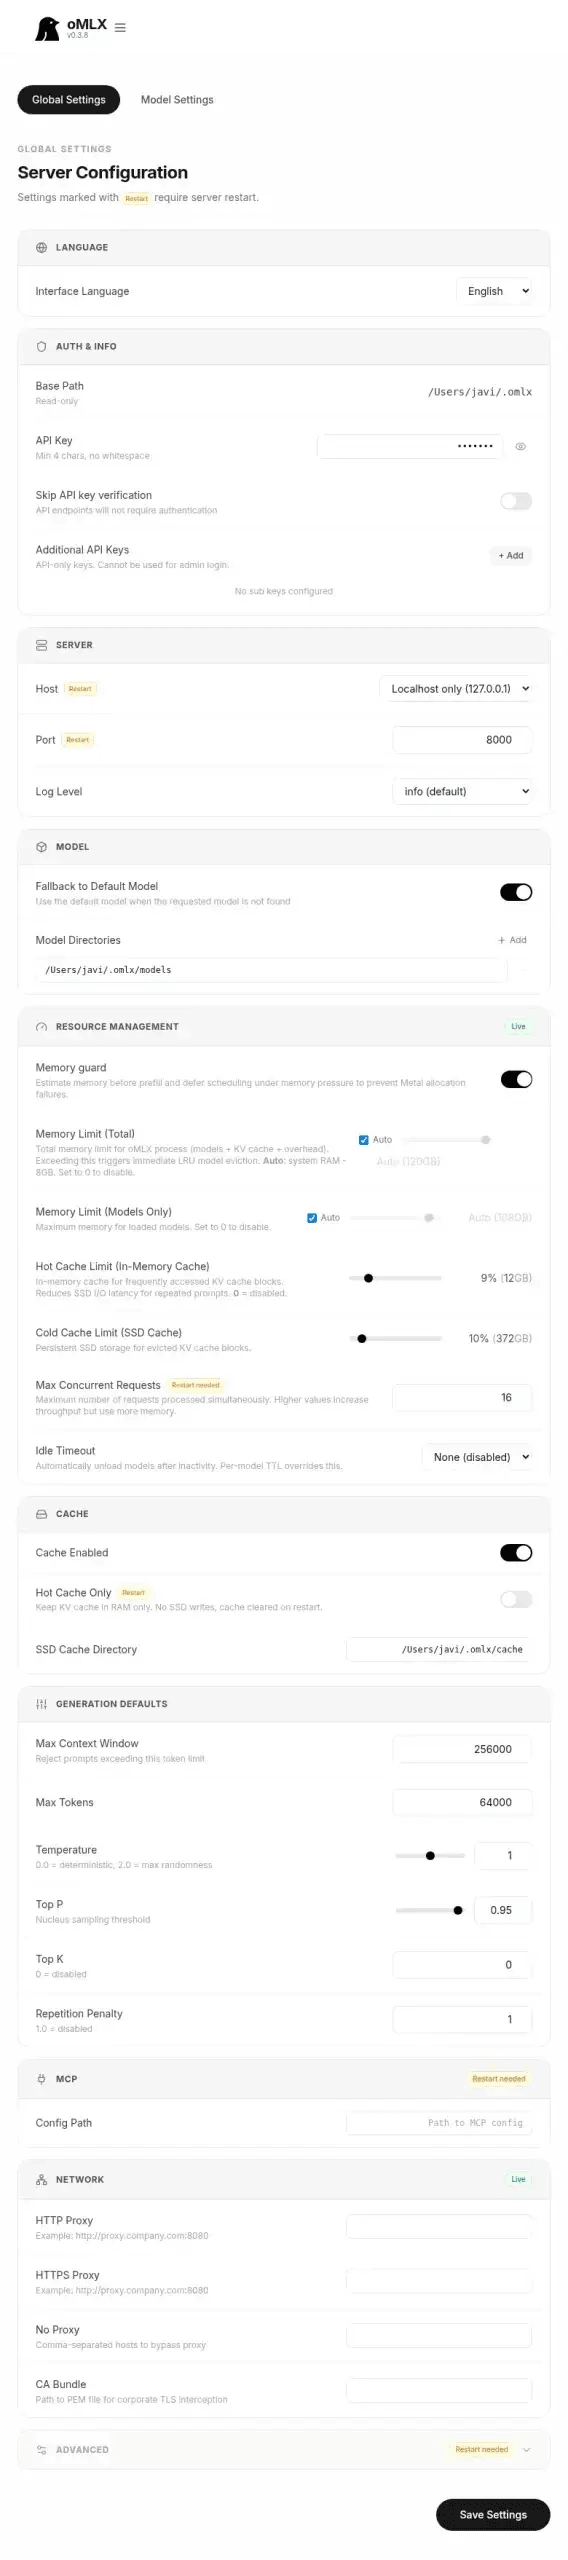
128 GB 内存的服务器设置
Settings → Global Settings 包含完整的服务器配置。对于 128 GB 内存的机器,以下设置最关键:
Server → Host:Localhost only (127.0.0.1)。如果要开放到局域网,先配置好有效的身份验证。
Server → Port:默认为 8000。
Resource Management → Memory Limit (Total):Auto。oMLX 会扣除 macOS 预留的内存;在 128 GB 的机器上,最终约有 110–114 GB 可用于推理。
Resource Management → Memory Limit (Models Only):Auto。为激活值、KV 缓存和辅助进程保留一定比例的内存。
Resource Management → Hot Cache Limit:10%。这是位于 RAM 层的中间 KV 缓存。在支持 TurboQuant 的模型上启用它之后(见下文),实际使用这套配置的人通常会将 128 GB 机器上的这个值设为 10%。如果关闭 TurboQuant 且只加载一个模型,可以将其设为 Off,但这样就无法继续获得缓存带来的收益。
Resource Management → Cold Cache Limit (SSD Cache):10%。为冷 token 提供约 80 GB 的 SSD 缓存空间,同时避免占满 SSD。
Resource Management → Max Concurrent Requests:16。对于同时运行一个智能体、一个聊天会话,并由 IDE 发起请求的单个用户来说,这个值很宽裕。如果与小团队共享,可以提高到 32。
Resource Management → Idle Timeout:None。让模型保持加载状态;首个 token 会在远低于一秒的时间内返回,无需等待数秒。
Generation Defaults → Max Context Window:将全局默认值设为 256000。Qwen3.6 系列在长上下文下表现稳定,配合 TurboQuant,有效内存容量足以真正用上这么长的上下文。你可以在 Model Settings 中为每个模型设置更低的上限。
Generation Defaults → Max Tokens:64000。这是每次响应的上限。只有计划一次生成整本书时,才有必要设得更高。
Generation Defaults → Temperature:通用场景设为 1.0,代码模型设为 0.2–0.5。
Model Settings → Experimental Features → TurboQuant KV Cache:在大型稠密模型上启用 3.5 位量化。vLLM 于 2026 年 5 月 11 日发布的针对 Google TurboQuant 的独立研究表明,3.5 位量化可以达到全精度的质量,同时将 KV 缓存的内存占用降至约四分之一。在 M5 Max 上,这让一些使用 FP16 时无法容纳 128k 上下文的模型能够容纳它。在 0.6.4 中,这项功能不能与 VLM MTP 同时启用,而且在这些测试中,它并未提高生成速度;如果你追求的是速度,请参阅高级设置部分。
多 LLM 模型组合
128 GB 内存足以同时加载一个大型主模型、一个快速辅助模型、一个 VLM、一个嵌入模型和一个重排序模型。在 Models → Downloader 中粘贴 Hugging Face 仓库 URL,即可下载这些模型。
截至 2026 年 5 月,这套推荐来自实际在 M5 Max 上通过 oMLX 运行 Claude Code 的用户(来源见 Diego R. Baquero 的 gist):Unsloth 的 Qwen 3.6 35B-A3B 系列采用 MoE 架构,每个 token 约激活 3B 参数。在 128 GB 内存上,8 位版本可以轻松容纳:
主模型(聊天 + 代码 + 推理):unsloth/Qwen3.6-35B-A3B-MLX-8bit(约 37.7 GB)。35B 参数的 MoE,每次激活 3B 参数。它是全能型模型,适用于长对话、代码和智能体。在 128 GB 内存上,它可以与其他所有模型同时驻留,空间仍然宽裕。
压缩程度更高的替代方案:unsloth/Qwen3.6-35B-A3B-UD-MLX-4bit(约 21.6 GB),适合希望同时加载两个主模型的情况。相比 8 位版本,质量略有下降,但能留出更多空间进行尝试。
稠密推理模型(当 MoE 力有不逮时):Mistral-Large-2-123B-Instruct-mlx-4bit(约 70 GB)或 Llama-3.3-70B-Instruct-mlx-4bit(约 40 GB)。适用于需要单次完成深度推理、稠密架构优于激活参数量较小的 MoE 的场景。
快速辅助模型:Qwen3-14B-Instruct-mlx-4bit(约 8 GB)。用于智能体中的低成本任务、解析和摘要。
视觉模型:Qwen2.5-VL-32B-Instruct-mlx-4bit(约 18 GB),涵盖 OCR、图像描述和多模态推理。
嵌入模型:BGE-M3-mlx(约 1.2 GB),在一个模型中集成稠密、稀疏和多向量表示。
重排序模型:ModernBERT-base-mlx(约 150 MB),为一套完善的 RAG 流水线补上重排序环节。
以 Qwen3.6 35B-A3B 8 位版本为主模型,同时加载 14B 辅助模型、VL-32B、嵌入模型和重排序模型,总占用约为 65–70 GB,运行起来很宽裕。再加上用于稠密推理的 Mistral Large 2 123B,名义总占用会达到约 135 GB。LRU 策略会将闲置模型移到 SSD,因此,只要会话没有同时固定所有模型,这些模型在实际使用中就可以共存。在 Model Manager 中固定主模型,确保它永远不会被逐出内存。
让 Claude Code 连接本地端点
oMLX 在 http://127.0.0.1:8000 提供兼容 Anthropic 的 API。在当前版本中,路由位于 /v1 下:POST /v1/messages 和 POST /v1/messages/count_tokens。Claude Code 会读取 ANTHROPIC_BASE_URL,因此,只需导出环境变量,就能让 CLI 连接你的 Mac。首先,在 Claude Code 的全局配置中关闭归因请求头,避免网关向提示词中附加额外的干扰内容:
从 0.5.0 开始,新增了一条可以替你完成所有这些操作的快捷命令;本文这套操作步骤最初写成时,它还不存在:
omlx launch claude
它会将 ANTHROPIC_BASE_URL 指向你的服务器,把配置的密钥写入 ANTHROPIC_AUTH_TOKEN(如果没有密钥,则使用 omlx),清空 ANTHROPIC_API_KEY 以强制使用指定的基础 URL,将 API_TIMEOUT_MS 提高到 3,000,000,并禁用非必要流量。它还会根据引擎实际支持的能力设置 CLAUDE_CODE_MAX_CONTEXT_TOKENS 和 CLAUDE_CODE_AUTO_COMPACT_WINDOW,这正是过去需要通过上下文缩放选项手动完成的工作。它要求上下文窗口至少为 48,000 个 token;如果所选模型达不到这个要求,就不会启动。Codex、OpenCode、OpenClaw、Hermes 和 Pi 也有对应命令,仪表盘和命令行指南中都有说明。
下面的手动配置方法仍然有效。如果你想精细控制每个变量,就使用这种方式。
~/.claude/settings.json:
{
  "env": {
    "CLAUDE_CODE_ATTRIBUTION_HEADER": "0"
  }
}
然后执行启动命令:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_AUTH_TOKEN=<your_api_key>
export ANTHROPIC_DEFAULT_OPUS_MODEL=unsloth/Qwen3.6-35B-A3B-MLX-8bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=unsloth/Qwen3.6-35B-A3B-MLX-8bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3-14B-Instruct-mlx-4bit
export ANTHROPIC_DEFAULT_MODEL=unsloth/Qwen3.6-35B-A3B-MLX-8bit
export API_TIMEOUT_MS=600000
export CLAUDE_CODE_USE_BEDROCK=0
export DISABLE_NONESSENTIAL_TRAFFIC=1
claude --bare
--bare 参数会跳过钩子、LSP、插件同步和自动记忆,将 Claude Code 的系统提示词缩减到约 1,795 个 token(加载全部功能时则会使用数千个 token)。对于使用本地模型的离线工作,这是合理的默认选择:系统提示词中的每个 token 都会消耗 Mac 的带宽。重新连接 api.anthropic.com 时,去掉这个参数即可。
oMLX 仪表盘中的 Claude Code with oMLX 区域可以帮你生成这条命令:从三个下拉菜单中分别选择 Opus、Sonnet 和 Haiku,然后复制可直接粘贴执行的命令。将 Context scaling for Claude Code 设为 64000:Claude Code 默认请求 200k token 的上下文,但对本地模型来说,请求 64k 比请求它无法满足的 200k 更合适。这个选项会按比例调整上报的 token 数量,使自动压缩在达到目标大小时触发。
有一点确实需要注意:Claude Code 是针对 Claude 的工具使用格式和响应模式调优的。通过 ANTHROPIC_BASE_URL 接入非 Claude 模型,可以用于自动补全和推理,但工具调用的可靠性以及智能体循环的表现都会下降。它适合离线工作、处理不应离开 Mac 的敏感数据,或者在 api.anthropic.com 对你限流时充当备用方案。它无法与 Claude Opus 4.7 完全等价替换。
如果 oMLX 运行在 Mac Studio 上,而你想从 MacBook 使用 Claude Code,可以通过 SSH 端口转发连接:
ssh -L 8000:localhost:8000 user@mac-studio
连接成功后,笔记本上的 127.0.0.1:8000 就会指向 Studio 上的 oMLX。将下面的脚本保存为 claude-local.sh:
#!/bin/bash
export ANTHROPIC_BASE_URL='http://localhost:8000'
export ANTHROPIC_AUTH_TOKEN=''
export ANTHROPIC_DEFAULT_OPUS_MODEL='Qwen3.6-35B-A3B-MLX-8bit'
export ANTHROPIC_DEFAULT_SONNET_MODEL='Qwen3.6-35B-A3B-MLX-8bit'
export ANTHROPIC_DEFAULT_HAIKU_MODEL='Qwen3-14B-MLX-4bit'
export ANTHROPIC_DEFAULT_MODEL='Qwen3.6-35B-A3B-MLX-8bit'
export API_TIMEOUT_MS=600000
export CLAUDE_CODE_USE_BEDROCK=0
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
claude --bare --dangerously-skip-permissions
使用 chmod +x claude-local.sh 为它添加执行权限,然后在 SSH 会话中运行。默认 API 密钥为空。如果你在 Settings → Auth & Info 中设置了密钥,就用它替换 ''。
--bare 会将 Claude Code 的系统提示词缩减到约 1,795 个 token。--dangerously-skip-permissions 会跳过在自动化流水线中没有意义的交互式权限提示。
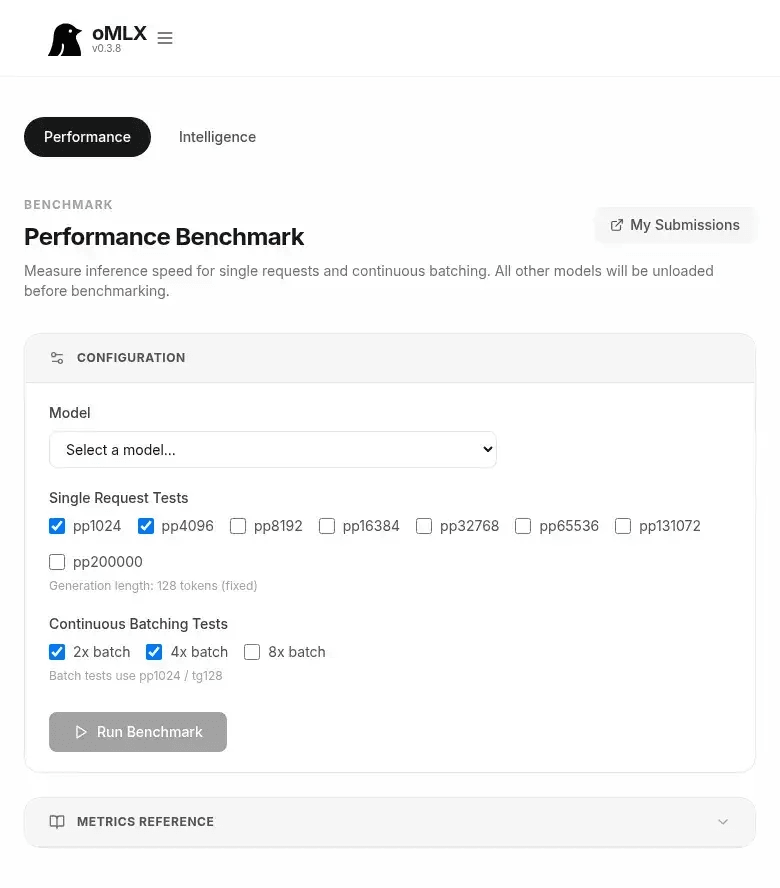
Bench → Performance 会在你的实际硬件上运行测试。面板涵盖八种提示词长度的预填充测试(pp1024、pp4096、pp8192、pp16384、pp32768、pp65536、pp131072、pp200000),以及并发数为 2x、4x 和 8x 的连续批处理测试。结果会提交到公开的 oMLX 排行榜,My Submissions 会将你的结果与采用相同测试配置的其他机器并列展示。在 0.6.4 中,每次测试结束后都会自动上传;如何避免上传,见 0.6.4 基准测试部分。
以下参考数据于 2026 年 5 月在配备 128 GB 内存的 40 核 M5 Max 上,使用 oMLX 0.3.8 实测得出,并非推算值(omlx.ai 排行榜上已经有 M5 Max 的提交结果,vLLM 于 2026 年 5 月 11 日发布的独立 TurboQuant 研究也证实了大型稠密模型的这些数据):
Qwen 3.6 35B-A3B 8-bit(MoE,激活参数量为 3B):短上下文下的解码速度为 65–80 tok/s。这是在这台机器上最能改变日常使用体验的模型。以下是这套配置的实际基准测试:
连续批处理(pp1024 / tg128):
Llama 3.3 70B 4-bit:解码速度为 14–18 tok/s。
Mistral Large 2 123B 4-bit,KV 缓存使用 TurboQuant 3.5-bit:解码速度为 8–11 tok/s。在 128k 上下文下,关键指标是峰值内存,约为 74 GB(FP16 KV 缓存的内存占用会远超 128 GB)。dasroot.net 的 M5 Max 长上下文实验记录了 104B 稠密模型同样的峰值内存占用。
根据公开的 oMLX 基准测试提交结果,gpt-oss-20b MXFP4-Q4 在 40 核 M5 Max 上的解码速度约为 100 tok/s。
上面的表格是我们在 0.3.8 上的实测结果。2026 年 9 月 15 日,我又在同一台机器上使用 0.6.4 重新跑了一遍测试。在完全没有启用加速的情况下,这个模型处理 32k 提示词时的速度从 15.2 tok/s 提高到了 77.9 tok/s。推测解码还能带来 1.07 倍到 1.88 倍的加速,具体取决于模型和上下文。新表格见 0.6.4 基准测试部分。
vLLM 在 2026 年 5 月测得 TurboQuant 的 KV 缓存压缩比为 4.41 倍。这个数字决定了你是“有 128k 上下文,但内存装不下”,还是“用得上 128k 上下文,还能同时加载另外两个模型”。在 4-bit 和 3.5-bit 下,质量仍接近全精度;到了 3-bit,代码和长篇推理中的质量下降就开始变得明显。
在 0.6.4 上,推测解码是这台 M5 Max 提速最有效的手段,而具体该选哪种方法,取决于模型。通过 API、在 temperature 为 0.6 的条件下测量,Qwen3.8-27B oQ4e 使用 Lightning MTP 后,速度从 21.1 tok/s 提高到了 39.7 tok/s。Qwen3.6-35B-A3B 8-bit 使用 VLM MTP 后,速度从 79.7 tok/s 提高到了 117.5 tok/s。本节所有数据都于 2026 年 9 月 15 日在本指南所用的机器上实测得出,测试方法和完整表格见 0.6.4 基准测试部分。
oMLX 0.6.4 提供三种推测解码方法,每个模型只能启用其中一种:
Lightning MTP:使用模型权重内自带的多 token 预测(MTP)头。只有在转换时保留了 mtp.* 张量,它才能工作。
VLM MTP:使用一个不到 2 GB、针对该基础模型训练的外部 MTP 草稿模型。只有在没有其他请求运行时,它才会生效。
DFlash:使用 z-lab 的块扩散草稿模型,每轮最多提出 16 个 token。它一次处理一个请求,并维护自己的前缀缓存。
这三种方法都会由大模型验证每个候选 token,因此最终输出来自大模型,而不是草稿模型。以下是各个组合在这台 M5 Max 上的实测结果:
对于 Qwen3.6-35B-A3B,启用 Lightning MTP 的 oQ4e 构建版本在两项测试中都是最快的,而且比 8-bit 版本少占用约 15 GB 内存。在长上下文和以文字叙述为主的回答中,各种配置的加速收益都会缩小,因为大模型接受的草稿 token 更少,但没有任何配置比各自的基线更慢。
如果 Qwen 模型的设置中出现警告 Config declares MTP layers but the weight files contain neither mtp.* tensors nor native nextn layers,说明转换时移除了 MTP 头。默认的 mlx-lm 转换器就会这样做:这台 Mac 上安装的 mlx-community 发布的 Qwen3.6-35B-A3B 构建版本,以及 lmstudio-community 发布的 Qwen3.8-27B 构建版本,都存在这个问题。有两种解决办法:下载保留了 MTP 头的构建版本,例如 oMLX 作者发布的 oQ4e-mtp 版本;或者启用 VLM MTP,搭配外部草稿模型使用。
草稿模型的下载方式与其他模型相同。在 Models → Downloader 中,粘贴 Hugging Face 仓库 ID 并开始下载。oMLX 会根据类型识别草稿模型,并将其标记为辅助模型;开启 Hide Helper Models 后,它们也不会出现在 API 的模型列表中。
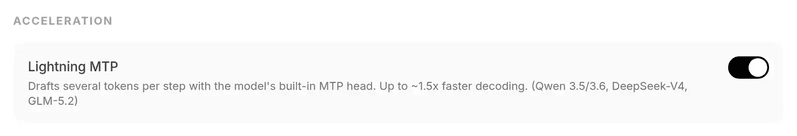
对于保留了 MTP 头的模型,打开 Settings → Model Settings,点击模型的齿轮图标,然后在 Acceleration 区域开启 Lightning MTP。保存后,oMLX 会重新加载模型。
在 Qwen 上,默认每轮生成 3 个草稿 token,自适应控制器会根据每次响应的接受率调整这个数量。oMLX 日志会为每次响应记录一行,包含该接受率:在 Qwen3.6-35B-A3B oQ4e 上,接受率约为 72–77%,每轮输出 2.5 到 2.9 个 token。使用贪心采样时,除了微小的数值差异,输出与未启用 MTP 时一致。使用温度采样时,拒绝采样会保留大模型的输出分布。
在同一个 Acceleration 区域中,开启 VLM MTP,从下拉菜单中选择草稿模型,然后保存。0.6.4 版本的代码中有三个条件值得提前了解:
模型必须加载到视觉引擎上。多模态 Qwen3.6 和 Qwen3.8 版本默认如此,但对于纯文本模型,这个设置会被静默忽略。
它不能与 TurboQuant、重复惩罚或出现惩罚同时使用。内置的 Qwen 预设将 presence_penalty 设为 1.5,这会使 VLM MTP 关闭。
只有在没有其他请求运行时,它才能加速请求。有并发请求时,oMLX 会回退到常规批处理。
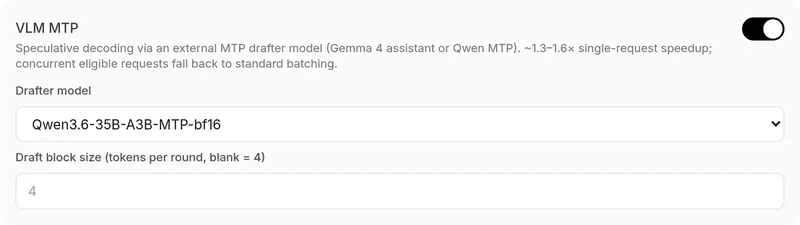
你也可以通过管理 API 应用同样的更改。在配置多个模型或编写脚本时,这种方式更方便。第一条命令使用你的密钥登录并保存 cookie;第二条命令更新模型设置:
curl -c omlx.cookies -X POST http://127.0.0.1:8000/admin/api/login \
  -H "Content-Type: application/json" \
  -d '{"api_key": "your_api_key_here"}'

curl -b omlx.cookies -X PUT \
  http://127.0.0.1:8000/admin/api/models/Qwen3.6-35B-A3B-8bit/settings \
  -H "Content-Type: application/json" \
  -d '{"vlm_mtp_enabled": true,
       "vlm_mtp_draft_model": "Qwen3.6-35B-A3B-MTP-bf16"}'
路径中的模型名称和草稿模型名称,都是模型列表中显示的 ID。对于 Lightning MTP,请求体为 {"mtp_enabled": true}。该端点会拒绝任何不认识的字段,因此拼写错误不会被悄悄放过。
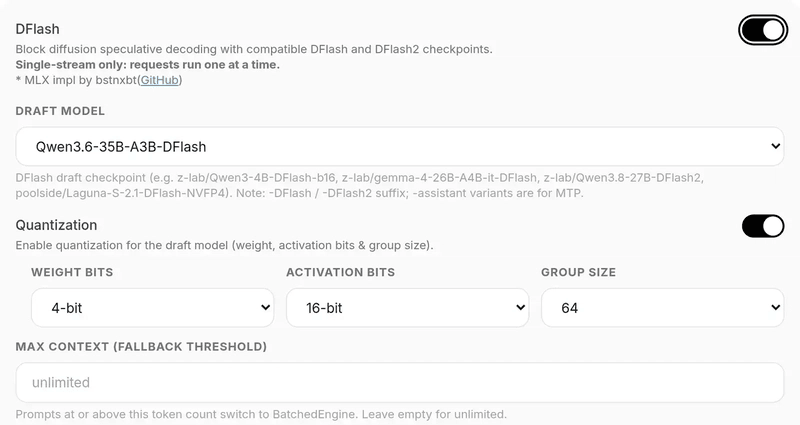
在提示词长度为 1,000 个 token 时,DFlash 是最快的方法;但在长上下文场景下,它的表现最差。在内置基准测试中,使用 1k 提示词时,Qwen3.6-35B-A3B 8-bit 的速度从 92 提升到 112 tok/s;但使用 32k 提示词时,速度从 78 降到了 17 tok/s。Qwen3.8-27B 4-bit 在 32k 提示词下的速度从 23.5 降到了 6.3 tok/s。如果你使用 Claude Code,它每轮都会发送数万个 token 的上下文,请保持 DFlash 关闭。
对于聊天或自动补全等短提示词任务,下载对应的 z-lab 草稿模型:z-lab/Qwen3.6-35B-A3B-DFlash(0.77 GB)、z-lab/Qwen3.8-27B-DFlash2(3.85 GB)或 z-lab/gemma4-12B-it-DFlash(1.46 GB)。在 Acceleration → DFlash 中启用它,并将草稿模型量化为 4 位。在 27B 模型上,使用 1k 提示词时,4 位草稿模型的速度为 48.2 tok/s,而 bf16 为 36.9 tok/s,同时少占用 2.5 GiB 内存。
它还有两个限制。每次只能处理一个请求。另外,虽然 dflash_max_ctx 会将长请求交给常规引擎处理,但处理完第一个这样的请求后,DFlash 就会一直保持关闭,直到你重新加载模型。
Qwen ANE Prompt Processing 会将 Qwen3.5、3.6 和 3.8 的部分预填充计算分配给 Apple 的 Neural Engine(ANE)和 GPU。Tune for this Mac 按钮会测量最适合你这台机器的分配比例,在你应用结果之前不会保存任何设置。在 Qwen3.8-27B oQ4e 上,它建议将 35% 的 MLP 通道和 37.5% 的 GDN 层交给 ANE。采用这个比例后,8,193 个 token 的提示词预填充速度从 452 提升到 510 tok/s,增幅为 12.8%。
但在完整模型上,这 12.8% 的提升并未延续。应用该分配比例并开启 Lightning MTP 后,内置基准测试测得:使用 4k 提示词时,预填充速度为 505 tok/s,而不使用 ANE 时为 499 tok/s;使用 32k 提示词时,两者分别为 422 和 471 tok/s。通过 API 测试时,在上下文为 15,100 个 token 的情况下,首个 token 耗时为 34.8 秒,而不使用 ANE 时为 35.2 秒。代价是模型加载后的内存占用从 16.0 增加到 20.7 GB,加载时间从 2 秒增加到 20 秒,因此在这台 Mac 上,我选择保持它关闭。
在 M5 Max 上进行调优之前,请先在模型设置中关闭 Use both ANEs。这个模式是为 M3 Ultra 设计的,后者将两颗芯片连接起来,拥有两个 ANE。它只会加速长度为 2,048 个 token 或更多的提示词;生成阶段仍在 GPU 上运行。
项目本身记录了三项代价。它无法做到逐比特一致,因为 ANE 使用的是重新量化为 INT8 的权重。它依赖 Apple 的私有接口,而 macOS 更新可能会……