
8.0
热点
AI SCORE
模型发布2026-10-14 05:25
AWS 开源 2B 决策模型,专做选项判断
dev.to · AI#Agent#决策模型#开源
Editor brief · 编辑速览
Strands Decider 2B 对给定状态与封闭选项直接输出决策及校准概率,无需生成文本。模型采用 Apache 2.0 许可,可本地运行并接入 Agent 工具调用审查;素材报告桌面 GPU 中位延迟约 115 毫秒。
Agent 内部的许多 LLM 调用,其实并不是为了生成文本,而是为了做一些小决策:这张工单该归哪个团队处理?用户真的说过这个工具参数,还是模型自己编出来的?这条消息是否紧急?该用便宜的模型,还是昂贵的模型?每做一次这样的决策,我们都要把完整上下文发给前沿模型,等上一两秒,再解析它返回的自由文本,而且这些文本并不告诉我们模型对自己的判断有多大把握。
AWS 的 Strands Agents 团队旗下实验部门 Strands Labs 发布了 Strands Decider 2B。这是一个采用 Apache 2.0 许可证的模型,专门填补这个空白。它不生成文本,而是接收一个状态和一组问题,为每个问题从封闭的选项集合中作出选择,并返回经过校准的概率。它在本地运行,在桌面 GPU 上的响应延迟中位数约为 115 ms,还能接入 Strands Agents 的 intervention 系统,在工具调用执行前进行审查。
这是一个决策模型,作者称之为“system one”模型:选择选项、回答是或否,或者按量表打分,每次都会给出概率。它不生成文本。
架构:保留 Qwen3.5-2B-Base 的主干,移除 LM head,加入一个约 100 万参数的 pointer head,以及 rank-16 LoRA adapters。只需一次前向传播,没有解码循环。
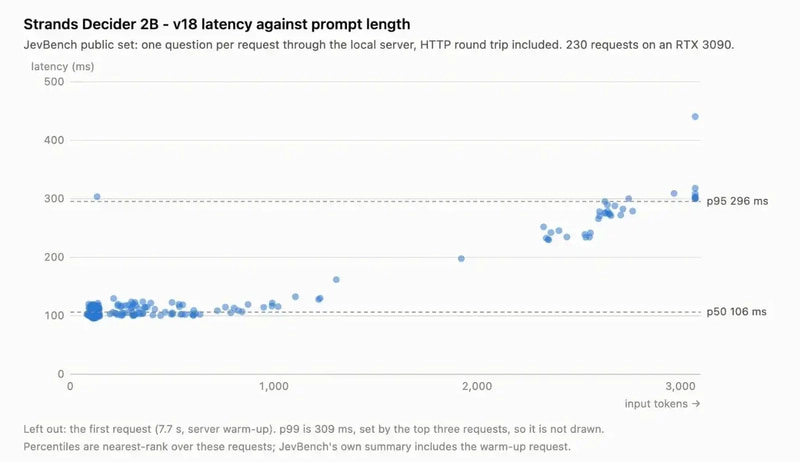
首个版本的延迟:在 RTX 3090 上,中位数为 115 ms,p95 为 299 ms;在 M3 Pro 上为 153 ms。
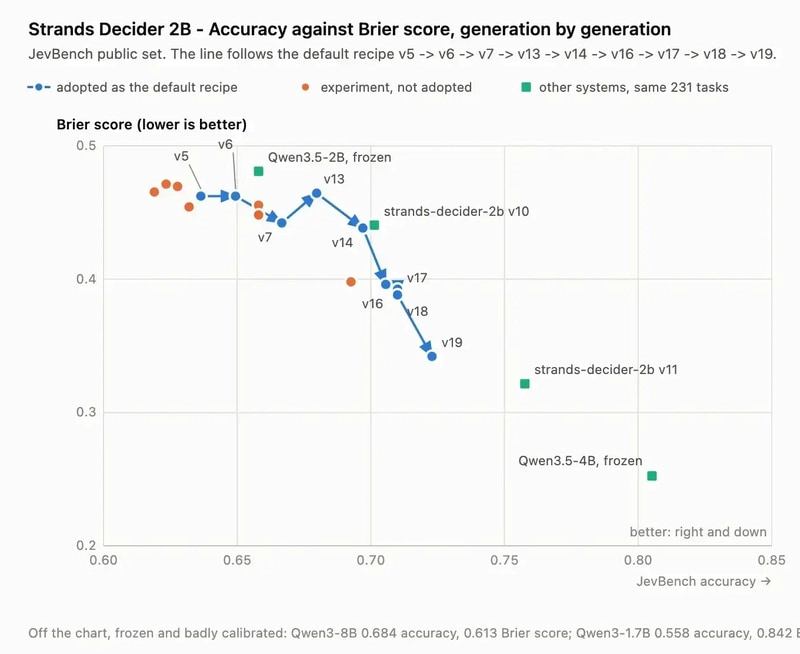
在 JevBench 的 231 个公开任务中,当前参考模型答对了 180 个,准确率为 0.779。Gemma 4 系列中的 26B 模型能答对 207 个。
运行 pip install strands-decider,然后通过 CLI 使用,或者启动本地 HTTP server,通过 /v1/systemone 调用。
这是一个实验项目,不是 AWS 托管服务,需要你自己运行。
“决策模型”这个思路在 9 月引起了关注。当时,TypeSafe AI 结束隐身开发状态,推出了 Jev。这是一个专有模型,返回的是带类型的决策,而不是文本,目前通过候补名单开放使用,价格为每百万输入 token 0.042 美元。Strands 肯定了 Jev 对推广这一思路的贡献,并使用 JevBench 进行评估。两者的区别在于发布方式:Jev 是闭源的;Strands Decider 则公开了权重、代码和完整的训练方案。
这里还有一个设计层面的理由。问聊天模型“你自己的工具参数有依据吗?”,它可能被说服回答“有”。而一个返回数值、由你的 if 语句据此选择分支的分类器,不会跟你讨价还价。
Decider 保留了 Qwen3.5-2B-Base 的 transformer 主干,移除词表输出头,换成 pointer head。输入采用固定格式:状态、问题、编号选项,以及一个 <answer> 标记。这个 head 将每个选项的最终隐藏状态与 <answer> 位置的隐藏状态进行匹配打分,再通过 softmax 将这些 logits 转换为概率,处理就结束了。整个过程不生成任何 token。
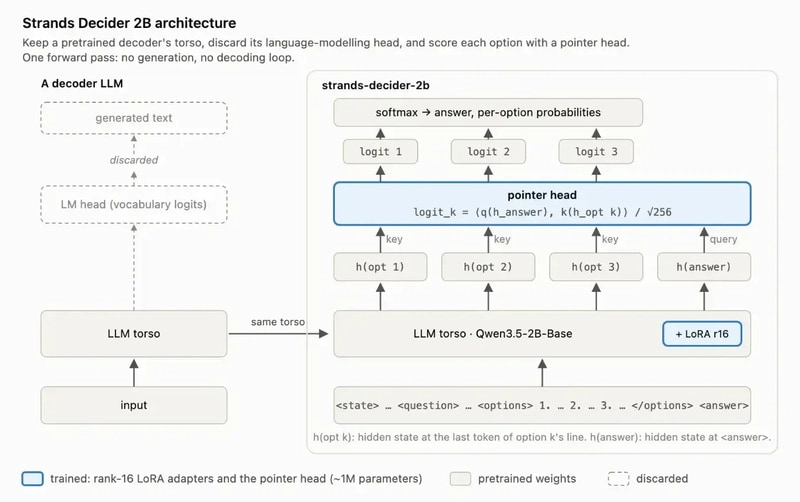
这带来了两个实际好处:首先,这个 head 没有针对各个选项的专属参数,因此不会学出“选项 1 通常是正确答案”这样的偏好,修改选项名称也不需要重新训练;其次,训练的只有 LoRA adapters 和 head,因此仓库能够公开完整训练方案,训练大约需要一张 RTX 3090 跑 11 小时,或者八张 H100 跑约 70 分钟。
它支持三种问题类型:noul,回答是或否,返回 P(yes);choice,从 N 个选项中选择一个;以及 score,按照有序评分标准选择一个等级。你可以在一次请求中,针对同一个状态提出多个问题;状态只需编码一次。
README 本身也提醒,单次运行之间,如果差距不到约 10 个任务,结果就不可靠。对于 v19,Techstrong.ai 报道其在简单任务上的准确率为 100%,在困难任务上为 50.5%:擅长常规任务,处理复杂任务表现一般,而这正是它的定位。
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?" \
  --score "How frustrated is the writer?=calm,frustrated,depressed"
README 中的示例输出来自一次 CPU 运行:选择 billing 的概率为 0.773,紧急程度的概率为 0.858,挫败感得分为 1.03,置信度为 0.509。最后这个数字,就是模型在告诉你它没有把握,而 LLM 不会给你这样的信息。
strands-decider serve StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 --port 8000
curl -s localhost:8000/v1/systemone -H 'content-type: application/json' \
  -d '{"state": "Help! My payouts have been failing for 3 days!",
       "questions": {"is_urgent": {"type": "noul", "instructions": "Does this convey urgency?"}}}'
server 绑定在 127.0.0.1,没有身份认证。不要通过公开的 Service 暴露它。
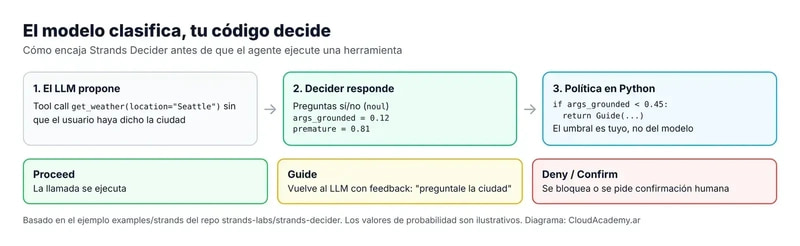
下面是仓库中 examples/strands/ 示例的精简版。这个 Agent 的 system prompt 急于让它行动,导致它猜了一个城市;Decider 抓住了这个问题:
from strands import Agent, tool
from strands.interventions import Guide, InterventionHandler, Proceed

YES = 0.45  # illustrative threshold; tune it on your own traffic

class ToolCallReviewer(InterventionHandler):
    name = "strands-decider-tool-call-reviewer"

    def __init__(self, decider):
        self._decider = decider

    def before_tool_call(self, event, **kwargs):
        state = build_state(event.agent.messages, event.tool_use)  # conversation + proposed call
        answers = self._decider.ask(state, QUESTIONS)  # args_grounded, premature (noul)
        if answers["args_grounded"]["noul"] < YES:
            return Guide(feedback="The arguments look guessed. Ask the user to confirm them.")
        if answers["premature"]["noul"] >= YES:
            return Guide(feedback="Too early to call this tool. Clarify with the user first.")
        return Proceed()
Guide 不会阻止调用;它会带着反馈把当前回合交还给模型,最终让 Agent 询问“哪个城市?”,而不是直接报告西雅图的天气。Strands interventions 还支持 Deny 和 Confirm,后者用于人工审批。
因为 server 只监听 localhost,所以在 Kubernetes 中,最自然的部署方式就是把它作为 sidecar,放进 Agent 所在的 pod。原生 sidecar,也就是设置了 restartPolicy: Always 的 init container,会在 Agent 之前启动,并在 pod 的整个生命周期内运行。有两个容易踩的坑:首先,目前没有发布好的容器镜像,因此需要自己构建,并把权重打包进去;其次,httpGet 探针一定会失败,因为 kubelet 访问的是 pod IP,而不是 127.0.0.1,所以应该使用 exec 探针,访问 http://127.0.0.1:<port>/health。对于这个 2B 模型,g6 系列节点配备的 NVIDIA L4 和 24 GB 显存已经足够。
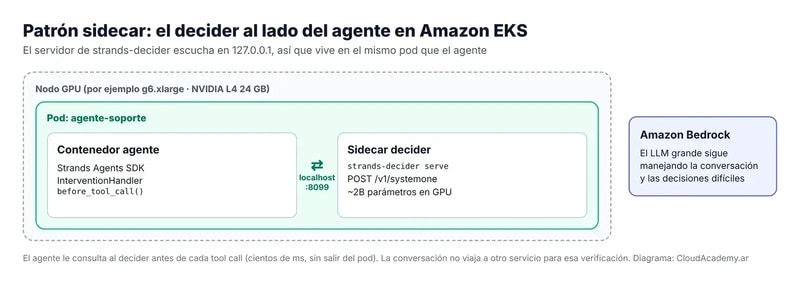
模型免费,但硬件需要付费。在 us-east-1,g6.xlarge 的按需价格约为每小时 0.805 美元,全天运行大约每月 588 美元。我粗略估算了一下:按约 115 ms 的延迟,每秒串行完成约 8 次决策,一个月大约能处理 2000 万次决策;如果每次使用 500 个 token,同样的用量在 Jev 这种按 token 收费的服务上大约需要 450 美元。持续高用量或有隐私要求时,自托管更有优势;用量较低时,闲置 GPU 的成本反而更高。可以先从 CPU 开始,共享 GPU,并把 Decider 当作第一轮过滤器,将低置信度的情况升级交给 LLM 处理。
根据 model card:改换问题的措辞,往往仍会得到相同答案;包含多个推理步骤的长文档是它的弱项;score 和 noul 对陌生评分标准的迁移能力较差;而概率校准是在短文本分类任务上拟合的,因此需要用你自己的实际请求验证阈值。训练数据和示例都是英文。
benchmark 并不是重点,231 个任务的结果有很大噪声。重点是职责分离:模型负责分类并返回数值,你的代码负责决策。这样,那些隐藏在 prompt 里的决策,就变成了可以通过明确阈值进行测试、版本管理和审计的东西。这与平台团队使用 Kubernetes admission policies 的逻辑相同:在某个操作执行前,设置一个确定性的检查关卡。它还没有达到生产可用的程度,官方示例也说明其中的阈值仅用于演示。不过,我会把它用作内部 Agent 的工具调用护栏,部署到共享 GPU 的 pod 中,并将它的决策与当前 LLM 的决策进行比较。
本文最初以西班牙语发布在 CloudAcademy.ar,包含完整的 Kubernetes manifest 和完整的 intervention 示例。
Strands Decider 2B 介绍
GitHub 上的 strands-labs/strands-decider
Strands Agent intervention 示例
Hugging Face 上的 model card
Techstrong.ai 的报道
VKTR:TypeSafe AI 推出 Jev
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。