
8.0
热点
AI SCORE
技术实践2026-10-13 17:42
Agent 安全应落实到工具授权层
dev.to · AI#Agent#安全#权限管理
Editor brief · 编辑速览
文章将 Agent 拆解为观察、决策、执行的反馈循环,指出模型输出通过工具才会产生实际影响。它建议为每个 Agent 配置独立身份、明确的权限范围,并默认拒绝未授权操作。
如果 Agent 真有魔法,我们就没法保障它们的安全。好在它们没有,所以我们做得到。
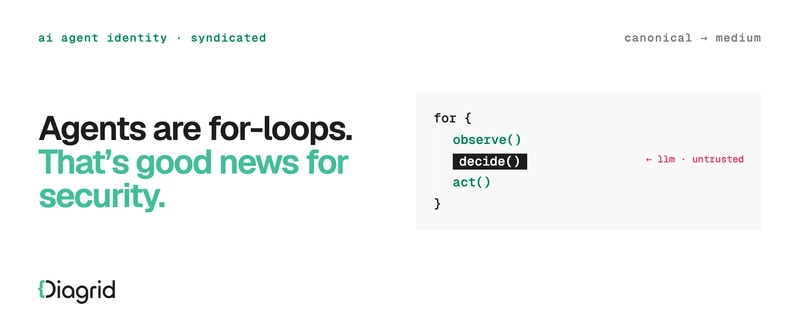
AI Agent 并不神奇。它们只是采用概率性决策、拥有现实世界操作权限的工作流。抛开那些包装,你会发现,它们用的就是你在 Kubernetes controller 和嵌入式恒温器中早已熟悉的经典控制器反馈循环:观察、决策、行动,然后重复。唯一的新元素,是决策这一步交给了语言模型。
这是个好消息,因为这意味着,过去二十年积累的分布式系统安全经验,几乎可以原封不动地用在这里。模型是你不能信任的部分;围绕模型的一切,则是你已经知道如何做好安全防护的部分。
模型输出指令。行动步骤中的工具负责把模型的意图转化为现实世界中的行为:写入数据库、退款、部署。这意味着,安全边界不在 prompt,从来都不在。安全边界在工具层,而工具访问本质上是一个授权问题,我们对此早有成熟的解决方案:每个 Agent 都有自己可验证的身份,每个身份都获得范围明确的授权,所有未经授权的操作默认拒绝。
注意,这套方案取代的是什么。如今常见的做法是:把一个共享的 API key 放在环境变量里,让所有 Agent 共用,再把真正的策略写进 system prompt,当作一句客气的请求。只以模型指令形式存在的权限,根本算不上权限。而且,在工具前面放一个网关,作用也没有看上去那么大:网关能保护一条访问路径,却无法保护不在它上面运行的工作负载。如果 Agent 能直接访问后端服务,网关就只是个摆设。
为每个 Agent 单独签发身份凭证,凭证有效期短,并且可以通过密码学验证(SPIFFE 提供了相应标准)。针对每个工具、每个 Agent 限定授权范围,并在运行时强制执行。以默认拒绝一切为起点,把授权作为经过审慎决定的例外。再加上一份经过签名的执行历史,这样,“Agent 做了什么”就能得到经得起审计的回答,而不是只能拿出一份任何人都可能修改过的日志文件。
这套系统仍然存在一个弱点:针对 Agent 已获合法授权的工具实施 prompt injection。如果 Agent 被允许发送邮件,而一份被投毒的文档诱导模型发错了邮件,那么身份验证和授权机制都履行了职责,损害却依然发生了。没有任何基础设施能让模型变得可信。基础设施能做的,是把行为失控的模型所能触及的范围限制得足够小,从而把一场灾难缩小为一次安全事件。
更深入的讨论,可参阅《Agent 身份:AI 仍然缺失的基础层》和《为什么 MCP 网关还不够》。
如需进一步采取措施,你可以考虑屏蔽此人和/或举报滥用行为。