
8.0
热点
AI SCORE
开源项目2026-10-13 22:00
SparseEngine 统一接入十五种稀疏注意力
dev.to · AI#推理优化#稀疏注意力#开源
Editor brief · 编辑速览
SparseEngine 以 KV 缓存抽象统一接入稀疏注意力方法,让不同缓存表示共享调度、批处理和前缀缓存能力,并以 Apache-2.0 发布代码。文中报告同批量下约 1.5 至 2.6 倍吞吐提升,而约 10 倍结果来自不同最大批量的比较。
SparseEngine 是一个面向 LLM 的推理引擎,只将部分 attention 状态保留在 GPU 显存中。包含哈尔滨工业大学作者在内的团队在 arXiv 上发表了相关论文,编号为 2609.39068v1,并在 CURRENTF/SparseEngine 仓库中以 Apache-2.0 协议发布了代码。
稀疏 attention 方法决定 KV cache 中哪些部分可以保留下来,以近似计算为代价,降低长上下文 decoding 的显存占用和 attention 计算成本。
现有推理引擎将这一决策与自身的 cache 布局绑定,因此,基于 page 的引擎适合某些方法,却无法支持另一些方法。
SparseEngine 以 KV cache 抽象为核心构建:每种方法可以定义自己的 cache 表示,而调度、batching 和 prefix caching 仍由引擎统一提供。
论文报告的吞吐量优势分为两种情况:采用 SnapKV 并实际移除 KV 数据时,在各个“系统与方法”组合成功测试的最大 batch size 下,SparseEngine 的总 decoding 吞吐量约为原版 vLLM 的 10 倍,但这比较的是不同 batch size;采用 Quest 和 OmniKV 时,在相同 batch size 下,吞吐量约为原版的 1.5 至 2.6 倍。
论文还为多轮任务引入了 Chain Cache,让 KV 淘汰方法能够从压缩后的历史状态继续执行;同时提供 prefix pruning,可以移除选定的历史区域,而不影响 prefix matching。在 Agent 轨迹测试中,SnapKV、Quest 和 OmniKV 的表现接近完整 attention 基准;H2O 在 SWE-bench Lite 上的任务解决率则从基准的 25.0% 降至 13.0%。prefix pruning 需要延迟四轮执行,才能恢复到未剪枝基准的表现。
上下文越短,加速幅度越小。评估还记录到,加速幅度最大的方法,准确率下降也最大。因此,对团队来说,决定取舍的关键指标仍然是方法本身允许牺牲多少准确率。
这个引擎面向的是在自有 GPU 上部署长上下文 Agent 的场景。论文中的限定条件说明了这些数据涵盖哪些 batch,以及哪些 attention 变体。
长对话推理的开销主要来自两处:一是 KV cache,它保存所有已处理 token 的 attention 状态;二是读取这些状态的 attention 计算。稀疏 attention 方法通过只保留一部分状态,同时降低这两项开销。SnapKV、H2O 这类方法决定保留哪些条目;Quest 这类 page 选择方法则针对每个 query 选择 KV page。不同方法所需的数据表示也不同。
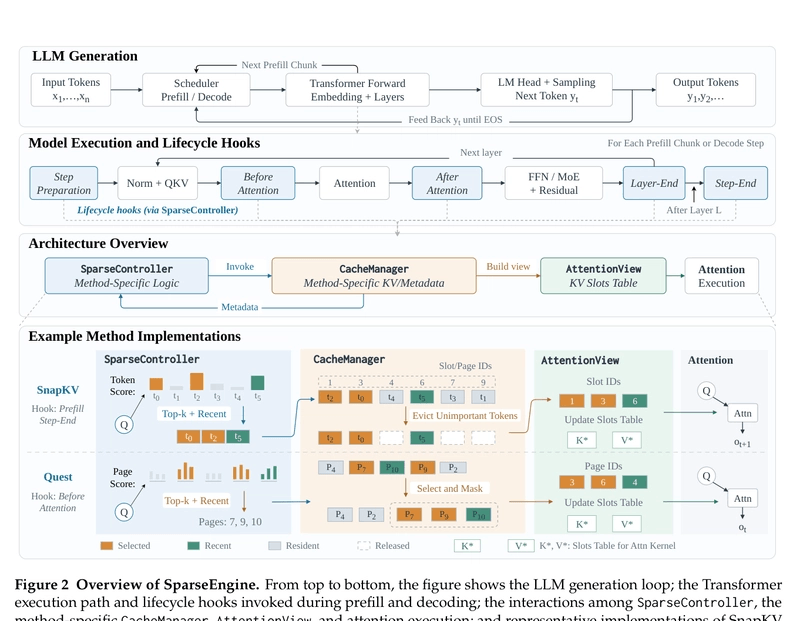
SparseEngine 论文中的图 2(arXiv:2609.39068v1,获取于 2026-10-11):顶部是生成循环,中间是稀疏方法可以接入的 hook 点,另有向 attention backend 暴露选定状态的接口。
论文认为,围绕单一 cache 布局构建的引擎,会限制它们能够承载的方法。论文列举了以 page 为中心执行操作的 Vortex、按 GPU-CPU pipeline 划分工作的 SPIN,以及按 attention head 保留状态的 Tangram。这些引擎都很适合某一类方法。SparseEngine 提出的设计重新划定了边界:通过一套共享的生命周期契约,在 prefill、decoding 和步骤切换过程中提供细粒度 hook,让每种方法定义自己的 KV 表示和工作流程,同时共用调度器、continuous batching 和 prefix caching。
这种边界划分带来的直接主张是覆盖范围。SparseEngine 支持 15 种方法,分属动态稀疏 attention、KV 淘汰、KV 量化和 KV 压缩四个类别。论文图 1 将这些方法与支持它们的引擎并列展示。
对推理服务团队而言,有一个设计细节让这种覆盖能力更加具体。SparseEngine 的 ChainCacheIndex 将一个会话与其保留的逐层 KV、方法专属元数据,以及逻辑 token 前缀关联起来。这些正是 KV 淘汰方法在下一轮从保留的历史状态继续执行时所需的状态。
相比标题中的倍数,实际测量时的运行条件更重要,而论文给出的条件足够明确,可以逐项核查。评估使用的两个模型是 FP8 格式的 Qwen3-30B-A3B 和 BF16 格式的 GLM-4.7-Flash,硬件涵盖 NVIDIA H100、H20、RTX PRO 6000、4090 和 5090 GPU。在各个“系统与方法”组合成功测试的最大 batch size 下,采用 SnapKV 的 SparseEngine 在两个模型上的总 decoding 吞吐量都约为原版 vLLM 的 10 倍。采用 Quest 和 OmniKV 时,在多个相同 batch size 的比较中,SparseEngine 达到约 1.5 至 2.6 倍的吞吐量。
同一张图的图注也给出了读者必须了解的限定条件:测试过的最大 batch size,不一定就是系统能够承载的最大容量,因此,总吞吐量数据描述的是一个实测运行点。另有两条说明进一步限定了比较范围:当 GLM 的输入长度为 128K token 时,Vortex 即使在 batch size 为 1 的情况下也会显存不足;HiSparse 和 Tangram 则不支持该模型使用的 multiple-head latent attention 变体。如果把图中最高的数据直接理解为同等条件下的引擎比较,就会夸大结论。采用最激进淘汰策略的引擎,能够在固定显存预算内容纳最大的 batch,这才是其总吞吐量优势的来源。
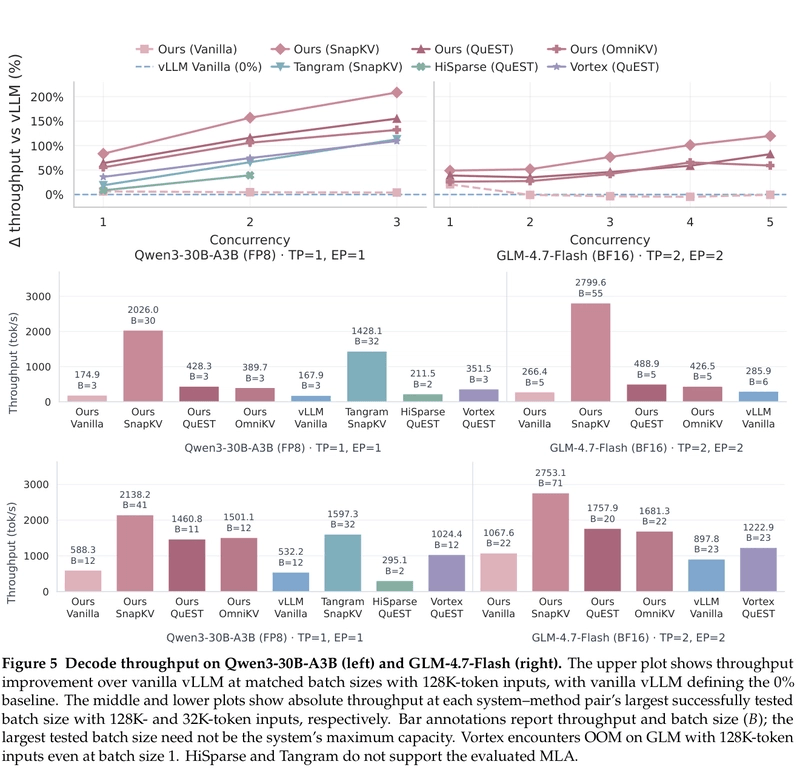
SparseEngine 论文中的图 5(获取于 2026-10-11):上方各图展示在相同 batch size 下相对原版 vLLM 的吞吐量提升,中间和下方各图展示绝对吞吐量,柱状图标签同时标注吞吐量和 batch size。
论文的后半部分主要讨论多轮任务。Chain Cache 让 KV 淘汰方法能够在新一轮开始时,从保留的、经过压缩的状态继续执行。这解决了一个实际问题:如果轮次之间丢弃 cache,执行多轮任务的编程 Agent 就必须在每一轮重新构建上下文。
支持这一主张的证据同时涵盖任务成功率和速度。使用 mini-SWE-agent 在 SWE-bench Lite 上评估时,采用 Chain Cache 的 SnapKV 在 GLM-4.7-Flash 上解决了 24.7% 的任务,完整 attention 为 25.0%,Quest 为 25.3%;在 Qwen3-30B-A3B 上,SnapKV 的任务解决率为 8.3%,完整 attention 为 5.3%,但这一基准水平太低,不足以据此给这些方法排名。另一项 Claw-Eval 测试中,OmniKV 的平均得分为 68.0,pass@1 为 51.1%,完整 attention 基准分别为 67.4 和 50.5。速度方面的数据来自对已记录 Agent 输出的回放,计入了 prefill、decoding、调度和模拟工具等待时间。在 Gasai 上,采用 8K cache 预算和 Chain Cache 的 SnapKV,在 FP8 格式的 Qwen3-30B-A3B 上实现了相对原版 2.24 倍的端到端加速。Gasai 是论文专门用于测量系统效率的 Agent 轨迹;各方法的并发数根据其 KV 显存需求选择,GPU 配置保持相同。
prefix pruning 为价值较低的历史内容提供了一个可调节的控制项。通过全局评分,在指定工具结果中保留 20% 的对齐 KV token,会让任务成功率略有下降。使用 OmniKV,并将剪枝延迟四轮工具结果后执行,可以恢复性能:在相同的 300 个任务上,任务成功率达到 25.0%,原版为 23.7%。我们对这一结果的理解是,Agent 对话中包含大量价值较低的工具结果。
第二组评估明确了本文结论的适用范围。在 AIME 2024 上使用一个较小的 thinking model 时,以稀疏程度换取速度的方法表现出明显差异:StreamingLLM 的准确率为 18.3%,加速倍数为 3.36;PyramidKV 的准确率为 53.3%,加速倍数为 1.66;采用较高 cache 预算的 SnapKV,准确率为 85.0%,加速倍数为 1.05。论文直言,加速幅度更大的方法通常也会出现更大的准确率下降。论文将较小的加速幅度归因于评估所用上下文较短,此时 attention 在总执行时间中的占比更低。
SparseEngine 项目仓库页面截图(github.com/CURRENTF/SparseEngine,获取于 2026-10-11):展示了已发布代码的许可证、主要语言、star 和 fork 数量,以及文件列表。
同一篇论文还在 LongBench V1 和 V2 上评估了质量,报告的是 SparseEngine 与各方法参考实现之间的百分点差值。这种呈现方式有明确含义:引擎能够复现所承载方法的质量,但该方法自身的准确率取舍仍然存在。选择 SparseEngine,决定了团队能够运行多少种方法,以及运行效率如何;选择低 cache 预算的 SnapKV,则决定了服务能够保留多少准确率。
同一篇论文揭示了两项成本,都值得纳入容量规划。实际移除 KV 数据,让固定显存预算能够容纳更大的 batch,从而提升总吞吐量,并改变部署形态:用更少的副本,每个副本承载更多并发请求。稀疏化也会损失准确率,编程任务的结果展示了损失可能有多大:在使用 GLM-4.7-Flash 的 SWE-bench Lite 评估中,H2O 解决了 13.0% 的任务,完整 attention 为 25.0%。
对于在自有 GPU 上运行 Agent 的基础设施,这篇论文的实际价值,是为希望用自身流量验证这些主张的团队提供一套方法选择框架。先根据方法在自身工作负载上的准确率取舍选择稀疏方法,再根据引擎能够支持多少种方法和工作流程来选择引擎,同时确保 prefix caching 和 continuous batching 能正常使用。Netics 构建并运营自托管 AI 平台,其模型层的选择也取决于同一个问题:当工作负载的形态发生变化时,哪些部分仍然可以替换。我们关于推理工厂中 KV cache offload 的文章进一步讨论了下一步:这些状态离开 GPU 后,会被放到哪里。
Netics 编辑部制作的示意图:将已发布的 decoding 数据与论文附带的测量条件并列展示。团队在引用数字之前,应当按这个顺序阅读。
仓库提供了已发布的代码,采用 Apache-2.0 协议,主要使用 Python。仓库创建于 2026 年 1 月,最后一次推送是在 2026 年 10 月 8 日,阅读时有 83 个 star 和 13 个 fork。希望用自身流量验证这些主张的推理服务团队,可以运行对比测试,并结合附带条件阅读这两张图。相比只看标题中的倍数,这样的验证更公平。Netics 在本文中报告论文数据时也保留了这些条件,原因相同。
本文最初发表于 Netics 博客。
如需进一步采取行动,可以考虑屏蔽此人和/或举报滥用行为。