
8.0
热点
AI SCORE
技术实践2026-10-14 02:32
实测 agent-hooks 在执行前拦截超额退款
dev.to · AI#Agent#工具调用#安全
Editor brief · 编辑速览
作者测试微软 agent-hooks:当退款请求为 840 美元、上限为 500 美元时,策略在工具执行前拦截,退款函数未进入。文章还指出所测版本不存在公告中的安装 extra,并说明需另行安装执行约束 SDK。
一个客服 Agent 试图退款 840 美元,而你的策略规定,上限是 500 美元。真正重要的问题只有一个:这条上限究竟在哪里执行——是在模型可能遵守、也可能不遵守的 system prompt 里,还是在 tool call 执行前必须经过的代码路径上?
我想知道微软的 agent-hooks 实际上提供的是哪一种,所以亲自跑了一遍。先说结果:拦截器在工具调用的接入点触发,退款函数根本没有被执行。不过,验证过程并不顺利,而我最初踩坑的方式,才是值得写下来的部分。
发布公告告诉你这样安装:
pip install agent-framework-core[agent-hooks]
这个 extra 根本不存在。在 agent-framework-core==1.21.0 中,发布的 extra 只有 all:
$ python -c "import importlib.metadata as m; print(m.distribution('agent-framework-core').metadata.get_all('Provides-Extra'))"
['all']
pip 对此很客气——提示 warning: The package agent-framework-core==1.21.0 does not have an extra named 'agent-hooks'——然后仍然安装了核心包。middleware 确实在里面(agent_framework/_agent_hooks.py,共 1,710 行),但它调用的执行约束 SDK 是一个独立的包,需要你明确指定安装:
pip install agent-hooks-sdk # 0.1.0b2 at the time of writing
没有这个包,模块仍然可以导入,但工厂函数会抛出明确的 ModuleNotFoundError,准确告诉你该安装什么。这一点做得不错,并不是每个项目都会这样处理。
一个工具、一个拦截器、一个上限。这个 interceptor 刻意写得很简单:
class RefundGuard:
    def intercept(self, context):
        if context["interception_point"] != "pre_tool_call":
            return Verdict.allow()
        call = context["tool_call"]
        if call["name"] == "issue_refund" and float(call["args"]["amount"]) > CAP:
            return Verdict.escalate(
                reason="refund_over_limit",
                message=f"refund {call['args']['amount']} exceeds the {CAP} cap",
            )
        return Verdict.allow()
按照文档的方式,把它接到 Agent 上:
bundle = create_agent_hooks_middleware([RefundGuard()], record_sink=RECORDS.append)
agent = Agent(client=client, instructions="support agent",
              tools=[issue_refund], middleware=[bundle])
这里没有使用真实模型。我写了一个假的 chat client,让它只发出一次 issue_refund 调用,这样运行结果就是确定的,也不花钱。record_sink 把决策流交给我,让我能用数据判断,而不是凭感觉。
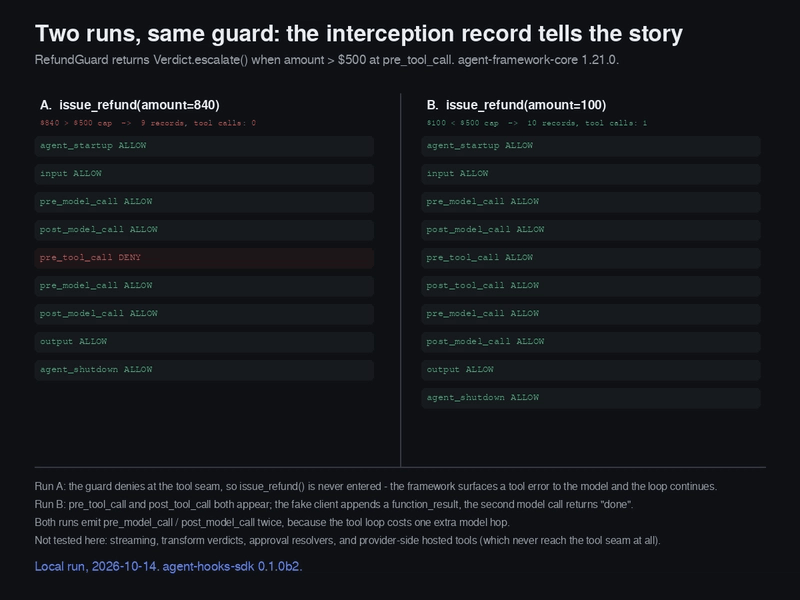
运行 A 请求退款 840 美元,运行 B 请求退款 100 美元。其他条件完全相同。
840 美元的请求始终没有进入函数体。框架把工具错误交给模型,循环继续运行。这正是我们想要的行为:Agent 不会崩溃,只是无法通过这次调用完成任何实际的资金操作。
两次运行都出现了两轮 pre_model_call / post_model_call——经过工具调用会多出一次模型往返。只有运行 B 出现了 post_tool_call,因为运行 A 根本没有执行工具,也就没有调用后的事件可记录。记录流就是凭据:
A: agent_startup, input, pre_model_call, post_model_call,
   PRE_TOOL_CALL(DENY), pre_model_call, post_model_call, output, agent_shutdown
B: agent_startup, input, pre_model_call, post_model_call,
   PRE_TOOL_CALL(ALLOW), POST_TOOL_CALL(ALLOW), pre_model_call, post_model_call, output, agent_shutdown
第一次尝试看起来没问题,实际上却完全失效了。我用框架自带的几个层叠出了这个假的 client,但顺序放错了:
class OneShotClient(ChatMiddlewareLayer, FunctionInvocationLayer, ChatTelemetryLayer, BaseChatClient):
    ...
当 ChatMiddlewareLayer 排在 MRO 的最前面时,chat 接入点就成了最外层的 get_response,因此它会收到 Agent 向下传递的混合 middleware 列表——chat middleware 和 function middleware 混在一起。它注册自己认识的部分,丢掉其余部分:
Ignoring unrecognized middleware of type _AgentHooksFunctionMiddleware:
it is neither a ChatMiddleware nor a callable and will not be executed.
日志里只有这一行。没有异常,运行也没有失败。然后,840 美元的退款就执行成功了:tool_executed: true, calls: [{"customer": "acme", "amount": 840.0}],而拦截记录中完全没有 pre_tool_call 条目——拦截器根本没有被询问。调整顺序,把 FunctionInvocationLayer 放到最前面,运行 A 就会按设计被拦住。
我不会把这称为框架 bug:手写 chat client 是我自己的选择,而且只要读日志,就能看到这种失效。但我们有必要说清楚它意味着什么。如果支出上限、破坏性命令检查或 PII 检查关卡,因为一个类顺序的细节而悄悄失效,那比没有关卡还糟,因为你会以为自己已经有了保护。如果你自己组装 client,就要对记录流做断言——“pre_tool_call 有没有触发?”只需要一行测试,却决定了规则究竟是在真正执行,还是只起装饰作用。
这个设计在此处确实有一点做对了:如果把 bundle 放到 client 上,它会拒绝运行,而不是只安装一部分:
MiddlewareException: MiddlewareBundle member _AgentHooksAgentMiddleware is agent middleware,
but this middleware seam supports only chat, function middleware. A bundle is one indivisible
feature and cannot be partially installed; pass the bundle to the agent instead.
这才是正确的失败方式:在配置阶段明确报错,并在错误信息中给出修复方法。
没有使用真实的 provider client,也没有使用真实 LLM。让一个假的 client 发出一次 tool call,足以证明这个接入点能够拦截调用,但不足以证明整个循环在一个频繁交互的模型下也能正常运转。
没有测试 streaming、transform verdict,也没有测试 approval resolver。Verdict.escalate 的含义是附带审批元数据的拒绝;在我的运行中,没有人批准任何操作。
文档说明,托管的、由 provider 执行的工具,永远不会经过框架的工具接入点。pre_tool_call 阶段的拒绝,无法阻止 provider 自行执行的工具——这是已经说明的限制,不是我发现的 bug。
只测试了一组版本:agent-framework-core==1.21.0 + agent-hooks-sdk==0.1.0b2,日期为 2026-10-14。两者都处于实验阶段,API 也明确说明了这一点。
在工具边界执行以美元计价的策略,确实可行,也确实生效了——840 美元的退款在进入函数体之前就被拦下,完全符合发布公告中的说法。但公告中的安装命令不能按原样奏效,而自己接线时出现的失效也可能是静默的。要看记录流,不能只看那一行日志。
这套契约本身与框架无关,同样的演示也涵盖了 LangGraph、OpenAI Agents SDK、Semantic Kernel、LlamaIndex、CrewAI 和 Claude Agent SDK。如果有人在其中一个框架上重新运行我的这两个场景,并得到不同的决策流,那才是值得继续追踪的结果——同一套契约,八个宿主框架,而我只检查了其中一个。
如果要进一步采取行动,你可以考虑屏蔽此人和/或举报滥用行为。