
8.0
热点
AI SCORE
编程提效2026-10-16 03:45
将低频流程移入 Claude Code 按需技能
dev.to · AI#Claude Code#技能#上下文管理
Editor brief · 编辑速览
文章以发布说明流程为例,将常驻 CLAUDE.md 的长指令拆成 SKILL.md、脚本与参考文件。启动时仅加载技能名称与描述,正文及辅助材料按任务需要读取。
书籍:Prompt Engineering Pocket Guide
我的另一本作品:Thinking in Go(两册系列)——Go 编程完全指南 + Go 中的六边形架构
我的项目:Hermes IDE | GitHub——面向使用 Claude Code 和其他 AI 编程工具交付软件的开发者的 IDE
关于我:xgabriel.com | GitHub
打开你的 CLAUDE.md,往下翻。在构建命令后面的某个地方,应该有一节叫“发布版本”:怎么找到上一个 tag、哪些 commit 类型要忽略、标题按什么顺序排列、用什么语气来写。这四十行内容,你可能一个月只用两次。但每次会话的每一轮对话,它们都占着 context window,哪怕你整个下午都在修一个 CSS bug。
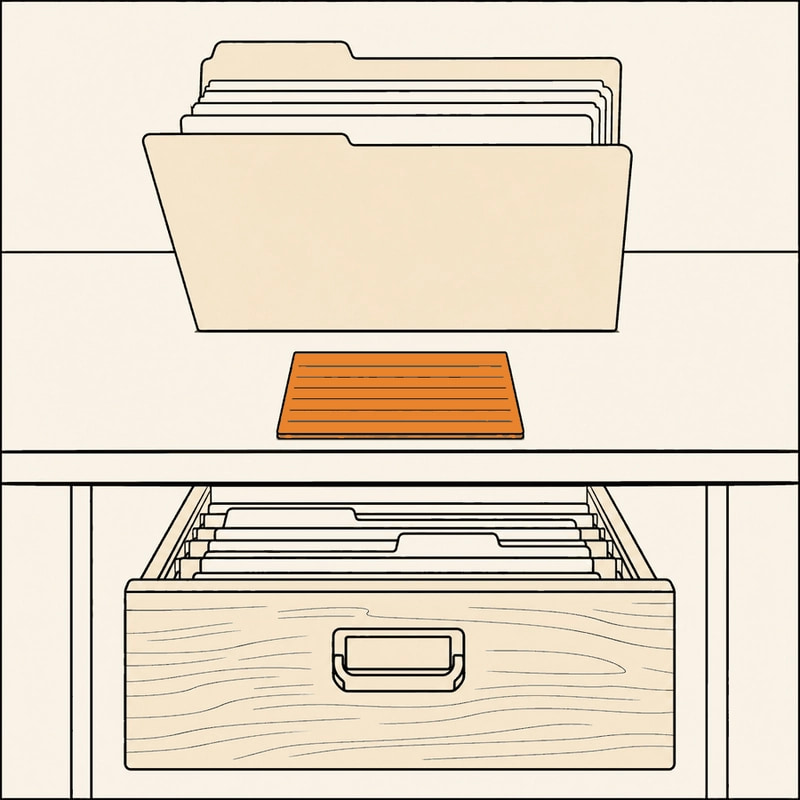
CLAUDE.md 的设计就是如此。Claude Code 会在每次会话开始时读取它,而同一份文档也建议:每个文件尽量控制在 200 行以内,把“多步骤流程”移到 skill 中。skill 的正文会一直留在磁盘上,直到 Claude 判断当前任务需要它。预先进入上下文的,只有名称和一段描述。
把这套流程移到一个 Claude Code skill 中:一个 SKILL.md、一个随附脚本,再加上一份只有在编写发布说明时才会加载的风格参考。
Anthropic 的 Agent Skills 概述将 skill 分为三个层级,每个层级在不同的时机加载:
脚本还能进一步节省上下文。Claude 运行随附脚本时,只有脚本的输出会进入上下文,代码本身不会。因此,确定性的工作,比如列出 commit、给 commit 分组,应该交给脚本;需要判断的工作,比如哪些 commit 是用户关心的,则应该写在 markdown 中。
在把所有内容都搬出 CLAUDE.md 之前,有一点需要注意:skill 一旦被调用,它的内容就会在本次会话剩余时间里一直留在对话中,而且 Claude Code 不会在后续轮次重新读取这个文件。因此,节省的是那些完全不涉及发布的会话。在真正发布版本的那次会话中,从 skill 触发的那一刻起,正文就会占据上下文。
始终摆在桌上的,只有索引卡。文件夹和抽屉,等任务需要时才打开。
项目级 skill 放在 .claude/skills/<name>/SKILL.md,个人 skill 放在 ~/.claude/skills/<name>/SKILL.md(参见 skills 文档)。这里使用项目目录,让 skill 随代码仓库一起分发:
.claude/skills/release-notes/
├── SKILL.md
├── reference/
│   └── style.md
└── scripts/
    └── commits.sh
先写脚本。它会找到上一个 tag(也可以通过参数指定),列出从那以后所有非 merge commit,并在每行前面标注对应的 Conventional Commits 类型,这样模型就不用自己解析前缀了:
#!/usr/bin/env bash
# Usage: commits.sh [from-tag]
# Prints "<type>\t<hash> <subject>" for each commit
# since the tag, grouped by type.
set -euo pipefail

from="${1:-}"
if [ -z "$from" ]; then
  from="$(git describe --tags --abbrev=0 2>/dev/null \
    || true)"
fi

if [ -n "$from" ]; then
  echo "# commits since $from"
  range="$from..HEAD"
else
  echo "# no tag found, listing all commits"
  range="HEAD"
fi

git log "$range" --no-merges --pretty='format:%h %s' |
  awk '
    { type = "other" }
    $2 ~ /^feat(\(.*\))?!?:/ { type = "feat" }
    $2 ~ /^fix(\(.*\))?!?:/  { type = "fix" }
    { print type "\t" $0 }
  ' | sort -s -k1,1
git describe --tags --abbrev=0 只输出从 HEAD 可达的最近一个 tag,也包括轻量 tag。|| true 则避免尚无 tag 的仓库触发 set -e,导致脚本退出。
接下来写风格参考。这就是之前放在 CLAUDE.md 里的那四十行,只保留模型无法自行推断的要求:
# Release notes style

## Headings
Use these, in this order, and skip empty ones:
### Features, ### Fixes, ### Other

## Bullets
- Start with a past-tense verb: "Added", "Fixed".
- Describe the effect for the user, not the code.
- End with the short hash in parentheses: (a1b2c3d).
- A `!` right before the colon marks a breaking change.
  List it first under its heading, prefixed **Breaking:**.

## Leave out
- Refactors with no visible effect.
- Dependency bumps, unless they fix a security issue.
然后编写 SKILL.md,把两者串起来:
---
name: release-notes
description: >-
  Drafts user-facing release notes from the git commits
  since the last tag, grouped into Features, Fixes and
  Other. Use when the user asks for release notes, a
  changelog entry, what shipped since a version, or a
  summary of changes for a release. Not for single
  commit messages or PR descriptions.
---

# Release notes

1. Get the commits by running:
   `bash "${CLAUDE_SKILL_DIR}/scripts/commits.sh" [tag]`
   Pass a tag only if the user named one.
2. Read [reference/style.md](reference/style.md)
   before writing anything.
3. One bullet per user-visible change. Merge commits
   that describe the same change. Drop chore, ci, test
   and docs commits unless the user asks for them.
4. Reply with Markdown only. Edit CHANGELOG.md only
   if the user asks you to.
>- 是标准 YAML 语法:它会把后面缩进的多行折叠成一个字符串,让较长的 description 保持易读,也避免其中偶然出现的冒号破坏解析。
${CLAUDE_SKILL_DIR} 是 Claude Code 提供的替换变量,会被填入 skill 自身所在的目录,因此无论当前工作目录在哪里,脚本路径都能正常使用。名称必须由小写字母、数字和连字符组成;在 Anthropic 的其他产品界面中,名称还不能包含 "anthropic" 或 "claude"。参考文件直接从 SKILL.md 链接过去,只隔一层,因为最佳实践指南提醒:如果通过一连串引用才能找到某个文件,Claude 可能只会读取其中一部分。
你也可以使用 skills 文档中的内联 shell 语法,把脚本直接嵌进去:一个感叹号,后面跟着用反引号包裹的命令。命令会在 Claude 看到 skill 之前执行,并把输出插入其中。文档指出,命令一旦失败,整个调用就会中止;而这里的 tag 参数又是可选的,所以让 Claude 自己运行脚本更简单。
Claude Code 会监视 skill 目录,在会话期间发现新增或修改过的 skill。如果会话开始时 .claude/skills/ 还不存在,Claude Code 就尚未监视这个目录:运行 /reload-skills 让它发现这个 skill,并在本次会话后续每次修改后再次运行该命令,或者直接开启新会话。
在一个至少有一个 tag 的仓库中开启新会话。先问 What skills are available?,这是故障排查指南给出的检查方法之一。列表中应该能看到 release-notes。如果它出现在列表里,却始终不触发,就检查 YAML:当 frontmatter 解析失败时,skill 仍然会加载,但元数据为空,因此 /release-notes 可以使用,Claude 却没有 description 可供匹配。运行 claude --debug 查看解析错误。有一种很容易踩到的情况:单行 description 没有加引号,却包含了冒号后紧跟空格的内容。
接着,分别用应该触发和不应该触发的 prompt 来测试:
标记为“No”的那些行才尤其有用。它们与 skill 使用相同的词汇,比如 commit、git、tag,但仍然应该在不调用 skill 的情况下处理。如果让它写 commit message 的 prompt 也触发了 skill,就说明 description 写得太宽泛。
要看清 skill 带来了什么变化,先建立一份基准。在 .claude/settings.local.json 中用 skillOverrides 将它关闭,在新会话中运行相同的 prompt,然后移除覆盖配置:
{
  "skillOverrides": {
    "release-notes": "off"
  }
}
至于上下文开销,/context 中的 Skills 行会报告应用预算限制后 skill 列表的大小,因此与模型实际收到的内容一致;/skill-doctor(Claude Code v2.1.252 或更新版本)则会报告每个 skill 的上下文开销和调用次数。手动测试五个 prompt,就能发现明显的漏触发和误触发。如果想测试更多,文档中的 skill-creator 插件可以生成应该触发和不应该触发的 prompt,测量命中率,并提出 description 修改建议。使用 /plugin install skill-creator@claude-plugins-official 安装。
进门时,检查的只有 description。正文能不能加载,正文自己没有发言权。
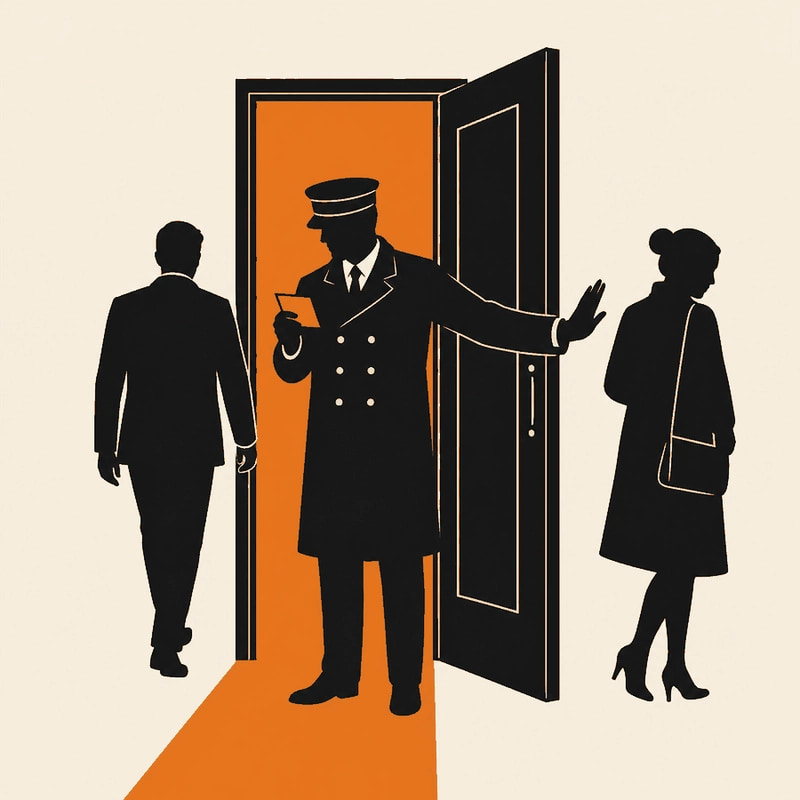
在 skill 被选中之前,SKILL.md 中 frontmatter 以下的所有内容都是不可见的。选择完全依据 description;Anthropic 的概述说,Claude 会将“你的请求与它进行匹配”。description 写得含糊,正文再好也没有运行的机会。
说清做什么,以及什么时候用。最佳实践指南要求同时包含这两点:skill 的功能,以及使用它的触发条件。“帮助处理发布”两点都没说清。“根据上一个 tag 之后的 commit 起草发布说明。当用户要求编写发布说明、changelog 条目时使用……”则给了模型一个明确的任务,以及一组可供匹配的表达。
使用第三人称。description 会被注入 system prompt,指南提醒,“我可以帮你”或“你可以使用这个”之类的措辞,可能导致 skill 发现机制出现问题。“起草发布说明”从任何视角读都成立。
使用用户实际会输入的词。没人会要求“一份发布产物摘要”。他们会问“1.4 之后发布了什么”,或者“写一下 changelog”。把这些表达放进去。对于不触发的 skill,文档给出的第一步排查方法,就是检查 description 是否“包含用户自然会说出的关键词”。
把最关键的使用场景放在最前面。在 Claude Code 中,列表里的 description 和 when_to_use 文本合并后,默认会在 1,536 个字符处截断。超出部分根本不会传给模型,因此最重要的那句话要放在前面。
整个列表也有预算限制,默认是模型 context window 的 1%。如果 skill 很多,列表超出预算,Claude Code 就会从调用次数最少的 skill 开始,整段移除 description。新 skill 的调用次数从零开始,因此很容易率先被移除。检查 /context 中的 Skills 行,并在 skillOverrides 中将低优先级 skill 设为 "name-only",腾出空间。
明确边界。“不用于单条 commit message 或 PR 描述”是本教程的设计选择,并非文档规定。如果某类相近请求总是误触发 skill,这句话就有价值。文档针对过度触发给出的解决办法,是让 description 更具体;明确排除某些场景,就是其中一种做法。
遵守可跨产品使用的限制。在 Claude API 和 claude.ai 中,description 必须非空、最多 1,024 个字符,而且不能包含 XML 标签。Claude Code 自己的文档只提到列表在 1,536 个字符处截断,但把 description 控制在 1,024 个字符以内,就能让 skill 兼容这些产品。
如果你只希望在自己明确要求时才生成发布说明,就在 frontmatter 中加入 disable-model-invocation: true。这样,description 会完全退出上下文,skill 也只会在你输入 /release-notes 时运行。这是上下文开销最低的选项;对于带有副作用、希望手动触发的操作,这也是合适的选择。
如果某条规则必须每次都生效,比如“没有运行测试,绝不推送 tag”,就不该把它放在 skill 里。文档建议使用 hook,因为无论 Claude 是否遵循某个 skill,只要对应事件发生,hook 就会运行。CLAUDE.md 仍然应该存放每次会话都需要的信息:构建命令、项目布局、约定。其他内容都可以留在磁盘上,等请求需要时再读取。
skill 的 description 是一个只承担一项任务的 prompt:让 skill 在正确的请求下被选中。Prompt Engineering Pocket Guide 重点讨论的,正是这类 prompt 的写法:表达具体,选择模型能够匹配的词,并且既测试命中,也测试未命中。如果你正在精简一份已经膨胀成手册的 CLAUDE.md,同样的方法也适用。
如果需要进一步采取行动,可以考虑屏蔽此人和/或举报滥用行为。