
8.0
热点
AI SCORE
编程提效2026-10-15 20:14
发现 AI 擅自决策:简单审查胜过复杂流水线
dev.to · AI#AI编程#代码审查#成本优化
Editor brief · 编辑速览
作者尝试用隔离计划信息的流水线,发现 AI 实现中未经需求确认的业务决策,但在两个案例中,直接让模型对照计划审查代码取得了相当的检出量和更高精度。简单方案约一分钟完成,成本约为原方案的七分之一,结论仍受样本量限制。
简而言之:我花了几周时间,搭建了一条 pipeline,专门找出 AI 编程 Agent 在没有告知你的情况下自行做出的决策。它的核心理念是:读取代码的一方绝不能看到计划。后来,我终于做了那个一直拖着没做的对比实验:只用一条 prompt,让模型对照计划审查代码。在我的两个测试用例上,这条 prompt 找出的静默决策和 pipeline 一样多,精确率更高,耗时约一分钟,成本大约只有七分之一。下面聊聊这个想法、pipeline 的工作方式,以及它为什么输了。
你写了一份计划,AI Agent 按照计划实现。代码很干净,所有测试都通过了。但在代码的某个地方,Agent 自行决定:每天最多取款 5,000,金额采用四舍五入,也就是 round half-up;重复开立一个已经存在的账户时,什么都不做。这些规则,计划里一条都没写。
我把这些称为“静默决策”。单独看,每一条都很合理。Agent 总得选一种处理方式,于是它没有询问,就自己选了。
测试发现不了这些问题,因为测试同样来自对同一份计划的同一种理解。如果 Agent 决定拒绝透支,它写的测试就会检查透支是否被拒绝。整套测试自洽,但你要等到部署之后,才会发现当初选错了。
代码审查也不能可靠地发现这些问题。审查者带着对计划的理解去读代码,一条看起来合理的规则,很容易就被当成原本的设计。很少有人会追问:“这件事真的有人决定过吗?”
Traycer 的 verification pass、Qodo 的 ticket compliance 这类计划符合性检查,都是从计划出发,问的是:代码有没有做到要求的事?我想反过来问:代码做了哪些根本没人要求它做的事?
这意味着,待检查的行为必须从代码中提取,而不是从计划中提取。计划告诉你原本想做什么,代码才是实际构建结果的唯一记录。
问题的形式也随之改变。“这份计划漏写了什么?”是一个开放式搜索,搜索范围涵盖所有可能需要明确规定的内容。“这段代码做了 40 件事,其中哪些能在计划中找到依据?”则是两份具体列表之间的匹配问题。匹配结果是可以核查的。
关键在于,描述代码的人不能读过计划。否则,他们就会用计划里的措辞描述代码,每个决策看起来都会像是有意为之。所以,负责描述代码的一方必须处于盲态。
整条 pipeline 都建立在这个假设之上。但正如你接下来会看到的,数据并不支持它。
这个工具叫 silent-decisions。它在 Agent 完成实现之后运行,共分六步。计划直到第 4 步才会进入流程,而且即使到了这一步,任何模型一次也只能看到其中一句话。
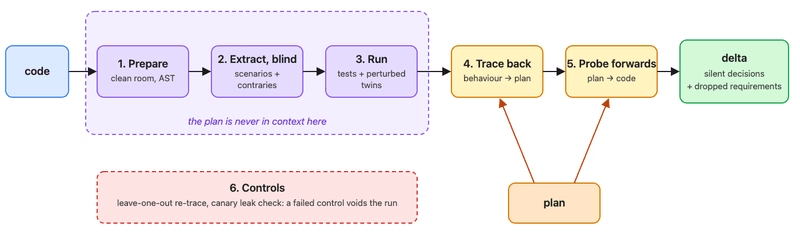
准备。 将源代码复制到一个“洁净室”中,移除注释、测试、文档和 git 历史。Agent 编写的代码经常会把计划带进注释里,例如 // per spec: reject overdrafts,这会破坏盲态。此外,再用一次普通的 AST 遍历,列出所有决策点:字面量、比较表达式、拒绝路径、舍入调用。
盲态提取。 让一个从未见过计划的新 Agent 读取洁净室中的代码,用包含真实数值的具体场景描述代码行为。每个场景还要附带一个相反结果:另一种同样合理的实现会给出的结果。
全部执行。 将每个场景转成测试并执行。每个测试还会搭配一个经过扰动的孪生测试,断言错误结果,而且这个孪生测试必须失败。最终留下的是经过验证的行为描述,而不是模型的意见。
回溯计划。 对每一组“计划语句、场景”配对,让一个只负责做决策的小型分类器——TypeSafe AI 的 Jev——回答一个问题:这句话要求代码当前的行为,要求相反行为,还是两者都没要求?每组问题问两遍,第二遍交换两个选项的位置;如果答案随着选项位置变化,就丢弃。一个场景如果找不到任何计划语句作为依据,就是静默决策。
正向探测。 为每一句规定行为的计划语句生成一个探测测试。如果探测失败,就说明代码遗漏了一项需求。
控制运行有效性。 隐藏几句计划语句,再重复回溯:原本依赖这些语句的行为,此时必须被判定为没有依据。再用一个 canary 字符串检查提取器是否确实处于盲态。只要有一项控制检查失败,这次运行就不算数。
最后,你需要审查的只有差异部分:静默决策和遗漏的需求。每一项都会变成一张卡片,请你做出选择:
每天最多取款 5,000
daily-limit。A. 代码当前的行为:拒绝取款,余额保持 6,000。
B. 另一种选择:接受取款;没有限额。
你选择 A 或 B,答案就会转成一条经过签署确认的回归测试。你只需要读少量决策,不必看完整个 diff。
如此复杂的 pipeline,只有在能发现更便宜的方法发现不了的问题时,才有意义。因此,我设计了六个实验组,让它们处理同一份计划和代码,再用同一份标准答案评分。
关键是 a 组和 b 组。如果一行 prompt 就能找出同样的决策,那其余这套机制就不值它的成本。c 组直接检验核心思路:使用相同的 pipeline,但允许提取器读取计划。如果盲态真的重要,c 组应该比 e 组表现更差。
测试包含两个用例,都是小型 TypeScript 账本程序,里面预先埋入了一些决策:
两个用例都是我这边编写的,其中大部分编写和运行工作由 AI Agent 完成。阅读下面所有结果时,请记住这一点。
我用五次运行开发这条 pipeline,也就是 e 组和 f 组;随后又在相同代码上运行了两次实验,测试 a 到 d 组。最后,对所有实验组的每份输出进行盲评:一个全新的模型会话拿到计划、代码、标准答案,以及打乱顺序、标为 L01 到 L13 的列表,但不知道每份列表由哪种方法生成。召回率是找出的预埋静默决策占全部预埋静默决策的比例。精确率是被标记的条目中,真正属于计划外决策的比例。
在更难的用例上,一分钟就能跑完的 prompt 追平了完整 pipeline。以下是 ledger-rounding 上按决策逐项进行盲评的结果,该用例包含 22 个预埋决策:
这里的成本是 Claude Code 针对 claude-opus-5-5 报告的 API 等价成本。实际消耗的是订阅额度。
在较小的 ledger 用例上,所有基于模型的实验组得分都在 0.90 到 1.0 之间,因此无法据此区分它们。两个用例中,每个实验组都找出了所有遗漏的需求。
f 组得零分是输出格式的问题,并不是它什么都没找到。它报告的是代码位置,比如“DAILY_WITHDRAWAL_LIMIT = 5000 这里有一个决策”,而不是具体规则;评分要求则明确规定,条目必须说清楚决策是什么。在之前一次更宽松的评分中,它大约得了 0.5。
有些细节比平均值更重要:
pipeline 确实能抓到 prompt 漏掉的问题。 “重复开立一个已经存在的账户时,什么都不做”这一条,prompt 在 12 次运行中漏掉了 11 次,而 pipeline 各组在 10 次运行中找到了 9 次。不过有一点需要说明:这恰好就是我在第 004 次运行后修复的漏检问题,而所有在较难用例上接受评分的 pipeline 运行,都发生在修复之后。
prompt 找出了更多标准答案之外的真实决策。 prompt 每次运行大约能找到 9 到 10 个,pipeline 则是 0 到 4 个。其中一部分差距,可能来自自由文本比可执行场景更容易被认可,但这个差距确实很大。
最难的决策,所有方法都漏掉了。 “转账不计入每日取款限额”这一条,所有实验组在每次运行中都没发现。这不是盲态提取特有的弱点。对任何读取这段代码的模型来说,它都很难发现。
盲评结果与我此前对 pipeline 的评分,每次运行最多只差一个决策。 所以,早先的结果并没有因为我自己评分而被抬高。
盲态没有带来帮助。 整个设计建立在一个假设上:读过计划的模型,会把代码描述成符合计划的样子,因此提取器绝不能看到计划。c 组检验的正是这一点,结果是,允许提取器看到计划的 pipeline,表现与盲态版本一样好,得分分别为 0.86 和 0.83。能看到计划的审查也没有照单全收地认可代码。它的精确率是所有实验组中最高的。
这套机制带来的是验证能力,而不是发现能力。 pipeline 报告的每个场景都实际执行过,它报告的每项遗漏需求也都由一个失败的测试确认。prompt 给出的判断则完全没有通过执行代码来核验。这当然有价值,也是那项始终多抓出来的问题的来源。但在这些用例上,这点价值抵不上七倍的耗时,以及七到十倍的成本。
这些局限确实存在,而且会向两个方向影响结论:
用例很小,而且是自己编的。 两个用例都只有一个约 140 行的文件,由我这边借助 AI Agent 编写,每条规则都明确体现为一个 if 或常量。这恰好是通读一遍最容易奏效的场景。在真实代码中,规则散落在多个文件里,结果可能不同。
只有一个模型评分者。 它不知道所评方法,但它终究是模型,不是人,而且各组的写法不同,有的是自由文本,有的是 Given/When/Then,因此它可能猜出某份列表属于哪类方法。
运行次数少,波动很大。 c 组和 d 组都只运行了一次。同一实验组的三次运行,召回率最多相差约 0.2。
a 组并不是真正的实现者。 它是一个全新会话,只是被告知代码是自己写的,并没有实际编写这段代码的记忆。
pipeline 已经在这些用例上经过五次运行调优。 prompt 完全没有调优,却仍然追平了它。
小用例的标准答案偏向 pipeline。 ledger 的 10 个决策里,有一半是在看过 pipeline 自己的输出后补进去的。只看最初的 5 个决策,所有基于模型的实验组都拿到了 1.0。较难用例只按最初的标准答案评分,因此文章的核心数字不受影响。
先跑最简单的基线。 我确实做了一个便宜的基线,但选错了:一个很容易被击败的静态扫描。真正重要的基线是一行 prompt。它运行约一分钟,就回答了那个 pipeline 调优五次都没能回答的问题。
先写下什么结果能证明自己错了,然后真的去跑。 我自己写的方法说明里就说过,如果 pipeline 赢不了一行 prompt,那就说明 prompt 足以胜任,这就是实验发现。结果,发现还真是如此。我本可以提前几周知道。
我会保留执行验证这一部分。 把每条判断转成实际运行的测试,再配上一个必须失败的孪生测试,这个做法每次运行都奏效。无论用什么替代 pipeline 的其余部分,“给我一个能跑起来的场景”,都是比“模型这么说”更好的审查单位。
别让 AI 给自己的作业打分。 一个 AI Agent 编写测试用例、运行实验、评分结果、提出修复方案,每项工作都做得很称职。但这些都无法告诉我,这个方法到底有没有用。真正给出答案的,是运行那个我一直回避的对比实验,再把所有实验组的输出打乱、隐去方法标签,交给一个不知道自己在评哪种方法的新会话盲评。
已发表的工作中,最接近的是 AssumptionMiner:它在能看到 prompt 的情况下,从 LLM 生成的代码中提取隐含假设,但不运行任何东西。b 组大致就是这类方法:一次能看到计划的审查。在这些用例上,它追平了 pipeline。
下一步可能应该做成一个 skill,而不是继续这条 pipeline:用一条设计得当的 prompt 完成一次审查,以 b 组的 prompt 为起点,再把执行验证作为可选步骤,用来核查它的判断。目前成本最低的实验,是把 b 组生成的列表送进 pipeline 的执行和探测步骤,看看能否得到与完整 pipeline 相当的已验证输出。
真正能让这件事有定论的,是独立用例:真实仓库,以及由没看过任何工具输出的人编写的标准答案。在这种场景里,规则分布更散,更难一次看全,盲态提取加执行验证或许仍然能领先。也可能不能。
代码、两个测试用例、标准答案,以及记录每次运行的日志,包括出错的地方,都放在 GitHub 上:rodrinobrega/silent-decisions。每次运行都有对应的 git 标签,也附上了盲评材料,任何人都可以重新评分。这是一个实验,不是产品。
如果需要采取进一步行动,可以考虑屏蔽此人和/或举报滥用行为。