
8.0
热点
AI SCORE
模型发布2026-10-16 00:35
Gemini 4 Argon 整合机器人控制与仿真
The Decoder#谷歌#机器人#多模态
Editor brief · 编辑速览
谷歌展示 Gemini 4 Argon 在机器人控制、从照片或草图生成仿真,以及评估训练视频上的能力,在自家 ERQA 基准上得分为 87%。公开示例提示词也显示,演示仍依赖较多人工指导。
Gemini 4 Argon 是 Google 尝试打造的一个统一 AI 模型,既能控制机器人,也能生成交互式 3D 训练环境,还能评估训练数据。
只需照片或草图等简单输入,这套系统就能构建仿真环境,让机器人在部署到现实世界之前练习动作。
这些演示仍然需要人类提供详细的 prompt 和指导。开发者可以通过 Google 的付费开发者访问计划使用 Argon。
Google 希望用 Gemini 4 Argon 这一个模型覆盖机器人开发的整个流程:控制机器人、构建虚拟练习环境,以及为训练视频评分。不过,示例 prompt 也暴露出,这个模型仍然需要人类提供大量细致指导。
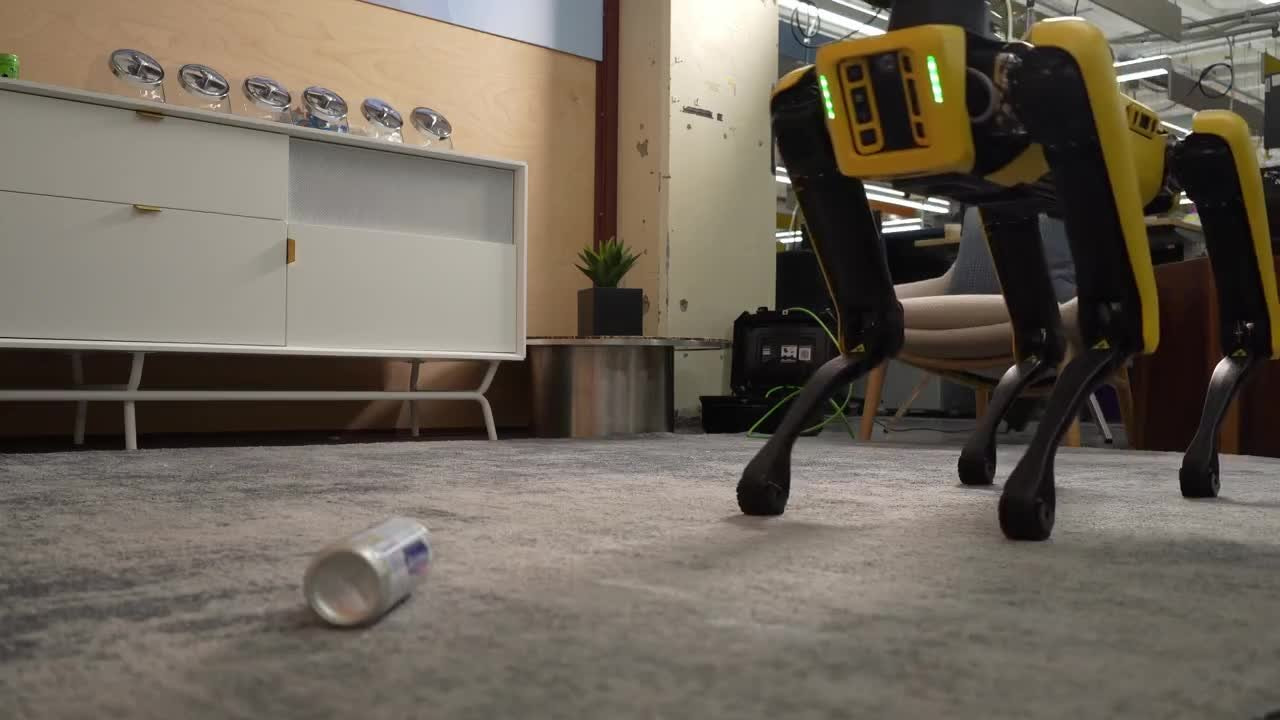
一台 Boston Dynamics Spot 机器人要把汽水罐扔进脚踏式垃圾桶。在它踩下真实踏板之前,Gemini 4 Argon 会先构建垃圾桶的虚拟副本,让机器人在仿真环境中练习用三条腿保持平衡。完成练习后,它才会在真实硬件上尝试这项任务。在机器人松开汽水罐之前,还会有两个额外的 AI Agent 检查脚部和夹爪的位置是否正确。
Google 就是这样展示其最新模型在机器人任务上的能力的。Argon 旨在更好地理解空间关系、编写控制代码,并从物理角度解读视频。Google 将这个模型视为一种通用工具,从控制单个机器人到复现已发表的研究,都在它的能力范围内。Google 称,这是迈向“physical AGI”的又一步;多年来,Google 及其 AI 子公司 DeepMind 一直在追求这一目标。
在 MuJoCo 仿真环境中练习完整动作流程后,Gemini 4 Argon 控制 Spot 捡起汽水罐,踩下踏板,并将罐子扔进垃圾桶。| 图片:Google
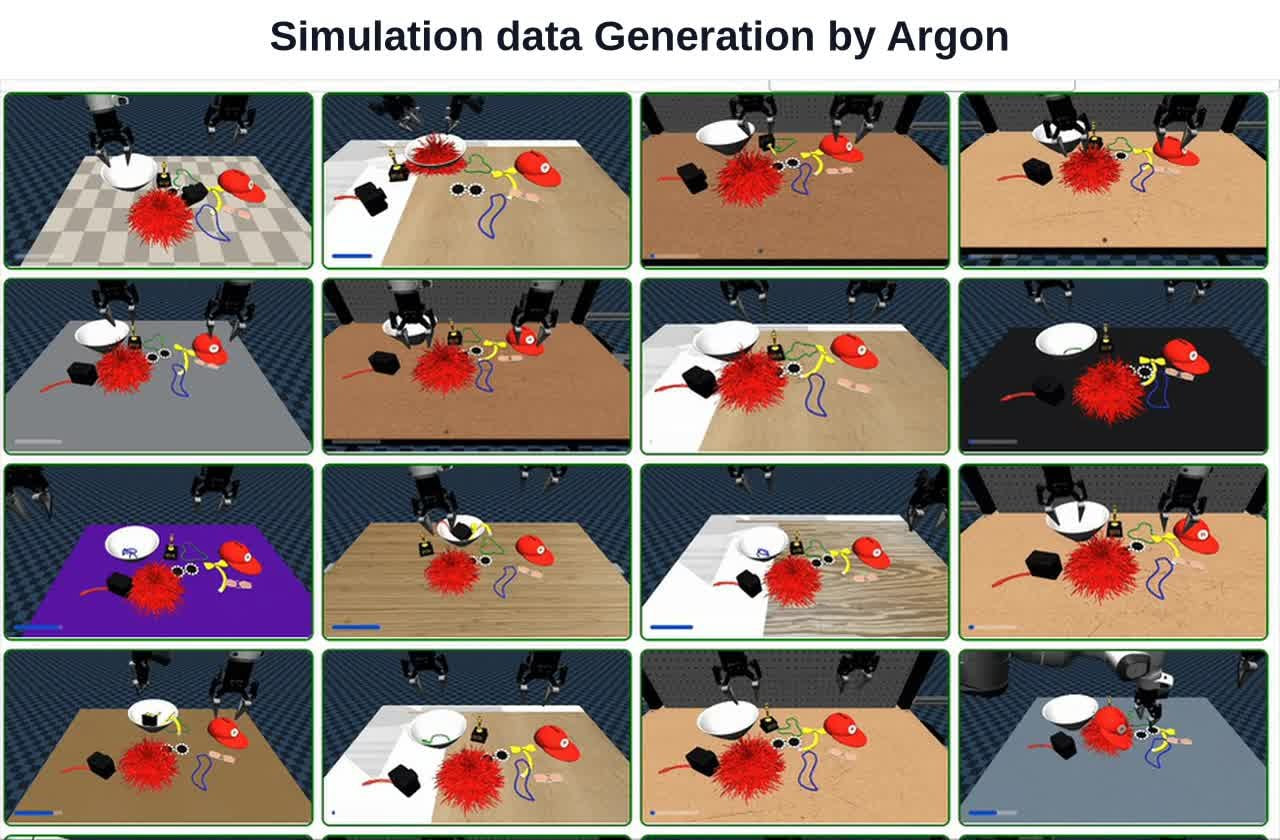
Spot 演示采用了一种在 Google 许多示例中反复出现的模式:Argon 用仿真来准备任务、验证任务,或生成训练数据。仅凭一张摆着派对道具的桌面照片,模型就构建出了虚拟副本,其中甚至包括一顶柔软的毛绒帽子。它设计了 77 项任务,从扶正倒下的物体到清理桌面,并为一个控制模型生成了超过 4,500 个训练回合。在真实机器人上测试时,任务成功率从 56% 提升到了 75%,执行时间则从 35 秒缩短到了 24 秒。
仅凭一张照片,Argon 就能生成超过 4,500 个不同的仿真回合,将真实机器人的成功率从 56% 提升到 75%。| 图片:Google
Argon 也能使用其他来源的输入。根据一段遥操作机器人的录像,它可以构建仿真环境,尽可能还原画面中的外观,并复现指尖处相同的力传感器读数。根据一段人类执行抓取任务的第一视角视频,模型则能把手部和手指动作映射到一个拥有五指双手的虚拟人形机器人上。
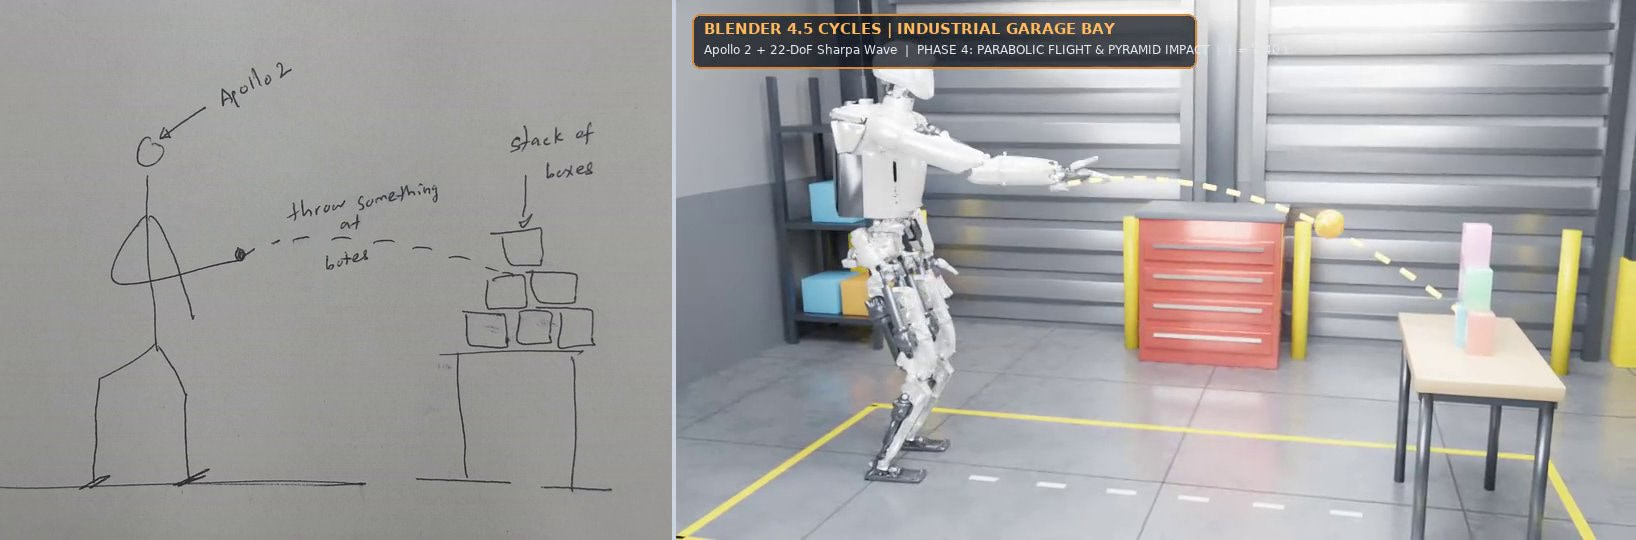
甚至用圆珠笔画的草图也可以。一张图画着人形机器人用球击倒一堆呈金字塔形排列的箱子,Argon 将它转化成仿真环境,并计算出投掷动作,在机器人不失去平衡的前提下,击倒全部六个箱子。
根据一张简单的手绘草图,Argon 构建出仿真环境,让人形机器人在保持平衡的同时,一次投掷就击倒全部六个箱子。| 图片:Google
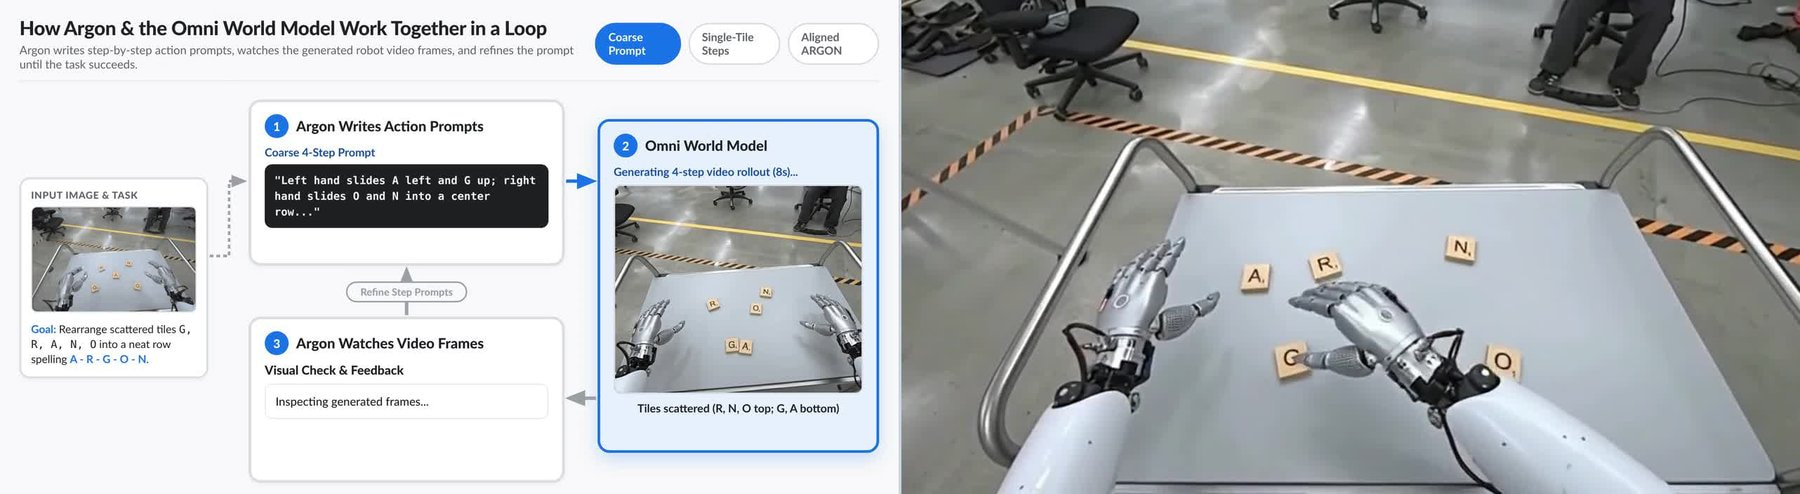
有一个演示完全发生在 AI 生成的视频中。Gemini Omni 是一个视频世界模型,可以生成片段,展示场景中的某个事件会如何改变场景,而 Argon 则担任导演。它会编写带时间戳的指令,描述双手应该执行什么动作,比如将一枚 Scrabble 字母牌滑到桌面中央。Gemini Omni 根据这些指令生成视频,然后 Argon 检查其中的单帧画面,调整下一条指令。任务目标是将五枚散落的字母牌排列成“ARGON”,经过 33 步操作,字母牌终于排成了正确顺序。
Argon 逐步指挥视频世界模型 Gemini Omni,直到机器人双手将字母牌排成 ARGON。| 图片:Google
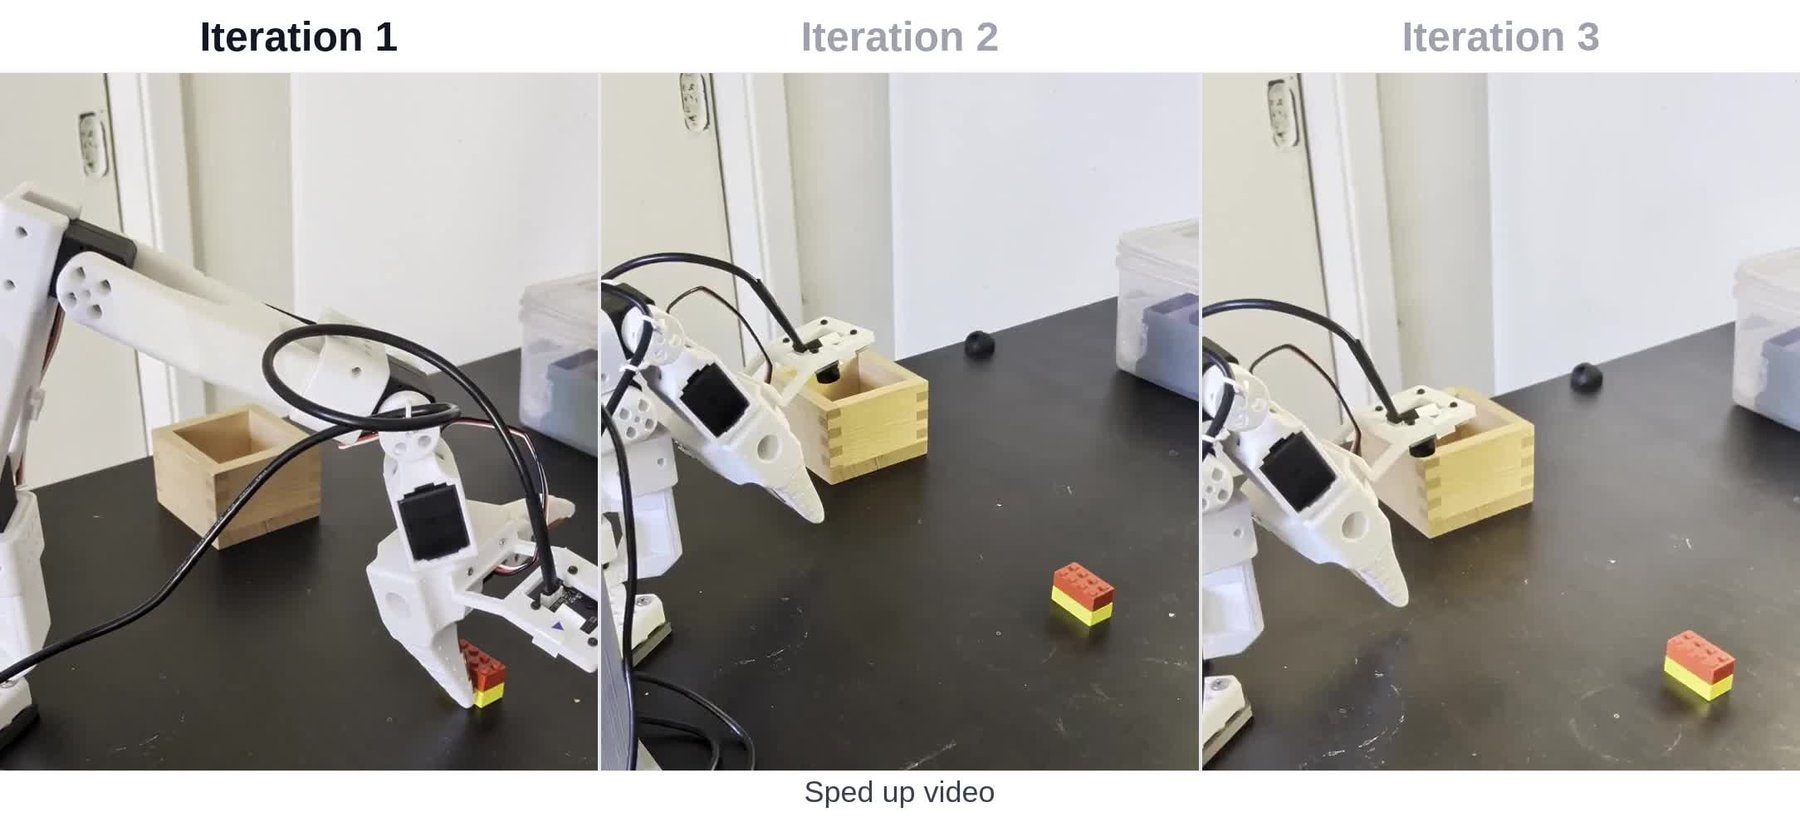
在另一个使用简单机械臂的演示中,Argon 需要把一块 Lego 积木放进木盒,并逐步改进自己的表现。尝试失败时,prompt 会要求 Argon 检查自己的日志和摄像头图像,找出原因,在应用经过验证的修复方案后重试。第一次执行耗时接近一分钟,第二次快了很多,只用了 23 秒,不过积木碰到了盒子的边缘。第三次尝试时,积木在约 17 秒后准确落在了盒子正中央。
经过三轮迭代,Argon 将机械臂的执行时间从 58.9 秒缩短到 17.4 秒,并在最后一次尝试中准确命中盒子中央。| 图片:Google
Google 也希望 Argon 能用于科研。每篇论文只需提供一条 prompt,它就能将已发表的机器人实验复现为可在浏览器中运行的交互式仿真。Google 表示,目前已经构建了 68 个这样的沙盒,其中包括机器人足球,以及踩着滑板的人形机器人。
ERQA(Embodied Reasoning Question Answering)基准测试用于衡量 AI 模型理解和解决 3D 环境中物理与空间问题的能力。这项测试包含 400 道题,不允许使用辅助工具,因此模型必须完全依靠推理作答。根据 Google 公布的数据,Argon 得分为 87%,领先所有其他前沿模型。排名第二的 Claude Opus 5.5 得分为 82.3%,落后约五个百分点。GPT-6 Astra 以 81% 紧随其后,Claude Fable 5.1 则为 74%,落后 Argon 13 个百分点。
根据 Google 的数据,在衡量空间和物理推理能力的 ERQA 基准测试中,Gemini 4 Argon 领先 Claude Opus 5.5 约五个百分点。| 图片:Google
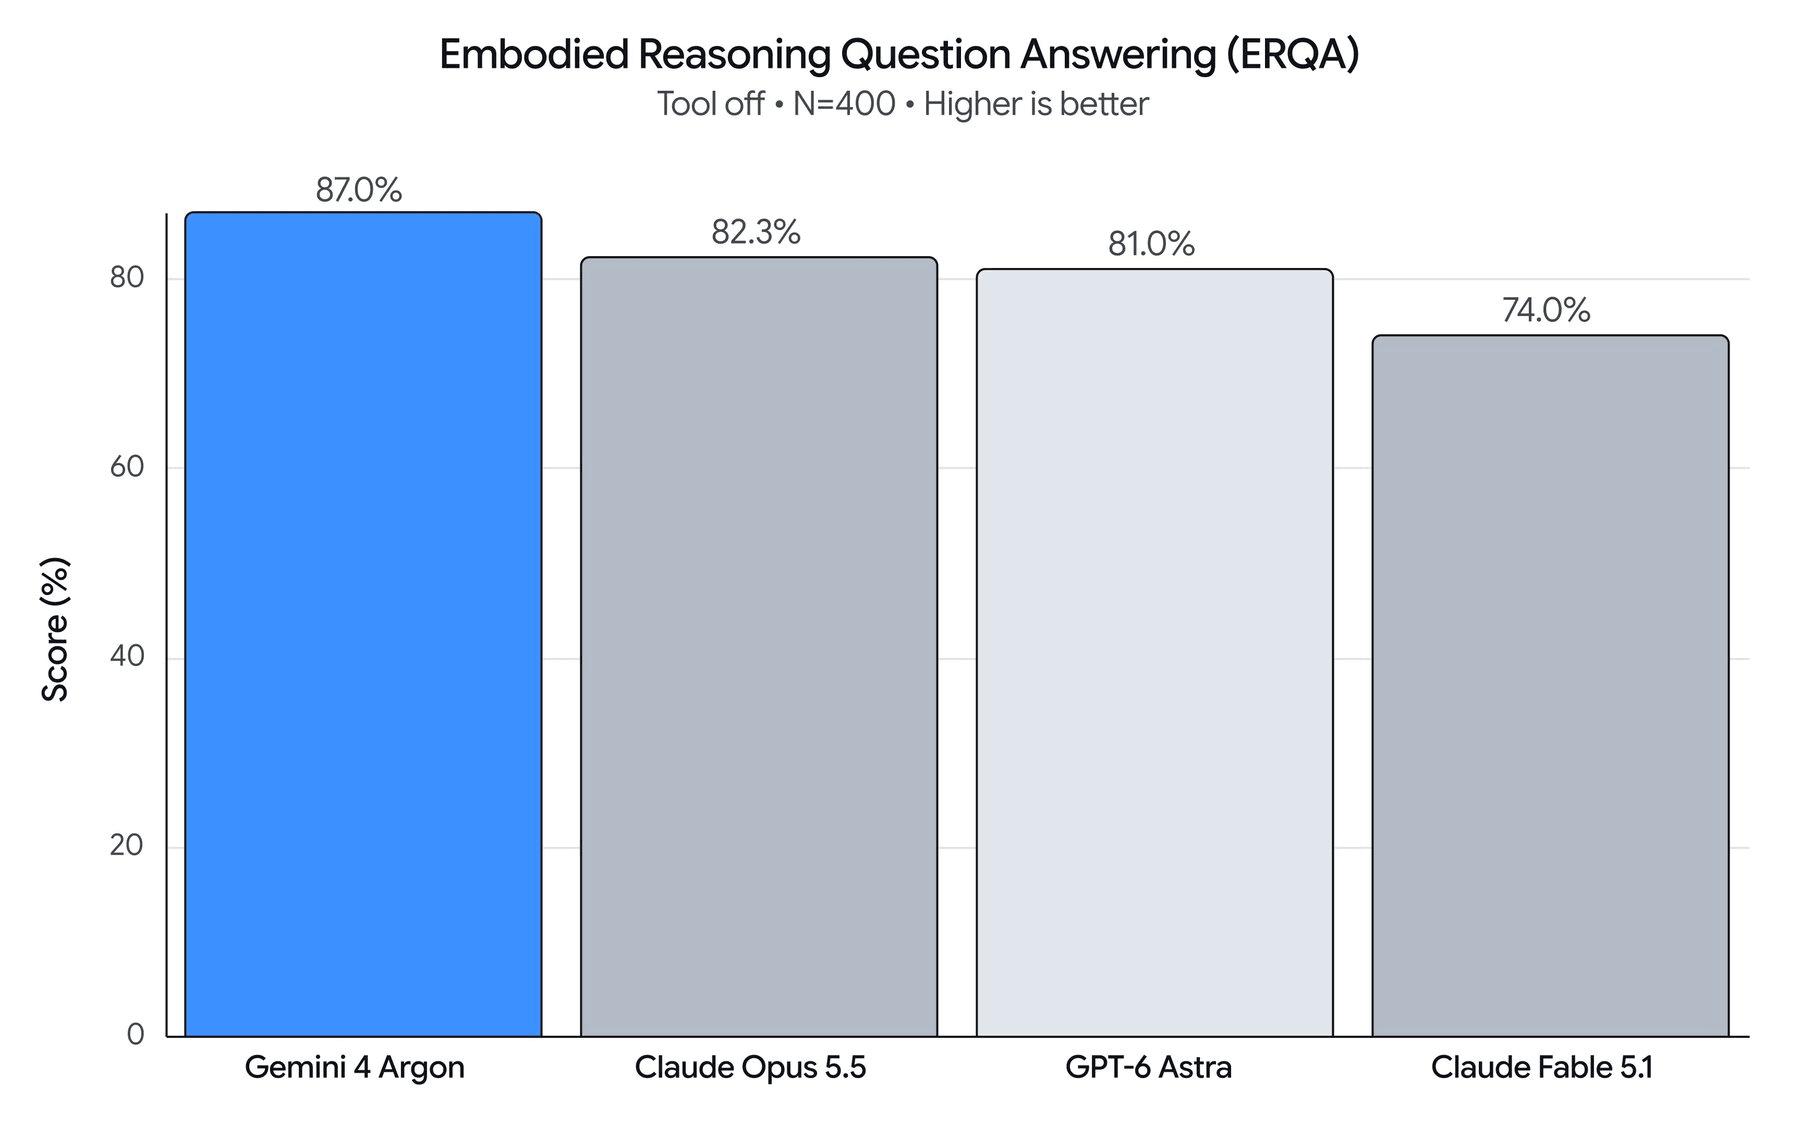
一天后,Artificial Analysis 发布的 AA-Robotics 基准测试却呈现出另一番结果。在这项测试中,语言模型需要直接控制真实机械臂完成八项任务。Argon 在满分 100 分中拿到 55 分,排名第三,落后于获得 69 分的 GPT-6 Astra 和获得 65 分的 GPT-6.1 Sol。
除了控制机器人和构建仿真环境,Argon 还被设计用于评估训练数据。在一段两分多钟的视频中,一台双臂机器人用纸折出一只狐狸,模型将整个过程拆分为多个子步骤,并标记出停顿和抓取失误。这些片段在训练中的权重随后会被降低。在另一段人类给圆环分类的视频中,Argon 则追踪了任务在哪些地方取得进展、陷入停滞,或者出现倒退。
Google 还展示了一个更有趣的用例,围绕一道经典称重谜题展开:十二个外观完全相同的球中,有一个比其他球更重或更轻。Argon 构建了一个包含两条机械臂和一架天平的仿真环境,仅凭摄像头图像判断天平的倾斜情况。它最多称重三次,就能找出那个重量异常的球。
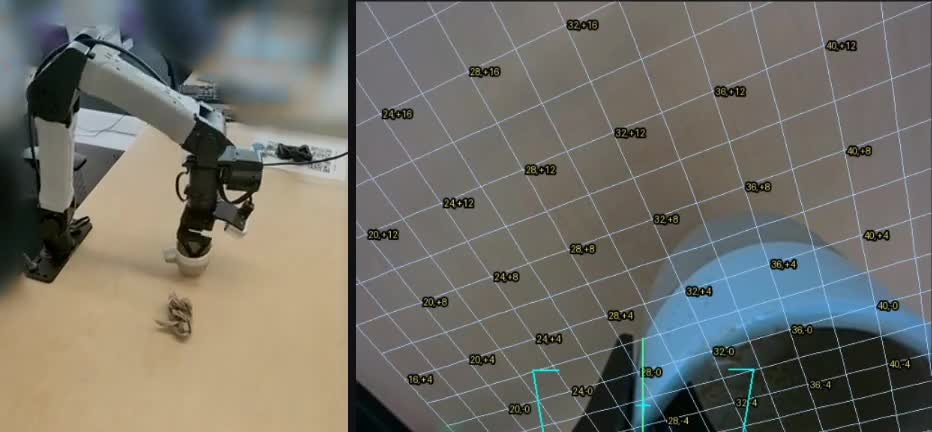
Google 公布了这些演示所用的详细示例 prompt,它们也让一些宏大的说法有了更具体的参照。在被描述为“zero-shot”的扶正倒扣杯子任务中,Argon 收到的是一张叠加了厘米网格的摄像头图像,以及“grasp”“lower until contact”等预先构建好的命令。对于仿真任务,prompt 还包含长长的禁止事项清单,防止模型走捷径,比如直接复制测得的传感器数值。Google 没有在博客文章中公布各个演示的失败率,而对于 75% 的成功率,也没有说明它基于多少次尝试得出。
在没有事先训练的情况下,Argon 借助摄像头图像中的坐标网格引导,扶正倒下的杯子,并将一张餐巾塞进杯中。| 图片:Google
Argon 现已在 Google AI Studio 和开发环境 Antigravity 中开放,但仅限 Google AI Ultra 订阅用户使用。开发者也可以通过 Gemini API 的付费层级访问这个模型。
就在几天前,Google 刚刚在全球发布 Gemini 4 Argon。在机器人领域,该公司此前已经推出了用于空间感知和任务规划的 Gemini Robotics-ER 1.6。在虚拟环境中训练也不是新鲜事:初创公司 World Labs 展示过如何将真实场景转化为虚拟训练环境,Nvidia 的 DreamDojo 则以视频形式模拟机器人动作。Google 这套方案的不同之处,在于它希望用同一个模型包办仿真、控制和评估。
订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻通讯、每年六期的独家“AI Radar”前沿报告、完整历史文章访问权限,以及评论区访问权限。