
9.0
重磅
AI SCORE
模型发布2026-10-15 23:00
英伟达扩充智能体模型,覆盖云端与本地
NVIDIA Blog#英伟达#智能体#本地部署
Editor brief · 编辑速览
英伟达发布开放的 1200 亿参数 Nemotron 3.5 Super VL,面向持续运行的专用智能体。同期推出两款 Bolt 边缘模型,分别面向 24GB 和 4GB 内存配置,覆盖本地智能体工作负载。
NVIDIA 今日发布 Nemotron 3.5 Super VL。这款拥有 1200 亿参数的开放模型,面向专用、持续运行的 Agent,提供最快的任务完成速度和最高的准确率。
一同亮相的还有两款全新的边缘模型:Nemotron 3.5 Bolt 74B-A9B 24GB,针对本地 Agent 工作负载,优化每 GB 内存下智能水平与速度的平衡;以及 Nemotron 3.5 Bolt E4B 4GB,针对快速对话 Agent,优化每 GB 内存所能提供的智能水平。
Super VL 和 Bolt 74B-A9B 现已推出,Bolt E4B 将于 10 月 23 日发布。这三款开放模型共同覆盖了从大型企业服务器,到边缘设备和本地硬件的各类 Agent 部署场景。
如今,任何希望在 NVIDIA 基础设施上运行 Agent 的组织,都能找到针对相应硬件层级优化的开放模型,无需在模型能力与部署可行性之间取舍。
Super VL 和 Bolt 加入 Nemotron 家族,与 Lightning 和 Ultra 并列。
8 月发布的 Lightning 负责高吞吐量工作负载;Ultra 负责最具挑战性的推理任务;Bolt 则将智能带到边缘端。
Super VL 与 Nemotron Coalition 合作构建,在多模态 Agent 任务上展现出领先的准确率,包括指令遵循、工具使用、多步骤业务工作流和视觉理解。它以约五分之一的参数量,达到了可与 NVIDIA 最大推理模型媲美的表现。
Nemotron 3.5 Super VL 面向大规模 Agent 工作流,在同类模型中提供前沿水平的智能。
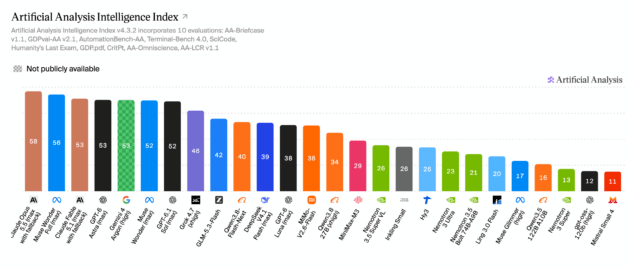
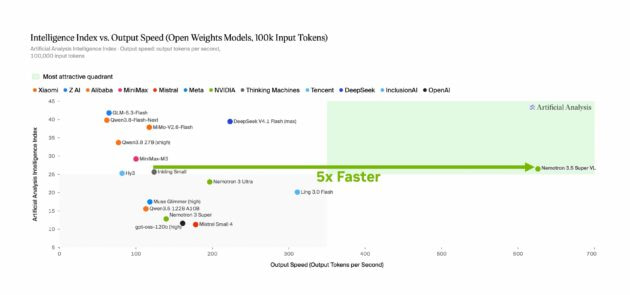
作为同类中速度最快的开放 Agent 模型,它的速度是排名第二的模型的 5 倍,能够帮助企业 Agent 更快完成大量任务,覆盖持续数天乃至数周的工作流。
在 Artificial Analysis Intelligence Index 排行榜上,Nemotron 3.5 Super VL 的吞吐量最高可达其他同类模型的 5 倍。
与封闭的前沿模型不同,组织可以使用自己的数据对 Super VL 进行后训练,将其部署在自己的基础设施上,并对基于它构建的系统进行监督。
Bolt 74B-A9B 24GB 专为在 NVIDIA RTX/DGX Spark 上本地运行日常 Agent 任务而设计。它采用原生 2-bit 量化,能够装入 24GB 内存,并与其他应用同时运行。
与内存占用相近的其他模型相比,它在智能水平和速度之间取得了良好的平衡:能力足以完成大多数工作,速度又远快于智能水平最高的那些模型。
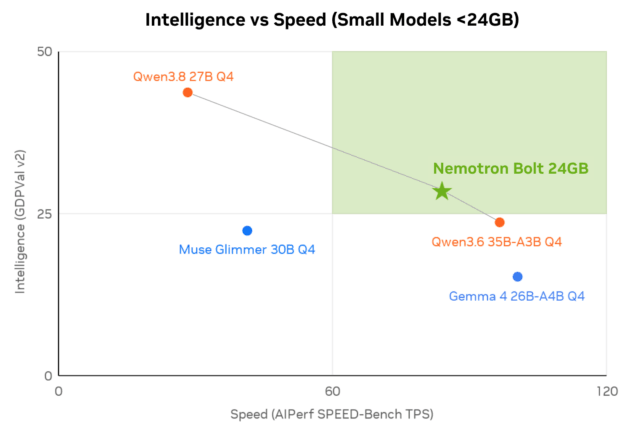
使用 Bolt 74B-A9B 24GB,用户可以把项目交给主流的本地 Agent 运行框架,从网络调研到代码编写、调试,都无需将这些工作负载发送到云端。它在 PinchBench 上位列同类开放模型第 1,在 BrowseComp 上位列开放模型第 2。Bolt E4B 4GB 则面向运行在 GeForce RTX、Jetson 和 RTX/DGX Spark 上的物理 Agent 与对话 Agent。它将自然对话与多轮 Agent 能力相结合,为快速响应的本地语音助手、交互式角色和嵌入式界面提供支持。
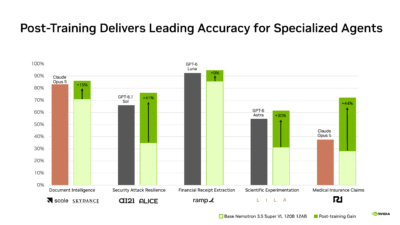
各行各业已有数十家组织,正在使用自己的数据、工具、政策和工作流对 Super VL 进行后训练,以进一步提升其在专用任务上的准确率。这些任务正是各家 Agent 部署的核心。
各行业的组织都在对 Super VL 进行后训练和定制。Scale AI 为 Skydance 的供应商信用融资 Agent,以及 EY 的并购尽职调查 Agent,对模型进行了后训练。AfterQuery 为 Hebbia 定制了模型,用于信贷协议分析。AI21 和 Alice 对模型进行了后训练,以增强其抵御网络安全攻击的能力。Mercor 在 APEX-SWE 编码基准上对模型进行了后训练,用于能够规划、编写和调试代码的编码 Agent。ModelScope 则通过其 ms-swift 框架,支持开发者为专用多模态应用微调模型。
其他定制 Nemotron 3.5 Super VL 的组织还包括:将其用于金融文档智能处理的 Ramp;将其用于主权 AI 驱动的网络安全研究和漏洞分析的 Dream;将其用于科学发现和检索的 Lila Sciences;以及将其用于医疗理赔分析和收入周期管理的 R1。TrainLoop 使用 Nolla 的皮肤科数据对模型进行了后训练。Nolla 刚刚成为首家获准由 AI 为患者开具初始处方的公司。正在集成 Nemotron 3.5 Super VL 的软件平台公司包括:
Nemotron 3.5 Super VL 的视觉语言能力,重点针对 Agent 在实际工作中会遇到的内容:光学字符识别、表格、图表,以及可视化文档中的结构化信息。
它可以处理网页、提取文本、读取各类图形和图表,并根据发现的内容给出洞见。同样的能力也适用于 PDF,以及 Agent 经常处理的其他文档。
Nemotron 3.5 Super VL 能理解图像、网页和 PDF,并基于这些理解采取行动。将文本理解和视觉理解整合到同一个模型中,意味着 Agent 无需在独立系统之间分派任务。当工作从文档处理推进到数据分析,再到决策时,上下文可以始终保持连贯。
开放性与可定制性相互促进。该模型提供开放权重、开放数据集和训练配方。
控制权体现在两个方面。组织可以根据自身安全和数据驻留要求,决定模型的运行位置;同时,也可以选择一个能够自行调整的模型,而不必受制于供应商的限制。
例如,在保险行业,定制 Agent 可以反复扫描理赔材料,查找欺诈迹象。在金融服务领域,Agent 可以审查信用评分,并依据组织自身的放贷标准标记相关活动。模型保留在本地,数据保持私密。
NVIDIA NeMo、基于 Python 的流水线和开放数据集为模型定制提供支持。
Nemotron 3.5 Super VL 在预训练和持续预训练阶段,总共使用了约 26 万亿个 token;随后,使用约 380 万个样本,并在数十个环境中结合强化学习进行后训练。
NVIDIA 还在 Hugging Face 上发布了开放数据集,覆盖 Agent 工具使用、金融、指令遵循、长上下文、公平性和视觉语言理解,同时发布了 NeMo Gym 中的强化学习环境。
NVIDIA NIM 将模型封装为可用于生产环境的微服务,提供经过性能优化和验证的配置,以及企业级支持,并且每两周更新一次,包含安全补丁和性能改进。
当模型运行在 NVIDIA Dynamo 上时,组织可服务的用户数量最高可达原来的 8 倍,延迟降低 85%。
Nemotron 3.5 Super VL 现已在 Hugging Face、Open Router、ModelScope 社区上线,同时以 NVIDIA NIM 的形式提供。
Nemotron 3.5 Super VL 可运行于 NVIDIA 的完整硬件产品栈:在 DGX Spark、DGX Station、RTX PRO 和 RTX 系统上提供桌面端本地智能,在 NVIDIA Jetson 上提供边缘端智能,也可运行于数据中心和云环境。
Nemotron 3.5 Bolt 74B-A9B 24GB 现已在 Hugging Face 上提供,支持 llama.cpp、Ollama、LM Studio、Unsloth 和 vLLM。它专为 10 月 16 日上市的 NVIDIA RTX Spark 笔记本电脑打造,也可以运行在 GeForce RTX PC、DGX Spark、DGX Station 和 RTX PRO 工作站上。
下载开放权重,通过 NVIDIA NeMo 探索定制资源,或阅读技术博客,了解完整的架构解析。
订阅 NVIDIA 新闻、加入社区,并在 LinkedIn、Instagram、X 和 Facebook 上关注 NVIDIA AI,及时了解 Agent、NVIDIA Nemotron 等领域的最新动态。
探索可按自己的节奏学习的视频教程和直播内容。
请参阅有关软件产品信息的声明。