
8.0
热点
AI SCORE
编程提效2026-10-16 03:42
Copilot 多模型编排需累计计算调用费用
dev.to · AI#Copilot#多模型#成本
Editor brief · 编辑速览
据文章介绍,Copilot 的 HydraFusion 会为单次任务选择执行模式、推理强度及参与模型,并新增 Max 档位。它与每次选择一个模型的 Auto 模式不同,费用按实际参与模型各自的标准费率计算。
书籍:System Design Pocket Guide: Interviews(系统设计口袋指南:面试篇)
系列:Pocket Guides for Developers(开发者口袋指南)——8 本短书,涵盖 Agent、RAG、prompt、可观测性、事件、数据库和系统设计——以上是整个系列。
我的项目:Hermes IDE | GitHub——一款面向使用 Claude Code 和其他 AI 编程工具交付软件的开发者的 IDE。
关于我:xgabriel.com | GitHub
你在 Copilot 的模型选择器里选中一个选项。背后却是一个模型先写初稿,其他模型再评判或审查,最后你才看到一个答案。
这个选项就是 HydraFusion。10 月 14 日,GitHub 为它更新了模型池:Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna。同时还新增了一个档位:HydraFusion Max。计费规则写在 GitHub 的文档里:它每调用一个模型,你就要按该模型的标准费率付费。
HydraFusion 不是一个模型。GitHub 文档将它称为运行时模型编排器。对于每个 prompt,它会选择执行模式和推理强度,挑选模型,最后返回一条回复。Copilot 的 Auto 模式每次请求选择一个模型;HydraFusion 则会选择一套工作流,在单轮交互中协调多个模型。
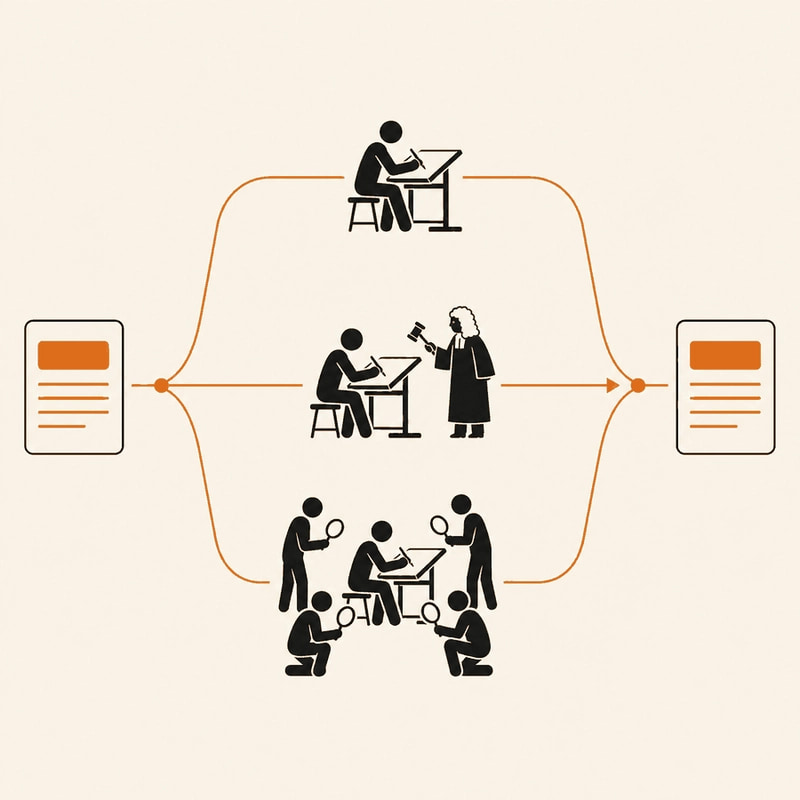
文档列出了三种模式。Single 把任务交给一个模型。Cascade 先让一个高效模型起草,再由评判模型决定接受初稿还是升级处理。Critique 则让一个模型起草,多个模型并行审查,然后由起草模型修改一次。
10 月 14 日的更新日志列出了四项变化:
HydraFusion Max 使用相同的架构和工作流,但推理强度更高,面向更复杂的任务。文档还补充说,Max 提供 extra high 推理强度。
两者目前都处于研究预览阶段,可在 VS Code、GitHub Copilot app 和 Copilot CLI 中使用,支持 Copilot Pro、Pro+、Business 和 Enterprise,但需要开启实验性功能或预览功能。GitHub 文档明确写道:“HydraFusion 不适用于生产工作负载。”
一个 prompt,三条可能的执行路径:Single、Cascade 或 Critique。你只会看到最终答案。
HydraFusion 本身不额外收费,但也不享受 Auto 模型选择的折扣。它调用的每个模型都按各自的标准费率计费。GitHub 文档还指出,由于一个任务可能运行多个模型,单个任务消耗的 AI credits 可能高于只使用一个模型时的消耗。
所以,同一个 prompt 的花费可能相差很大。Single 的成本大致相当于调用一个模型;Critique 则要支付起草模型、每个审查模型以及修改初稿的费用。主对话会尽可能留在同一个模型上,以便复用缓存的 token。这能限制额外开销,但无法消除它。
文档中还有两条对预算很重要。你无法指定 HydraFusion 使用哪些模型;它只会调用你的套餐包含、且组织策略允许的模型。如果没有符合条件的模型,它根本不会出现在选择器里。
上下文窗口是另一个容易踩的坑。文档说,HydraFusion 没有自己的上下文窗口;它显示的窗口大小,取决于其模型中最小的上下文上限。如果你的对话已经超过这个限制,就要先压缩上下文,再切换过去。
GitHub 在 9 月 4 日发布 HydraFusion 时,公布了与 Claude Opus 5 对比的离线测试结果:
看这些结果时,要把它们的局限一起考虑进去。这些结果来自受控的离线运行,绑定了特定的 benchmark 版本、工作流配置、模型池和定价假设。CheckpointBench 是 GitHub 内部的 benchmark,成本数字也是估算值,并非实际账单数据。只有 TerminalBench 显示质量有所提升,另外两项都是牺牲少量质量,换取更低的费用。
而且,这些结果描述的是 9 月的配置。10 月 14 日的模型池和各阶段推理强度已经不同,更新日志也没有公布新的数据。Omdia 分析师 Torsten Volk 对 TechTarget 表示:“每项编程任务都用 LLM,往往在经济上算不过账。”
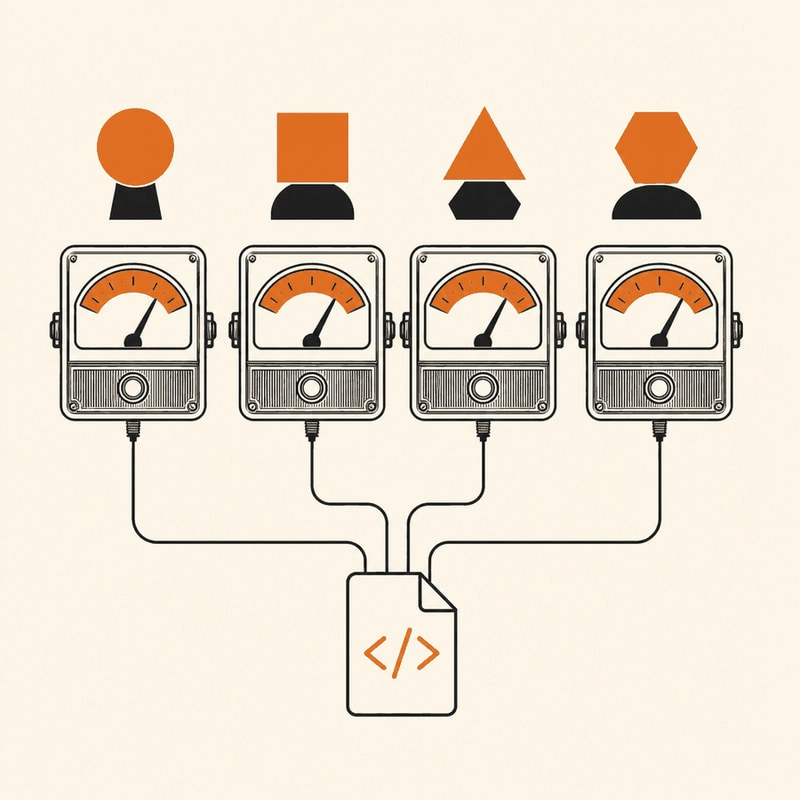
HydraFusion 不收额外费用,但它调用的每个模型都有自己的计费表。
文档中有一个限制,比 benchmark 更值得关注。当一份初稿被丢弃时,它已经在工作区中做出的改动,比如文件编辑,不会自动撤销。最终答案可能来自升级处理后的模型,但被否决的初稿所做的修改,仍然留在磁盘上。
所以,给它一个可以随便折腾的分支。按照文档,在 Copilot CLI 中先用 --experimental 启用,再通过 /model 选择。把这些操作放到一个 git worktree 里执行:
git worktree add ../app-hydra -b try/hydrafusion
cd ../app-hydra
copilot update
copilot --experimental
# in the session: /model -> HydraFusion (Research Preview)
对于一次性 prompt,文档给出的命令是 copilot --experimental --model hydrafusion -p "YOUR-PROMPT"。在 VS Code 1.140 或更高版本中,开启 chat.copilot.hydraFusion.enabled,再从 Copilot Chat 的模型下拉菜单中选择它。
提交这个分支里的任何内容之前,先运行 git status 和 git diff,逐一检查每个文件,包括最终答案从未提到的文件。文档也提出了同样的要求:提交之前审查改动。
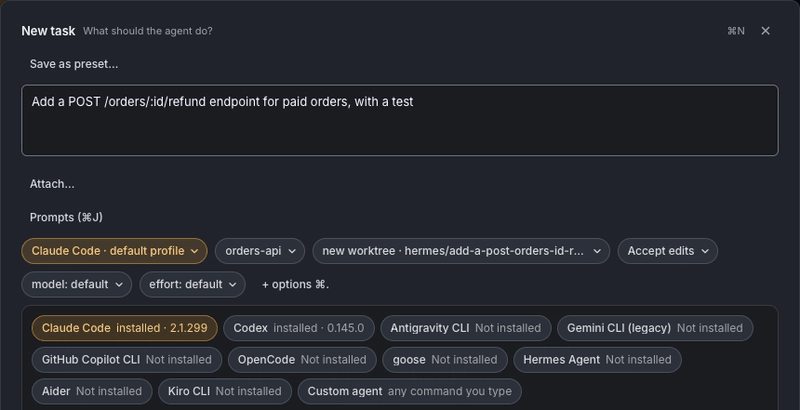
Hermes IDE 是我开发的,所以阅读这一节时,请把这层关系考虑进去。GitHub Copilot CLI 是 Hermes 可以在真实终端中打开的 Agent 之一,与 Claude Code、Codex 等工具并列,你也可以添加任意命令行 Agent。按下 ⌘N,每个任务都会在各自的 worktree 中,使用独立的 hermes/<name> 分支启动。这正是应对“被丢弃的初稿仍会留下修改”这一限制所需要的隔离方式。
要在这里使用 HydraFusion,先启动一个 GitHub Copilot CLI 任务,输入 /experimental on,再按 GitHub 文档的说明重启 Copilot CLI,然后从 /model 中选择 HydraFusion。把同一个工单交给第二个 worktree 中的 Claude Code,就能比较模型路由器与单个模型生成的 diff。我自己还没有运行过 HydraFusion。
Hermes 2.3.4 的 Agent 选择器:Claude Code 和 Codex 显示为已安装,GitHub Copilot CLI 和其他支持的 Agent 也列在其中,此外还有 Custom agent。
Hermes 免费,采用 BSL 1.1 许可证开放源代码,支持 macOS、Windows 和 Linux。它与 GitHub、Anthropic、OpenAI 或 Nous Research 没有关联。
如果你已经订阅 Copilot Pro 或更高套餐,并且开启了预览功能,试用它只需要改一个设置、建一个分支,再支付每次运行消耗的 credits。找一个你已经手动完成的任务,分别交给 HydraFusion 和一个你信任的单模型运行,然后比较 diff 和 credits 消耗。这比 GitHub 的表格更能说明问题。
如果路由器每调用一个模型都要向你收费,你还愿意让它决定哪些模型可以修改你的代码吗?欢迎在评论区聊聊。
HydraFusion 是系统设计权衡的一个缩影:什么时候升级处理,什么时候花钱征求第二意见,以及一次廉价的初次尝试失败后,会带来什么成本。System Design Pocket Guide: Interviews 通过 15 个真实设计案例,逐步讲解这些决策是如何做出的。它是 Pocket Guides for Developers 系列 8 本短书中的一本,整个系列涵盖 Agent、RAG、prompt、可观测性、事件、数据库和系统设计。如果你想让 Copilot CLI 和 Claude Code 围绕同一个工单比一场,Hermes IDE 可以为它们各自提供独立的 worktree。
如需进一步处理,你可以考虑屏蔽此人和/或举报滥用行为。