前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9915
  • LocalRAG 开源本地文档问答完整链路
  • Copilot群聊支持在同一对话处理多个仓库
  • Agent 执行工具前需要哪些安全关卡
  • 让 Claude Code 参考后端而不误改代码
  • Opus 快速模式开放,提速成本需细算
  • 让编程 Agent 看懂仓库依赖关系
  • 分类与抽取任务可让模型直接选答案
  • 为付费 API Agent 强制设置支出上限
  • n8n 长任务先响应,避免超时重试
  • Meta 新开放权重模型支持苹果芯片本地运行
  • 英伟达推出百万上下文开放多模态 Agent 模型
  • 用Claude Code做手机声波联机游戏
  • Google OAuth 支持刷新令牌密钥绑定
  • 将低频流程移入 Claude Code 按需技能
  • Copilot 多模型编排需累计计算调用费用
  • Gemini CLI 消费者登录退役带来的迁移提醒
  • 编码智能体自动放行配置可能成为攻击入口
  • 用事件钩子识别编码智能体何时等待操作
  • 并行编程 Agent 背后的 Git 工作树机制
  • Copilot 部分模型将于11月16日退役
  • NoteBank 用片段回放补强长上下文记忆
  • Meta 推出8160亿参数开放权重多模态模型
  • 两台 M5 Ultra Mac 可运行 Muse 开放模型
  • SageMaker 支持部署 Muse Spark Open
  • 谷歌 ADK 配方库贯通 Agent 开发部署
  • 为多轮 Agent 建立持续评估流水线
  • ctxtrim 压缩日志,节省编程上下文
  • 技能触发不准,先改好 description
  • AI 生成页面上线前,补验 GA4 事件链路
  • 让客服机器人把处理结果反馈到检索排序
  • Muse Spark Open 发布,主打编程与 Agent
  • FLUX 3 Klein 开放权重,8GB 显存可运行
  • Gemini 4 Argon 整合机器人控制与仿真
  • 英伟达开放多模态模型,面向企业智能体
  • Vercel 扩展后端与 Agent 部署能力
  • 英伟达发布面向智能体的多模态开放模型
  • 英伟达扩充智能体模型,覆盖云端与本地
  • 已加载 37 / 9915
8.0
热点
AI SCORE
技术实践2026-10-16 05:46

分类与抽取任务可让模型直接选答案

dev.to · AI#信息抽取#模型架构#结构化输出
Editor brief · 编辑速览

文章提出,在标签分类和文档字段抽取中,可让模型选择已有候选项或输入片段,减少自由生成带来的格式与取值偏差。这类指针式方法限制了答案范围,但不等于保证选择正确。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

你已经把答案给了 LLM。那它为什么还要从头写一遍?

把一张客服工单和四个标签发给模型,问它哪个标签最合适。它会逐个 token 写回 {"label": "billing"}。可“billing”这个词从一开始就在你的 prompt 里。

信息提取也是如此。发票号码就在 PDF 里,模型却要把它重新敲一遍给你。通常,它能敲对。

写作是一个循环,而写作者什么都能写

LLM 一次读完你的 prompt,再逐个 token 写出答案,每生成一个 token,都要再跑一遍模型。这也是输出比输入贵的原因:在 Anthropic 的价目表上,Sonnet 5.5 每百万输入 token 收费 2 美元,每百万输出 token 收费 10 美元。

对于一个简短的标签,成本并不是真正的问题。问题在于,写作者什么都能写:“Billing”、“billing_dispute”、“Sure! The label is billing.”。于是你得加上 parser、重试、schema。JSON mode 能帮上一些忙,但正如一篇指南所说,它是“对格式的约束,不是对正确性的保证”。

指针的工作方式不同。它只读一遍输入,然后给已经存在的内容打分:可以是你提供的每个标签,也可以是文档中每一个可能的文本片段。答案只能来自输入。
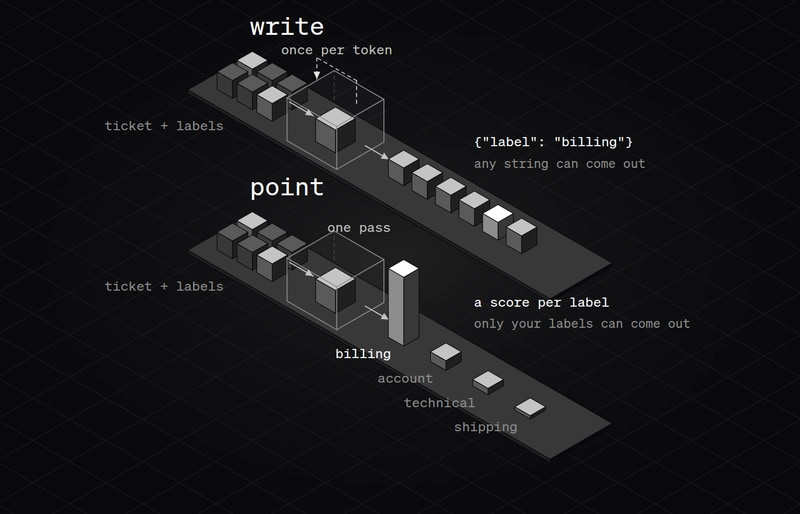
Two flows. Write: the input goes into a model that loops once per token and emits {

这并不是什么新思路。Pointer Networks(2015)就会选取输入中的元素作为输出。SQuAD(2016)把每个答案定义为“对应阅读段落中的一段文本”。BERT 的做法是给每个 token 打分,判断它作为答案起点或终点的可能性。直到今天,命名实体识别仍然会返回起始和结束偏移量。

ScaleDown 的 CDM 是什么

ScaleDown 于 10 月 13 日推出了四个小型任务模型,称为 Constrained Decoding Models。他们与 LangChain 合作发布的文章这样概括这个想法:“CDM 针对单一任务训练,只返回该任务允许的答案,比如你提供的列表中的一个标签,或输入中的文本片段。”

根据 ScaleDown 的文档:

Classify 按每个标签的评分标准为你的文本打分,返回 top_label,以及总和为 1.0 的各项分数。它负责指向答案。

Extract 返回“从输入中提取的原样文本片段”,同时提供置信度和起始、结束偏移量。它负责指向答案。

Summarize 做的是“流畅的改写,而不是挑选原文中的句子”。它负责写作。

Compress 用来压缩长上下文。文档没有说明它是挑选原文,还是重新改写。

所以,这个思路只适用于四个模型中的两个。关于命名还要说明一点:“constrained decoding”通常指屏蔽常规 LLM 的部分 token,让它无法违反你的 schema,比如 Outlines、XGrammar 的做法。在这里,它是一个产品名称。

真正的价值在于凭据

速度快当然好。更重要的是,指向原文的答案自带证据。如果 Extract 说发票号码位于第 8 到第 17 个字符,你就可以从自己的字符串中截取这一段,核对结果。而一个写出来的答案,即使有两位数字被调换,看起来也和正确答案没什么区别。
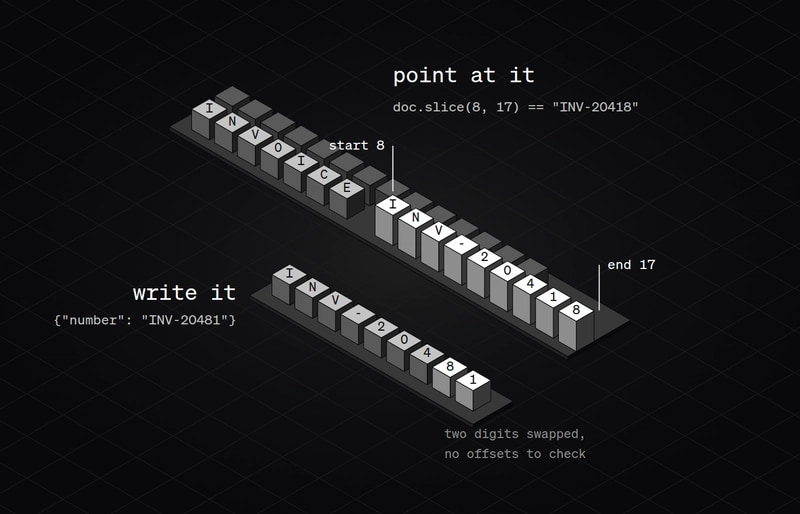
A made-up invoice line,

它们在应用中应该放在哪里

放在主 LLM 周围,辅助它工作。小模型处理日常任务,通用模型负责那些确实需要写作的事情。
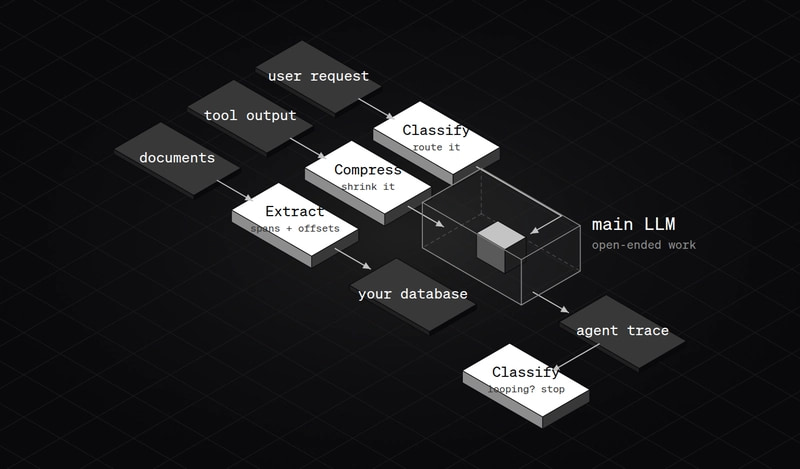
Architecture diagram. A user request goes to Classify, which routes it to the main LLM. Tool output goes through Compress before reaching the main LLM. The agent trace goes to a second Classify that checks for looping and can stop the run. Documents go to Extract, which writes spans with offsets into your database.

循环检测来自 LangChain 的示例:当 Classify 给“looping”的评分超过 0.8 时,就停止运行。但这只有在 0.8 这个分数对你的数据有实际意义时才有效。ScaleDown 没有公布校准数据,而且 Classify“总会返回一个胜出标签,即使模型并不确定”。因此,要加上一个 other 标签,并用几百条你自己的样本进行评估。

Jev、OpenAI 和 Cloudflare 做到了其中一半

TypeSafe 的 Jev、OpenAI 的 Decisions API 和 Cloudflare 的 Clef 都能回答有明确类型的问题,并给出概率。这对应的是 Classify 的那一半。它们都没有在文档中说明支持指向文本片段。
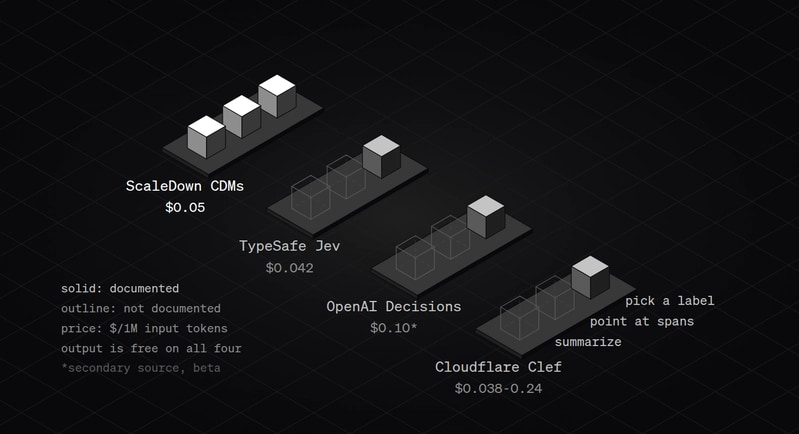
Four small platforms, one per API, each with three slots: pick a label, point at spans, summarize. ScaleDown CDMs fills all three, $0.05 per million input tokens. TypeSafe Jev ($0.042), OpenAI Decisions ($0.10, secondary source, beta) and Cloudflare Clef ($0.038 to $0.24) fill only pick a label; the other two slots are empty outlines for not documented. Output is free on all four

指向答案做不到什么

答案必须存在于输入中。“这张发票上一共有多少件商品?”需要做加法。指针没有可以指向的答案。

标签合法,不代表标签正确。它也可能指错。

Summarize 会写作,Compress 则没有说明。不要以为“无法凭空编造文本”这一特性也适用于它们。

那些亮眼的数字来自 ScaleDown 自己。推文声称速度快 200 倍、成本低 467 倍。ScaleDown 自己的基准测试文档则声称,准确率提高 8% 到 19.5%,速度提高到 2.2 倍至 13.9 倍。这两组说法目前都还没有经过独立验证。

你的文本会离开自己的服务器。这是一项托管 API 服务。

想深入了解?可以阅读那篇带有交互示例的详细博客:smiit.in/writing/answer-is-in-the-input

Jev:不会说话的 AI,以及为什么这恰恰是它的价值所在

你的 AI 编程会话,每多发一条消息就会更贵。原因在这里。

你的哪些 LLM 调用,其实是在做选择题?欢迎在评论区告诉我。

如果需要进一步处理,你可以考虑屏蔽此人和/或举报滥用行为。

Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
让编程 Agent 看懂仓库依赖关系
下一篇
为付费 API Agent 强制设置支出上限