
8.0
热点
AI SCORE
模型发布2026-10-16 00:09
英伟达开放多模态模型,面向企业智能体
The Decoder#英伟达#多模态#Agent
Editor brief · 编辑速览
英伟达发布面向企业智能体的开放多模态模型 Nemotron 3.5 Super VL,参数规模为 1200 亿,同时推出两款面向本地设备的紧凑型 Bolt 模型。已有数十家组织开展 Super VL 微调,报道同时指出其性能发挥依赖英伟达硬件。
Nvidia 发布了 Nemotron 3.5 Super VL,这是一款拥有 1200 亿参数的开放多模态模型,面向企业场景中的 Agent 任务和文档分析。
两款更小的 Bolt 变体面向本地设备:一款经过大幅压缩,适用于内存容量至少为 24 GB 的系统;另一款 4 GB 版本面向语音助手,将于稍后推出。
Nvidia 在发布模型权重的同时,也公开了数据集和训练方法,但所有优化都围绕自家硬件展开,以此带动芯片和系统销售。
Nvidia 发布了 Nemotron 3.5 Super VL,这是一款拥有 1200 亿参数、面向企业 Agent 的开放多模态模型。与它一同亮相的还有两款紧凑的 Bolt 模型,旨在将 AI Agent 带到本地 PC 和边缘设备。
Nvidia 为持续在后台运行的专用 Agent 打造了 Nemotron 3.5 Super VL,让它们能够处理文本、图像、文档和视频。
据 Nvidia 在技术博客中的介绍,该模型采用 Mixture-of-Experts 架构,1200 亿参数中,每个 token 只激活 120 亿参数。Nvidia 与 Nemotron Coalition 共同开发了这款模型,联盟成员包括 Mistral AI、Thinking Machines Lab、Perplexity 和 Black Forest Labs。
另外两款面向本地硬件的小模型也在同期发布之列。Nemotron 3.5 Bolt 74B-A9B 24GB 用于在本地设备上执行 Agent 任务,更小的 Bolt E4B 4GB 则面向快速响应的语音助手,将于本月晚些时候推出。Nvidia 声称,这两款模型都能提供“每 GB 内存所能承载的最高智能水平”。
Super VL 和 Bolt 加入了现有的 Nemotron 产品线。其中,8 月发布的 Lightning 主打高吞吐量,Ultra 则负责高难度推理任务。所有变体都针对 Nvidia 硬件进行了优化。
在 Artificial Analysis 的综合排名中,Super VL 与领先的闭源模型仍有明显差距,但超过了 Nvidia 自家的 Nemotron 3 Ultra。| 图片:Nvidia
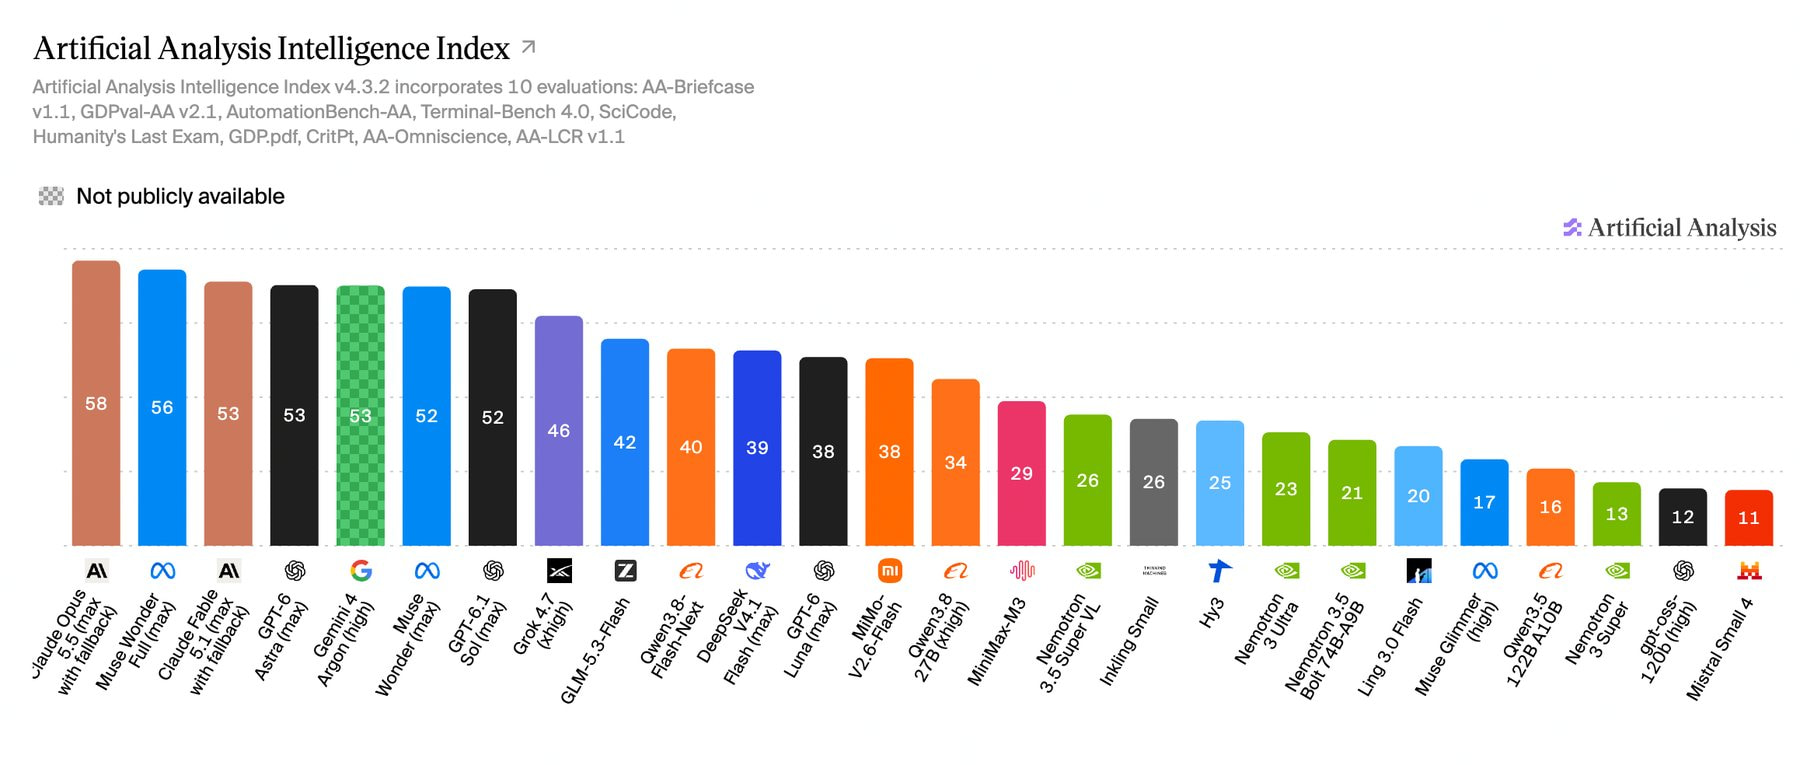
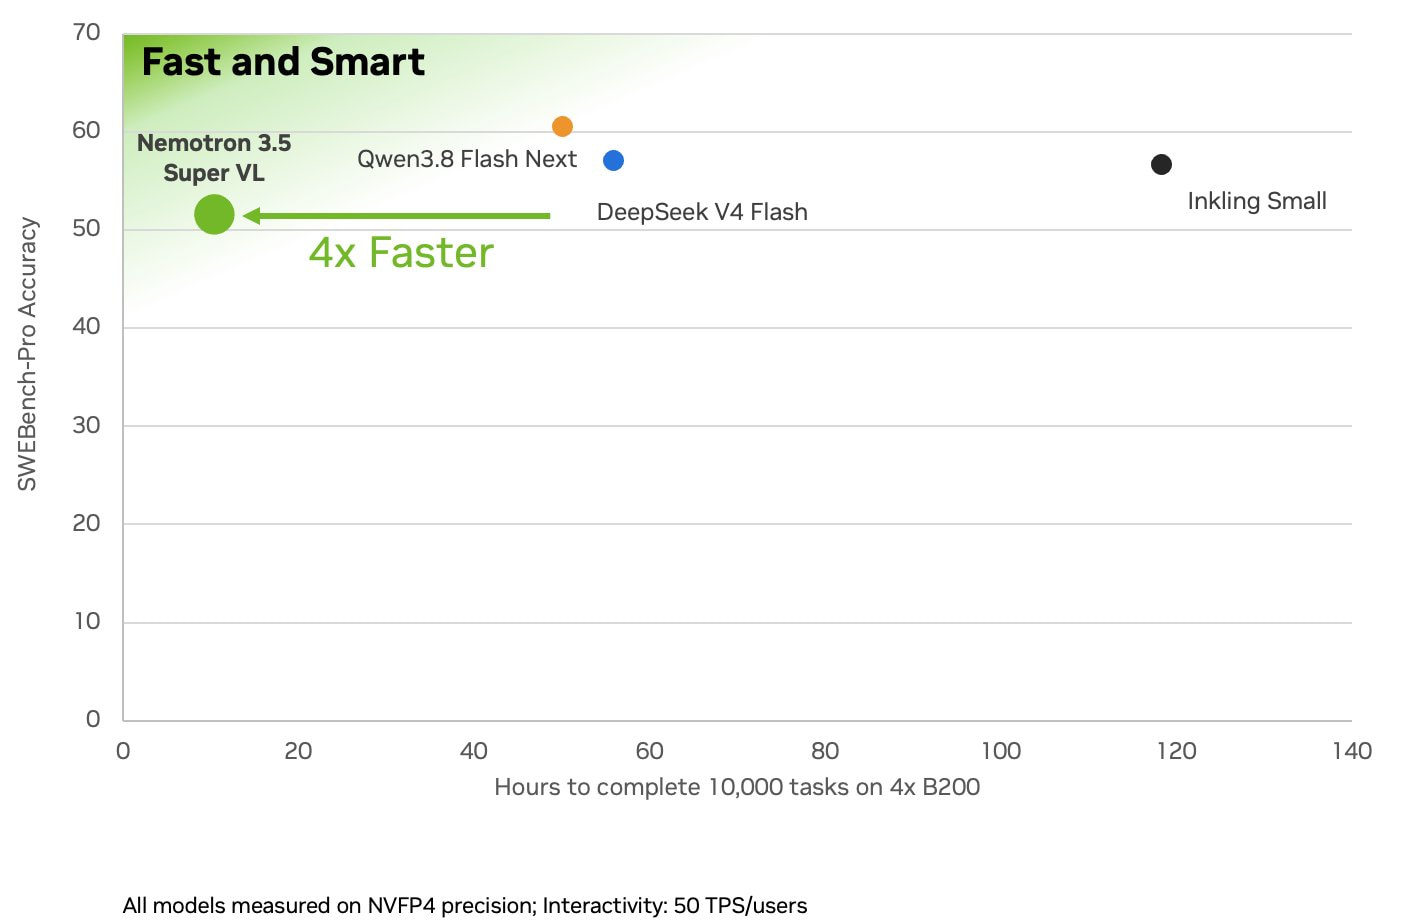
Nvidia 从自家最大的推理模型 Nemotron 3 Ultra 蒸馏出了 Super VL。在 Agent 遵循指令、调用工具、执行多步骤业务流程或分析图像等任务上,Super VL 据称只需约五分之一的参数,就能达到 Ultra 的准确率。Nvidia 表示,在 Hermes 和 LangChain 的 Agent 测试中,它的得分实际上还高于 Ultra;在 SWE-bench 和 Terminal-Bench 编程基准测试中,它也超过了上一代 Nemotron 3 Super。
在编程基准测试中,Super VL 的准确率略低于竞争对手,但 Nvidia 表示,它完成任务的速度是对手的四倍。| 图片:Nvidia
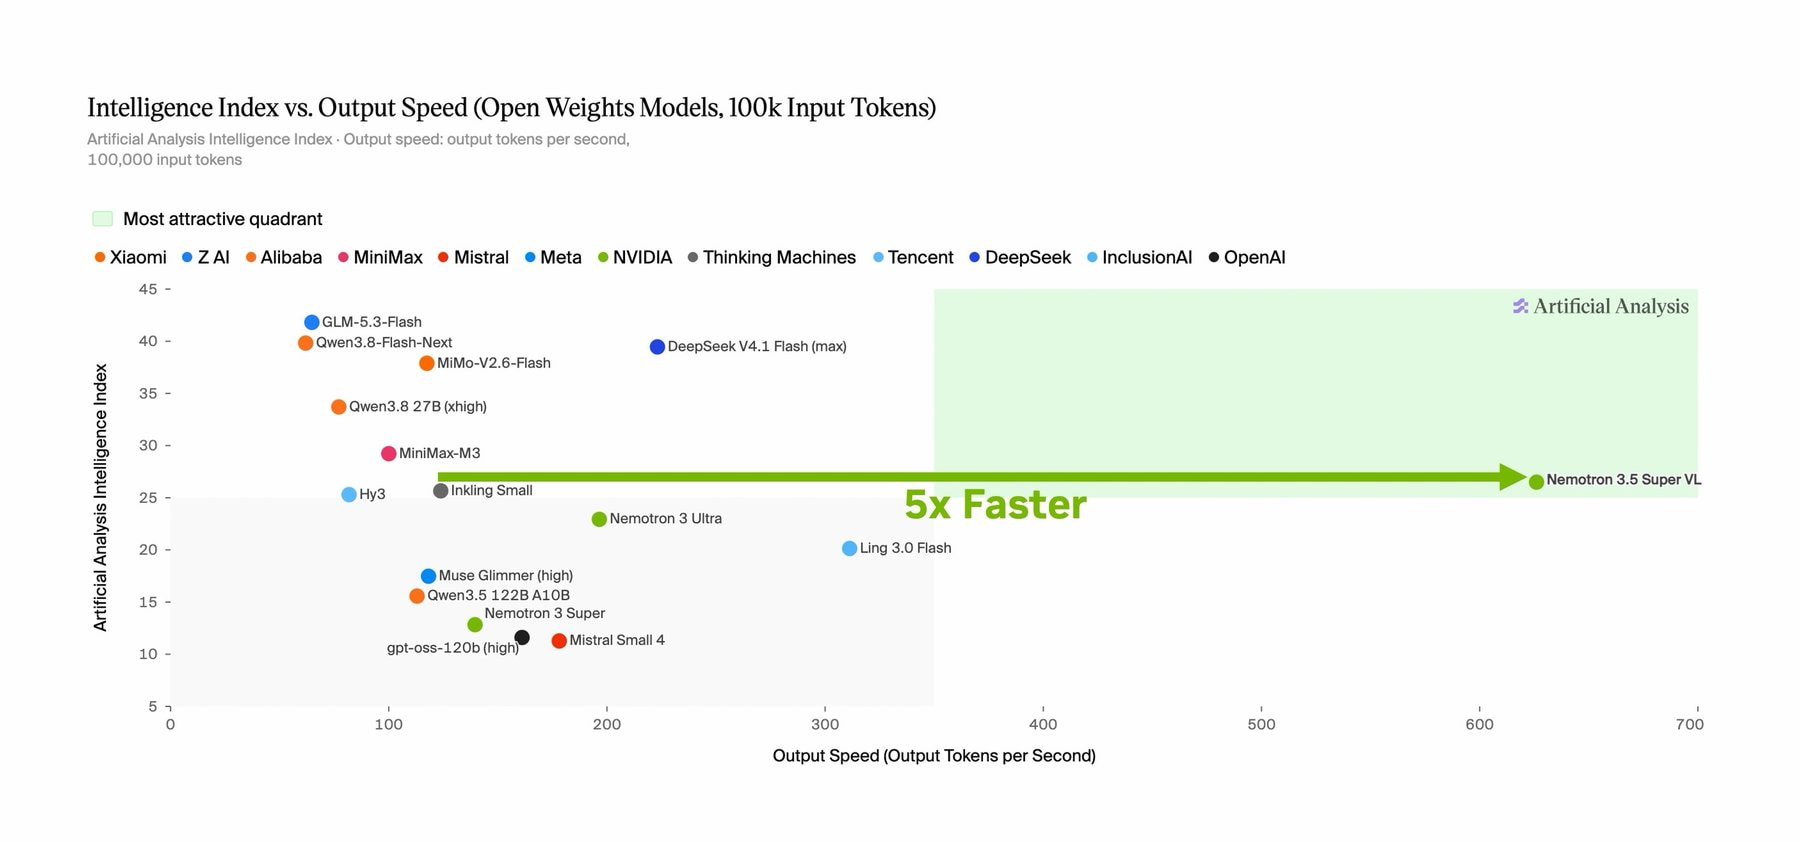
Nvidia 援引 Artificial Analysis 排行榜称,在单张 GPU 上执行 Agent 任务时,Super VL 的吞吐量最高可达其他同等规模开放模型的五倍。EXO Labs 在 DGX Spark 上进行的一项独立测试显示,没有其他模型能同时在准确率和速度上超过它。当 Agent 需要连续数天甚至数周处理大量任务时,这种速度优势就能体现出价值。
Nvidia 表示,在 Intelligence Index 得分相近的情况下,Super VL 每秒生成的 token 数最高可达同级其他开放模型的五倍。| 图片:Nvidia
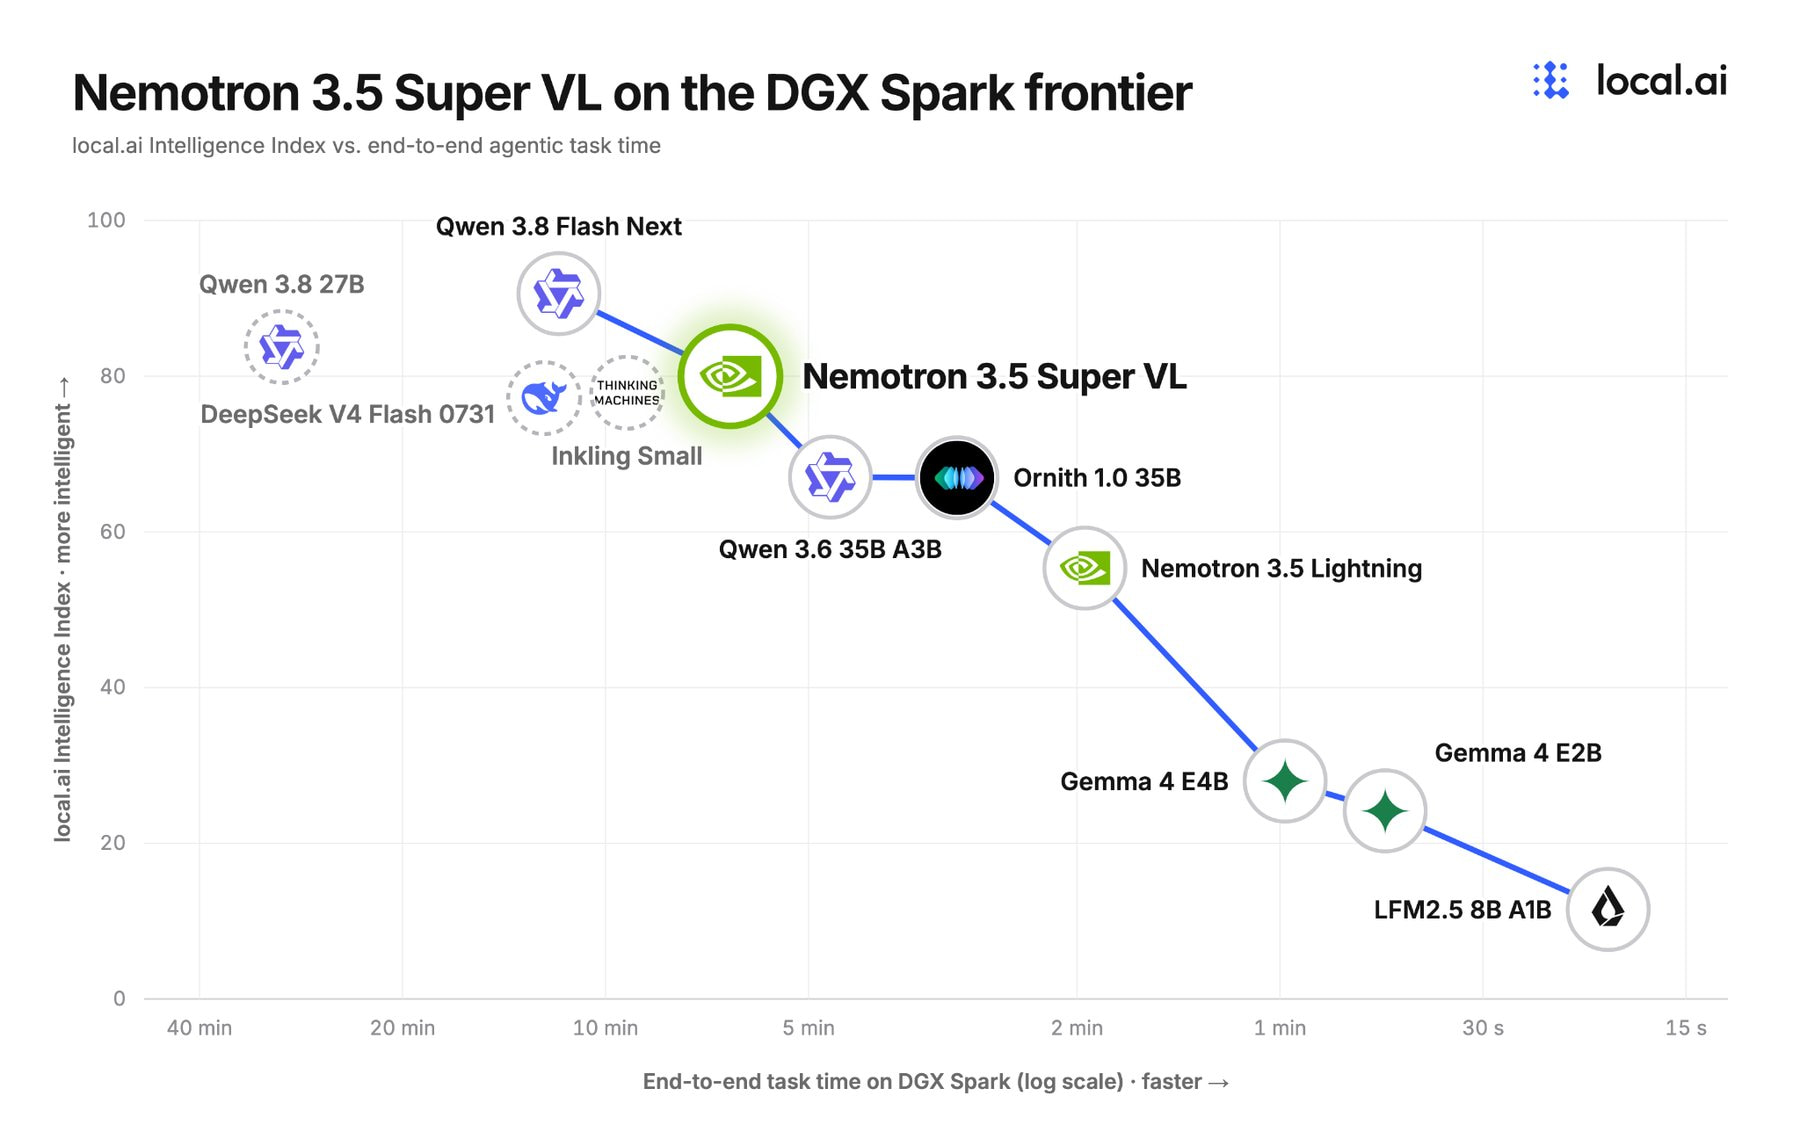
面对闭源前沿模型,Nvidia 将 Super VL 的目标客户定位为这样一类企业:希望用自有数据进行微调,在自己的服务器上运行模型,并摆脱供应商服务条款的约束。Nvidia 表示,这可能会吸引需要持续筛查理赔欺诈的保险公司,或希望按自定标准评估信用状况的金融服务公司。为了支持定制,Nvidia 提供了 NeMo 框架、Python 流水线和开放数据集。
在 DGX Spark 上,所有受测模型中,没有哪一款能同时比 Super VL 更准确、更快。| 图片:Nvidia
Nvidia 使用自家的 4-bit NVFP4 格式压缩 Super VL。在 Blackwell GPU 上,模型全程以 4-bit 精度运行;在较老的显卡上,则只有权重以 4-bit 存储,计算仍采用 16-bit 精度。模型中对精度敏感的部分会保留更高精度。为避免质量下降,Nvidia 对压缩版本进行了训练,使其输出与未压缩的原始模型保持一致。
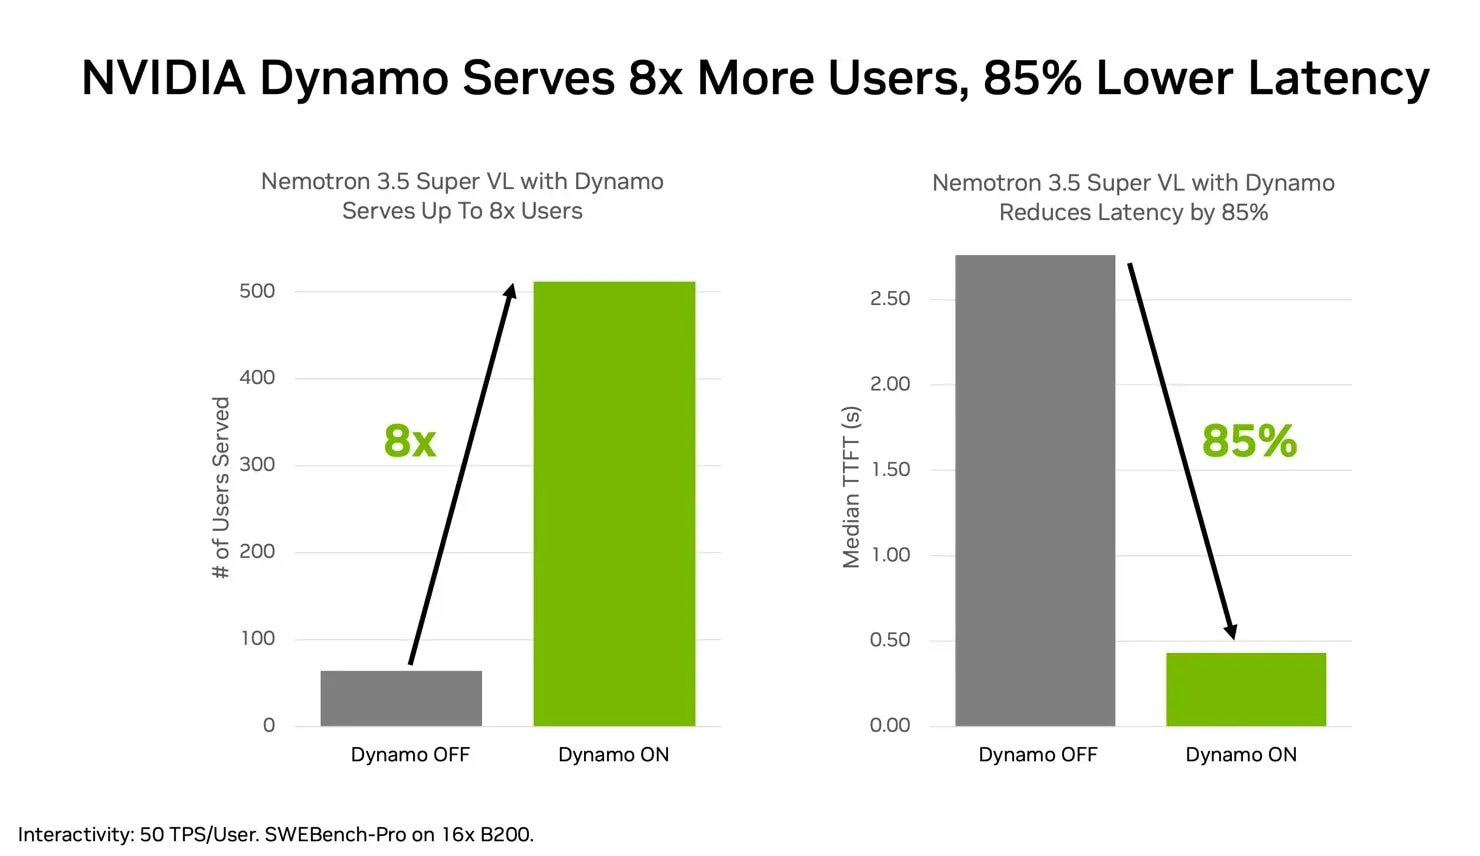
Nvidia 表示,借助其推理软件 Dynamo,Super VL 能服务八倍的用户,同时将首个 token 的响应时间缩短 85%。| 图片:Nvidia
模型内置的草稿组件会提前提出多个 token,再由主模型通过一次前向传播完成验证。在 DGX Spark 上,Nvidia 则推荐使用自家的 LiLiCorr 方法:将所有草稿 token 放在一起评估,以生成更连贯的输出。Nvidia 表示,与不使用推测性草稿的运行方式相比,这种方法最多可将文本生成速度提升至 2.3 倍。
Agent 在每次请求中都会发送相同的指令、工具描述和对话历史,因此 Super VL 会缓存这些重复部分的计算结果,避免每次重新计算。Nvidia 的推理软件 Dynamo 还会将同一会话的请求路由到已持有该会话缓存的 GPU。在 16 张 B200 GPU 上,这使 Super VL 能够服务八倍的并发用户,同时将首个 token 的响应时间缩短 85%。
在视觉能力方面,Nvidia 重点关注 Agent 在日常工作中会遇到的材料,包括 OCR、表格、图表、多页文档和视频。Super VL 可以解读一张图表,将其与同一文档其他位置的表格关联起来,并对两者进行总结,无需额外的图像模型。
Nvidia 表示,在图表基准测试 CharXiv 上,Super VL 的得分为 80.8%,而较早的 Nemotron 3 Nano Omni 为 63%。如果允许模型运行 Python 代码,得分还会提高到 84%。Nvidia 称,它在 OCRBench v2 排行榜上也位居表现最好的开放模型之列。
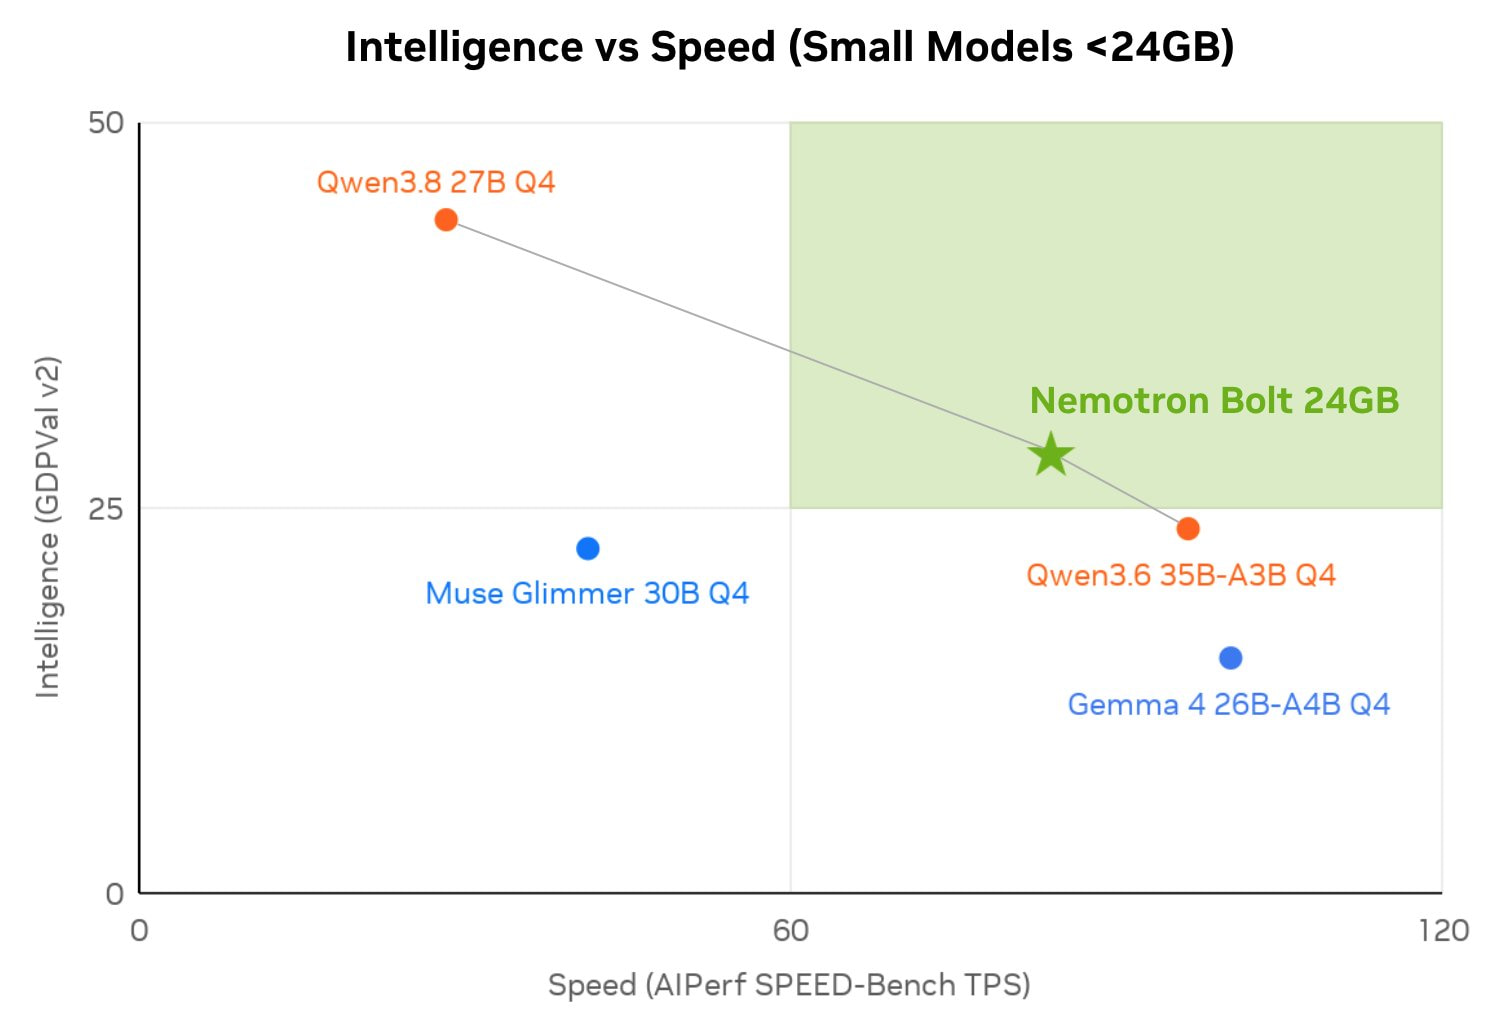
Bolt 74B-A9B 24GB 是 Super VL 的精简版本,采用混合 Mixture-of-Experts 架构,740 亿参数中,每一步只激活 90 亿参数。为了将模型塞进 24 GB 内存,Nvidia 对权重进行了激进的 2-bit 量化。
Bolt 可以处理日常本地任务,例如需要 Agent 执行多个步骤、调用工具或搜索网页的任务。Nvidia 表示,用户可以让它编写和调试代码,或判断哪些 PC 组件适合自己的系统。
该模型针对 Nvidia 的 RTX Spark 和 DGX Spark 进行了优化。前者是一款面向具备 AI 能力的 Windows 笔记本的新芯片,后者是一款紧凑型 AI 工作站,最高配备 128 GB 共享内存。模型还可以在 GeForce RTX PC、DGX Station 和 RTX PRO 工作站上运行,并支持 llama.cpp、Ollama、LM Studio 和 vLLM。
即便经过大幅压缩,24 GB 仍是一道很高的门槛。只有价格昂贵的高端硬件才具备这么大的内存容量,而以当前 GPU 的价格,大多数消费者很难认为这笔投入值得。目前,本地 Agent 主要面向开发者和高性能工作站的拥有者。
对于性能较弱的设备,Nvidia 规划了 Bolt E4B 4GB,但尚未发布。它面向 GeForce RTX 显卡、Jetson 模块以及 RTX/DGX Spark,旨在为语音助手、交互式角色或设备界面提供支持。按照设计,这款模型应当能够自然对话,在多轮交互中使用工具,并持续了解当前应用中正在发生的事情。
Nvidia 表示,已有数十家机构正在针对自身需求微调 Super VL,主要集中在文档量大、数据敏感的行业。Scale AI 为媒体公司 Skydance 调整了该模型,用于处理供应商抵扣款项的 Agent,预计成本将降至原来的四十分之一,响应时间缩短至五分之一。Ramp 用它将收据照片转换为结构化数据,预计响应速度将提升至十倍。EY 将其用于收购尽职调查,Hebbia 则用它分析信贷协议。
Nvidia 表示,在内存占用不超过 24 GB 的模型中,Nemotron Bolt 在速度和任务质量之间取得了最佳平衡。| 图片:Nvidia
另一批采用者来自网络安全领域。AI21 为安全公司 Alice 微调了 Super VL,用于分析威胁和漏洞;据 Nvidia 称,准确率提高了 40%。Dream 使用该模型寻找漏洞,CrowdStrike 则在构建保护企业网络的 Agent。Salesforce 计划将政府工作流程自动化,R1 用它审核医疗账单,Perplexity、Dassault Systèmes 和 Mercor 也在使用这款模型。
Nvidia 发布了基础版、后训练版和 4-bit 压缩版的模型权重,同时公开了数据集、训练方法和强化学习环境。与许多通常只共享权重的开放权重模型相比,Super VL 的开放程度更高。
Nvidia 表示,模型在预训练和持续预训练阶段使用了超过 25 万亿个 token;后训练和强化学习阶段则在约 100 个开放训练环境中,又加入了约 400 万个样例。
Nvidia 还在 Hugging Face 上发布了多个数据集,供其他开发者训练或微调自己的模型。这些数据集涵盖 Agent 如何使用工具、遵循指令、处理长文本和理解图像,另有一些数据集涉及金融、安全性和公平性。
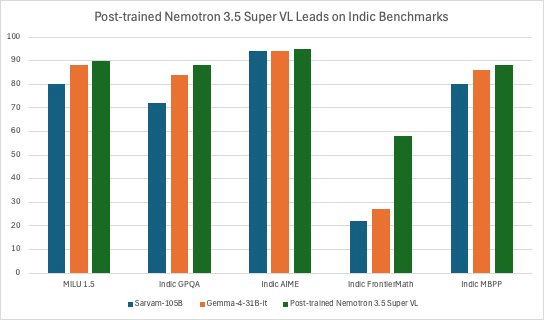
其中一个数据集面向印度使用的语言。Nvidia 与 Indian Institute of Technology Madras 及其 AI 实验室 AI4Bharat 共同构建了这个数据集,包含 22 种印度语言、约 2.83 万亿个 token 的文本。
使用 Indic 数据集微调后,Super VL 在印度语言基准测试中超过了 Sarvam-105B 等规模更大的专用模型。| 图片:Nvidia
Super VL 可以在 DGX Spark、DGX Station、RTX PRO 和 RTX 等桌面系统上运行,也能在边缘设备的 Jetson 模块、数据中心和云端运行。通过 Nvidia NIM,企业可以获得可直接部署的模型微服务,其中包含经过验证的配置和支持服务,并计划每两周更新一次。Nemotron 3.5 Super VL 120B-A12B 和 Nemotron 3.5 Bolt 74B-A9B 24GB 的权重已在 Hugging Face 上提供。
Nvidia 开放发布这些模型,但从数据中心服务器到工作站,都围绕自家产品进行调优。想充分发挥 Nemotron 性能的人,最终就会购买 Nvidia 硬件。
Nvidia 开放模型背后的策略服务于自身利益。运行自有开放模型的企业越多,对计算硬件的需求就越大;在可预见的未来,开放模型很可能仍会针对 Nvidia 进行优化。与此同时,Meta、Google、Anthropic 和 OpenAI 等公司正在开发自己的芯片,并转而围绕这些芯片优化模型。为了进一步推动开放 AI 模型的普及,Nvidia 最近向 Hugging Face 投资了 129 亿美元,后者是开发和分享这类模型最重要的平台之一。
由人工精选、不炒作的 AI 新闻
订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻简报、每年六期独家“AI Radar”前沿报告、完整历史内容,以及评论区访问权限。