
8.0
热点
AI SCORE
技术实践2026-10-15 23:05
AWS 用分层控制扩大智能体自主权限
AWS ML Blog#智能体#权限控制#可观测性
Editor brief · 编辑速览
AWS 提出 Trust in Depth 方法,从范围、认知、边界、观测和验证五个层面约束智能体。其核心是让可验证的操作自主执行,将需要判断的决策留给人类。
每次与企业管理者交流,我都会听到同样的话:他们希望 Agent 能做更多事,却不相信它们每次都能做对。
这种顾虑很合理。让 Agent 变得有用的创造力和自主性,也恰恰让它们难以获得信任。给 Agent 一项任务,它会自行寻找完成任务的路径,选择工具、安排步骤,而这些都不是开发者预先编排好的。同一个任务运行两次,它可能走出两条不同的路线。今天通过的一次测试,并不能说明明天 Agent 会如何行动。
通常的应对办法是让人参与其中,审批 Agent 的每一个动作。规模较小时,这种方式行得通;但随着 Agent 承担的工作越来越多,待审批事项会不断堆积,审核疲劳也随之出现。被要求检查一切的人,反而会漏掉真正重要的问题。谨慎成了瓶颈,而原本能力更强的 Agent,却无法承担那些本可以带来更大价值的工作。
解决办法是:当 Agent 的行为可以验证时,让它自主行动;把人的判断留给真正需要判断的决策。随着 Agent 开始承担金融交易等风险更高的工作,一次错误操作造成的损害也会越来越大。组织需要有信心把重要工作交给 AI Agent,确信即使无人看管,它也会遵守设定的边界。这种信心需要一步步建立。
内容过滤、测试和监控各有重要作用,但其中任何一项能力,都无法单独保证 Agent 下一次运行时会正确行事。信任来自彼此独立、相互支撑的多层机制。这沿用了业界践行了二十年的 Defense in Depth(纵深防御)方法,只是有了新的用途:Defense in Depth 限制可能出错的范围,而这套方法扩大的是你可以安全放手的范围。AWS 将其称为 Trust in Depth(纵深信任)。
要建立信任,你需要在 Agent 生命周期的不同阶段回答一组问题:
在这些问题中,有些要求可以表达为精确规则,另一些则需要判断。例如,公司可能要求只有经理才能批准访问权限,或者必须先阻止员工登录,才能共享其邮箱。而保持友好语气、妥善处理敏感情况等要求,则取决于具体情境和人的判断。
对于定义精确的规则,测试可以说明控制措施在你预想到的场景中是否有效,但 Agent 会走上你没有预想到的路径。能进一步解决这个问题的技术是 automated reasoning(自动推理):它通过数学逻辑,检查一条规则是否在所有可能的情况下都成立。只要对系统及其假设有精确描述,它就能确认规则在这些描述覆盖的每一条路径上都成立,或者找出规则失效的确切情形。这样的结果就是证明。但证明的可靠性取决于背后的规则和假设,因此,最难的工作发生在 Agent 运行之前。
十多年来,AWS 一直在生产环境中使用 automated reasoning:从每秒处理超过 21 亿次请求的 Identity and Access Management(IAM),到 AWS Nitro Hypervisor、Amazon S3 Block Public Access 和 VPC Reachability Analyzer 等关键系统。现在,我们正在将这项技术用于 Agent。只要 Agent 的规则能够精确表达,automated reasoning 就能对其进行检查。
不过,并不是每条规则都能精确表达。“只有经理才能批准访问权限”可以证明,“保持友好语气”则不能。对于无法证明的要求,需要限制 Agent 的访问权限和操作范围,评估其行为,并把确实存在歧义的情况交给人来判断。当你确认相关规则得到执行、Agent 能可靠地完成任务,而且故障可以被发现和处理时,再赋予它更多自主权。
下面,我们逐层介绍 Trust in Depth 对你的要求,以及 AWS 如何帮助你满足这些要求。
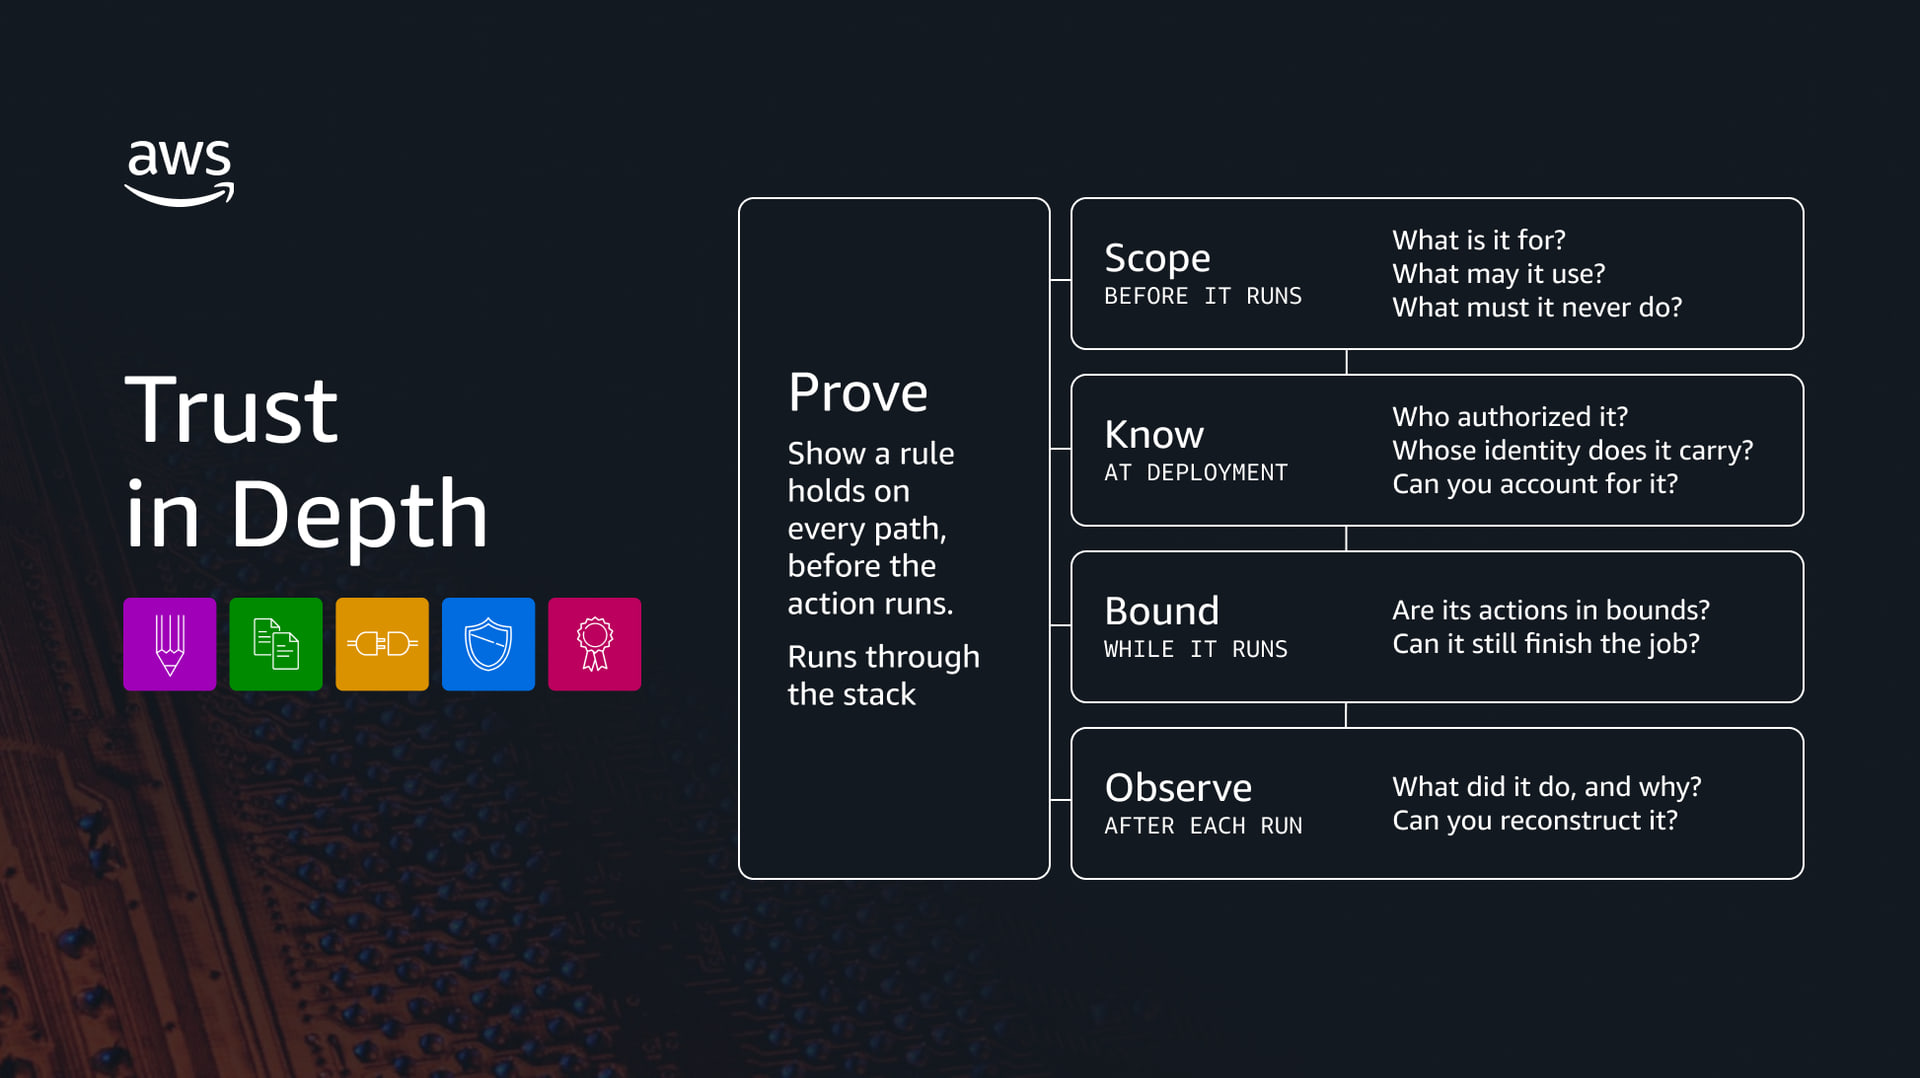
信任始于 Agent 运行之前,这也是最值得投入精力的阶段。在这里发现的问题,修复成本很低。界定范围,就是确定 Agent 负责哪些工作,可以访问哪些工具、数据和服务,必须遵守哪些规则,以及哪些决策仍由人来做。
“解决客户的问题”只说明了要达成什么目标,没有说明 Agent 可以通过哪些行为来实现目标。你仍然需要限制它可以看到什么、可以做什么,以及何时必须停下来询问。只授予完成工作所必需的访问权限,不要多给。还要留意那些没人有意授予、却随工具或角色一并附带的能力。为了完成一项任务而授予管理员角色,可能让 Agent 同时继承整个环境中的权限。
范围界定从构建阶段就开始了,首先体现在你如何定义 Agent。Agentic 编码系统 Kiro 将严谨性和成熟的工程实践引入 Agent 的构建阶段。它把高层意图转化为结构化、由 spec 驱动的需求,并在编写任何代码之前,利用 automated reasoning 找出矛盾、歧义和缺漏。Kiro 还会推导出基于属性的测试,用广泛的输入检查实现是否符合这些需求,从而发现难以检测的 bug。Strands 提供开源工具包,用于定义 Agent 的模型、指令和工具,同时提供运行 Agent 的托管运行时。无论选择什么框架,你都有同样的责任:定义 Agent 的工作及其边界。
下一步,是把这些边界转化为能够约束 Agent 的规则。Amazon Bedrock AgentCore 提供治理控制,让 Agent 能够安全地规模化运行,并对其行为实施管理。借助 Bedrock AgentCore 中的 Policies,你可以用自然语言描述 Agent 能够访问哪些工具、API 和数据。在 policy 生效之前,automated reasoning 会检查其中的缺漏,例如找出授予过多访问权限的规则,也会检查是否存在导致规则永远无法满足的矛盾。
界定 Agent 的范围是最困难的部分,因为要把人的意图转化为持久有效、可强制执行的 policy,需要足够精确,也足够完整。但这也是回报最大的部分。后续的一切都建立在这里设定的基础之上;policy 越精确,Agent 就越能安全地自主完成更多工作。
看不见的东西,就无法治理。团队创建 Agent 的速度,已经超过了人们跟踪它们的速度;一个无人知晓的 Agent,也就无人控制。每个 Agent 都需要独立身份,并且每次行动时都要验证这个身份。任何操作都应有据可查。出现问题时,你应当能够知道哪个 Agent 做了什么,以及是谁授权了它。
AWS Agent Registry 为整个组织中的 Agent、Model Context Protocol(MCP)服务器、工具和 skills 提供一个受管理、经过审批的目录。管理员通过审批流程,控制哪些资源可以被发现,并移除不再符合安全、合规和质量要求的资源。人和 Agent 都可以查找、复用已有资源,无须重复构建。但目录只能告诉你有哪些资源。掌握这些 Agent 之后,AgentCore 会为每个 Agent 签发独立身份,并在每次请求时检查,因此每个操作都能追溯到一个具体的 Agent,以及它所依据的明确授权。这样,你才能掌握每一个代表你行动的 Agent。
设定边界很重要,因为 Agent 即使连续执行了 10 个你批准的步骤,仍然可能得到一个无人预期的结果。它可能泄露敏感数据、偏离主题,或者以 policy 禁止的方式组合原本允许的操作。限制可能向两个方向失效:太宽松,Agent 就会做不该做的事;太严格,它又根本无法完成工作。因此,可以让 Agent 自行选择完成任务的方式,但绝不能依赖它来执行对自身的限制。这些限制定义了 Agent 的边界,应当置于 Agent 周围的运行环境中,以确定性的方式执行,并针对完整的操作序列进行评估,而不是只逐步检查。
你在 Scope 阶段定义的 policy,会在这里发挥作用。AgentCore 中的 Policy 会对每一次经由 AgentCore Gateway 路由的工具调用执行检查。AgentCore Gateway 是 Agent、工具和模型的安全入口。由于执行机制位于 Agent 的推理过程之外,即使 Agent 存在 bug、受到操纵,或遭遇 prompt injection,同样的检查仍然有效:它无法关闭一个不由它运行的控制机制。权限也不必始终固定不变。任务的风险会随进展而变化,因此,时序 policy 会考虑当前会话中已经发生的事情,并随着工作推进调整权限。Amazon Bedrock Guardrails 管理 Agent 输出和接收的内容,过滤有害或偏离主题的内容,并对敏感数据进行脱敏。Automated Reasoning checks 则更进一步,证明响应与你设定的 policy 一致,而不是仅仅符合模型对 policy 的理解。
边界也决定了 Agent 从一开始就能接触哪些资源:能操作哪些文件、能调用哪些服务,以及能使用哪些凭证。开源沙箱 Strands Box 在 Agent 的指令之外强制执行这些边界,让 Agent 可以使用真实工具和数据,但只能访问你允许的资源。从开发者的第一次本地会话到生产环境,同样的边界始终有效,因此 Agent 无法在生产环境中执行开发环境里不被允许的操作。
即使范围、身份和边界都已设定妥当,Agent 仍然可能在几毫秒内给出响应,没有任何报错,所有仪表盘也都显示正常,却依然做错了事。它可能检索了错误的信息、选择了错误的工具,或者走了一条没人预料到的路径。系统健康并不等于任务成功。要区分两者,你必须还原 Agent 实际做了什么:它接收了什么上下文、调用了哪些工具、应用了哪些 policy 决策,以及最终结果如何。部署前的测试依然必不可少。生产环境则会补充真实条件下的行为证据,为运维人员提供调查、干预和改进所需的信息。
Amazon CloudWatch Omni 专为持续观察而构建。它捕获每一条 trace,并将 Agent 从模型调用到工具调用的每个步骤呈现在时间线上,供团队调查。其内置评估器会针对常规监控难以覆盖的质量维度为 Agent 响应评分,例如正确性、忠实性,以及 Agent 是否选对了工具。Agent 出错时留下的 trace,还可以成为验证修复效果的测试数据集,让 Agent 的运行和改进基于同一套证据。
一位经理要求服务台 Agent 为即将离职的客户经理 Sam 办理离职手续。Agent 需要移除 Sam 的访问权限,把他的邮箱移交给接任者,并释放公司不再需要的许可证。但 Sam 的邮件中,也可能包含客户纠纷所需的证据。如果操作顺序不对,Sam 可能在离职后仍有访问权限,或者这些证据可能面临风险。安全、邮件、法务和财务部门各有要求,Agent 都必须遵守,即使没有人为它编排过完整流程。
有两条规则约束操作顺序。必须先阻止 Sam 登录,才能转换他的邮箱并将其共享给接任者。在更改他的邮件许可证之前,Agent 必须检查是否存在 legal hold,也就是因纠纷而必须保全记录的要求,并确认许可证变更后,这些记录仍能得到保护。
**Scope。**在 Agent 运行之前,团队将这些规则写成 AgentCore 中的 policy。每条 policy 都要求:只有针对 Sam 账号的前置步骤已经成功,下一步才能运行。Agent 恰好获得六个工具:阻止登录、检查 legal hold、设置 hold、转换邮箱、授予接任者访问权限,以及更改许可证。它没有删除账号的工具,因为共享邮箱需要保留该账号才能继续存在。
**Know。**Agent 使用自己的独立身份,因此,对 Sam 账号的每一次更改都能追溯到它。
**Bound。**Agent 尝试将 Sam 的邮箱转换为共享邮箱,供接任者 Priya 使用。通过 AgentCore Gateway 执行的 AgentCore Policy 阻止了这次调用:Sam 仍然可以登录,而转换邮箱不会更改他的密码,因此旧凭证仍能打开邮箱。Agent 先阻止 Sam 登录,然后转换邮箱,并授予 Priya 访问权限。接下来,它开始处理经理真正提出的要求:释放许可证。但 gateway 再次阻止了操作,因为还没有人检查法务部门的 hold 清单。Agent 检查后发现,法务部门要求保留 Sam 的邮件,用于处理一场客户纠纷。于是,它设置 hold,确认已经生效,再将 Sam 的许可证更改为支持这项保护的许可证。这样,公司就可以回收权限和功能更广的许可证,同时完整保留证据。
**Observe。**每一步都有记录:Agent 尝试做什么、规则作出了什么决定、设置了什么 hold,以及最终结果如何。
Agent 完成了任务,无须由人逐步审批。权限限制了它能够更改的内容,身份让这些更改可追溯,policy 则阻止它在必要的保障措施落实之前采取行动。通过记录下来的步骤,团队可以验证:Sam 的访问权限已经被阻止,接任者能够使用邮箱,所需证据也仍然受到保护。
AWS 将这些层结合起来,让你能够把 Agent 的范围限定在其工作所需之内,掌握哪些 Agent 正在代表你行动,约束它们的言行,了解它们做过什么并持续改进;对于能够精确表达的规则,还能证明这些规则始终成立。任何单独一层都无法独自赢得这种信任。它们共同构成 Trust in Depth,也正是这些机制,让一个有能力的 Agent 成为值得托付重要工作的 Agent。
边界由你来划定:哪些事情 Agent 可以自主完成,哪些需要人的批准,以及何时必须停止。这样,你的员工就能腾出精力,专注于只有人才能做的事:权衡棘手的问题、处理灰色地带,并为你选择保留在人手中的决策负责。随着证据不断积累,证明 Agent 始终遵守这些边界,你可以扩大它的职责,也可以缩小。
在 AWS,我们相信,任何组织,无论在哪个平台上部署 Agent,都应当能够拿出证据回答这四个问题,并在适用的地方提供证明。这是 AWS 正在为客户建立的标准,我们也邀请整个行业以此要求自己。Defense in Depth 让系统能够安全地连接世界;Trust in Depth 则让 Agent 能够在这个世界中安全地自主行动。
从一个 Agent、一个工作流,以及一条你能够证明有效的边界开始。随着信任逐步建立,再扩大范围。
要开始实施可强制执行的规则,可以了解 Amazon Bedrock AgentCore 中的 Policy,以及 Amazon Bedrock Guardrails 中的 Automated Reasoning checks。