
8.0
热点
AI SCORE
编程提效2026-10-15 12:03
把 ClickUp 项目记录变成 Agent 可查询记忆
dev.to · AI#Agent#知识管理#项目管理
Editor brief · 编辑速览
作者为 cognee 构建 ClickUp 连接器,将任务、评论和文档同步为 Agent 可查询的记忆,用于追踪迭代阻塞原因。文章展示接入代码,并讨论真实工作区测试暴露的 API 问题。
大多数团队都有同一个问题:“为什么这件事被阻塞了?”答案其实已经在那里,只是分散在任务状态、一个自定义字段、三条评论,以及某个人上个月写的 Doc 里。站会前,没人会把这些都读一遍。
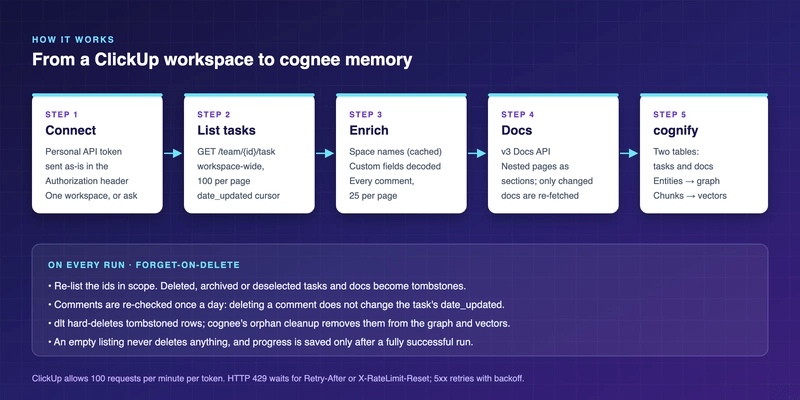
我想要一个能读完这些信息的 Agent,于是在 Mergetober 活动期间,为 cognee 这个面向 AI Agent 的开源记忆层开发了一个 ClickUp connector。它把任务、评论和 Docs 转换成 Agent 可以查询的记忆,并随着工作区的变化持续同步这些记忆。
这篇文章讲的是,为了让它可靠运行,我做了哪些工作。ClickUp API 有几处出乎意料的行为,其中两处直到我在真实工作区测试时才暴露出来。
import asyncio

import cognee
from cognee_community_connector_clickup import clickup_source

async def main():
    await cognee.remember(
        clickup_source(space_ids=["90120001"]),  # token from CLICKUP_API_TOKEN
        dataset_name="sprint_memory",
        primary_key="id",
        write_disposition="merge",
        max_rows_per_table=0,
    )
    answer = await cognee.search(
        query_text="Which tasks are blocked, and what are they waiting on?",
        query_type=cognee.SearchType.GRAPH_COMPLETION,
        datasets=["sprint_memory"],
    )
    print(answer)

asyncio.run(main())
身份验证使用 ClickUp 个人 API token(头像 → Settings → Apps → API Token → Generate)。你可以通过 space_ids、folder_ids 或 list_ids 选择要导入的内容。明天再运行一次,就只会获取发生变化的内容。
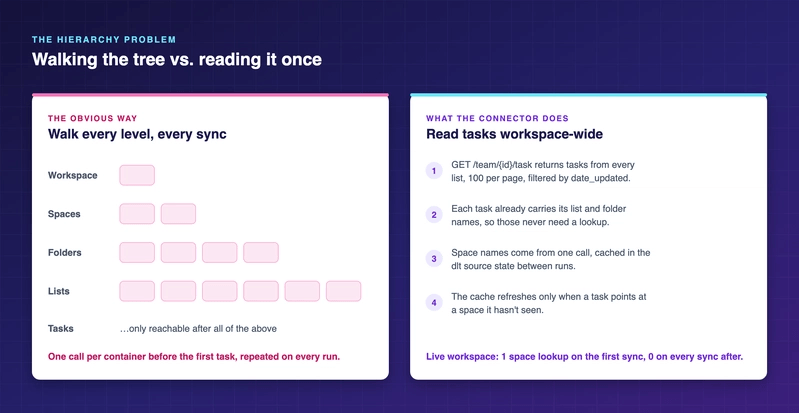
ClickUp 把所有内容都嵌套起来:Workspace → Space → Folder → List → Task,每一层都要单独调用 API。最直观的实现方式,是先遍历整棵树,才能看到第一个任务,而且每次同步都要再遍历一遍。ClickUp 每分钟允许 100 次请求,对于大型工作区,光是这次遍历就会消耗大部分请求额度。
绕开这个问题的方法,是使用支持筛选的团队任务端点 GET /team/{team_id}/task。它能返回工作区内所有 List 中的任务,每页 100 个,并支持 date_updated_gt 筛选条件。每个任务本身已经带有所属 List 和 Folder 的名称,唯独没有 Space 名称。因此,connector 会获取一次 Space 名称,将其缓存在 dlt state 中,只有当某个任务指向此前没见过的 Space 时,才刷新缓存。
在我的测试工作区中,这意味着首次同步只需查询一次 Space,之后每次同步都不需要再查。
团队通常会把重要信息放在自定义字段里:严重程度、组件、审核人。但 API 返回的格式,只有 ClickUp 自己看得懂。下拉选项返回的是 2,标签返回的是选项 ID 列表,人员字段返回的则是用户对象列表。
如果直接把这些数据送进知识图谱,Agent 学到的就是“严重程度是 2”。connector 会通过字段的 type_config 解析每个值,让文档写成“严重程度:高”。它还支持日期、复选框、货币、评分、位置和进度。下面是 connector 针对一个示例任务生成的真实输出:
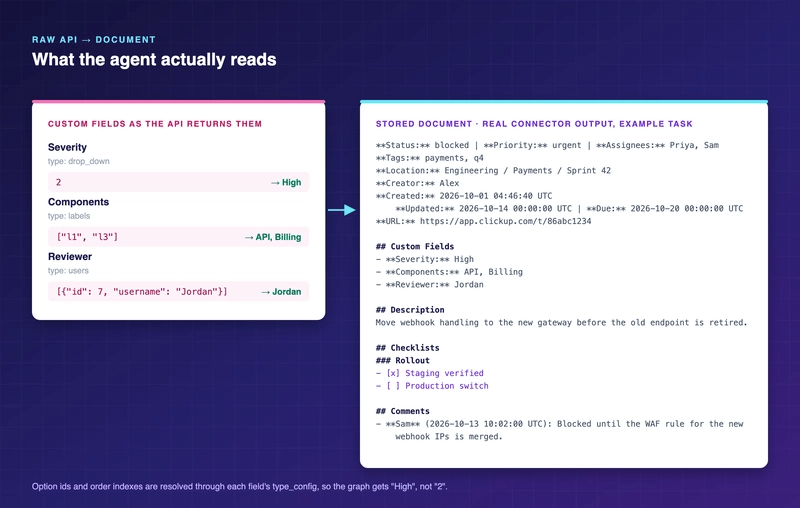
每份任务文档还包含状态、优先级、负责人、标签、所在的 Space / Folder / List、检查清单,以及全部评论。评论端点只返回最新的 25 条,因此 connector 会继续向前分页,获取其余评论。ClickUp Docs 也会通过 v3 Docs API 同步,嵌套页面会被渲染成文档中的章节。
我的测试套件全部通过了。随后,我把 connector 连到一个真实的 ClickUp 工作区,才发现两个假设是错的。
date_updated_gt 并不严格表示“大于”。我传入最新任务自身的时间戳,ClickUp 仍然返回了这个任务:传入最新时间戳 − 1 ms,会返回;传入最新时间戳,也会返回;传入最新时间戳 + 1 ms,才不会返回。因此,每次“没有任何变化”的重复运行,都会重新导入最新任务,并重新获取它的评论。修复方法是:如果任务的时间戳等于游标值,而且已经导入过,就跳过它;同时仍然接收在同一毫秒内创建的真正的新任务。
删除评论是不可见的。我在一个真实任务中发布了一条测试评论,并观察任务的 date_updated。它发生了变化,所以新增评论能够被同步到。随后,我删除了这条评论,date_updated 却完全没变。基于游标的同步,会让这条已删除的评论永远留在 Agent 的记忆里。
解决方法是重新检查评论,默认每天一次。connector 会重新读取选定范围内任务的评论,与上次保存的指纹进行比较,只重新渲染评论发生变化的任务。我也在真实工作区验证了这一点:下一次检查后,那条已删除的评论就从记忆中消失了。

这些数字来自我的测试工作区,其中有 12 个任务和 1 份 Doc。首次同步发出了 17 次请求,大部分用于获取评论,每个任务一次。没有任何变化时重跑,只发出 4 次请求:查询工作区、增量列出任务、检查删除情况,以及列出 Docs。每日评论复查大约需要为每个任务发出一次请求,这也是它每天运行一次,而不是每次同步都运行的原因。
ClickUp 不提供删除事件流,因此每次运行都会重新列出选定范围内的 ID。被删除、归档或移出选定范围的任务和 Docs,会变成墓碑记录({"id": ..., "_deleted": true})。dlt 会将它们硬删除,cognee 的孤立数据清理机制则会将它们从图谱和向量存储中移除。
两道保护机制可以避免一次异常就清空记忆。如果已经知道存在条目,但列表请求却返回空结果,connector 会假定服务出了故障,并跳过清理。另外,它只会在一次运行完全成功后保存进度,所以即使中途崩溃,下次运行也只是重复执行这些工作。
不会获取评论下的串式回复;ClickUp 为这些回复提供了单独的端点,需要逐条评论调用。
不会下载附件。
Docs 的同步范围由其直接父级决定:选择一个 Space,只会包含直接位于该 Space 下的 Docs。
Mock 测试告诉我,代码确实按我的预期运行。只有真实 API 才能告诉我,我的预期是否正确。上面两个 bug 都通过了所有单元测试,因为模拟 API 的行为符合我对 ClickUp 的假设。现在,模拟 API 的行为已经与 ClickUp 的实际行为一致,测试也就能防止这些 bug 再次出现。
这个 connector 正作为 topoteretes/cognee-community#278 接受审查,对应 issue #4701。合并之前,你可以从我的分支安装:
pip install "cognee-community-connector-clickup @ git+https://github.com/priyansh-narang2308/cognee-community@feature/clickup-connector#subdirectory=packages/connector/clickup"
如果你的团队日常都在 ClickUp 里工作,我很想知道,你最先会问 Sprint Agent 什么问题。
如需采取进一步行动,你可以考虑屏蔽此人和/或举报滥用行为。