
8.0
热点
AI SCORE
技术实践2026-10-15 03:54
MCP工具数量实测:准确率之外更要看成本
dev.to · AI#MCP#工具调用#成本优化
Editor brief · 编辑速览
作者在 Claude Code、Codex 和 Gemini 上完成了1932次测试,将工具数量从5个扩展到100个,未观察到准确率变化。测试指出,成本差异主要取决于客户端的工具加载方式,默认隐藏多数工具也改变了命名的作用。
关于 MCP server 设计,大多数建议都说要控制工具数量。我读了 91 份资料:38 份建议减少工具数量,20 份给出了具体数字(大多是 10–20 个),但只有 10 份真正测过工具数量与准确率的关系。于是我自己做了测试:1,932 次运行,三个客户端,工具数量从 5 个到 100 个。在当下的顶级模型上,准确率没有变化:100 个工具没有影响,长得相似的工具没有影响,甚至含糊的工具名也没有影响。变化的是成本,而变化多少取决于客户端如何加载工具,不取决于模型。自 2026 年以来,这三个客户端默认都会向模型隐藏工具列表中的大部分内容,这也让工具名称以一种新的方式变得重要起来。
开始测试之前,我完整读完了 91 份关于 MCP server 设计的资料:21 份官方文档、28 篇厂商博客、20 篇独立博客、2 个论坛讨论帖,以及 20 篇论文。其中,38 份建议精简工具,22 份建议通过搜索或延迟加载,让模型可见的工具集合保持较小规模,还有 8 份推荐 code mode,也就是用一两个工具执行代码。没有一份建议把所有工具都暴露出来。
20 份资料给出了具体数字:5–8 个(Workato)、5–15 个(Phil Schmid)、每个 namespace 少于 10 个且总数少于 20 个(OpenAI)、10–20 个(Gemini、Speakeasy)、30–50 个(Claude 文档),以及“40 个是拐点”(Archestra)。这 20 个数字中,只有 3 个来自资料作者自己的测量。两条被反复引用的说法经不起推敲。“模型遇到 30 个工具就会出问题”可以追溯到 RAG-MCP 论文,但那篇论文统计的是 prompt 中的 MCP server 数量,不是工具数量。“Cursor 不接受超过 40 个工具”这句话,在 2026 年 1 月取消数量上限后就已经不成立了。
在这 91 份资料中,46 份只是观点,8 份引用了别人的结论。37 份做过某种测量,但只有 10 份测过工具数量与准确率的关系:7 篇论文、GitHub 的 Copilot(工具从 40 个减少到 13 个,准确率提高了 2–5 个百分点)、LangChain,以及一项针对 1.7B 模型的非正式测试。其余资料测的是 token 数量,或比较 MCP 与 CLI,这些都不算工具数量测试。甚至在工具分组这件事上,建议也各不相同:15 份推荐按工作流组织工具,15 份推荐将工具分组,3 份推荐每个操作对应一个工具。而这 3 份的依据是权限确认提示,不是准确率。
我搭了一个模拟 server,提供 100 个贴近实际使用的文件和文档工具,名称和 schema 都准确反映各自的用途。其中一些工具刻意设计得容易混淆,比如 pdf_compress、pdf_optimize 和 image_compress。它还有一个分组版本,用 7 个工具覆盖 50 项操作,以及一个使用含糊名称的版本。所有工具都不会实际操作文件:评判结果的依据是 server 的调用日志。
我给 Agent 安排了 18 项答案已知的任务,其中 10 项存在歧义,在工具数量 N = 5、10……50、75 和 100 时分别执行,每项任务运行两次。客户端包括 Claude Code(Opus 5.5,分别开启和关闭 tool search)、Codex CLI(GPT-6.1-sol),以及 Antigravity(Gemini 3.1 Pro),每个客户端都使用各自的订阅。所有测量资料都放在 GitHub 上:报告、results.csv,以及每次运行的原始日志。
在使用独立工具的所有运行中,无论工具数量是 5 个还是 100 个,三个客户端以及 Claude Code 的两种模式都完全正确。这包括每一项存在歧义的任务,也包括工具总数为 75–100 个时额外加入的 50 个相似工具。因此,在 Opus 5.5、GPT-6.1-sol 和 Gemini 3.1 Pro 上(2026 年 10 月),“工具越少,准确率越高”在这个范围内并没有出现。这也符合资料调研中的限定结论:性能是否下降,很大程度上取决于模型。
Claude Code 的 tool search 从未隐藏正确的工具。每次运行都恰好调用了一次 ToolSearch,而且都是第一步操作,随后通过精确名称选择工具。模型一开始就能看到所有工具名称,在读取任何 schema 之前,仅凭名称就在相似工具之间做出了选择。
输入 token 数量按每个单元格的 36 次运行取平均值(18 项任务 × 2 次)。这些运行全部正确,因此表格展示的只是成本。
在 Claude Code 中,真正起作用的开关是 tool search。它默认开启:只有工具名称进入 prompt,模型通过一次 ToolSearch 调用加载所需的 schema。这次额外调用使它在工具少于约 19 个时,比一次性加载所有工具更贵;超过这个数量后,则更省:工具达到 100 个时,每次运行的输入量减少了 59%。在通过代理使用、使用 Azure Foundry、使用较旧模型、设置 ENABLE_TOOL_SEARCH=false,或使用 --tools "" 时,tool search 会关闭。不过,token 更少并不意味着每次运行更便宜:工具为 100 个时,按标价计算,开启搜索的一次运行成本为 $0.047,关闭搜索则为 $0.038,因为缓存输入很便宜,而搜索会增加一次调用。搜索节省的是上下文,不是钱。
我踩过一个坑:用于隔离测试的参数关闭了 Claude Code 的 tool search,导致我最初把“关闭搜索”的数据当作正常情况发布。仅仅一个参数,就让首次调用的成本相差 4 倍。
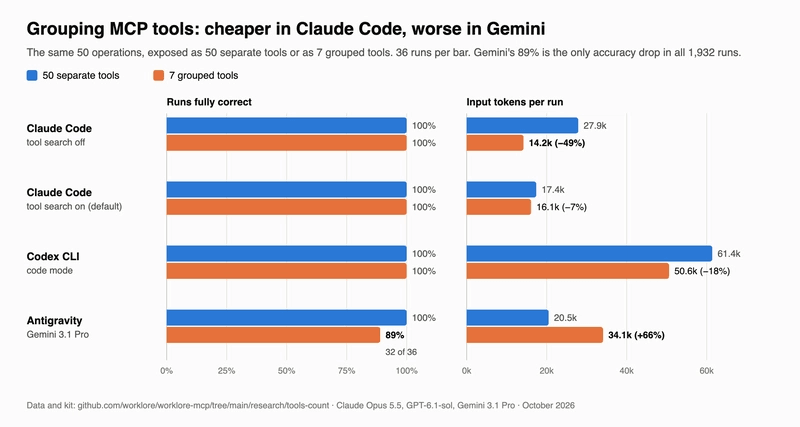
在加载全部 schema 的情况下(Claude Code,关闭搜索),7 个分组工具的成本相当于 14 个独立工具,准确率为 100%。开启 tool search,也就是使用 Claude Code 默认设置时,分组几乎没有影响:每次运行的输入 token 为 16.1k,而 50 个独立工具为 17.4k。只有在预先加载全部 schema 的情况下,分组才有明显收益。
Antigravity 是整个实验中唯一出现准确率下降的客户端,降到了 89%。Gemini 跳过了多操作工具的 schema,猜测 delete、help 和 fake_op 之类的操作名称,并有 3 次执行了错误操作。
在这个变体中,我保留了相同的 100 个工具和相同的描述,只是随意给工具起了名字:optimize_file、optimize_document、process_image、combine_files、handle_pages。准确率依然保持不变:276 次运行全部正确,没有执行任何错误工具。最终答案由描述决定。
但只要模型先看到的是名称,名称就会决定它如何走到正确答案。在开启搜索的 Claude Code 中,准确的名称让模型在 72 次运行中的 69 次里,恰好加载了所需的 schema;换成含糊名称后,这个数字变成了 72 次中的 7 次。模型转而使用关键词搜索。在工具数量为 100 个时,每次运行加载的 schema 数量从 1.6 个增加到 7.6 个(其中一次加载了 23 个),输入量增加了 21%。Gemini 在 72 次运行中,有 34 次首先打开了错误工具的 schema,还有 10 次用空参数试探错误工具。我的 server 拒绝了这些空参数调用;但在真实 server 上,如果某个工具没有必填参数,它就会被执行。在 100 个工具时,Gemini 的输入量增加了 38%。
如果所有描述已经放在 prompt 中,含糊名称就不会带来任何变化:关闭搜索的 Claude Code 完全没有受到影响。只有模型能看到描述时,好的描述才能补救糟糕的名称。Codex 用代码搜索工具定义,因此名称在它那里也几乎没有影响。
最容易误导模型的名称包括:“把 3 张 JPG 合成一个 PDF”让模型选了 combine_files,但这个工具实际上用于合并 PDF;“缩小一个 PNG”让模型选了 optimize_image;而将 pptx 和 docx 转成 PDF 的任务,则让模型混淆了 convert_file 和 convert_document。
要让所有客户端都能调用,工具名称应使用字母、数字、_ 和 -,最长 64 个字符。Claude API 不接受点号,有些客户端会自行替换名称中的点号。这 64 个字符的额度还要共同使用:Claude Code 调用工具时使用的名称是 mcp__<server>__<tool>,因此 server 名称越长,留给工具名称的空间就越少。运行中还遇到了一个意外:在一次预先加载工具的运行中,Gemini API 拒绝了包含整数 enum 的工具 schema。
使用前沿模型时,不要为了提高准确率而减少工具;应该为了成本和上下文而精简工具或延迟加载,并检查用户使用的哪些客户端会预先加载工具。
用动作和对象给工具命名,不要只用泛泛的动词:名称如今是模型最先读取的内容,含糊的名称会增加读取次数,并带来错误调用的风险。
把描述写得足够清楚,让模型能够区分工具:面对相似工具和含糊名称时,正是描述让准确率保持在 100%。
不要盲目分组:在用户实际使用的客户端中测试。
测量你自己的 server。这篇 worklore 文章逐步介绍了同一套 benchmark,你的 Agent 可以用它测试你的 server。
本实验使用的是模拟工具,而且只涉及一个领域:文件。只测试了三个前沿模型,没有测试更小或更旧的模型,而调研中那些做过测量的资料,恰恰报告了这类模型的表现下降。任务都是直接提出的,没有同时进行长时间推理,因此没有测量上下文拥挤的影响。含糊名称只在搭配良好描述时做了测试,没有测试名称和描述都含糊的情况。token 统计包含各客户端自身的开销。并非每组测试都覆盖了所有工具数量,而且 Codex 的含糊名称测试受使用额度限制,只完成了 72 次中的 60 次。此外,这只是一个时间点上的结果:2026 年 10 月。
你是根据测量结果,还是根据别人的建议来决定工具数量和名称的?你测了什么?
如需进一步采取行动,你可以考虑屏蔽此人和/或举报滥用行为。