
8.0
热点
AI SCORE
技术实践2026-10-16 00:00
SGLang 支撑编程模型 Beam 生产部署
LMSYS / SGLang Blog#模型部署#混合专家#Agent
Editor brief · 编辑速览
SGLang 团队介绍其对 Reflection Beam 的生产支持;该模型采用 5010 亿参数的 MoE 架构,每个 token 激活约 230 亿参数。模型面向软件工程与长流程 Agent 任务,计划以 Apache 2.0 协议发布。
混合注意力与输出门控
稠密层与分组 MoE 路由
三明治归一化与深度缩放残差
结合数据并行注意力的 DFlash2 推测解码
目标模型与草稿模型 KV 的统一内存
用于预填充/解码分离的异构 TP
推理、工具调用与 LoRA
BF16、NVFP4 和 FP8 模型支持
前缀复用、分块预填充与 HiCache
BF16 MoE 内核优化
在 Miles 中进行强化学习
OpenHands 智能体编程批量评测
AgentX 智能体编程批量评测
OpenHands 复现
Reflection 的 Beam 是一个拥有 5010 亿参数的混合专家模型,每个 token 激活 230 亿参数,专为软件工程和长程智能体任务打造。Beam 计划以 Apache 2.0 许可证发布,旨在让开发者能够在自己已经使用的运行时、框架和编程执行框架中部署模型,并基于它进行开发。
SGLang 现已原生支持 Beam,并为 Reflection 的生产 API 提供支撑。它帮助开发者将 Beam 的推理效率转化为经过生产环境验证的实际服务性能。BF16、NVFP4 和动态 FP8 支持,可灵活满足不同的精度和内存需求;DFlash2 推测解码可加速生成;前缀缓存结合混合注意力内存管理,则能在智能体的多次交互间高效复用上下文。在这些服务能力之下,我们还优化了 Beam 的投影、归一化和通信,以提高吞吐量。
本文介绍 Beam 在 SGLang 上的集成、优化及性能结果。要部署该模型,可以从我们的 Beam 服务部署指南入手,获取经过验证的配置和启动说明。
Beam 1.0 501B-A23B:仅含解码器的 MoE 模型,结合滑动窗口注意力与全注意力,拥有 256 个路由专家,每次选择前 8 个专家,并原生支持 100 万 token 的上下文窗口。
检查点支持:BF16、ModelOpt NVFP4 和 compressed-tensors 动态 FP8。
服务特性:DFlash2 推测解码、基数树缓存与 HiCache、分块预填充、CUDA 图、TP/EP/PP,以及注意力数据并行。
内核优化:投影打包、跨注意力与残差边界的融合、用于 FP32 路由器的专用 BF16x3 GEMM,以及 GB300 MoE 调优。
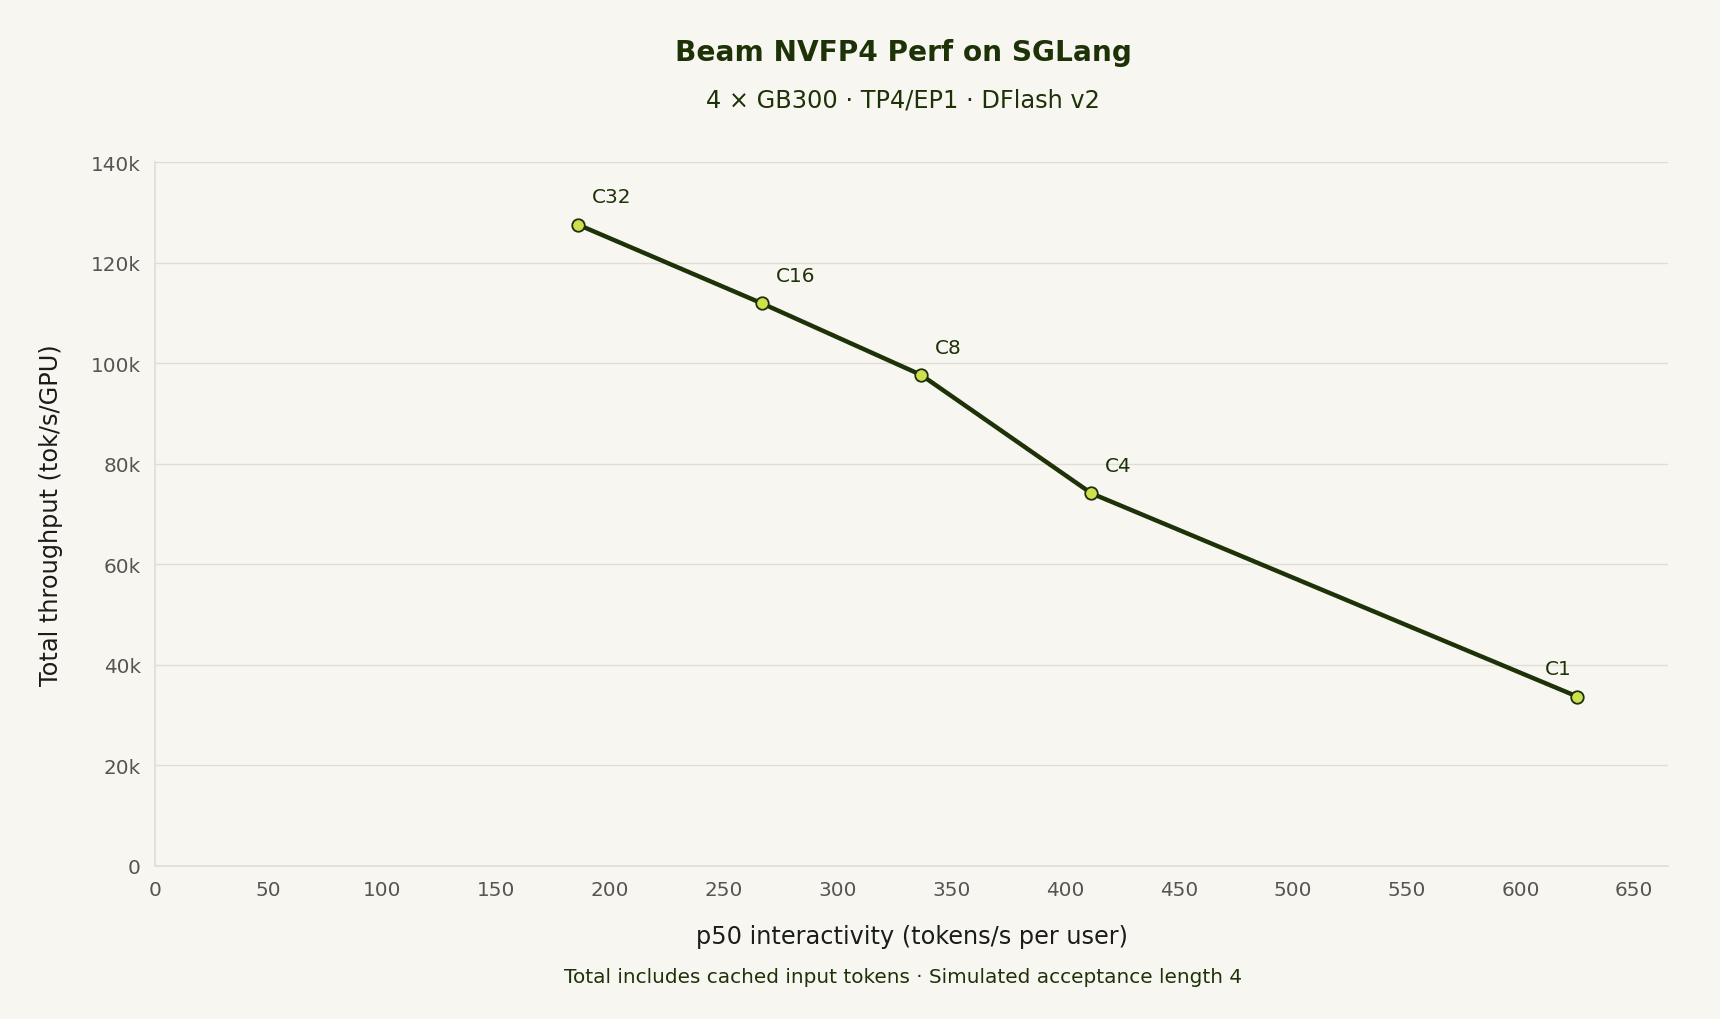
性能:在 4 张 NVIDIA GB300 GPU 上使用 NVFP4 检查点回放 OpenHands 多轮智能体编程任务时,SGLang 在并发数为 32 的情况下,每张 GPU 的总吞吐量达到 127.6K token/秒,每位用户的生成速度达到 185.87 token/秒(p50)。
Beam 将分组查询注意力与滑动窗口、全注意力层混合使用。其前馈网络堆栈以稠密 SwiGLU 层开头,随后切换到路由 MoE。Beam 在注意力输出经过投影之前对其进行门控,并在两个分支前后设置三明治归一化。深度缩放残差则控制各分支如何汇入隐藏状态流。
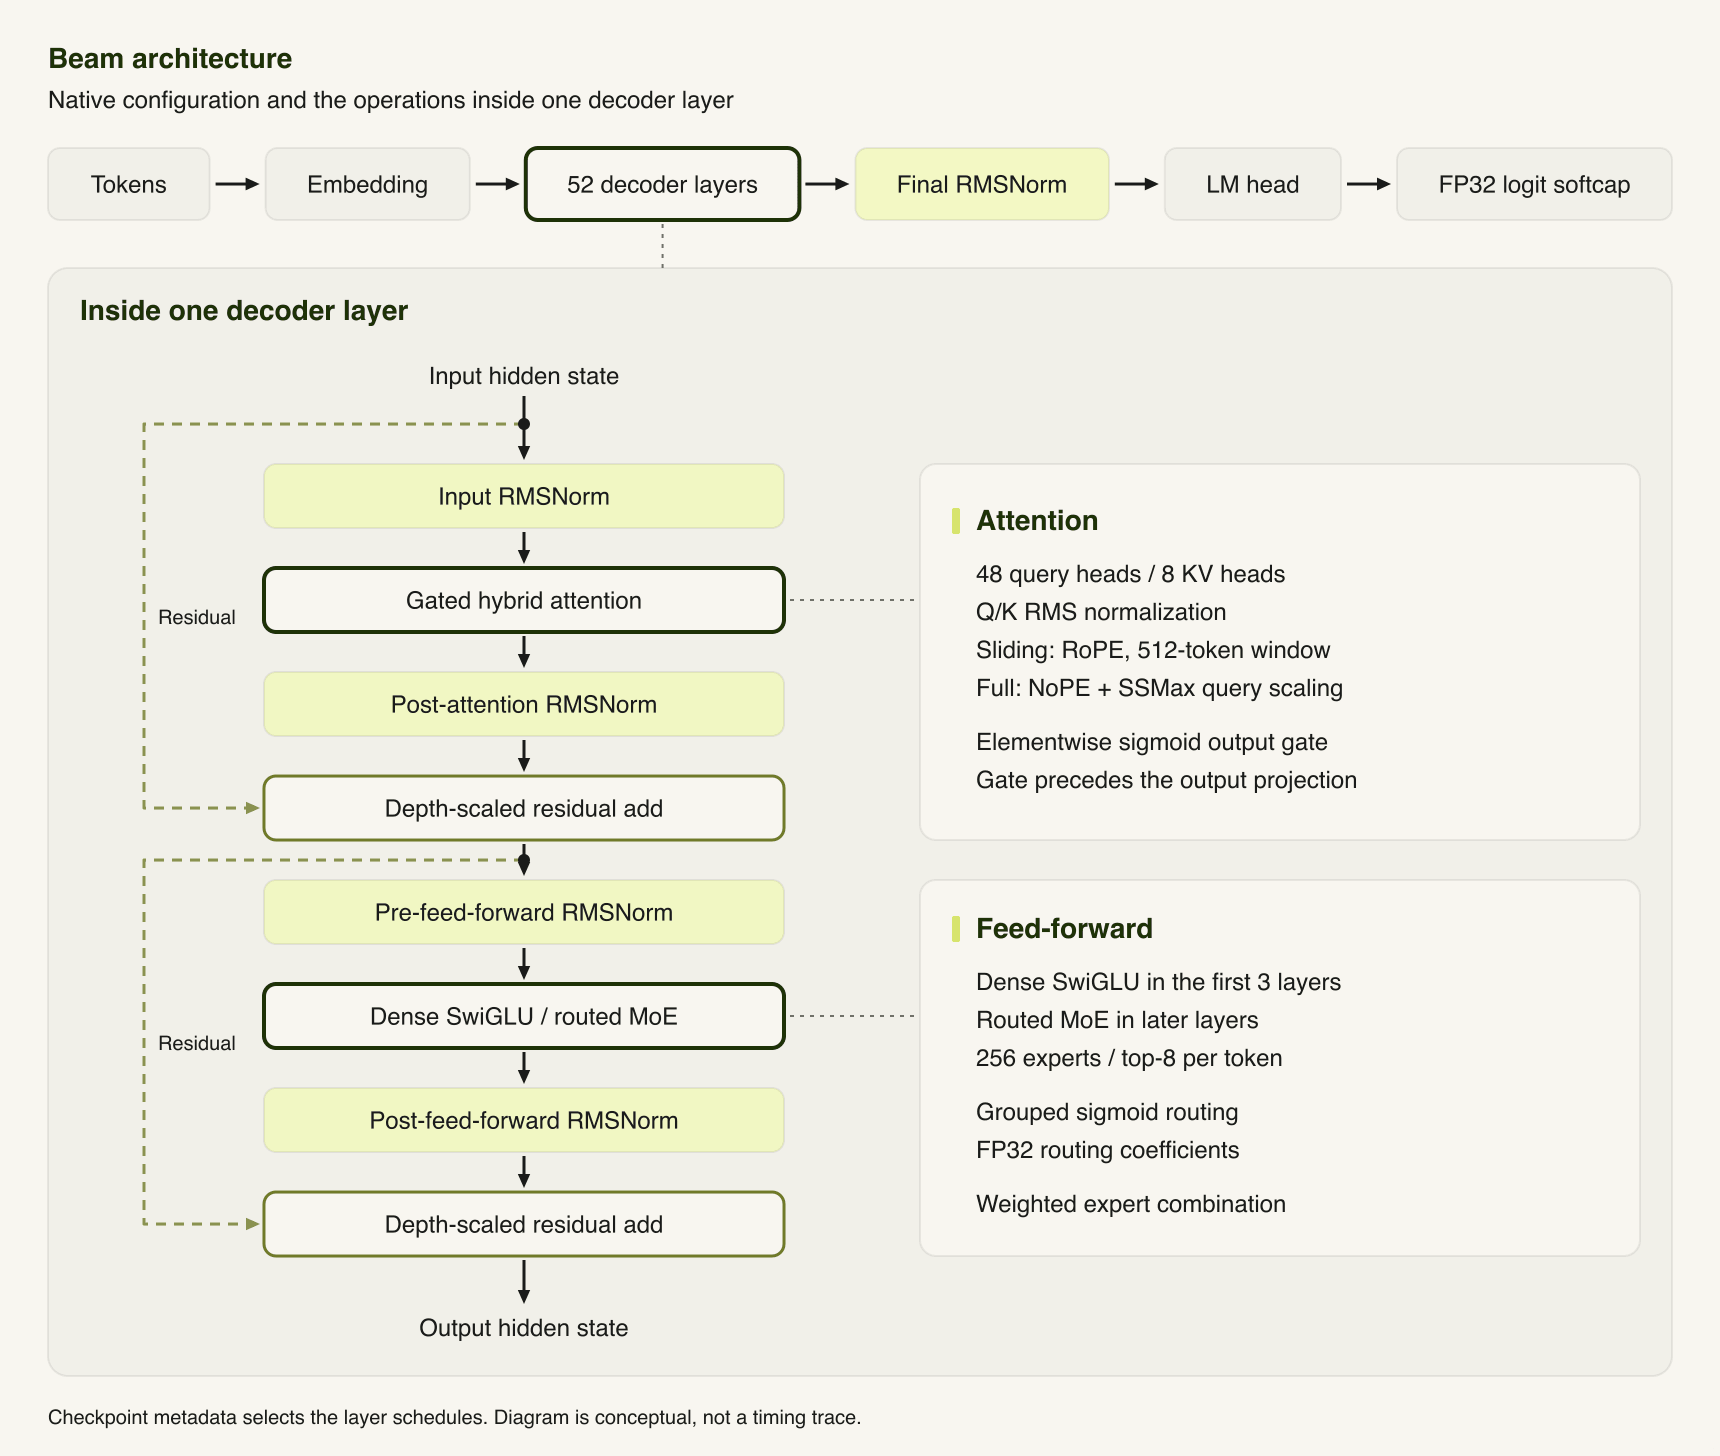
Beam 的解码器及单层内部的运算。注意力分支和前馈分支均以输出归一化和深度缩放残差相加结束。
检查点规定了注意力层和前馈层的排列方式。原生注意力排列会在每组滑动窗口层之后放置全注意力层,并以全注意力层结束。这意味着服务栈需要管理两种 KV 生命周期:全注意力需要保留完整历史,而滑动窗口注意力只需保留最近窗口。
混合注意力与输出门控
GQA 让 48 个查询头共享 8 个 KV 头,从而减少 SGLang 为每个 token 存储的 KV 缓存。滑动窗口层还会将保留的历史限制在最近窗口内,并使用 RoPE。全注意力层使用 NoPE,并通过 SSMax 根据位置缩放查询。两类层都会在注意力计算前对 Q 和 K 进行归一化。
Beam 在输出投影之前对注意力结果进行门控。另一个投影从归一化后的隐藏状态生成门控激活值;模型加上按头学习的偏置,应用 sigmoid,再将注意力输出与门控值逐元素相乘。QKV 投影和门控投影共享输入,因此在满足条件的布局下,我们可以将它们打包为一次 BF16 投影。
稠密层与分组 MoE 路由
前三个前馈层使用稠密 SwiGLU。后续层从 256 个专家中选择 8 个,并组合它们的 SwiGLU 输出。
路由器以 FP32 计算 logits。分组 top-k 选择利用 sigmoid 得分和专家校正偏置来选择专家。后端保留 FP32 路由系数,并在组合专家输出时应用 Beam 的路由缩放因子;如果内核有要求,则将该因子包含在路由权重中。
Beam 的全注意力层使用 Scalable Softmax(SSMax),使注意力在上下文增长时仍能保持集中。在 Q/K 归一化之后,位于从零开始计数的位置 p 的每个查询,都会乘以缩放因子 (1+(p+1)/2048)0.1(1+(p+1)/2048{)}^{0.1}(1+(p+1)/2048)0.1。这会逐渐使注意力分布更尖锐,抵消长上下文中 softmax 权重倾向于分散到更多 token 上的趋势。
三明治归一化与深度缩放残差
每个注意力分支和前馈分支都包含输入与输出 RMS 归一化。Beam 使用根据层深度推导出的系数,分别缩放分支和残差,然后将两者相加。两个缩放后的操作数都会先舍入为激活值的数据类型,再执行加法。
在未融合的过渡过程中,需要写出归一化后的分支结果,读取该结果以进行残差组合,再读取组合结果以执行下一次输入归一化。这些内存访问会在整个解码器中反复发生,因此我们在保留 Beam 舍入边界的同时,对这一过渡过程进行了融合。最后的解码器归一化和语言模型头之后,会以 FP32 对 logits 进行软限幅。
结合数据并行注意力的 DFlash2 推测解码
Beam 通过 SGLang 的 DFLASH 运行时支持 DFlash2。目标模型会在最终归一化之前,捕获所选解码器层的层后残差。草稿模型使用这些特征提出一个 token 块,Beam 再通过一次目标模型前向计算验证该块。
Beam 的集成新增了一条 CUDA 服务路径,将 DFlash2 与注意力数据并行相结合。使用 --attn-dp-size N 和 --enable-dp-lm-head 时,运行时会让注意力计算和草稿模型头的计算与 DP 布局保持一致。SGLang 会在 DP 填充确定最终 token 形状后,初始化目标模型验证所需的元数据,包括存在空闲对等进程的批次。
我们将草稿模型的 KV 内存计入混合池预算,使目标模型缓存分配时能够为草稿模型留出空间。草稿模型的捕获要求 PP=1,并且服务上下文必须同时满足目标模型和所选草稿模型的容量限制。
目标模型与草稿模型 KV 的统一内存
Beam 的全注意力 KV 会随上下文增长,而滑动窗口层只保留最近窗口。上游 SGLang 的统一 KV 分配器使用共享的 GPU 页预算来支撑这些分配。请求表保留稳定的虚拟 token ID;注意力读取和 KV 写入时,会将这些 ID 转换为当前的物理槽位。转换接口在两个方向上采用相同的虚拟到物理映射约定。
将 DFlash 纳入统一池,使这一布局扩展到了符合条件的全注意力草稿模型。目标模型和草稿模型在目标模型的页分配范围内保留各自独立的 KV 行,因此分配器会统一核算两者的内存。采用紧凑窗口的草稿模型可以基于目标模型的虚拟 ID,维护自己的请求到 token 映射表,从而限制其读取的页面,同时让 KV 存储继续使用共享布局。草稿模型写入时,会先转换这些 ID,再存储 KV。
具体放置方式取决于草稿模型的结构、KV 数据类型和注意力后端。使用 HiCache、主机内存池回缩或解码上下文并行时,准入检查会拒绝共享放置草稿模型。采用混合滑动窗口注意力(hybrid-SWA)的宿主模型会为回退到独立草稿模型内存的方案预留预算;不受支持的宿主模型与草稿模型组合会在启动时被拒绝。
我们将这条路径扩展到了使用解码 CUDA 图的 trtllm_mha 目标模型和草稿模型。它使用根据当前迭代读写范围规划的页表,并将新分配的页范围清零。在 SM90/SM120 上,它将 fmha_v2 预填充工作区与 XQA 解码信号量分离。该扩展会在 TRTLLM 后端的目标模型验证和草稿模型执行过程中传递转换后的 KV 位置。
用于预填充/解码分离的异构 TP
预填充和解码处理的 token 批次形状不同,因此采用分离架构的服务器可以为每个阶段分别选择注意力 TP 大小。对于 Beam 的混合注意力,当 KV 头的归属在两个组之间发生变化时,交接过程必须保留全注意力 KV 和当前有效的滑动窗口。
PR #40909 通过 NIXL 和 Mooncake,为混合滑动窗口模型新增了这条传输路径。它使用现有的 rank 归属映射,按 token/头分段复制窗口状态,将每个 token 的头分段放入匹配的解码缓冲区。全注意力 KV 通过暂存区传输;窗口状态则沿按头切片的路径传输。
推理、工具调用与 LoRA
SGLang 读取 Beam 检查点中的响应模板,为流式和非流式请求区分推理内容、答案和工具调用。该集成覆盖 Chat Completions、Responses 和 Messages,并支持 Beam 的工具语法和 JSON 输出约束。
BF16 LoRA 推理服务使用 Triton MoE runner,覆盖注意力投影与门控、稠密 MLP、路由专家、嵌入层和输出头。加载器保留注意力门控的限定名称,避免与 MLP 门控目标发生名称冲突。
我们支持原生 BF16、FP8 和 NVFP4 检查点,并通过 FlashInfer MegaMoE 新增了一条 NVFP4 专家并行路径。该路径要求同时使用 flashinfer_megamoe runner 和 all-to-all 后端;BF16 和动态 FP8 不在此次 Beam 扩展的支持范围内。优化部分将解释这条路径中的 token 归属和通信流程。
在这些格式下,路由器均保持其精度和路由缩放约定。量化检查点和 LoRA 保留独立的 QKV 模块与注意力门控模块,供各自的加载和适配器路径使用。
缓存的 Beam 前缀包含全注意力历史,以及在复用边界处所需的滑动窗口状态。SGLang 将两者与分页缓存对齐,使请求能够从该前缀继续执行,同时保留完整的当前窗口。分块预填充将长提示词分段处理,并与解码任务交错执行。
HiCache 将前缀复用从 GPU 内存扩展到主机内存和受支持的存储后端。启用 HiCache 后,Beam 仍保留其混合 SWA 池以及滑动窗口带来的内存节省。从主机内存回载时,使用各流水线阶段的本地层映射。
Beam 的归一化和门控路径在投影与集合通信操作前后串联了多个小操作。我们将这些操作链融合,以消除中间存储、复制和内核启动。
跨投影、归一化和集合通信边界的内核融合。我们将 all-reduce、输出归一化、缩放残差相加和下一层输入归一化融合,并将符合条件的融合边界扩展到 NVFP4。PDL 允许后续归一化操作在等待依赖完成之前加载权重。滑动窗口层将 Q/K 归一化与 RoPE 融合。全注意力层使用融合的 Q/K 归一化,并复用 SSMax 位置缩放因子。符合条件的 BF16 层将 QKV 投影和门控投影合并到一次内核启动中。注意力门控融合了偏置相加、sigmoid 和乘法。BF16 MoE 集合通信路径还整合了本地专家求和、路由缩放和 BF16 舍入。
跨投影、归一化和集合通信边界的内核融合。我们将 all-reduce、输出归一化、缩放残差相加和下一层输入归一化融合,并将符合条件的融合边界扩展到 NVFP4。PDL 允许后续归一化操作在等待依赖完成之前加载权重。滑动窗口层将 Q/K 归一化与 RoPE 融合。全注意力层使用融合的 Q/K 归一化,并复用 SSMax 位置缩放因子。符合条件的 BF16 层将 QKV 投影和门控投影合并到一次内核启动中。注意力门控融合了偏置相加、sigmoid 和乘法。BF16 MoE 集合通信路径还整合了本地专家求和、路由缩放和 BF16 舍入。
使用 MegaMoE 整合专家通信与计算。我们在 FlashInfer MegaMoE 上启用了 Beam 的 NVFP4 专家,并将其 runner 与 MegaMoE all-to-all 后端配套使用。FlashInfer 在其融合的 EP 内核中执行专家分发、计算和结果合并。Beam 提供显式的专家 ID 和路由权重,并接收各 rank 所属 token 的完整输出。融合后的衔接操作保留了两个缩放残差操作数在相加前各自的舍入行为。注意力与 MoE 分别检查是否满足融合条件;MoE 归约遵循所选后端的归属规则。CPU 卸载、空流水线阶段和不受支持的集合通信形状仍使用常规路径。所有 EP rank 都参与专家执行,包括没有本地 token 的 rank。
使用 MegaMoE 整合专家通信与计算。我们在 FlashInfer MegaMoE 上启用了 Beam 的 NVFP4 专家,并将其 runner 与 MegaMoE all-to-all 后端配套使用。FlashInfer 在其融合的 EP 内核中执行专家分发、计算和结果合并。Beam 提供显式的专家 ID 和路由权重,并接收各 rank 所属 token 的完整输出。融合后的衔接操作保留了两个缩放残差操作数在相加前各自的舍入行为。注意力与 MoE 分别检查是否满足融合条件;MoE 归约遵循所选后端的归属规则。CPU 卸载、空流水线阶段和不受支持的集合通信形状仍使用常规路径。所有 EP rank 都参与专家执行,包括没有本地 token 的 rank。
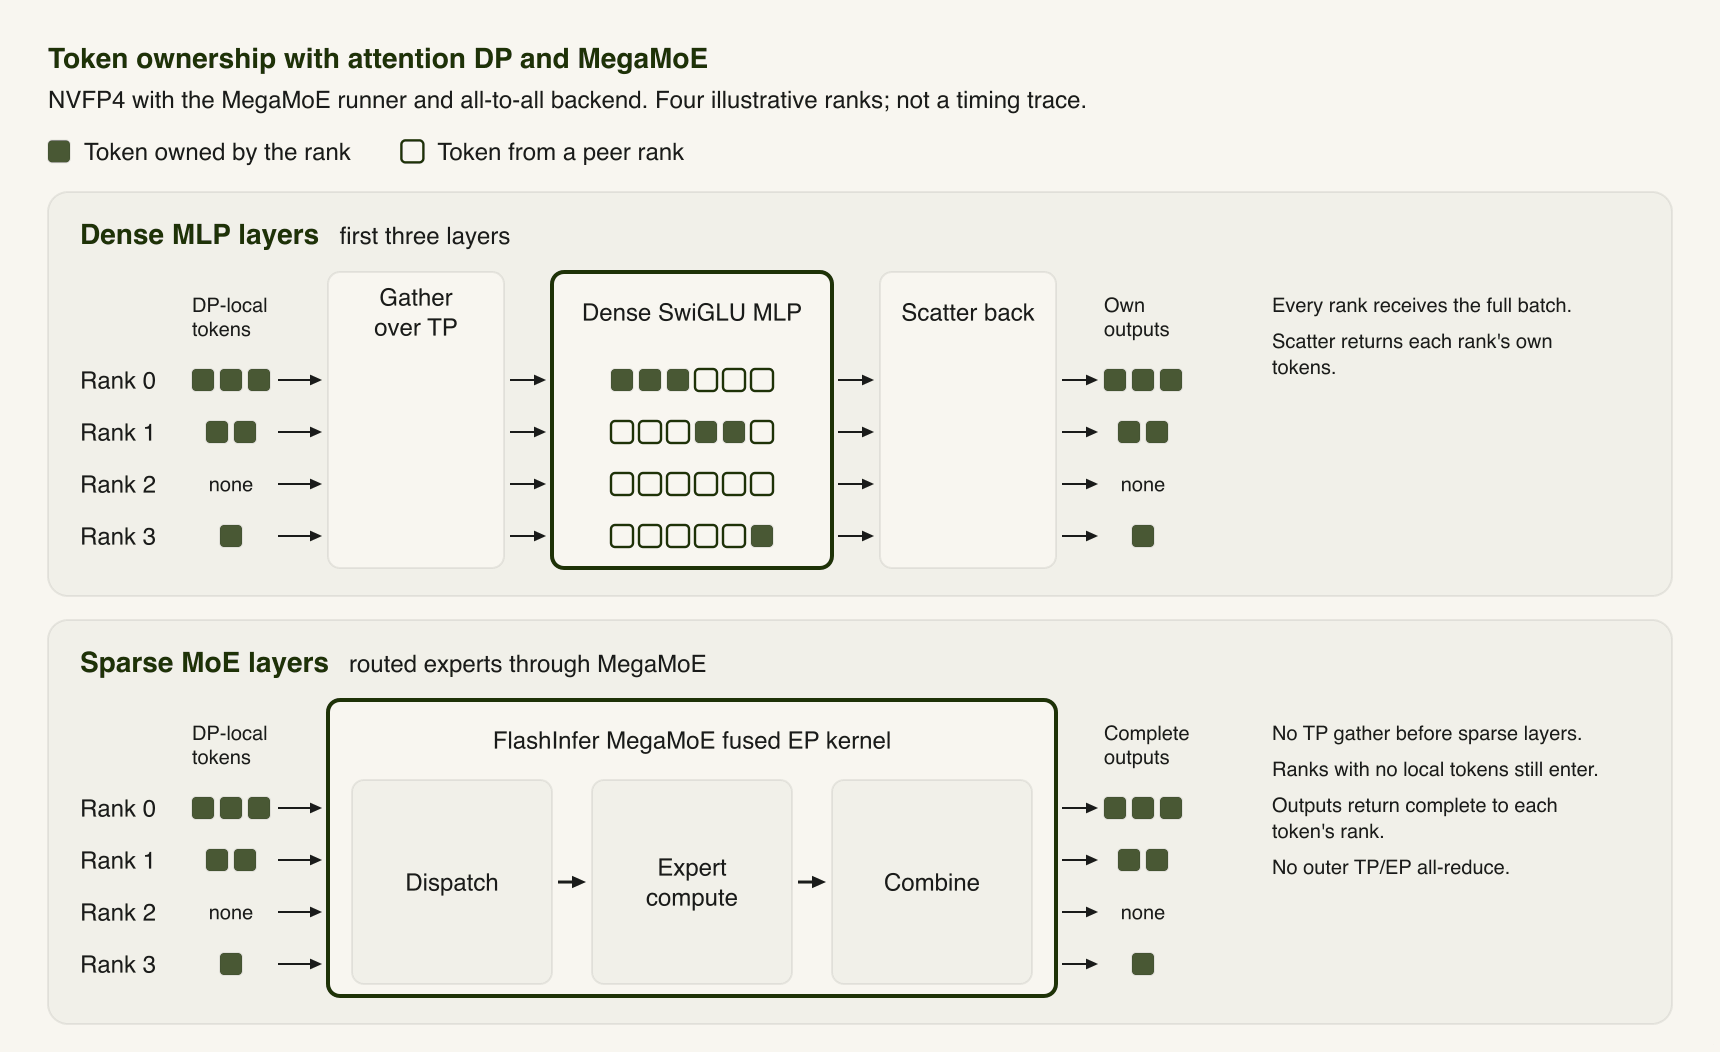
采用数据并行注意力时 MegaMoE 的 token 归属。稠密 MLP 层保留 TP gather/scatter;稀疏层将 DP 本地 token 送入融合的专家分发、计算和结果合并流程。完整输出返回各 token 所属的 rank,无需额外执行 all-reduce。
预填充和解码为专家内核带来了不同的 token 形状。我们为 gate/up 投影和 down 投影新增了 GB300 分块配置,并针对部分预填充形状使用 TMA。Triton 调优器还会从 Beam 配置中读取专家维度。
对于单 token 解码,可选择启用一条使用两个 GEMV 内核计算路由专家输出的路径。它保留了 gate/up 投影和激活的 BF16 舍入边界,并在对 down 投影输出进行舍入之前应用 FP32 路由权重。调用方仍负责专家归约、路由缩放和 TP 通信。其 FP32 归约顺序与 tensor-core 路径不同。
我们正通过 SGLang-TorchTPU 为 Beam 提供首日 TPU 支持。SGLang-TorchTPU 是一个原生 PyTorch 后端,用于在 TPU 上运行 LLM、VLM 和扩散模型推理。它将 TPU 加速与 RadixAttention、HiCache 等 SGLang 功能相结合,为智能体工作负载提供兼具成本效益与生产就绪能力的推理服务。
Beam 的 TPU 运行方案以及 SGLang-TorchTPU 的访问权限即将开放。通过此 Google Form 登记,即可获取最新进展。
Miles 通过 Megatron 插件支持 Beam,并使用 Reflection 的 SGLang 构建版本执行 rollout。训练后端实现了 Beam 的夹心式归一化与按深度缩放的残差、SSMax 注意力缩放、混合滑动窗口注意力、门控注意力输出、无辅助损失的 MoE 路由,以及 FP32 最终 logit 软截断,并通过 Megatron-Bridge 直接加载 Hugging Face 检查点。目标是让训练器与 rollout 对相同响应计算出的对数概率尽可能接近。
并行机制。该后端支持 DP、TP、SP、EP、专家 TP 和 PP。TP 对包括输出门控在内的注意力投影进行分片,SP 则沿序列维度对这些投影之间的激活进行分片。EP 和专家 TP 对路由专家的分片独立于注意力布局,各流水线阶段可以包含不同数量的层。启用路由重放后,训练器与 rollout 之间的差距在这些布局下保持相同水平,且不会随训练步数增加而扩大。
路由重放。Rollout Routing Replay 可按需启用。SGLang 记录每个生成 token 选中的专家,训练器的 MoE 层复用这些分配结果,而不重新计算 top-k,因此接近并列的路由器分数不会导致训练时选择不同的专家路径。重放的路由同样应用于激活重计算和每个流水线阶段。
数值一致性。在 Beam 对精度敏感的环节,训练器均遵循 SGLang 的数值计算方式。最终 logit 软截断在 FP32 中执行,按深度缩放的残差相加也在与引擎融合内核相同的位置进行舍入。路由器门控在训练、检查点保存与加载以及权重同步过程中始终保持 FP32。结合这些改动,训练器与 rollout 之间的对数概率差距缩小了一半,降至 BF16 归约顺序噪声的水平。确定性设置使多次运行的结果可复现。
共置与分离式部署。Beam 支持这两种模式。分离式运行将训练和 rollout 放在不同的 GPU 上,让下一次 rollout 与当前训练步骤重叠执行;TIS 用于缓解这种策略滞后一步所导致的离策略偏差。共置运行共享同一组 GPU,并同步交替执行,在引擎生成期间将训练器状态卸载到节点本地 NVMe。两种模式都会在每一步完成后,将更新后的 BF16 权重分桶传输给引擎。
LoRA 训练支持。LoRA 训练通过 Megatron-Bridge PEFT 进行,覆盖注意力、稠密 MLP 和路由专家的投影。适配器以 Hugging Face 格式导出,并由 SGLang 直接提供推理服务。在 RL 期间,仅通过权重更新会话向引擎流式传输适配器权重,基础权重保持常驻,引擎会验证每个接收到的适配器的校验和。
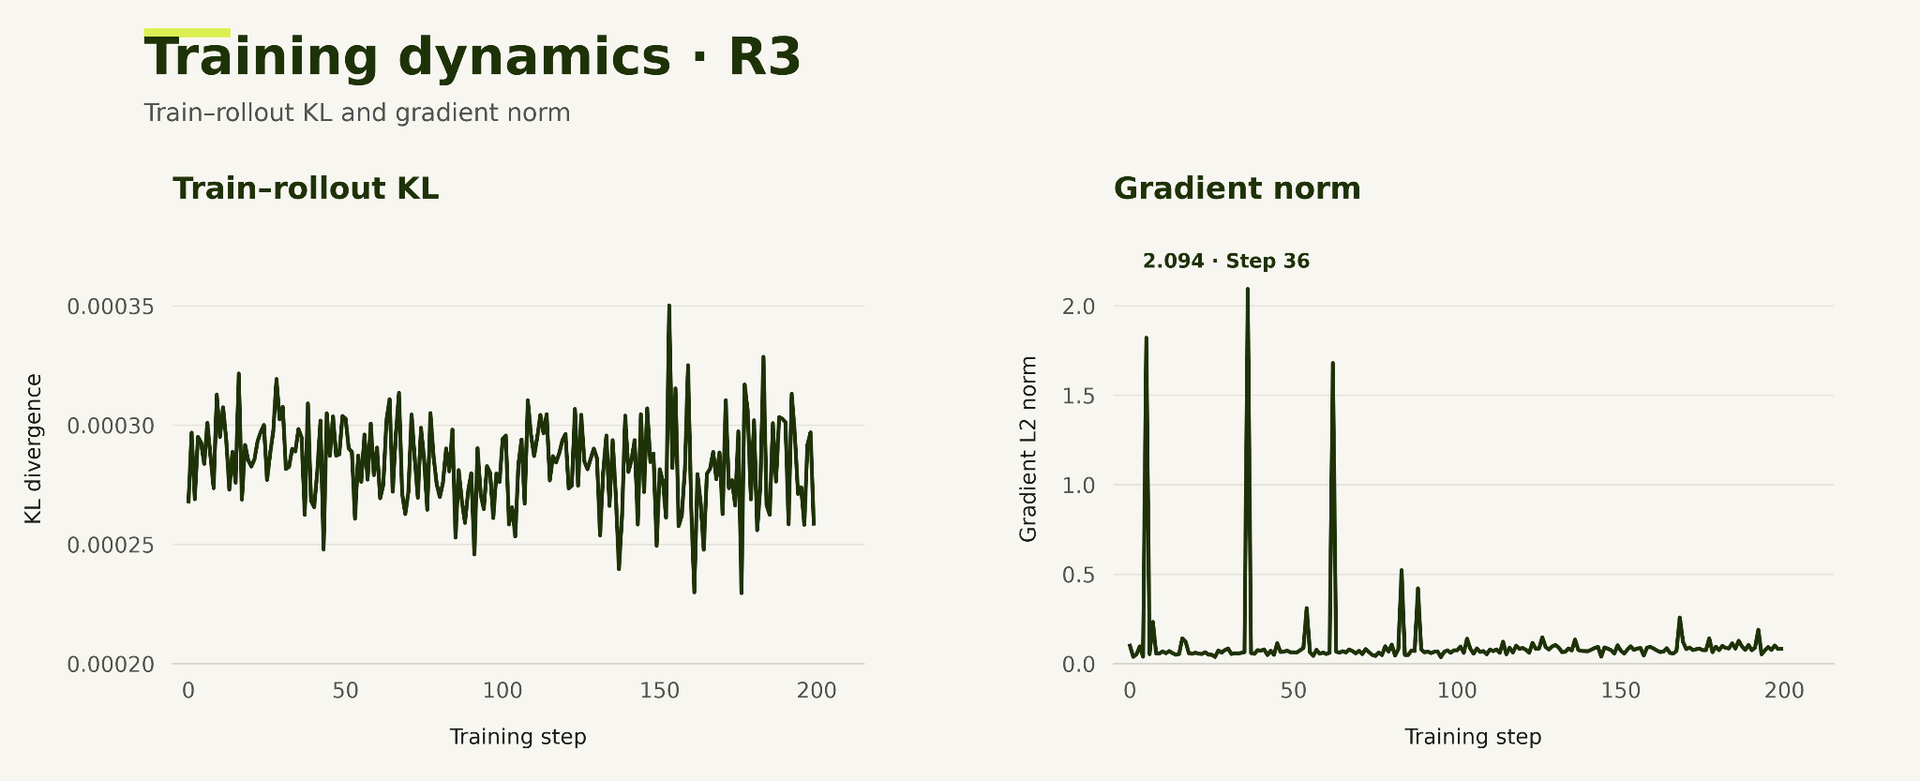
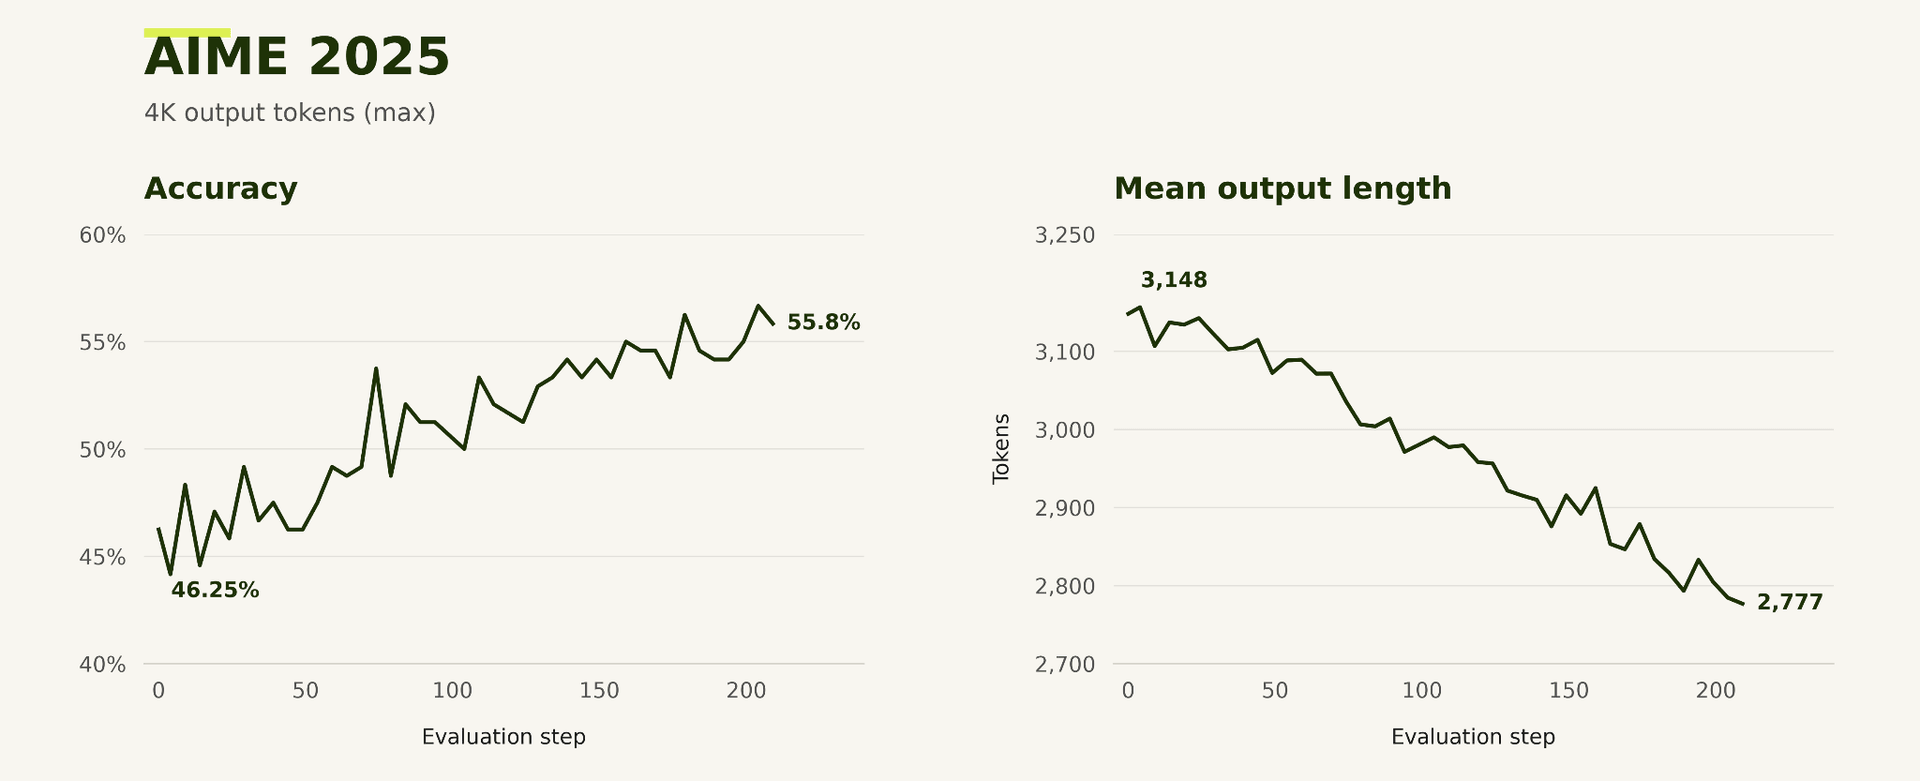
下图展示了一次在 DAPO-Math-17K 上进行的全参数 GRPO 训练:从 Beam 的早期检查点出发,在 96 块 H200 GPU 上以分离式异步模式运行。其中,64 块 GPU 用于训练,配置为 TP8、SP、EP8、专家 TP8 和 DP8;另外 32 块 GPU 运行两个 TP16 SGLang 引擎。每轮 rollout 为 32 条提示各生成 8 个响应,响应长度上限为 4K token,并用于一次优化器更新。在前 204 步中,AIME25 准确率从 46.3% 提升至 56.7%,同时平均响应长度下降。运行期间,训练曾从保存的检查点恢复过一次。
OpenHands 智能体编程并发扫描测试
我们使用 OpenHands 多轮智能体编程工作负载,收集了 Beam NVFP4 在 4 块 GB300 GPU 上采用 TP4 配置时的性能结果。每段对话以约 74K token 的提示开始,每轮输出约 220 个 token,共进行 13 轮。后续轮次复用前缀,整体缓存命中率约为 92%。我们分别测试了 1、4、8、16 和 32 段对话的并发度,并绘制了每 GPU token 吞吐量(tok/s/GPU)与 p50 交互速度(tok/s/user)的关系图。总吞吐量包含缓存命中的输入 token。这些测量使用包含 8 个 token 的 DFlash2 块,将模拟接受长度固定为 4,并使用真实的草稿 token;它们并未测量自然情况下的草稿接受情况或模型准确率。
AgentX 智能体编程并发扫描测试
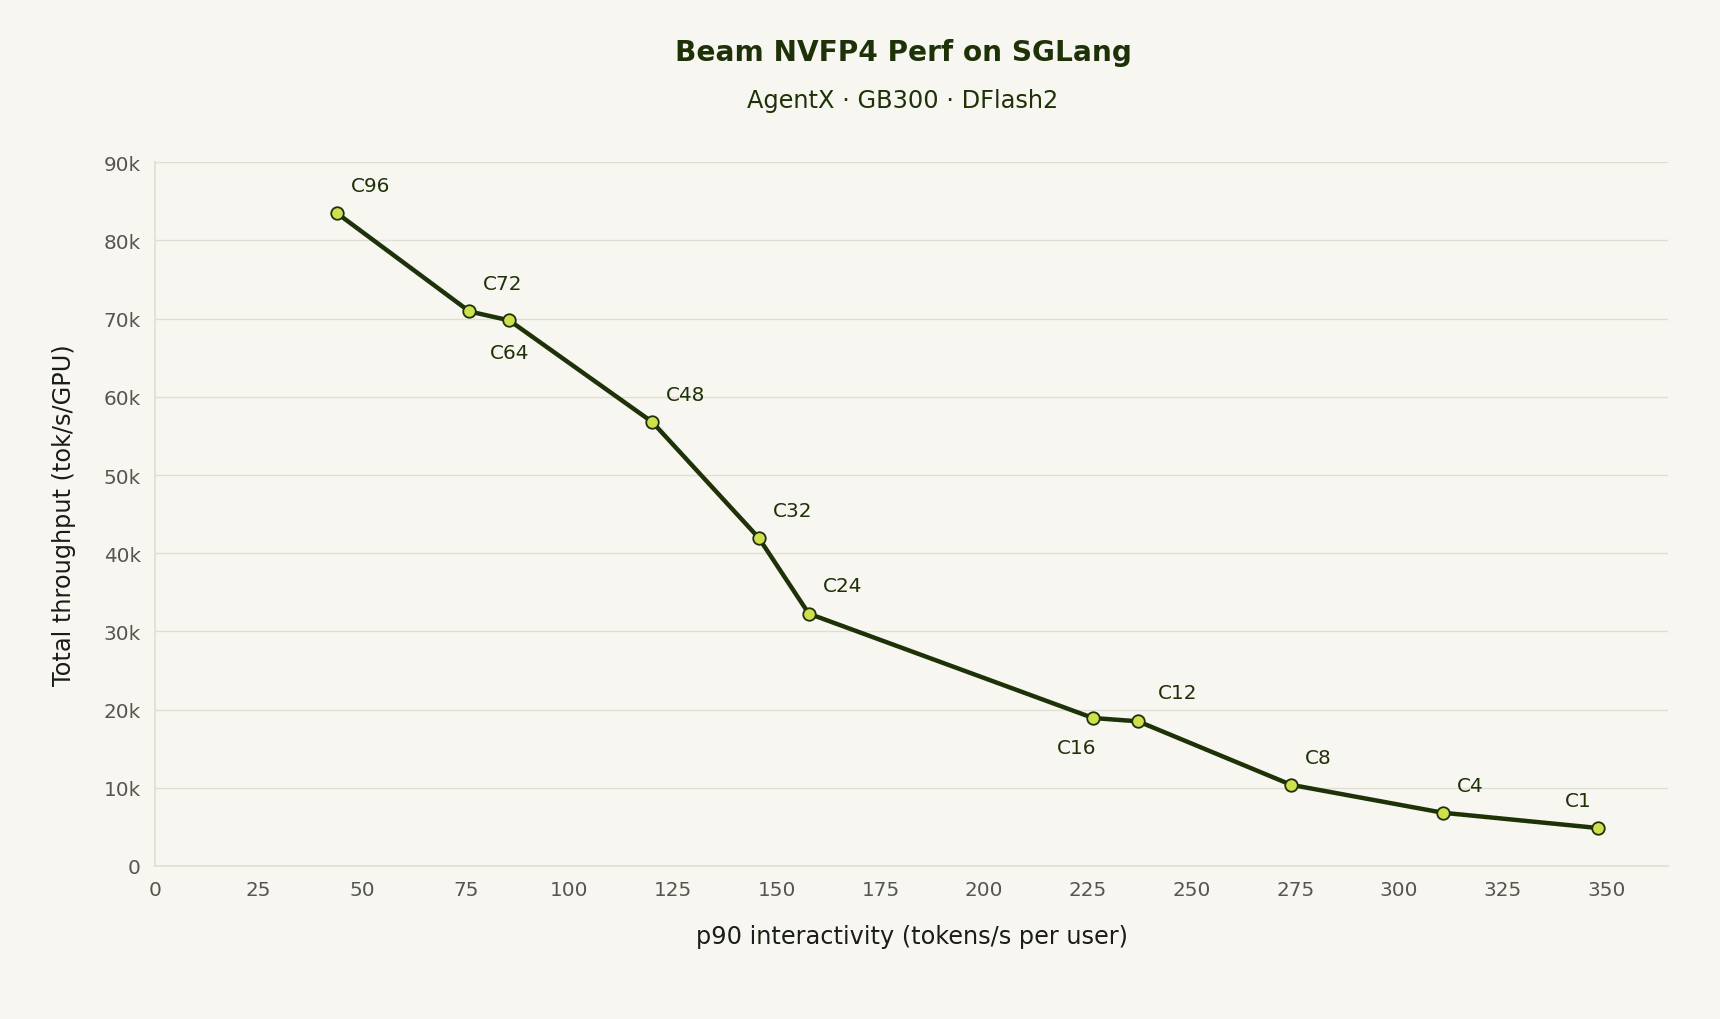
我们与 NVIDIA 合作,使用 AgentX 收集了 Beam NVFP4 在 4 块 GB300 GPU 上采用 TP4/EP1 配置时的性能结果。AgentX 是 SemiAnalysis 开发的一款回放工具,用于回放录制的多轮智能体编程轨迹。AgentX 会复现真实编程智能体会话中的提示长度、前缀共享、子智能体扇出以及轮次间的时间间隔,因此结果反映的是“真实的智能体负载”。同一会话中的请求共享较长的前缀,因此 92% 至 96% 的输入 token 会命中前缀缓存。测试使用了 FP8 KV 缓存,投机解码块大小设为 8。我们将并发度从 1 个会话逐步提高至 96 个会话,并绘制了每 GPU token 吞吐量(tok/s/GPU)与 p90 交互速度(tok/s/user)的关系图。在并发度为 96 时,吞吐量达到 83,504 tok/s/GPU,交互速度为 43.9 tok/s/user;单会话运行时的交互速度为 348.0 tok/s/user。
我们衷心感谢以下组织和个人,感谢他们为 Beam 的 SGL 集成开发作出的贡献,以及对其性能开展的大量基准测试。
SGLang 社区/RadixArk:Jimmy Shong、Andy Ye、Xiaoyu Zhang、Yanbin Jiang、Qiaolin Yu、Alex Nails、Yuhao Yang
Reflection:Aksel Joonas Reedi、Aymen Kallala、Christopher Vanderschuere、Ewen Wang、Florent Gbelidji、George Antoniadis、Joel Gustafson、Yoni Gozlan、Iaroslav Geraskin、Kai Wu、Neil Gollapudi、Renault Young、Asfandyar Qureshi、Thibaut Barroyer、Matthias Reso。
NVIDIA:Jinze Xue、Dong Xu、Michael Loh、Matthew Radzihovsky
OpenHands 测试复现
Beam OpenHands 并发扫描测试所用的脚本位于公开的 bench-openhands-gb300-sweep-beam 分支的 benchmark/beam_openhands 目录中。首先准备好 Beam Docker 镜像,然后使用 reproduce.py 安装隔离的客户端、构建数据集,并在一个配备 4 块 NVIDIA GB300 的节点上,采用 TP4/EP1 配置,依次测试 1、4、8、16 和 32 的并发度。
服务端使用该分支中的 SGLang。客户端使用提交版本为 acd09b44 的 EvalScope,通过 Beam 回放适配器运行其 swe_smith 多轮工作负载。并发度为 16 和 32 时,HiCache 为每个 rank 配置 88 GB 容量;并发度较低时则禁用 HiCache。
该工作负载是一个 OpenHands 多轮智能体回放任务,基于 nebius/SWE-rebench-openhands-trajectories 构建,并使用 nvidia/OpenScienceReasoning-2 中的文本进行填充:每段对话共 13 轮,首轮包含 74,160 个原始输入 token,之后每轮新增 753 个输入 token,每轮输出 220 个 token。随着对话历史不断增长,每个请求的提示长度约为 80K token,整体前缀缓存命中率为 92%。
服务端启动命令如下,其中 <cc> 同时设置最大运行请求数和解码 CUDA Graph 的批大小上限。
export MODEL_PATH=/models/Beam-1.0-501B-A23B-NVFP4
export DRAFT_PATH=/models/Beam-1.0-501B-A23B-DFlash2
export SGLANG_SIMULATE_ACC_LEN=4
export SGLANG_SIMULATE_ACC_METHOD=match-expected
export SGLANG_SIMULATE_ACC_TOKEN_MODE=real-draft-token
export SGLANG_RESPONSE_TEMPLATE_TURN_GRAMMAR=0

export OMP_NUM_THREADS=4 MKL_NUM_THREADS=4
export PYTHONNOUSERSITE=1 TZ=UTC
export HF_HUB_OFFLINE=1

CC=16  # Set to 16 or 32
python3 -m sglang.launch_server \
    --model-path "$MODEL_PATH" \
    --served-model-name beam \
    --quantization modelopt_fp4 \
    --tp-size 4 \
    --ep-size 1 \
    --attn-dp-size 1 \
    --nnodes 1 \
    --node-rank 0 \
    --dist-init-addr 127.0.0.1:39746 \
    --attention-backend trtllm_mha \
    --page-size 64 \
    --mem-fraction-static 0.80 \
    --enable-unified-memory \
    --reasoning-parser beam \
    --tool-call-parser beam \
    --speculative-algorithm DFLASH \
    --speculative-draft-model-path "$DRAFT_PATH" \
    --speculative-draft-attention-backend trtllm_mha \
    --speculative-num-draft-tokens 8 \
    --enable-hierarchical-cache \
    --hicache-size 88 \
    --max-running-requests "$CC" \
    --cuda-graph-max-bs-decode "$CC" \
    --context-length 1048576 \
    --chunked-prefill-size 16384 \
    --prefill-decode-interval 0 \
    --enable-cache-report \
    --enable-metrics \
    --tokenizer-worker-num 1 \
    --host 0.0.0.0 \
    --port 30080

CC=1  # Set to 1, 4, or 8
python3 -m sglang.launch_server \
    --model-path "$MODEL_PATH" \
    --served-model-name beam \
    --quantization modelopt_fp4 \
    --tp-size 4 \
    --ep-s