
8.0
热点
AI SCORE
技术实践2026-10-12 22:01
Bedrock 提示缓存失效为何没有报错
dev.to · AI#Claude#提示缓存#成本优化
Editor brief · 编辑速览
文章梳理 Claude 在 Bedrock 上提示缓存静默失效的五类问题,并介绍识别与修复思路。作者报告一次 LiteLLM 升级导致缓存命中率骤降、费用增加,并实测缓存回溯范围。
本文最初发表于我的 Substack。
Amazon Bedrock 上的 prompt caching 可能悄悄失效,连一条报错都没有。我在 Bedrock 上运行一个 Claude Agent 平台,梳理了本季度主流 Agent 框架中与 Bedrock 缓存有关的 bug 报告,发现有五类问题反复出现。下面逐一说明:会发生什么、如何判断自己是否遇到了,以及该改哪里。
7 月,一次 LiteLLM 升级改变了 Bedrock 请求中 system prompt 的位置。Claude Code 流量的缓存命中率从约 90% 降到了 25–45%,每天的费用涨到了原来的 2–3 倍,持续了六天才有人查明原因。每个请求返回的都是 200。AWS 文档写了缓存规则,但对 Agent 影响最大的一条——Bedrock 会向前回溯多远,查找已有缓存条目——只写了“约 20 个 content block”。所以,我实际测了一下。
Datadog 发现,2026 年 3 月,其客户追踪记录中的全部输入 token,有 69% 来自 system prompt:每次调用都会重新发送的指令、策略和工具使用说明。Prompt caching 正是控制这部分成本的关键。Bedrock 可以复用请求开头的内容,也就是你的指令、工具列表和前面的对话,并按正常输入价格的大约十分之一计费。
你需要用一个 cache point 标记可复用部分的结束位置。下一次请求只有在这个位置之前的所有内容完全一致,而且 Bedrock 能找到之前的缓存条目时,才能复用缓存。只要其中一个条件不满足,请求仍然可以正常执行。你只是又付了一次全价,还要为再次写入缓存多付 25%。
这五类问题大致按 Agent 遇到它们的顺序排列:先是 cache point 放在哪里,再是一次密集的工具调用会怎样影响它,然后是 prompt 本身、构建 prompt 的库,以及通过流式响应重建消息的过程。
在 Agent 循环中,大多数新增 token 来自工具调用和工具结果,而不是用户消息。如果 cache point 只放在最后一条用户消息上,它就会一直停留在最初的 prompt 上,工具调用历史则不断堆积在它后面。这样,每次调用都要为这些历史内容支付全价。
Cline 4.1.0 遇到的就是这个问题。它的 Bedrock 代码把 cache point 放在最后一条 role 为 “user” 的消息上,而在它的消息格式中,工具结果有自己的 role。因此,这个位置始终没有越过开场的 prompt。用户看到的现象是:每个会话开始时写入一次缓存,之后再也没有写入(cline/cline#13738;4.0.12 没有这个问题)。
检查方法:在一个较长的 Agent 会话中,缓存读取量应该随着每次调用持续增长。如果输入 token 不断增加,缓存读取量却停止增长,说明 cache point 没有移动。修复方法是把 cache point 放到最新消息的最后一个 block 上,不管这条消息的 role 是什么。
Bedrock 查找之前的缓存条目时,只会从新的 cache point 向前搜索固定数量的 content block。我测出了这个边界:从旧 cache point 起新增 21 个 block 时,下一次请求仍然命中;新增 22 个时,每次都会未命中。每个工具调用和每个工具结果都算一个 block。因此,一轮中并行执行十个或更多工具调用,就可能让旧缓存条目超出搜索范围。
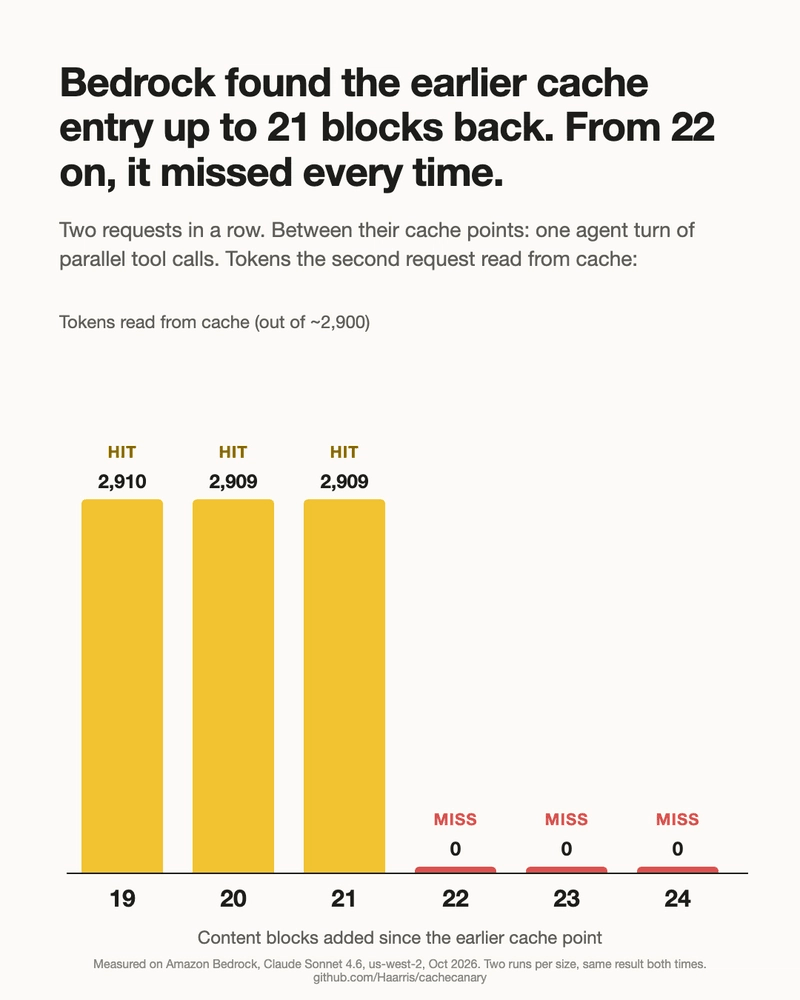
pydantic-ai 在自己的测试中也发现了同样的边界。执行 10 次并行调用后,新增了 21 个 block,下一次请求从缓存中读取了 6,827 个 token。执行 11 次调用后,新增了 23 个 block,缓存读取量变成了 0,并重新写入了 7,534 个 token(pydantic/pydantic-ai#9404)。一位 Strands 用户在一轮中执行了 18 次调用,随后缓存读取量为 0,写入量为 134,082 个 token(strands-agents/harness-sdk#3348)。同样的请求在 Anthropic 自己的 API 上不会未命中,因为在那里,一组连续的工具调用只算一个位置。Bedrock 则把每个调用单独计算。
检查方法:查看工具调用最密集的那些轮次之后紧接着的请求。如果这些请求的缓存读取量为零,而其他请求的读取量正常,就是这个问题。修复方法:当一轮新增超过约 18 个 block 时,保留上一个 cache point。Bedrock 允许每个请求设置四个 cache point,所以通常还有空间。
缓存采用前缀匹配。日期、请求 ID、用户名,或者针对每个条目的专用指令,只要放在 cache point 前面,就会让每个请求都变得独一无二。结果是每次调用都写入缓存,却没有一次读取缓存。
一个 AWS 示例应用清楚地展示了这个问题。在审查同一份文档的 28 次调用中,CloudWatch 记录了 196,680 个 token 写入缓存,读取量却是 0,原因是 cache point 被放在了每个条目各自的指令后面。把它移到文档之后,第二个条目就从缓存中读取了 4,624 个 token(aws-samples/review-and-assessment-powered-by-intelligent-documentation#327)。还有更隐蔽的情况。在一套 Mastra 配置中,消息存入 Postgres 的 jsonb 列后,再读取出来时,属性键的顺序发生了变化,导致 prompt 的字节内容改变,缓存随之失效(mastra-ai/mastra#25929)。
检查方法:把同一个请求执行两次,比较 cache point 之前的字节内容。它们必须完全一致。修复方法是把动态文本放到最后一个 cache point 后面,并以固定顺序序列化结构化内容。
大多数团队不会手动编写 cache point,而是由框架或网关添加,而且往往只对它认识的模型 ID 添加。升级库、切换到新的模型 ID,或者改用 application inference profile ARN,都可能让 cache point 悄悄消失。
前面提到的 LiteLLM 事故就是这种情况。这并不少见:MLflow 的 AI Gateway 会把 Bedrock 聊天消息转换成普通字符串,根本不发送 cache point(mlflow/mlflow#26477);LangChain 的 openwiki 则发现,其缓存中间件跳过了 application inference profile ARN(langchain-ai/openwiki#853)。
检查方法:如果缓存读取量和写入量都是零,就说明没有 cache point 传到 Bedrock。每次升级库或更换模型后,都要检查这一点。
当你以流式方式接收响应,并把它保存回对话时,库会根据各个 chunk 重建 assistant 消息。如果重建结果不是一整块文本,历史消息的结构就会发生变化。
在 LangChain.js 中,Bedrock 开启 extended thinking 后,流式响应中的文本 chunk 丢失了 block index,导致一条回答被保存成数百个独立的文本 block。这让下一个 cache point 远远超出了回溯搜索上限(langchain-ai/langchainjs#11357)。
检查方法:数一数保存下来的 assistant 消息里有多少个 content block。一条回复应该是一个文本 block,而不是几百个。
AWS/Bedrock 命名空间下的两个 CloudWatch 指标,基本就能说明情况:CacheReadInputTokenCount 和 CacheWriteInputTokenCount,按模型 ID 分开查看。在稳定流量下,读取量应该是写入量的很多倍。有写入、但读取量接近零,说明缓存已经开启,却没有命中,这比完全不用缓存还贵。两者都接近零,则说明没有发送 cache point。
如果 prompt 保持完全一致,但命中率在繁忙时段下降,就检查 cross-region inference。AWS 提到,在需求高峰期,其路由“可能导致缓存写入增加”,因为请求可能被分配到一个没有缓存副本的 Region。
要查明原因,可以开启 Bedrock model invocation logging。日志会记录每次调用的缓存计数,以及调用者是谁。
有两项。第一是 Bedrock 的缓存诊断:Anthropic 的 Console 现在已经能解释请求为什么没有命中缓存,Bedrock 还不能。第二是 AWS 文档给出准确的回溯数量,而不是“约 20 个”,因为多一个或少一个工具调用,就决定了 Agent 为历史内容支付的是 0.1 倍还是 1.25 倍的费用。
回溯数量来自我自己的测量:2026 年 10 月,在 Amazon Bedrock 上使用 Claude Sonnet 4.6,Region 为 us-west-2,每种规模发送两个请求,并分别用全新的 prompt 重复运行两次,确保旧缓存条目不会造成假命中(脚本位于 CacheCanary 仓库中的 scripts/live_lookback_boundary.py)。价格和倍率来自 AWS 公布的按需费率。其他数据来自 LiteLLM 的事故复盘(docs.litellm.ai/blog/bedrock-invoke-prompt-caching-incident);Datadog 的《监控 prompt caching,优化 token 使用量》(2026 年 9 月);Anthropic 的《通过 Claude Platform 降低成本并提升性能》(2026 年 9 月);AWS Bedrock 的 prompt caching 文档;以及各节中引用的公开 GitHub issue。
我在 Ruby AI 构建 Agent 平台,该平台在 Bedrock 上运行 Claude。我还为上面的检查做了一个免费的轻量工具 CacheCanary(github.com/Haarris/cachecanary)。它会读取调用日志,展示命中率以及未命中带来的成本,还能比较两个已保存的请求,告诉你第二个请求为什么没有命中。本文发布后,我还为 LiteLLM、Strands Agents 和 LangChain 写了经过测试验证的指南,准确展示它们各自向 Bedrock 发送了什么,以及缓存在哪一步失效。
当生产环境出了问题,而文档没有提前提醒我时,我就会写这样的文章。下一篇会先发布在我的 Substack 上。
如需采取进一步行动,你可以考虑屏蔽此人和/或举报滥用行为。