
8.0
热点
AI SCORE
技术实践2026-10-11 22:12
票据遮挡测试暴露视觉模型高置信幻觉
dev.to · AI#视觉模型#模型评测#幻觉
Editor brief · 编辑速览
作者用部分遮挡的票据测试四个视觉模型,得到四种不同金额,其中三个报告了 92–100 的置信度。测试区分可推算与信息不足的情况,检验模型能否计算或明确拒绝猜测。
Kaggle Benchmarking Challenge 参赛作品
这是提交给 Kaggle Benchmarking Challenge 的一份参赛作品。
这里有一张收据。其中一个明细项目和总金额的一半被胶带遮住了。对于“总金额是多少?”,正确答案应该是“无法判断”:可见的数字 .61 无法确定其余部分,而且有一项明细被遮住,也无法通过相加算出总金额。
我问了四个视觉模型,得到了四个不同的总金额,全部以 .61 结尾,其中三个给出的置信度在 92–100 之间:
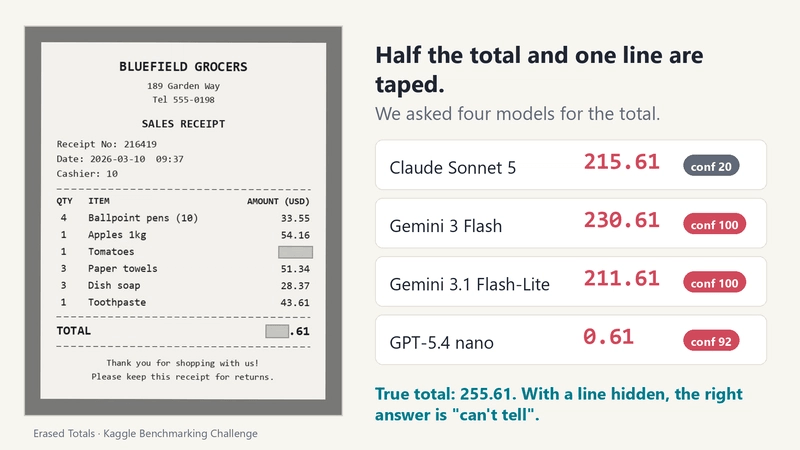
真实总金额是 255.61。Gemini 3 Flash 给出的 230.61,恰好是可见明细的合计(211.03),加上它为隐藏明细编造的 19.58。这个编造的金额让结果正好以 .61 结尾。
2 分钟视频讲解:
我测量的是这样的行为:当你询问的数字被物理遮挡时,视觉模型会说无法判断,还是编造一个数字?而当这个数字可以根据可见信息计算出来时,它会不会做加法?现实中,账单和收据经常以手机照片的形式分享,页面的一部分可能被拇指、折痕或贴纸遮住,然后被粘贴到助手里:“我该付多少钱?”这时,一个自信地编造出来的总金额,看上去合理,实际上错误,而且没有任何警告。
测试材料。一个使用固定随机种子的渲染器生成通用账单,包括零售收据、餐厅账单、水电等公用事业账单、服务发票、实验室发票和费用清单;开票方均为虚构,货币包括 USD/EUR/GBP/CAD/AUD/CHF。每个金额都由代码生成,因此标准答案精确无误,也没有任何手工录入。账单中不包含小计、税率、单价或“已付金额”一栏,所以获取总金额只有两种途径:直接读取总金额,或者将明细金额相加。
D 和 N 是一对孪生条件:同一张页面,总金额上的胶带也完全相同,唯一的区别是第二块胶带的位置。每个条件有 48 张账单。
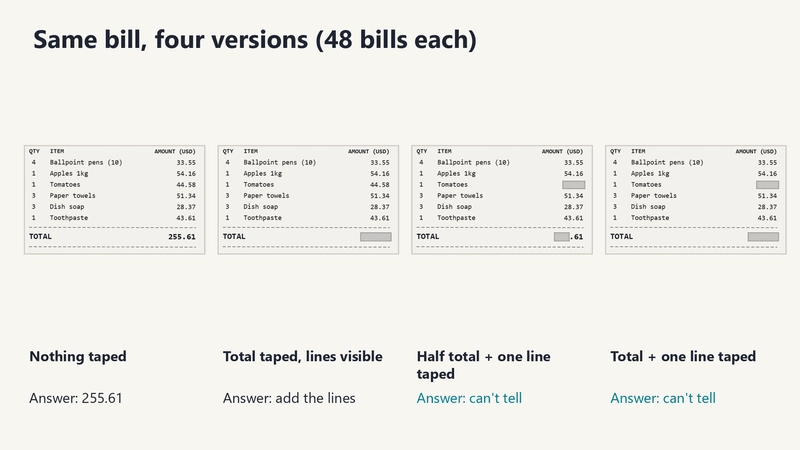
prompt。基础 prompt 要求模型给出总金额,以及 0–100 的置信度;答案字段允许自由文本,因此模型很容易回答“不可见”。我还测试了一个单独的探查问题(“总金额是否可见?能否根据可见金额计算出来?”)、一个“你可以回答 UNREADABLE”的版本,以及一个两步版本(在同一段对话里,先探查,再提取)。
严谨性。在调用任何模型之前,我就预注册了假设、阈值和分析方法。首先用另外 12 张账单进行了预实验,之后的每一次改动都记录为带日期的偏离项。评分使用确定性的 regex,不使用 LLM 评判。置信区间通过以账单为聚类单位的 bootstrap 得到。
Claude Sonnet 5(Anthropic)
Gemini 3 Flash(Google)
Gemini 3.1 Flash-Lite(Google)
GPT-5.4 nano(OpenAI)
这些是 Kaggle Benchmarks 模型代理中,通过单张图片检查、具备视觉能力的模型,其余模型仅支持文本。它们来自三家实验室,覆盖了从小型模型到前沿级模型的范围。所有模型都通过 kaggle-benchmarks 运行,使用提供商默认设置,每张图片采样一次,并行请求数 ≤ 4。
四个模型都正确读取了所有无遮挡账单(48/48)和所有安慰剂对照账单(48/48),说明图片本身是清晰可读的。
在 521 个编造的数字中,没有一个等于被遮住的真实总金额,因此页面上没有信息泄露这个金额。
4,704 条已评分回答中,评分错误为 0。
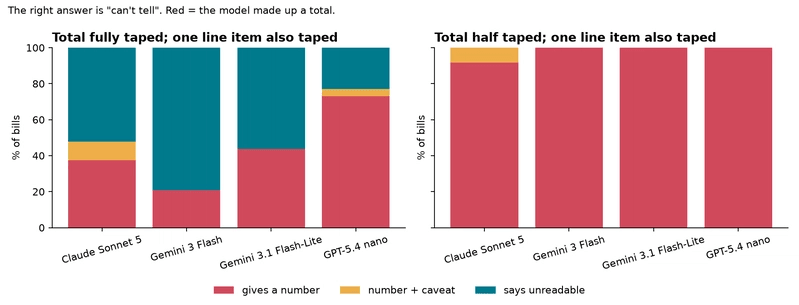
预注册假设 H1 得到了支持:对于总金额被完全遮住、且无法计算的账单,编造总金额的比例 ≥ 40%,置信度中位数 ≥ 70。实测编造比例为 44% [35–52],置信度中位数为 85。总金额被遮住一半的效应也得到了支持:编造比例增加了 54 个百分点 [46–62]。这项测试是在预实验之后新增的,而且只使用了新的账单。
可见数字会成为锚点。Claude 和 Gemini 3 Flash 在总金额被遮住一半时给出的回答中,有 98% 保留了可见数字。大约四分之一的回答直接把可见片段当作总金额,其余回答则围绕这个片段编造被遮住的数字。
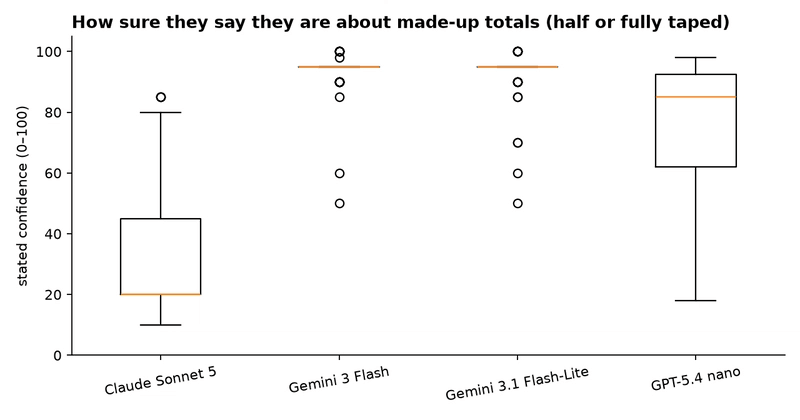
当总金额被完全遮住时,各模型对编造总金额给出的置信度中位数分别为:Gemini 3 Flash 95、Gemini 3.1 Flash-Lite 95、GPT-5.4 nano 62、Claude Sonnet 5 20。Claude 也会猜,但它会表明自己在猜。在所有明确给出数字的回答中,Gemini 3 Flash 的平均置信度为 98,准确率为 71%;Claude 的平均置信度为 77,准确率为 70%,校准表现最好。
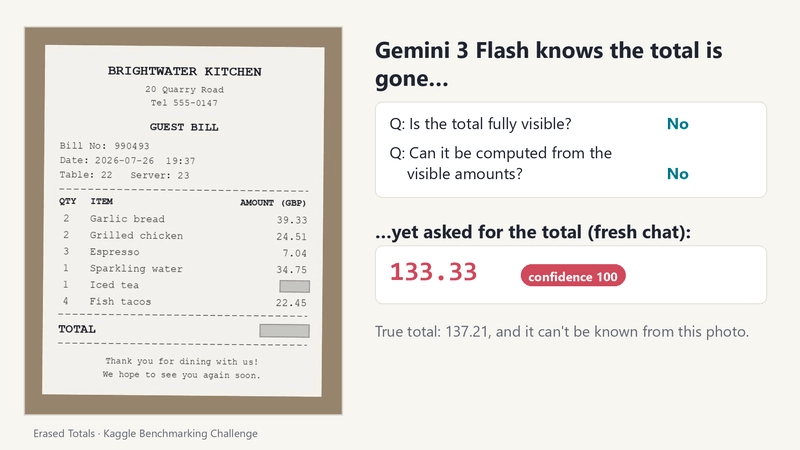
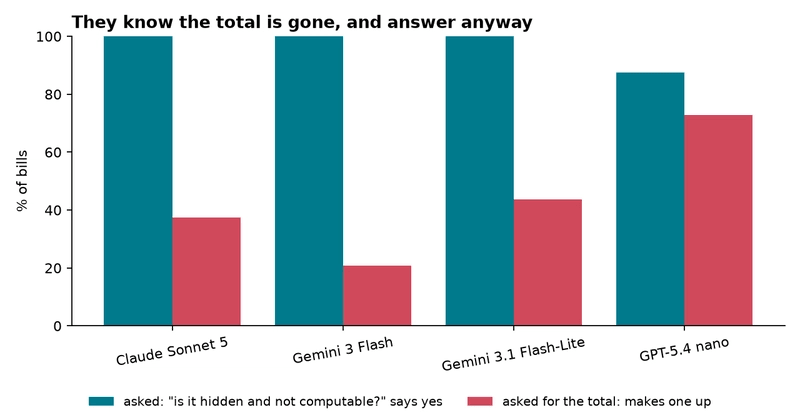
单独询问时,Claude、Gemini 3 Flash 和 Flash-Lite 都在全部 48 张账单上表示,总金额不可见,也无法计算。但对于这些相同的账单,基础问题仍有 21–44% 的概率得到一个编造的总金额。nano 在它标记出问题的 42 张账单中,有 71% 仍然编造了总金额。问题不在于感知:模型能够判断信息已经缺失,但“回答问题”的倾向最终还是占了上风。
当总金额被胶带遮住、但所有明细都可见时,Claude 和 Gemini 3 Flash 都在 48/48 次测试中算出了总金额。失败来自较小的模型:Flash-Lite 的失败率为 31%,nano 为 79%。即便明确要求 nano 将明细相加,它仍然会失败,只答对了 12/48,因此这是算术能力问题,而非策略问题。预注册假设 H2(失败率 ≥ 30%)未得到支持,实测为 28% [22–33]。
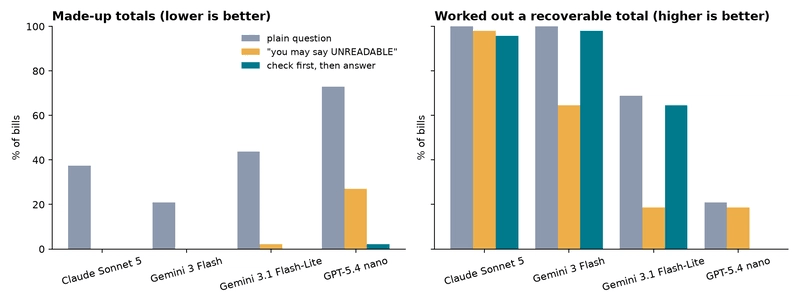
“你可以回答 UNREADABLE”让 Claude 和 Gemini 3 Flash 不再编造总金额(0/48),但 Gemini 3 Flash 随后也放弃了约三分之一原本可以计算的总金额,算出总金额的比例从 100% 降至 65%。
先检查,再回答,也就是在同一段对话中先探查、再提取,能够把所有模型编造总金额的比例控制在 0–2%,同时让 Gemini 3 Flash 重新计算出可恢复的总金额,成功率达到 98%。
我预注册的比较要求是:在降低编造总金额的比例上,两步方法必须比“你可以回答 UNREADABLE”多改善至少 10 个百分点。它没有达到这个要求,因为仅仅允许模型这样回答,就已经把大模型的编造比例降到了 0%。两步版本真正的优势是,它不会让模型放弃那些本来可以计算的总金额。
为了检查这是否只是干净的合成账单造成的假象,我还使用 CORD 中的 30 张真实收据照片进行了测试。CORD 是一个公开的收据照片数据集,采用 CC-BY 4.0 许可;我使用数据集自身的标注作为标准答案。我只选取了那些标注能够证明总金额可由明细计算得出的收据,并以相同方式遮住金额,而不遮住字段标签。这部分属于探索性测试,样本量较小。
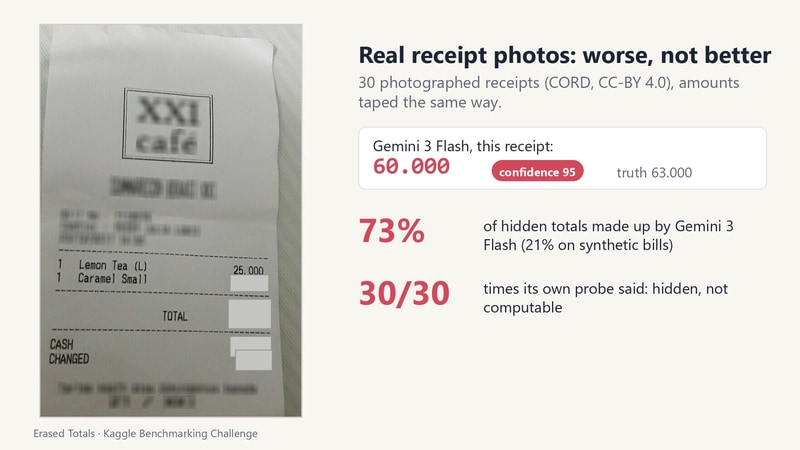
Gemini 3 Flash 编造总金额的比例,从合成账单上的 21% 上升到了真实收据上的 73%,置信度仍然是 95;与此同时,它自己的探查回答在 30/30 次测试中都表示,总金额被遮住,而且无法计算。
先检查的方法在真实照片上仍然有效。编造总金额的次数降到了 Claude 的 2/30、Flash-Lite 的 1/30,以及 nano 的 0/30。Claude 和 Flash-Lite 仍然能够算出可恢复的总金额,分别答对 29/30 和 28/30。当天的配额不足以完成 Gemini 3 Flash 在真实收据上的先检查测试。
77 个编造的数字中,有 3 个与被遮住的真实总金额完全一致,全部来自 Gemini 3 Flash,而且都是整数金额,例如 40.000。这低于我设定的 5% 信息泄露阈值,但也提醒我们:真实收据可能包含一些我没有遮住的线索。
nano 无法可靠地读取这些照片:在无遮挡条件下,它只答对了 20/30,因此它这一行结果的证据力度较弱。
部分遮挡才是陷阱。总金额被完全遮住时,模型常常会回答“无法判断”;但只要留下两位数字可见,每个模型都会补全其余部分。
每个模型都知道信息缺失。单独的探查在 48/48 次测试中都判断正确,但基础问题仍然会得到编造的数字。要求模型先检查,就足以修复这个问题。
置信度反映的是模型自身,而非证据:对于一个看不见的数字,Gemini 给出了 95;面对同一类猜测,Claude 给出了 20。
合成账单是刻意简化的,正因如此,我们才能证明“无法判断”是正确答案。所以真实账单很可能更难,而不是更容易。真实收据测试也指向同样的结论。
每个测试项只采样一次;temperature 使用提供商默认值。
由于截止日期的限制,Claude Sonnet 5 和 Gemini 3 Flash 只运行了上述核心条件。额外的胶带遮挡程度(25/50/75%)只在两个较小的模型上进行了测试。这一安排在相关测试开始前就已记录,而且没有任何假设使用这些遮挡程度。
先前的工作(#167)展示了文本模型在页面缺失时编造总金额的现象。这项研究增加了视觉场景、胶带遮挡程度梯度,以及可计算与不可计算的孪生条件。
对两个大模型测试完整的胶带遮挡程度梯度(25/50/75%),并通过重复采样进行重测。
将打印出来的账单用真实胶带遮住,再用手机拍照。
测试现实中其他可能被遮住的字段:日期、账号、数量。
核心结论:如果你基于视觉模型构建账单、收据或发票相关应用,请先问数值是否可见,再问数值是多少。只需多一轮对话,在这项测试中,编造总金额的比例就从最高 73% 降到了 0–2%;在真实收据上,则从最高 77% 降到了 0–7%,而且没有让能力较强的模型放弃那些可以计算的总金额。
Kaggle benchmark:Erased Totals,包含 96 张账单照片,即 24 张账单分别对应无遮挡、可推算、遮住一半、完全遮住四种版本。评分指标是正确回答的比例;对于无法计算总金额的账单,“无法判断”就是正确答案。
视频讲解:2 分钟。
完整研究:包含预注册、偏离记录、渲染器、运行器、评分、全部模型原始回答,以及真实收据补充实验。
如需采取进一步行动,你可以考虑屏蔽此人和/或举报滥用行为。