
8.0
热点
AI SCORE
编程提效2026-10-13 07:43
本地模型替代编程助手要测工具调用
dev.to · AI#本地模型#编程助手#Agent
Editor brief · 编辑速览
文章指出,代码基准分数接近并不代表本地模型能可靠承担编程Agent工作。作者基于Claude Code和Codex接入本地模型的经验,强调连续工具调用、参数格式遵循和跨文件编辑稳定性。
每一篇“用本地模型替代 Claude Code”的指南,开头都如出一辙:铺满一屏的 SWE-bench 分数,一句得意的“我们距离前沿模型只差五分”,再加上一份 GPU 采购清单。我读过十几篇,也实际跑过其中大多数配置。严格来说,它们并没有错。只是它们测的是容易衡量的东西,而不是决定你能否真正关掉 Claude Code 标签页的东西。
把 Claude Code 和 Codex 接到本地模型上做过实际工作后,我得到的结论是下面这样,只是没人会把它写进标题:
让本地 LLM 写出一个正确的函数,已经是解决了的问题。让本地 LLM 成为可靠的 Agent——在跨文件修改中,连续十次输出规范的 tool call,而且始终不偏离 schema——还没有解决。而后者才是这份工作的全部。
所以,这次我们认真聊清楚。我们会逐一讨论 2026 年末真正值得关注的模型家族、它们各自适合做什么、硬件的现实限制、配置方法(现在只要 60 秒)、那些没人截图展示的失败情况,以及一套成本模型,帮你判断它到底能不能省下一分钱。还会配上图表,因为让你眯着眼看一张数字表,恰恰就是问题所在。
2026 年发生了两件变化,都不是“模型在 Twitter 上吆喝得更响了”。
Mixture-of-Experts 打破了硬件门槛。一个 dense 70B 模型,每生成一个 token 都要激活全部 70B 参数。MoE 模型的总参数量很大,但每个 token 只激活其中一小部分——Qwen 的 35B-A3B 只激活约 3B。VRAM 占用取决于你加载的模型文件大小,速度则取决于那一小部分活跃参数。因此,以前需要服务器才能运行的模型,现在游戏显卡就能跑;量化之后,笔记本也能跑。
Agent 学会了与本地模型通信。这是 2025 年那些文章漏掉的部分。2026 年 1 月,Ollama 上线了对 Anthropic Messages API 的原生支持,LM Studio 和 llama.cpp 随后跟进。这才是关键突破:Claude Code 与 localhost 通信,不再需要一层代理适配。只要用一个环境变量把地址指过去,就能工作。连接这些组件不再是难点,也意味着讨论终于不能再停留在“它会不会写代码”上。
SWE-bench Verified 是每个标题都会提到的指标,而厂商公布的 2026 年成绩,确实已经逼近前沿模型。
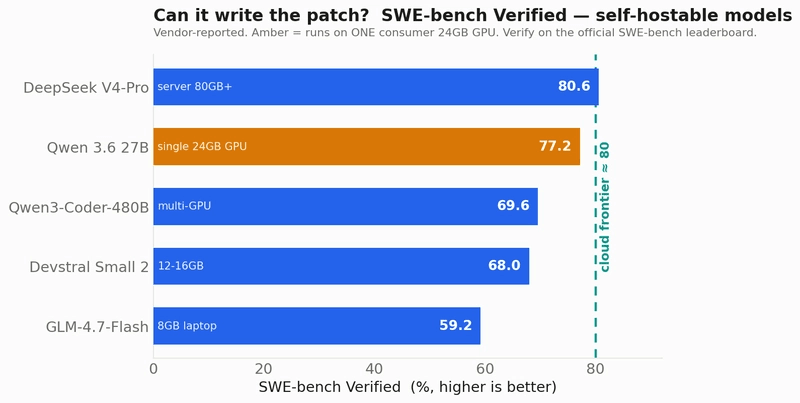
看完这张图,你会觉得问题已经解决了:单张 24GB 显卡上的模型,分数达到约 77,与云端前沿模型的差距几乎只是四舍五入的误差。但这里有个关键问题,也是整篇文章的核心:
SWE-bench 衡量的是“给定一个 bug,生成正确的 patch”。这是一项代码编写任务。对于模型接管你的编辑器时真正容易出问题的四件事,它几乎说明不了什么。
Tool call 有效性——它能否稳定输出格式正确、可被执行框架解析的 edit_file / run_command 调用?要求是可靠,而不是通常可以。
长流程一致性——第 11 次调用时,它还记得第 2 次调用时制定的计划吗?
高负载下的 context 表现——塞入真实 repo 的 40K tokens 后,质量还能保持吗?还是远没到宣称的窗口上限就已经崩了?
指令遵循——当你说“不要改测试”时,它能真的不改测试吗?
这四项没有一项出现在排行榜上。而你的本地配置之所以用起来与演示不同,原因恰恰都在这里。
⚠️ 请把本文所有数字都视为厂商自报数据。不同指南引用同一个模型时,分数可能相差很大,因为它们悄悄把 SWE-bench Verified 换成了 Pro 或 Terminal-Bench,却没有说明。在因为某个百分比而购买 GPU 之前,先去官方 SWE-bench 排行榜核实。
要按模型家族来考虑,而不是盯着某一个 checkpoint——每个家族都有多个尺寸,正确的选择是适合你的显卡和任务的那个。
如果只选一个模型家族,就选它。Qwen 在开放权重模型中,编程和 tool calling 都处于领先位置,而这两项能力的组合才是关键。
Qwen 3.6 27B(dense)——自托管编程模型的默认选择。SWE-bench Verified 约 77%,量化后约占 22GB,单张 24GB GPU 或 M 系列 Mac 就能运行。Tool call 表现可靠。
Qwen 3.5 35B-A3B(MoE)——总参数 35B,活跃参数约 3B。运行起来轻得令人意外(Q4 下需要 8GB VRAM),因为计算开销只来自活跃的那部分参数。它就是“笔记本上的前沿模型”这类标题的主角。
Qwen3-Coder(30B-A3B / 480B-A35B / Next-80B-A3B)——专门面向代码的产品线。30B 很适合日常使用;如果你有 64GB+ 统一内存或多张 GPU,480B 则是能力最强的开放编程模型。
**最适合:**通用编程 Agent、需要使用工具的工作流,以及希望一个模型就能把 80% 的工作做好的用户。**短板:**没有明显硬伤,是稳妥的默认选择。
在长流程、大量使用工具的 Agent 任务中,GLM 的表现超出了它的体量,而 Flash 版本是那些真正可用的模型中最轻量的一个。
GLM-4.7-Flash——SWE-bench 约 59%,可以在 5–8GB 的笔记本上运行。对于“我只有接近集显水平的 GPU”的用户,这是一个能干活的选择。
GLM-4.6 / 4.x(MIT license)——适合长时间、多步骤的 Agent 会话;这类任务中,多次调用之间的一致性,比单次作答的最高分更重要。
**最适合:**笔记本级硬件、长时间 Agent 会话,以及需要宽松许可证的团队。**短板:**面对高难度的单次编程任务,能力上限低于 Qwen 27B。
DeepSeek 公布了开放模型中的最高成绩——V4-Pro 的 SWE-bench Verified 约为 80.6%——但只有你的桌边放着一台服务器(80GB+),它才算得上“本地模型”。
**最适合:**纯粹而高难度的代码任务,前提是你有服务器级硬件,或者为团队准备了一台自托管服务器。**短板:**它不是消费级 GPU 模型;这是遇到难题时升级使用的档位,不是日常主力。
SWE-bench Verified 约 68%,采用 Apache-2.0,可在 12–16GB 显存中运行。如果你的要求是“许可证清晰,而且中端显卡就能跑”,它是最佳选择;以它的体量而言,也是一个扎实的 Agent 编程模型。
**最适合:**需要许可证确定性的商业用途、中端 GPU,以及 Agent 子任务。**短板:**跨文件推理的能力上限低于 27B 档位。
Kimi 面向长流程 Agent 工作,在难度更高的 Pro benchmark 上表现不错,但要在本地运行,需要较激进的量化,或者服务器硬件。
**最适合:**在强劲硬件上长时间自主运行。**短板:**对于单张消费级 GPU 来说,它不是现实的选择;其 benchmark 成绩来自 Pro,不能与前面那些 Verified 分数直接比较。
OpenAI 的开放权重产品线,通过 --oss 参数就能自然接入 Codex CLI。20B 可以在消费级硬件上运行;120B 则属于服务器级别。
**最适合:**已经统一使用 Codex、希望获得无须折腾工具链的本地备用方案的团队。**短板:**在开放模型的 tool calling 可靠性上,Qwen/GLM 通常略胜一筹。
Gemma 4(12B / 27B)是面向较轻量硬件的通用模型。如果你有一台 16GB 的机器,想要的是一个能力不错的多面手,它会很合适。
**最适合:**笔记本、编程与写作混合使用,以及低 VRAM 机器。**短板:**它是通用模型,面对高难度 SWE 任务时,会落后于专门针对编程调优的模型。
(值得一提的还有 MiniMax M2.x:训练时优先面向 Agent,定价也很有竞争力。如果你最在意每美元能换来多少吞吐量,值得关注。)
下面这张图,才应该真正指导你的 GPU 购买决策——它展示了性能,以及达到这种性能需要付出的 VRAM 成本。
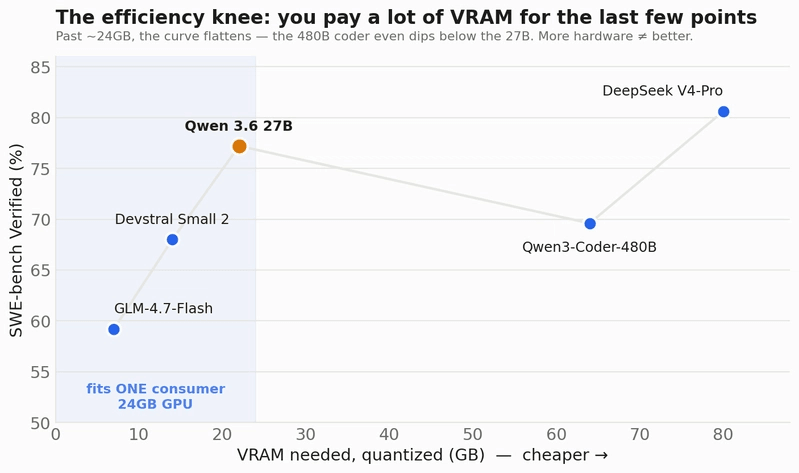
曲线在约 24GB 之前陡峭上升,之后逐渐趋平——480B 编程模型的 Verified 分数甚至低于 27B,内存需求却是它的 3 倍。结论是:单张 24GB 消费级 GPU 运行 Qwen 3.6 27B,是自托管的最佳平衡点。再往上投入,收益都会递减,除非你明确需要服务器级模型的能力上限。
这个发现改变了我选择本地模型的方式。Tool calling 与编写代码,是两种需要分别训练的能力。一个模型可以写出漂亮的函数,却依然做不好 Agent 必须做到的那件事:每次都在第一次尝试时,输出有效的 tool call。
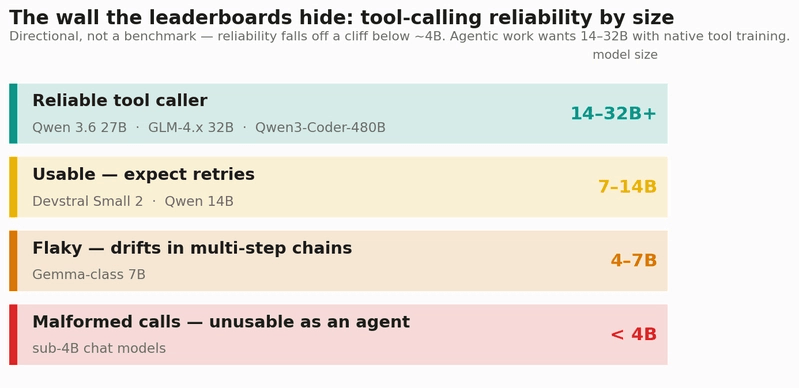
现有证据逐渐指向以下结论:
**参数量低于约 4B 时,可靠性会断崖式下降。**低于 7B 的模型,无论外面套着哪种 Agent,都会输出格式错误的 tool call。一个连调用格式都写不对的模型,执行框架救不了它。
**原生 tool-use 训练,优于事后加上的语法约束。**使用 tool template 训练过的模型,表现更规矩;事后附加 constrained decoding 的模型,仍会发生偏移。
**模型比执行框架更重要。**从 Claude Code 换成 OpenCode,再换成 Codex,也修不好一个连 JSON 都写乱的模型。
**多步骤调用链才是它真正失效的地方。**一次 tool call 没问题。连续五次、每次都依赖上一次结果时,较小的本地模型就开始幻觉式调用——编造不存在的函数,或者用已经偏移的参数再次调用某个函数——然后 Agent 就陷入重试循环。
实际选型的门槛是:做 Agent 工作,应当选择原生接受过工具训练的模型家族,尺寸在 14B–32B。到了 2026 年末,这基本上意味着 Qwen;GLM-4.x 和 Devstral Small 2 也是可信的替代选择。低于约 7B 的模型,都是在扮演 Agent 的聊天模型。
因为 Agent 现在已经能与本地模型通信,所以配置过程简单得有些平淡——这正是我们想要的。
Claude Code → 本地模型(通过 Ollama):
# 1. pull a capable coder
ollama pull qwen3-coder:30b

# 2. point Claude Code at localhost + a throwaway token
export ANTHROPIC_BASE_URL="http://localhost:11434"
export ANTHROPIC_AUTH_TOKEN="local-dummy"

# 3. run it
claude
**Codex CLI → 本地模型:**Codex 可以连接任何兼容 OpenAI 的 endpoint。使用 Ollama 时,--oss 参数会将它指向本地服务器(:11434);LM Studio 的服务地址是 :1234/v1。在 config.toml 中固定 provider 和模型。
**执行框架怎么选:**Ollama 适合以终端为主的用户,它甚至为 Claude Code / Codex / OpenCode 提供了单命令启动方式;LM Studio 则提供 GUI。两者都可以——记住,决定 tool call 可靠性的是模型。
下面两个坑,每个都让我折腾了一个晚上:
**显式设置 context window——至少 32K,最好 64K+。**默认值往往很小,编程 Agent 很快就会缺少足够的 context。但模型质量会在达到宣称的上限之前明显下降,KV cache 也会占掉你原本打算留给权重的 VRAM。两部分都要预留空间。
**切回云端时:**unset ANTHROPIC_BASE_URL,或者从 settings.json 中删掉它。这件事看起来很明显,直到你忘了操作,开始纳闷为什么“Claude”突然变笨了。
拿它做一周真实工作,你会看到一个稳定的规律:对于常规的单文件任务,一个好的本地编程模型,大约能达到云端 Claude 70% 的水平;而随着任务越来越依赖 Agent 能力,差距会迅速拉大。按出现频率排序,失败情况如下:
**Schema 偏移 → 重试循环。**模型输出的编辑操作格式有一点不对,执行框架拒绝了它,重试时又以另一种方式偏离格式。遇到困难步骤,这会消耗十几轮交互。
跨文件推理崩溃。“在整个模块中重命名这个东西,并修复 import”,云端做起来平平无奇而且可靠,本地 30B 模型却可能到第三个文件就迷失方向。
**能明显感受到的延迟。**云端几秒就能完成的调用链,本地可能需要几分钟——原因未必是 tokens/sec 太低,而是每次重试都要再完整生成一遍。
**Context 的断崖来得早,而且很陡。**大约用到宣称窗口的一半时,模型就开始出现不易察觉的退化;而“执行计划时悄悄变差”,恰恰是 Agent 最不能承受的事情。
这些问题并不意味着本地模型没有用。它是一种用途不同的工具。
这才是人们尝试本地模型的真正原因,所以我们来算账,别只是空泛地说“免费”。本地模型并不免费,而是预付费。你用固定的硬件支出、电费,以及盯着重试过程的时间,换掉了按量计费的 API 账单。
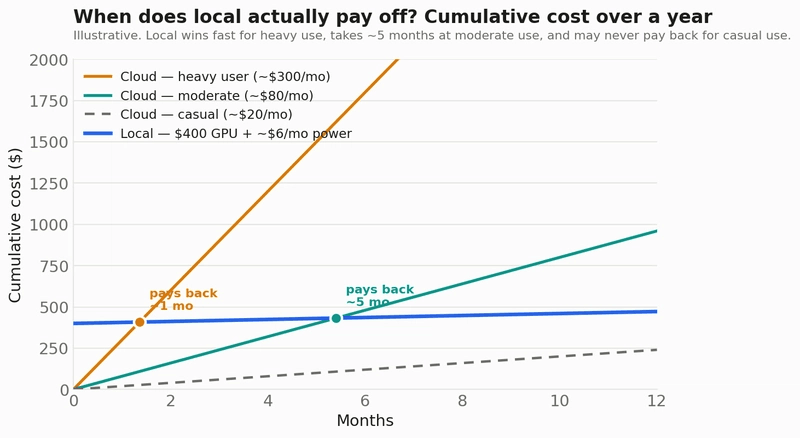
一张能轻松运行 Qwen 3.6 27B 的二手 24GB GPU:一次性花费几百美元。
持续负载下的电费:确实有,但不多——个人用户每月只需个位数美元。
作为对比,一个重度 Claude Code 用户,每月就可能花掉几百美元;运行 Agent 集群的团队,晒出的账单更是令人咋舌——“一个月花了 4,660 美元”的截图,如今都快成一个固定类别了。
坦诚的结论是:对偶尔写代码的个人用户来说,与谨慎使用云端相比,本地方案很少能回本——硬件和折腾的成本,比你省下的钱更多。真正让结论大幅反转的,是高调用量、重复性强,或者受隐私约束的工作负载——尤其是 Agent 集群:把成本低的 80% 调用分配给本地模型,只在剩下确实需要前沿模型的 20% 调用上消耗 token。这种路由方式,才是 2026 年真正能带来收益的做法。
别再问“哪个模型最好”,要问“这是什么任务”。
遇到下面这些工作,优先用本地模型:
下面这些工作,继续用云端 Claude/Codex:
我最终得出的那句话是:本地模型正在成为默认选择,前沿模型则负责处理升级上来的难题。这与大多数团队今天的用法正好相反,而省钱的空间就在那里。
本地 LLM 能替代 Claude Code 吗?如果要让它担任 Agent,处理困难、多步骤、大 context 的工作——还不行;阻碍它的不是 SWE-bench 分数,而是长会话中的 tool calling 可靠性。如果要让它成为一个便宜、私密、随时可用的主力,承担那 80% 不需要前沿模型的任务——完全可以,今天就可以,一张 24GB GPU 就够,而且它还在逐月变好。
错误在于把这件事当成非此即彼的选择。真正获得价值的人,会同时运行两个模型,并且知道每种任务该交给谁。
如果这篇文章对你有帮助,欢迎关注我——我会写 AI Agent、本地模型,以及它们背后那些不够光鲜的工程问题;随着新模型发布,我也在测试更多配置方案。
轮到你了:对你来说,真正的界线在哪里——具体是什么任务,会让你选择云端,并且拒绝信任本地模型?我在收集真实使用中的失效点。👇
本文数字都是厂商自报数据,而且每月都在变化——不要仅凭博客里的一个百分比就购买硬件。请到一手来源核实:
成本图和 tool calling 分层图都是示意图,用来展示取舍关系的走势——请代入你自己的 API 账单和 GPU 价格,计算适合你的数字。
如需采取进一步行动,你可以考虑屏蔽此人和/或举报滥用行为。