
9.0
重磅
AI SCORE
模型发布2026-10-13 02:48
Muse Wonder 跻身前列,任务成本上涨
The Decoder#Meta#Agent#模型成本
Editor brief · 编辑速览
据报道,Meta 新推出的 Muse Wonder 系列在十项基准中的六项进入前三,智能体任务能力提升最明显。与此同时,每项任务的成本接近此前的三倍。
Meta 的两款新模型 Muse Wonder 和 Muse Wonder Full,缩小了与领先 frontier model 的差距。
提升最明显的是 Agent 编程和自主解决问题的能力。
两个版本每次 API 调用的成本,都接近前代 Muse Spark 1.3 的三倍。
Meta 发布了 frontier model Muse Wonder 的两个版本,两者都跻身当前最优秀的 AI 模型之列。
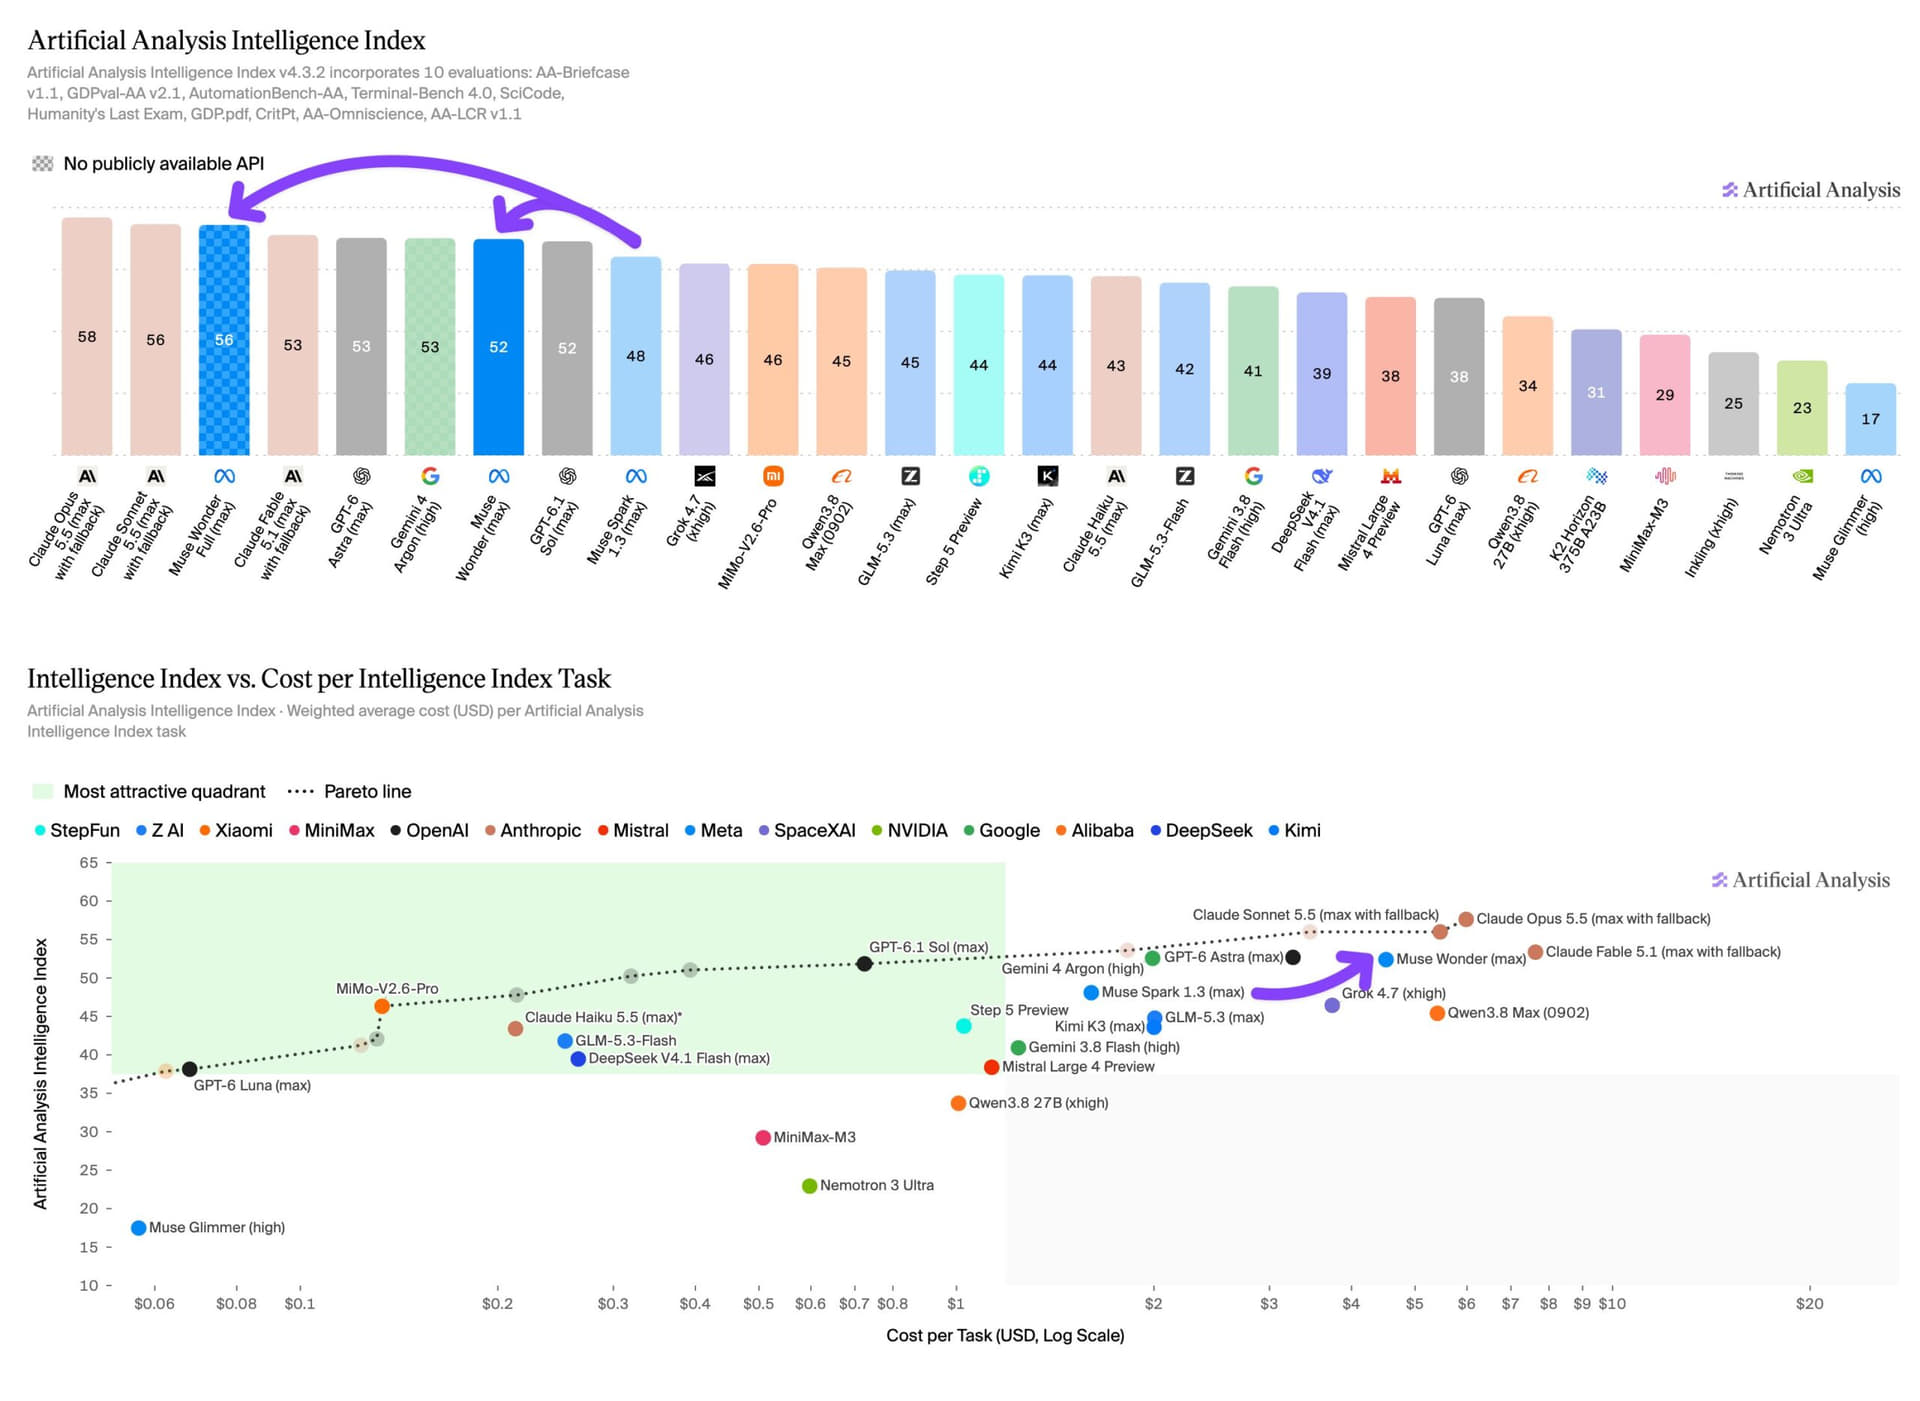
Muse Wonder Full 在 Artificial Analysis Intelligence Index v4.3 上拿到 56 分,Muse Wonder 则拿到 52 分。前代 Muse Spark 1.3 的得分为 48 分,这意味着它们相较于此前处于中游水平的模型,实现了显著跃升。
提升最明显的是 Agent 能力评测,这类测试衡量的是 AI 模型独立处理复杂任务的能力。在 Terminal-Bench 4.0 上,成绩从 33% 提升到了 57%。在总共十项 benchmark 中,Muse Wonder Full 有六项进入前三。这对 Meta 来说是一个亮眼的成绩:在开放的 Llama 模型经历了一段表现疲弱的时期后,Meta 似乎已经恢复了竞争力。
Muse Wonder Full 在 Artificial Analysis Intelligence Index 上拿到 56 分,跻身顶尖 frontier model 之列。| 图片:Artificial Analysis
Meta 重点介绍了两项新功能。“Active Memory”让模型能够记住跨对话的关键信息,并在需要时调用。“Active Focus”则指模型能够坚持处理困难任务、尝试其他方法,并在情况不明确时追问。这两项能力都是 Meta 所描绘的个人 AI Agent 的核心:这个 Agent 可以访问日历、消息和文档。
两款模型都支持一百万 token 的 context window,并接受文本、图像、视频和音频输入。Muse Wonder 可通过 Meta 的 API 和 Muse Code 使用,而 Muse Wonder Full 目前仅面向 Muse Code 用户开放。Muse Wonder 也将很快接入 Muse app,首先向付费订阅用户提供。此后,Meta 计划以它为基础构建面向所有用户的专用模型。
两款模型的编程能力都有显著提升。Muse Wonder Full 在 Coding Agents Index 上拿到 68 分,与使用 Sonnet 5.5 的 Claude Code 持平。Muse Wonder 得分为 63 分,高于前代的 54 分。
事实知识仍然是短板。在 AA-Omniscience 知识测试中,Muse Wonder Full 仅拿到 30 分,Muse Wonder 为 25 分。这远低于 Claude Opus 5.5 的 46 分、GPT-6 Astra 的 43 分,以及 Gemini 4 Argon 的 42 分,表明 Wonder 系列的基础模型规模可能小于竞争对手。较低的 hallucination rate 在一定程度上弥补了这一差距。与前代相比,Muse Wonder Full 将 hallucination rate 从 33% 降到了 23%;在所有指数得分至少达到 45 分的模型中,这一数值是第二低的。只有 Gemini 4 Argon 的 hallucination rate 更低,为 15%。
Meta 在博客文章中回应了一种常见批评:Muse 模型针对 benchmark 做了调优,但在实际使用中表现不足。公司表示,对于未被纳入训练优化范围的陌生任务,Muse Wonder Full 的表现优于预期,并将其归功于更强的基础模型。
Meta 官方公布的 benchmark 结果显示,这家在线广告公司已经追上了领先的 frontier model。| 图片:Meta
据 Vals AI 称,Muse Wonder Full (Max) 首次进入 Vals AI Index 就排在第五位,超过了所有 OpenAI 模型。只有当前的 Anthropic 模型得分更高。Muse Wonder 则排在第十位。
最大的进步来自编程和数学。在用于数学证明的私有 benchmark ProofBench 上,Muse Wonder Full 解出了 100 道题中的 94 道,前代则为 58 道。这使它距离顶尖模型的成绩(99 至 100 分)仅差五到六分。在 Terminal-Bench 4 上,Muse Wonder Full 的得分翻了一倍,同时输出 token 用量减少了 30%。金融和法律任务的表现则基本停留在前代水平,最多下降了两分。
根据 Artificial Analysis 的数据,Muse Wonder 在 Intelligence Index 上每项任务的成本为 4.52 美元,接近 Muse Spark 1.3 的三倍,后者为 1.60 美元。token 定价也有所上涨:每百万输入 token 为 4 美元,每百万输出 token 为 20 美元,而前代分别为 1.25 美元和 4.25 美元。Muse Wonder 每项任务使用的输入 token 也增加了 28%,输入 token 占总成本的 76%。
这使 Muse Wonder 的成本低于 Claude Fable 5.1 的 7.63 美元和 Claude Opus 5.5 的 5.98 美元,但高于 GPT-6 Astra 的 3.26 美元、Gemini 4 Argon 的 1.99 美元,以及 GPT-6.1 Sol 的 0.72 美元。Muse Wonder Full 的 token 定价尚未公布。两款模型的输出 token 用量都比前代少了约 10%。
Meta 表示,这些模型是在自建的 Prometheus 数据中心训练的,该中心的规模达到吉瓦级。更多细节见 model card。
订阅 THE DECODER,即可享受无广告阅读、每周 AI newsletter、每年六期的独家“AI Radar”前沿报告、完整的历史内容访问权限,以及评论区访问权限。