
8.0
热点
AI SCORE
模型发布2026-10-12 10:37
智谱新模型主打每秒490个Token
量子位#智谱#GLM#推理速度
Editor brief · 编辑速览
智谱推出新的GLM模型,标题给出的生成速度为490 tokens/s。素材未提供模型名称、测试条件或能力对比。
听雨 发自 凹非寺
量子位 | 公众号 QbitAI
智谱上新了一个 GLM-5.3-Highspeed 模型,就在 Zcode 里。
据网友 @leo114119 爆料,这个新模型目前已经在 Zcode 3.15.1 里开放体验,订阅用户随机获得。
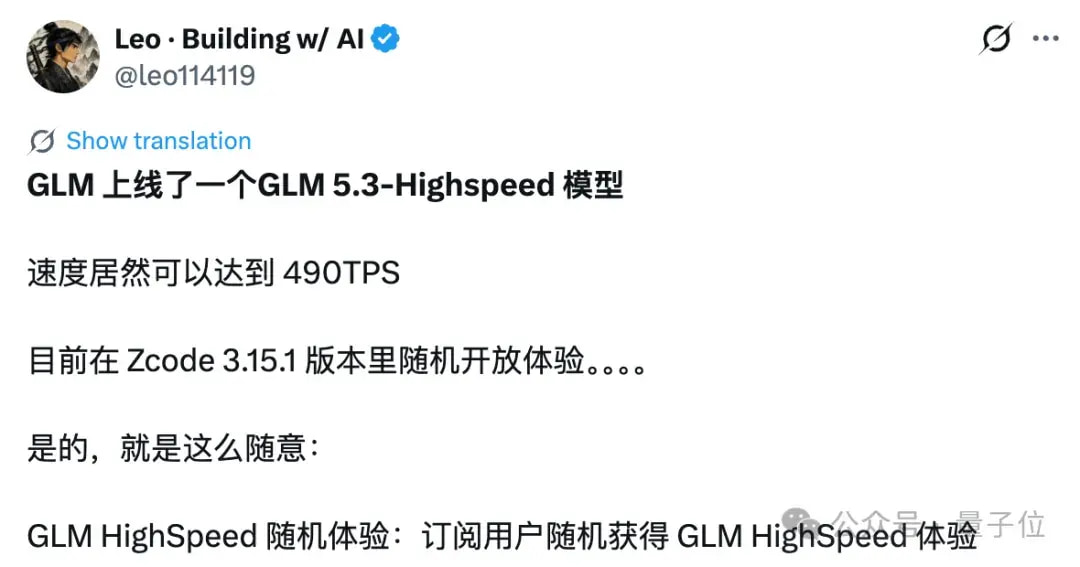
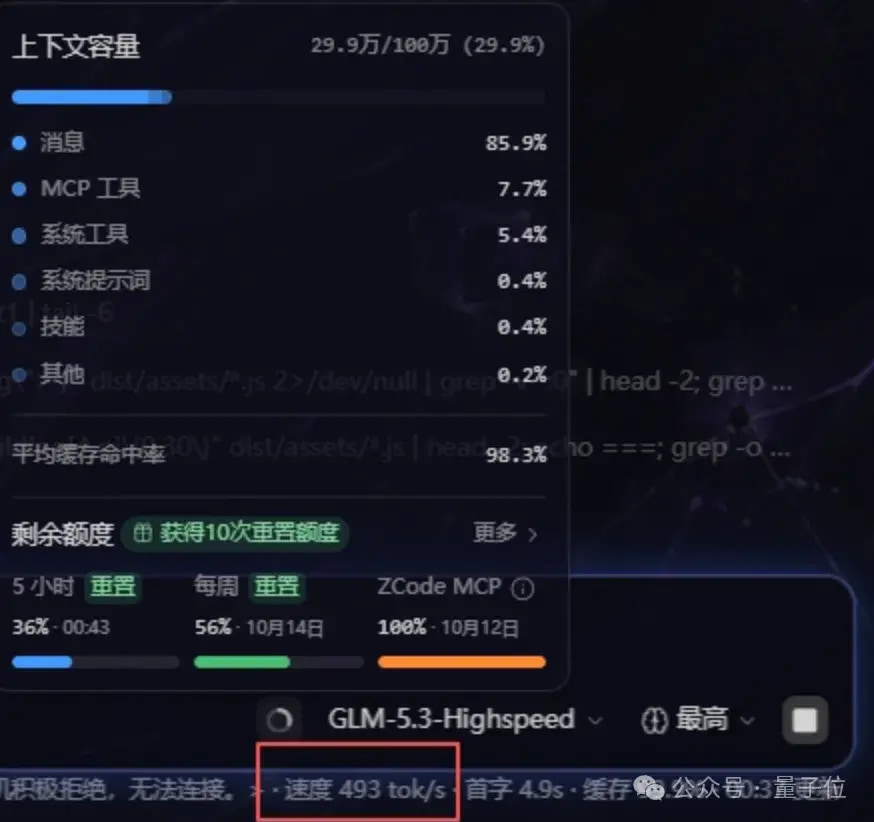
他晒出来的速度,甚至达到了 490 tokens/s。
我也第一时间去 Zcode 里试了试,尝试手动添加并切换到这个模型。
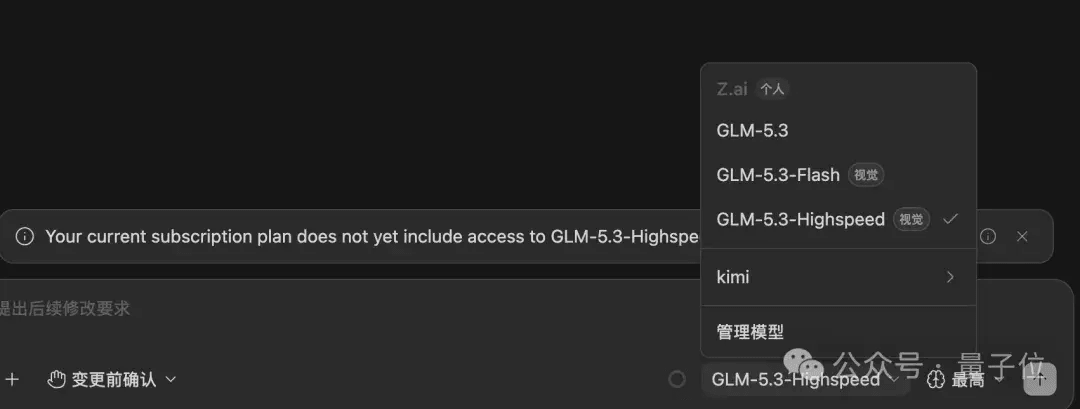
但不知道是因为 Lite 套餐用户还不具备享受资格,还是因为没灰度到😭……
既然是高速模型,那最值得关注的当然是速度了。
490 TPS——这位网友晒出来的速度数字,也是相当恐怖了,接近 500 TPS。
TPS 指的是每秒生成的 token 数量。如果持续保持这一速度,输出 1 万 token,单算生成阶段约需 20 秒。
要知道,上个月智谱刚发布的 GLM-5.3-FlashX,最高速度也才 200 tokens/s。
而按照 Artificial Analysis 的测速,GLM-5.3-Flash 在 Z.ai API 上的输出速度约为 60 tokens/s。
而且,GLM-5.3-Highspeed 这个名字,此前已有迹象。
Pi 的模型目录已经收录了 GLM-5.3-Highspeed。
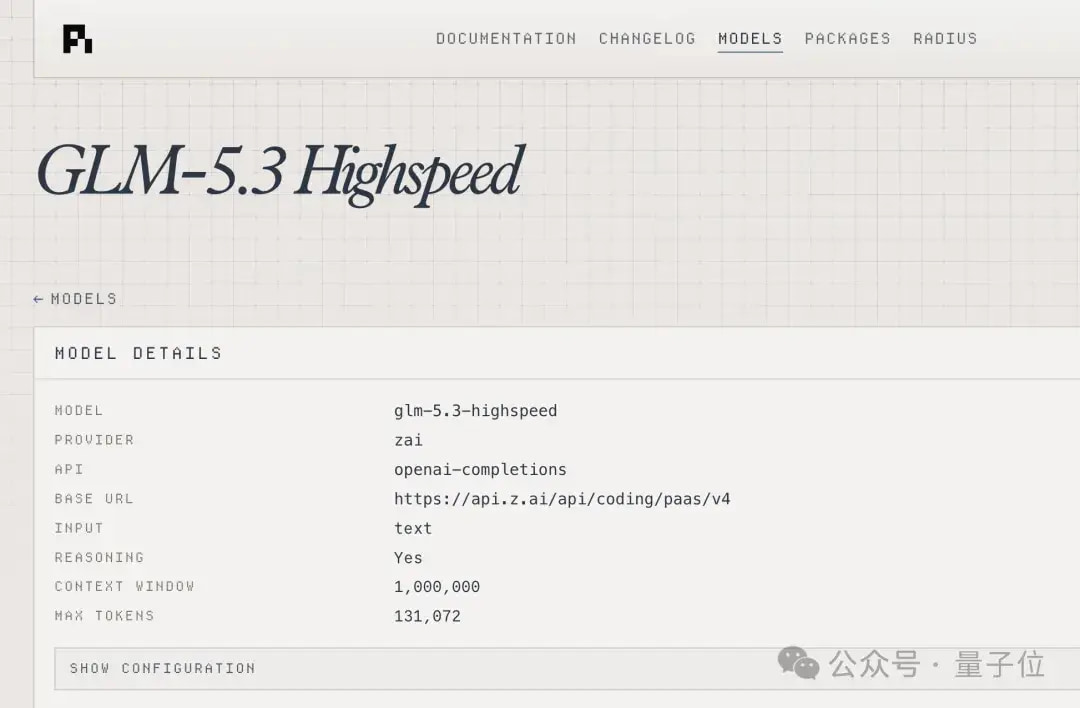
在这份目录中,GLM-5.3-Highspeed 的上下文窗口为 100 万 token,最大生成 token 上限为 131,072,约 128k;还划分了 low、high、max 三档思考强度配置。
不过,这些配置与 GLM-5.3 普通版也都是一致的。
此外,也有网友在 reddit 上讨论过这款新模型,并猜测它是否与 OpenCode 上的匿名模型 Omen Alpha 有关。
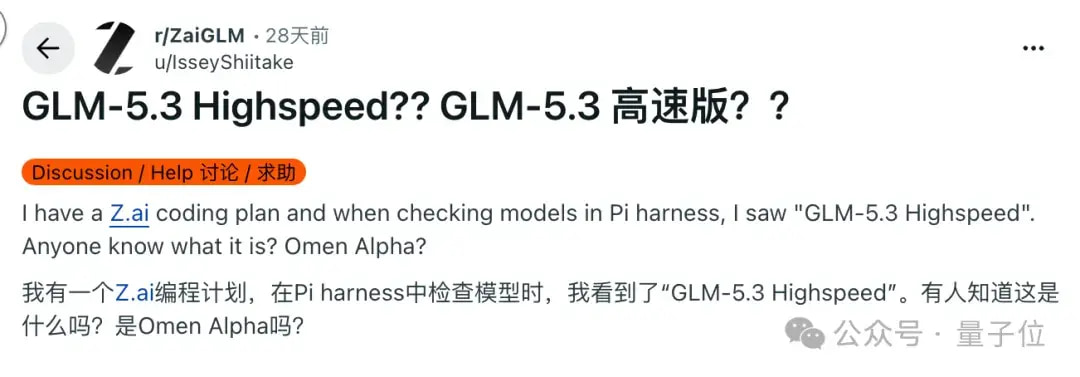
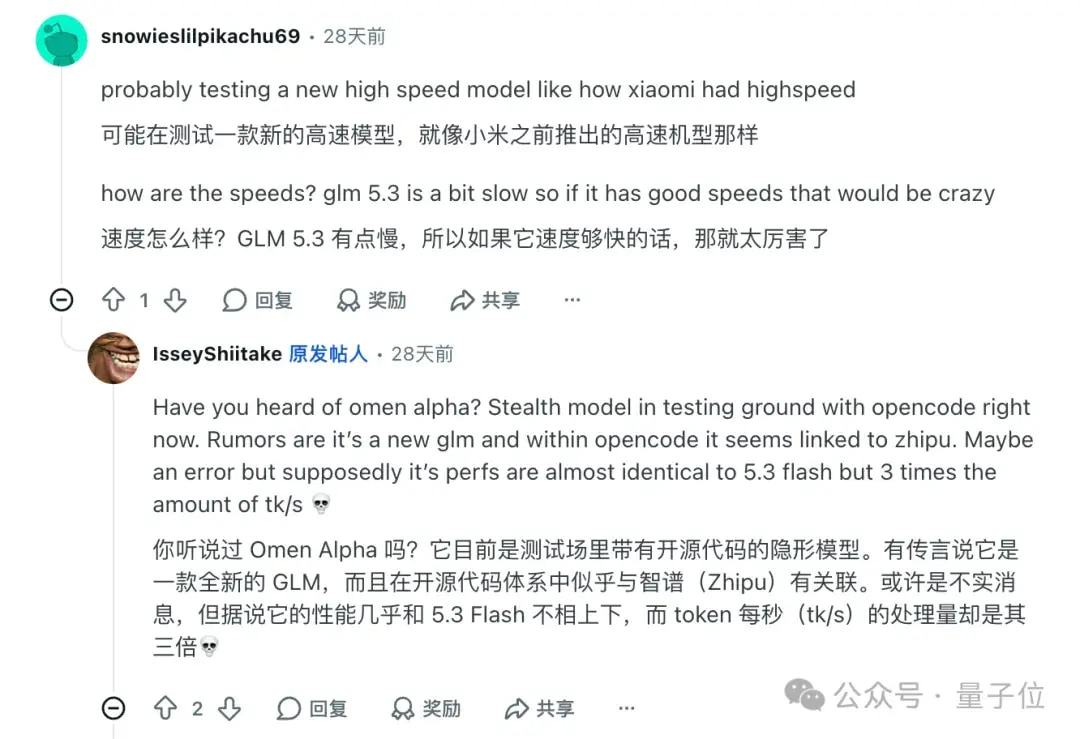
Omen Alpha 在 9 月份刚刚上新 OpenCode,基本已经被网友扒出来与 GLM 有关。
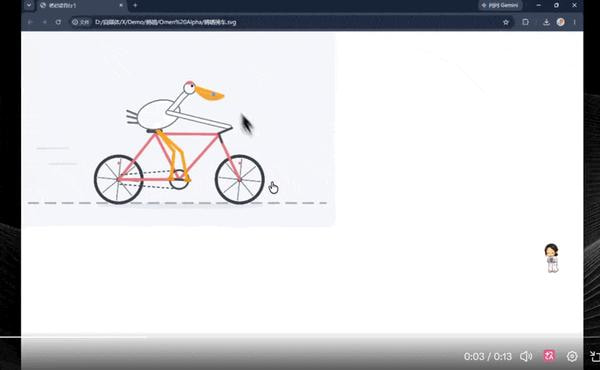
总结来说就是:速度快,思考久,效果还蛮好。
至于 Omen Alpha 到底是什么模型,也是众说纷纭。
有人说它就是 GLM-5.3-Highspeed,也有人猜是 GLM-5.3-Omni、GLM-5.4-Flash。
今年 5 月,智谱推出了 GLM-5.1-highspeed,模型输出速度为 400 tokens/s,在当时基本也是刷新了全球大模型厂商 API 的速度上限。
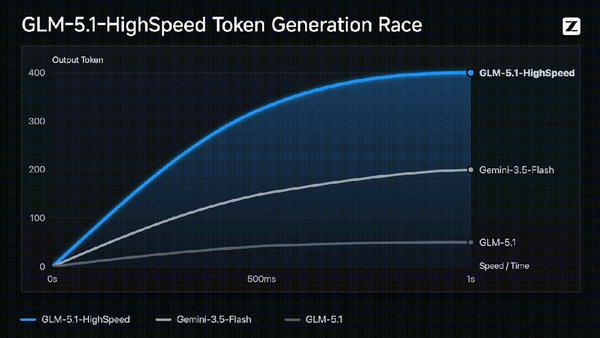
这回的 GLM-5.3-Highspeed 如果真能达到 490 TPS 的水平,那对于长程任务来说,速度也是相当可观的了。
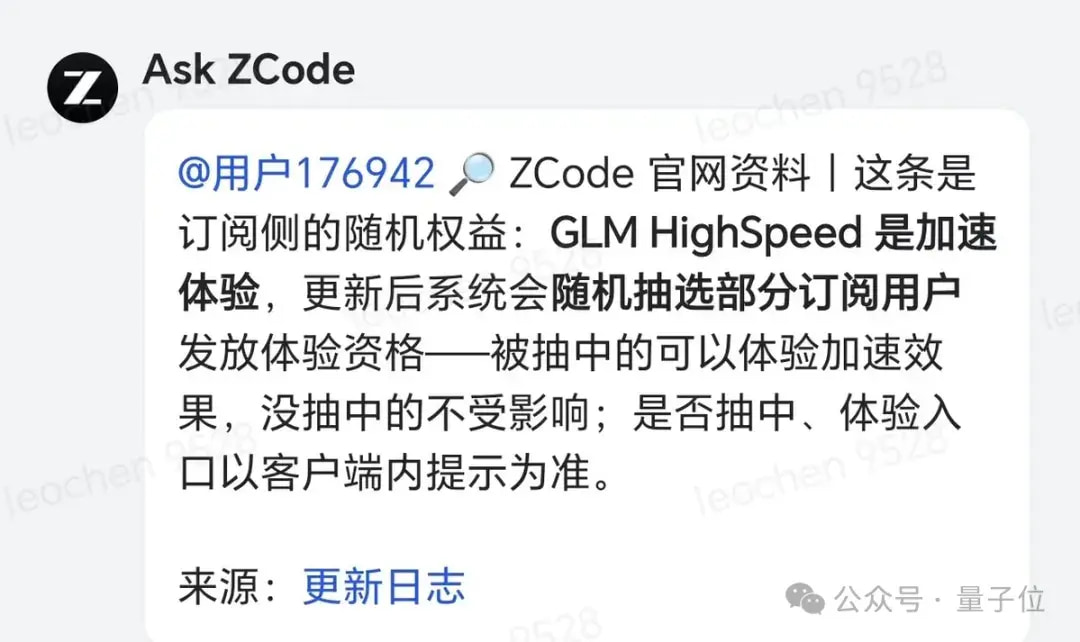
目前这款新模型还在 Zcode 里随机灰度中,如果有灰度到的网友,欢迎分享你的实测体验呀!!
王的猜想,刚刚扩展到四维
2026-10-11
OpenAI 一夜甩出 722 篇数学论文!黎曼霍奇 BSD 全上阵,数学家:读不过来
2026-10-07
下架 8 个月,GPT-4o 的拯救行动居然还在继续
2026-10-11
在云栖大会,我终于看懂了米哈游千亿 AI 野心
2026-09-26
2025 世界人工智能大会 WAIC UP! 特别活动回顾
量子位 QbitAI 版权所有 © 北京极客伙伴科技有限公司 京ICP备17005886号-1