
8.0
热点
AI SCORE
技术实践2026-10-11 23:39
多智能体协作成本高,质量收益有限
The Decoder#多智能体#成本优化#评测
Editor brief · 编辑速览
据 Vals AI 研究,多智能体团队成本最高达到单智能体的 5.1 倍,四项测试中仅一项出现可测量的质量提升。报道还援引 Anthropic 数据称,智能体数量超过十个后,质量趋于平台期,Token 成本继续增长。
研究发现,AI Agent 团队的表现几乎不比单个 Agent 更好。
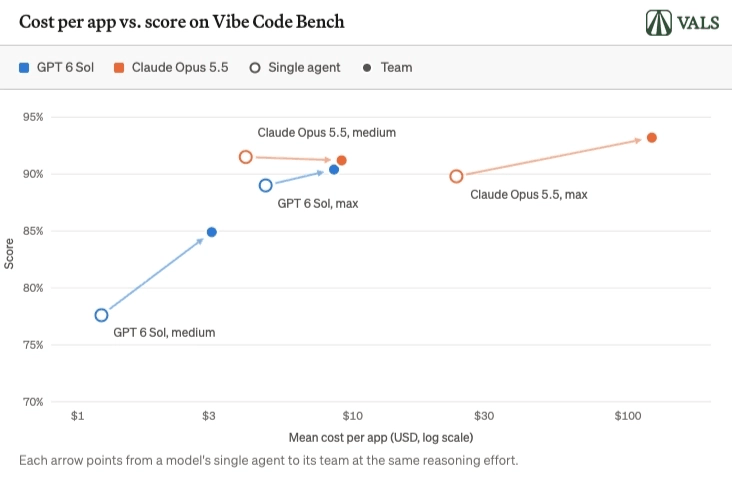
Evals 公司 Vals AI 在“Vibe Code Bench”上测试了 GPT-6 Sol 和 Claude Opus 5.5,分别让它们以单个 Agent 和 Agent 团队的形式运行,并采用两档推理强度:中等和最高 reasoning effort。Agent 团队的成本是单个 Agent 的 1.8 至 5.1 倍。
在团队与单个 Agent 的四组对比中,只有一组取得了统计显著的提升:在中等推理强度下,GPT-6 Sol 团队的得分高出 7.3 分。在最高推理强度下,团队配置没有给 Sol 或 Opus 5.5 带来任何实质优势。这些结果表明,在大多数情况下,Agent 团队带来的额外成本并不划算,尤其是在模型已经用满计算资源时。
Vals AI 的基准测试展示了每个应用的成本与 Vibe Code Bench 得分之间的关系。箭头从各模型的单个 Agent 指向相同推理强度下的 Agent 团队。团队的成本高得多,得分却几乎没有提升。| 图片:Vals AI[
在 Lean 定理证明任务中,当 Agent 数量超过 10 个时,Fable 5.1 的质量提升更明显,但它在所有测试中的得分仍低于 Opus 5.5。在知识库任务中,当 Agent 数量从 30 个增加到 100 个时,Fable 的得分反而略有下降。
OpenAI 研究员 Noam Brown 在 Dwarkesh Podcast 中证实,多 Agent 系统主要换来的是速度,而非更好的质量。4 个 Agent 完成任务的速度快了一倍,成本也增加了一倍。增加到 16 个 Agent 时,这一规律仍然成立,只是效率略有下降。
他说,这种效果很大程度上取决于任务类型。网络研究和数学任务适合并行处理,写小说却不适合。让 10,000 个 Agent 一起写一本小说,就像让 10,000 个人一起写一样,毫无意义。Brown 承认,将 Agent 扩展到极大规模的做法仍基本未经探索,因为成本实在太高。
OpenAI 开发者 Eric Provencher 最近也正是出于这个原因,告诫大家不要使用 Agent 集群。他认为,这很可能是在浪费钱,因为 Agent 之间的协调会失效。他将其称为“协调税”。
订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻通讯、每年六期独家“AI Radar”前沿报告、完整历史文章,以及评论区访问权限。
继续阅读,了解全貌。订阅不炒作的新闻报道。
完整阅读 THE DECODER 的每一篇文章
参与评论和社区讨论
通过邮件接收每周 AI 新闻回顾
每年 6 期:“AI Radar”——深入探讨最值得关注的 AI 话题
每日 AI 新闻,随时掌握最新动态
访问完整的十年历史文章库
由拥有 10 年以上 AI 经验的团队报道