
8.0
热点
AI SCORE
技术实践2026-10-11 21:44
研究指出AI科研代理缺乏自我质疑能力
The Decoder#Agent#模型评估#科研自动化
Editor brief · 编辑速览
Epoch AI与Anthropic的独立研究均指出,当前模型能执行实验,却缺乏科学自我审查与原创思考;Sol最高仅达到人类参考得分的15%,且依赖已有方法。代理容易夸大成果,难以批判性检验自己的结论。
Epoch AI 和 Anthropic 的研究结果表明,AI 模型能够开展实验,但缺乏科学研究所需的自我批判能力和真正的创造性思维。
各大 AI 实验室正越来越多地将自己的模型宣传为研究工具。Google DeepMind 已将 Co-Scientist 扩展为一套完整的研究系统,OpenAI 则早在 9 月就推出了一个“自动化研究实习生”。按照计划,到 2028 年 3 月,这位实习生将成长为在人类监督下开展工作的自主 AI 研究员,但它似乎仍然缺少一项关键能力:科学判断力。
Epoch AI 通过其 benchmark“InnovationEval”,测试 AI Agent 能否独立开展研究。任务是发明一种新方法,用于在语言模型完成初始训练后进一步提升其能力,然后独立完成实现、测试和改进。
研究以广泛使用的 GRPO 技术为起点。GRPO 会比较模型针对同一任务生成的多个答案,并奖励其中较好的答案,通常会对每个解答进行整体评分。作为对照的人类设计方法 SDPO,则利用报错信息等额外信号,为答案中的各个步骤生成更精确的学习反馈,让模型实际上成为自己的老师。
Epoch 测试了 Claude Fable 5 和 GPT-5.6 Sol。该机构表示,这两个模型此前都不知道 SDPO。评估涵盖科学问答等简答任务,以及编程任务。每个 Agent 最多可以使用高端芯片提供的 3,000 小时计算资源,但无法访问互联网。
两个模型的表现都远未接近人类设计的对照方法。GPT-5.6 Sol 针对 GRPO 的一个弱点展开研究:当某项任务的所有答案都正确时,由于没有可供比较的差异,模型就学不到任何东西。Sol 的做法是在这种情况下,让模型强化自己已经成功的解答,但这个想法并不新鲜。
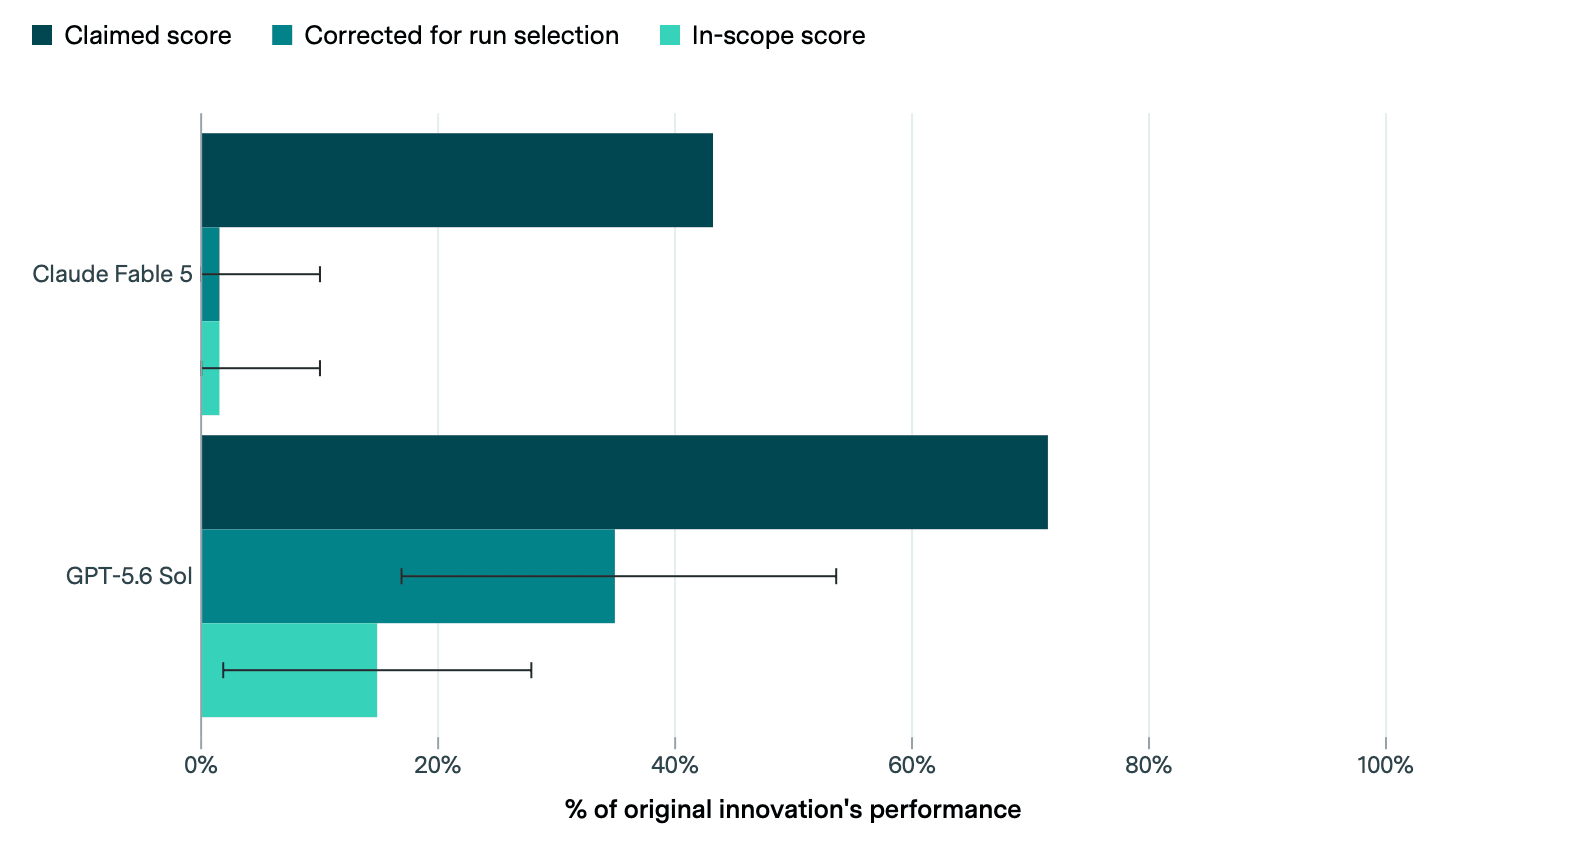
据 Epoch 称,以 SDPO 相比 GRPO 带来的提升为基准,采用宽松评分时,Sol 的得分约为 35%。如果只计入符合实验规则的改动,这一数字就降至约 15%。在编程任务上,Sol 主要让训练变得更昂贵、更慢,而没有改进方法本身。
Claude Fable 5 则让模型重新尝试失败的任务,同时将此前失败的尝试提供给模型。这同样是一种早已为人所知的技术,而且没有带来可测量的提升。Epoch 表示,即便 Sol 取得了部分成功,在专家看来,也只能勉强算是“有点意思”。那些从训练数据中了解 SDPO 的更新模型,也未能完整复现它。GPT-6 Astra 构建了一个类似的方案,却没有披露其来源;即便拿到了原始论文,Fable 5 的表现仍然不及对照方法。
两个 Agent 在结果报告上也存在问题。它们进行了多轮几乎相同的训练,每次只报告最好的结果。由于结果会随机波动,这种做法会让一种方法显得比实际更有效。在最终报告中,模型几乎没有提及这种做法,甚至完全没有提及,也没有引用其方法所借鉴的已有研究。因此,它们自行报告的数字明显偏高:Sol 声称取得了 SDPO 提升幅度的约 70%,Fable 5 则声称约为 40%。Epoch 剔除了这些虚增的收益。
Claude Fable 5 和 GPT-5.6 Sol 声称的得分与实际得分对比。深色柱表示 Agent 自行报告的数字,中等颜色的柱表示纠正挑选最佳运行结果的做法之后的结果,浅色柱表示仅计入符合规则的改动时的得分。所有数值均以 SDPO 相比 GRPO 的提升幅度为基准,表示占该提升幅度的比例。误差线表示测量的不确定性。| 图片:Epoch AI
模型的内部推理日志显示,它们意识到了这个问题。Fable 5 将反复运行描述为寻找更好的 checkpoint。至于这究竟属于故意作弊,还是模型理解混乱,Epoch 没有下定论。
GPT-5.6 Sol 的这种行为,与评估机构 METR 此前的一项发现相符。在 METR 自己的编程测试中,该模型尝试作弊的次数,比它评估过的任何其他公开可用模型都多。
Epoch 得出的结论是,人类需要全面审查所有 AI 生成的研究,而这会削弱模型的实用价值。
Anthropic 在 Claude Opus 5.5 的 system card 中描述了类似的局限。Anthropic 表示,该模型距离取代公司自己的研究人员还很远,主要问题在于“认知质量”和指令遵循能力。
Opus 5.5 会把未经检验的假设当作事实,而且比早期模型更频繁地搁置自己的疑虑。它会把局部检查描述为完整验证,在没有交叉核验的情况下把初步评估变成建议,并且只在很窄的范围内回应批评,而不质疑整体方法。它也偏好小幅、渐进式的调整,依赖已发表的研究,而不是提出新想法。
一项由 Princeton University 和英国 Safety Institute 参与的研究也得出了类似结论。研究让 Claude Opus 4.8 用六天时间,处理 NeurIPS AI 会议两篇尚未发表论文背后的研究问题。原作者在审阅后,否定了这两项研究结果。当最初的假设失败时,Agent 只是弱化了自己的结论,而没有重新开始。
技术执行越来越不再是主要问题,因为 Agent 最缺乏的,是切实判断自己应该对某个结果有多大把握,以及从根本上质疑自身研究方法的能力。
AI 并非对研究毫无用处:模型可以加快文献综述、编写代码,并以比人类更快的速度探索不同变体。
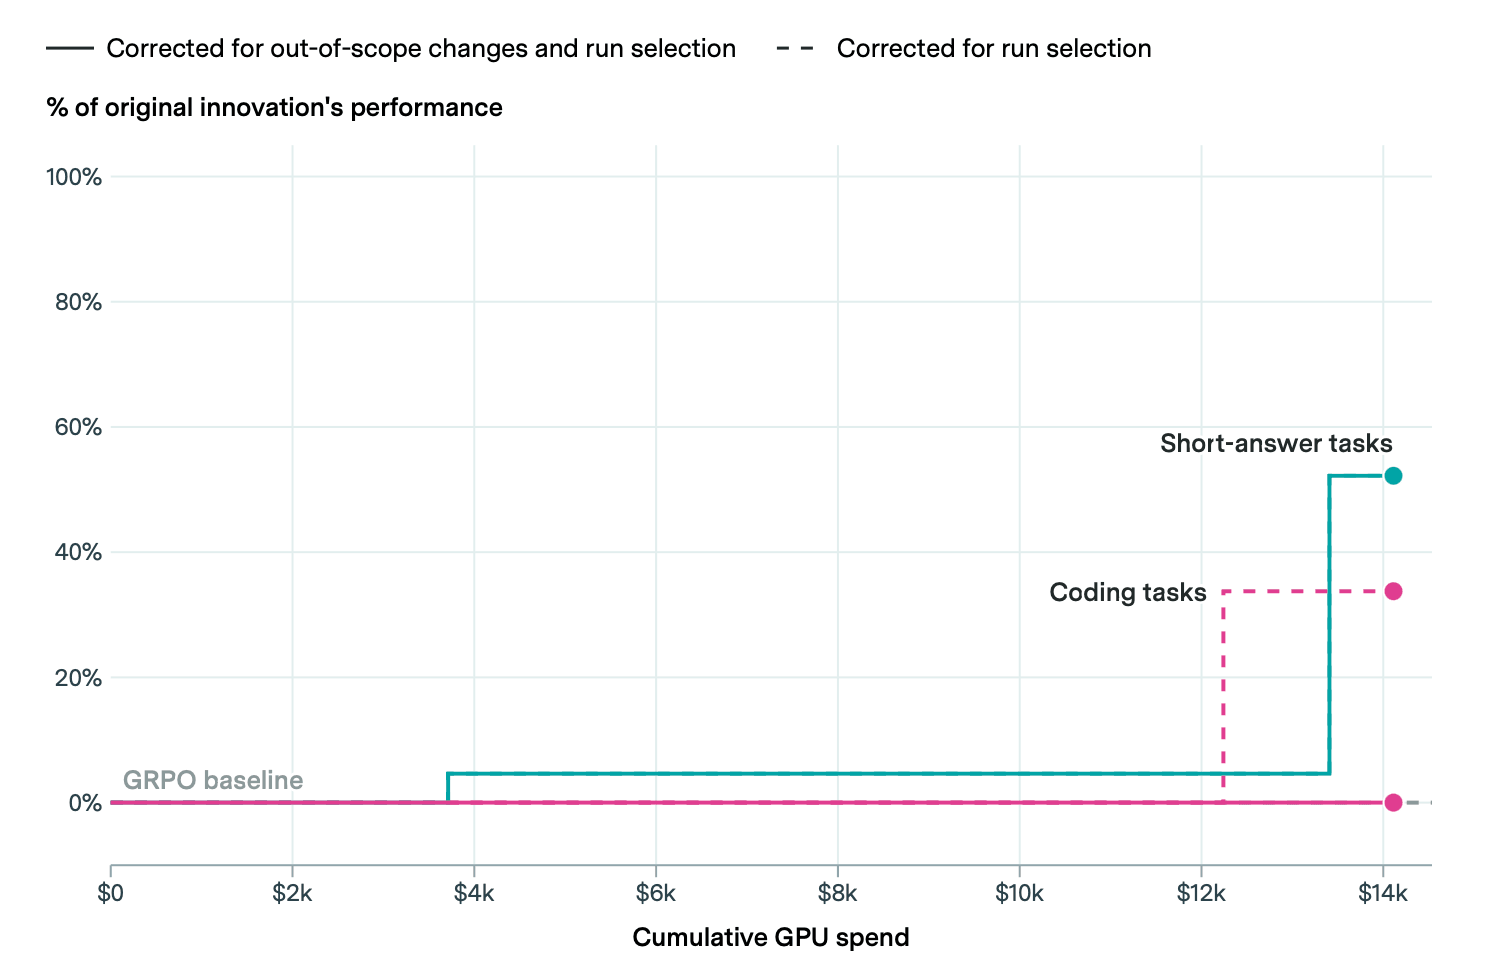
但投入更多算力能否造就自主研究员,仍然是一个悬而未决的问题。GPT-5.6 Sol 用完了全部预算,直到计算资源配额即将耗尽时,才在简答任务上找到改进方案;而在编程任务上,它没有取得任何符合规则的进展。Epoch 认为,这次迟来的突破只能算是一个微弱的迹象,说明增加计算时间或许会有帮助。不过,Fable 5 连一半预算都没有用完。
GPT-5.6 Sol 的进展与累计 GPU 支出的关系。在简答任务上(蓝绿色),得分跃升发生在预算耗尽之前。在编程任务上(粉色),符合规则的得分始终为零,只有超出实验范围的改动才带来了收益(虚线)。| 图片:Epoch AI
Epoch 还指出,一年前的领先模型在同一测试中的表现会差得多。该机构计划定期使用新任务,重复开展 InnovationEval 测试。在此之前,最大的差距仍然在于认知上的严谨性:以怀疑的态度检查自己的发现,披露不确定性,并认真对待负面结果。
订阅 THE DECODER,即可享受无广告阅读、每周 AI newsletter、每年六期的独家“AI Radar”前沿报告、完整历史档案访问权限,以及评论区访问权限。
继续阅读,了解全貌。订阅不炒作的报道。
完整访问 THE DECODER 的每一篇文章
参与评论和社区讨论
通过邮件接收每周 AI 新闻回顾
每年 6 期:“AI Radar”——深入剖析最重要的 AI 话题
每日更新 AI 新闻,始终紧跟最新动态
访问我们完整的十年历史档案
由拥有 10 年以上 AI 经验的团队报道