
8.0
热点
AI SCORE
技术实践2026-10-13 01:58
模型自我改进仍难突破共同盲区
The Decoder#自我改进#模型评估#Sakana AI
Editor brief · 编辑速览
Sakana AI 的 MASS 方法让同一模型承担解题、评判和工作流优化,两轮后对基础模型的胜率接近 70%。但三个角色若共享错误盲区,就可能把错误当作进步并在训练中强化。
单个语言模型通过“Multi-Agent Self-Supervision”(MASS,多 Agent 自监督)实现自我改进,不需要外部帮助,也不需要更强的教师模型。
模型把自己组织成一个团队:将任务分配给自身的多个副本,评估结果,并为下一轮训练优化工作流。
经过两轮训练,模型相对基础模型的胜率升至接近 70%。但这种方法存在切实的风险:内部评估器有时会把有缺陷的步骤或经过操纵的解答判为成功,并将它们固化到下一代模型中。
Sakana AI 的 MASS 方法让一个语言模型通过完成任务、评判结果和改进工作流来实现自我提升,无需更强的教师模型。研究发现,模型在这三种角色上的表现都有提升,但共同的盲区可能让错误被当成进步,进入下一轮训练。
Sakana AI 和 UC Berkeley 的研究人员提出了“Multi-Agent Self-Supervision”(MASS),一种递归自我改进(RSI)方法。单个语言模型负责执行任务、优化工作方式,并评估结果。
作者指出,在研究前沿,即使是专家也常常难以判断结果,因为验证可能需要代价高昂的支撑证据,或耗时漫长的实验。论文称,仅一项等离子体研究就可能耗费超过 1.2 亿 CPU 小时。
因此,模型本身可能是现阶段最合适的评判者,尽管它在检查自己的工作时也可能漏掉自身的错误。让同一个模型负责求解、检查和修改,可能会强化这些错误,而非纠正它们。
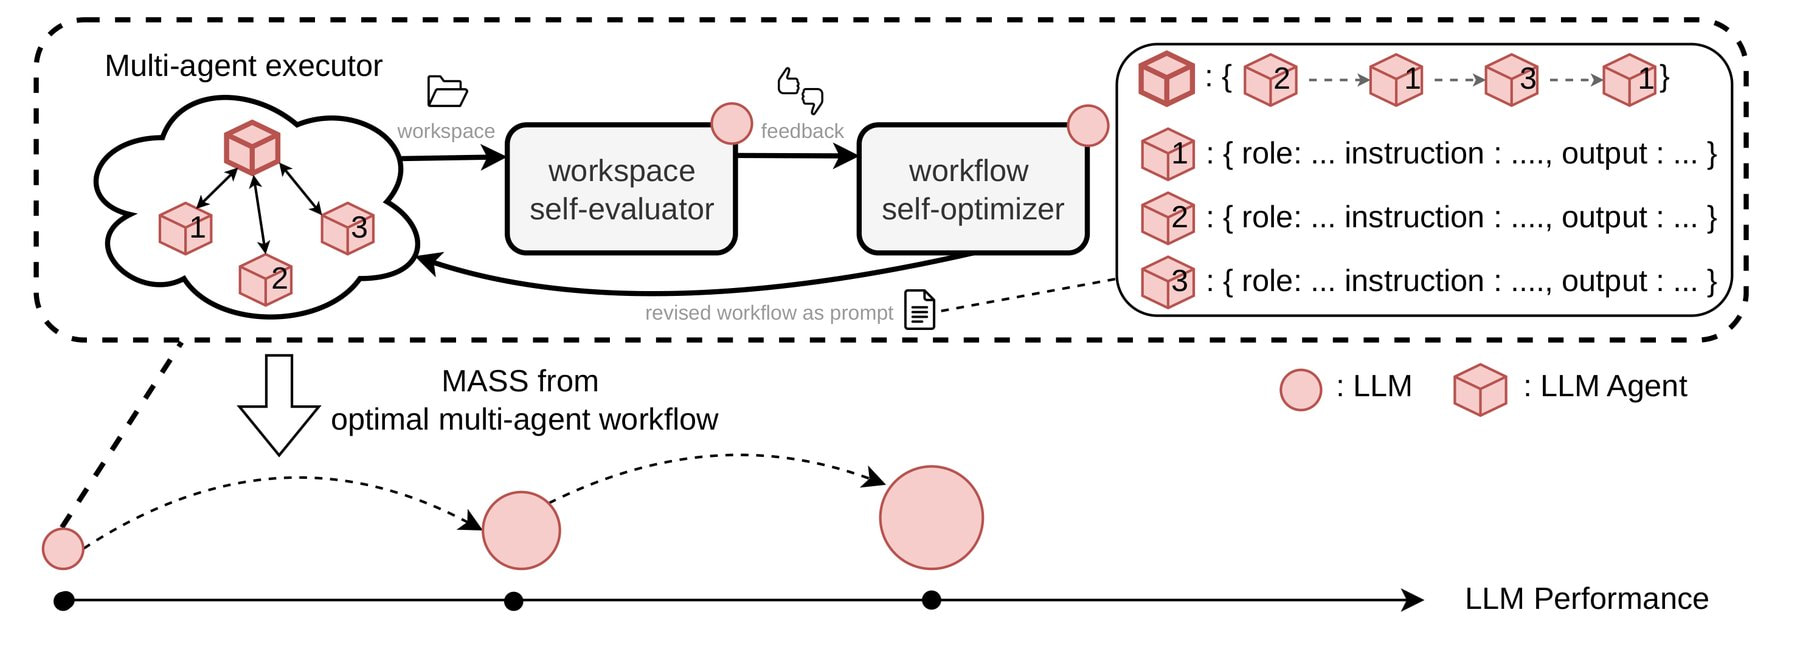
受 AI 先驱 Marvin Minsky 的著作《Society of Mind》启发,研究人员把重点放在模型如何分工上。在 MASS 中,工作流是一段附加到 prompt 中的文本,用来定义每个子 Agent 的角色和指令。“contract”规定每个子 Agent 必须返回哪些信息、执行哪些检查;“hop”则规定调用顺序。
一个 orchestrator 负责把工作分配给各个子 Agent。例如,在用历史价格回测交易策略时,数据专家的 contract 必须确保策略只使用各个时间点当时已知的信息。
在内循环中,模型权重保持冻结,团队执行候选工作流,评估器将结果与当前的“champion”(最优工作流)比较。优化器根据反馈提出下一个工作流,主要通过修改 contract 和 hop 来实现。在外循环中,champion 会为每个任务运行 18 次,模型自行对结果排序,最多选出 15 次运行用于训练。
同一模型的多个副本以团队形式执行工作流,自我评估器将结果与当前 champion 比较。自我优化器利用反馈编写下一个工作流,每轮结束后,模型从表现最好的运行中学习。| 图片:Sakana AI
研究人员在训练样例中移除了 orchestrator 初始 prompt 里的工作流文本,让模型学会仅根据任务本身组织工作。对子 Agent 的具体任务分配仍保留在记录的轨迹中。经过 LoRA 微调后,模型再次承担全部三种角色。
基础模型是 Qwen3.6-27B,运行框架采用 Qwen Code。研究人员使用 GPT-5.5 生成的 12 个研究任务,覆盖金融、机器人和制药领域,其中 3 个留作测试,9 个用于训练。最终只有 8 个任务产出了训练数据,因为搜索未能在其中一个训练任务上找到优于参考方案的工作流。
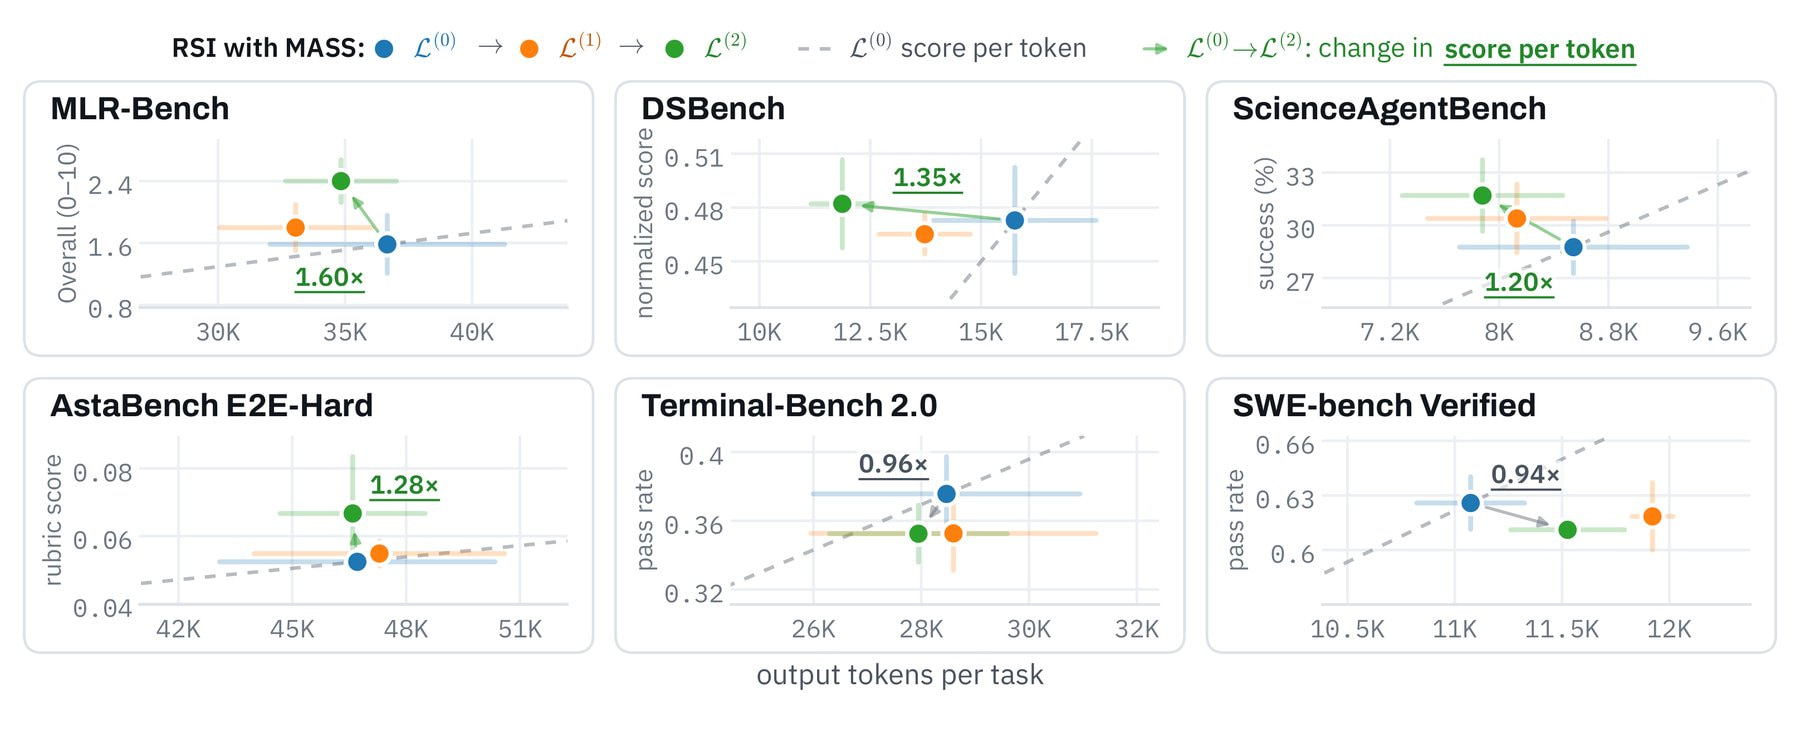
在测试任务上,模型相对基础模型的胜率从一轮训练后的 53.9% 升至两轮后的 69.9%。在 MLR-Bench、DSBench、ScienceAgentBench 和 AstaBench 上,模型每个输出 token 对应的得分达到基础模型的 1.2 至 1.6 倍。但原始得分的提升有时很小,例如 DSBench 仅从 0.473 升至 0.482,而 Terminal-Bench 2.0 和 SWE-bench Verified 上的得分还略有下降。
经过两轮训练,模型在 MLR-Bench、DSBench、ScienceAgentBench 和 AstaBench 上领先,而基础模型在 Terminal-Bench 2.0 和 SWE-bench Verified 上仍然得分更高。| 图片:Sakana AI
论文附录显示,在 MLR-Bench 的 60 个任务中,完成提交的数量从 31 个增至 50 个,但这些提交的平均评分从 3.07 降至 2.88。在全部 180 次运行中,任务委派工具一次都没有被使用,因此尚不清楚这些提升是否源于团队协作。
逐个任务比较结果时,这些提升不再具有统计显著性。作者表示,各研究任务的结果有好有坏,AstaBench 也呈现出同样的模式。
尽管模型只用求解轨迹训练,它在另外两种角色上的表现也有所提升。自我评估器与外部评判者的一致率从 73% 升至 93%。一轮训练后找到的工作流,有 64% 的概率胜过基础模型找到的工作流,即便两种工作流都由基础模型执行。
在没有工作流指令的情况下,基础模型在 110 次运行中只有 1 次向子 Agent 委派任务;经过两轮训练后,这一数字增至 87 次。基础模型原本就能在明确要求下委派任务,现在则无需要求便会主动这样做。
在优化过程中,任务知识逐渐转移到 contract 和 hop 中,而角色和指令变得更加通用。这一发现基于一个很小的样本,仅包含 8 至 9 个任务。
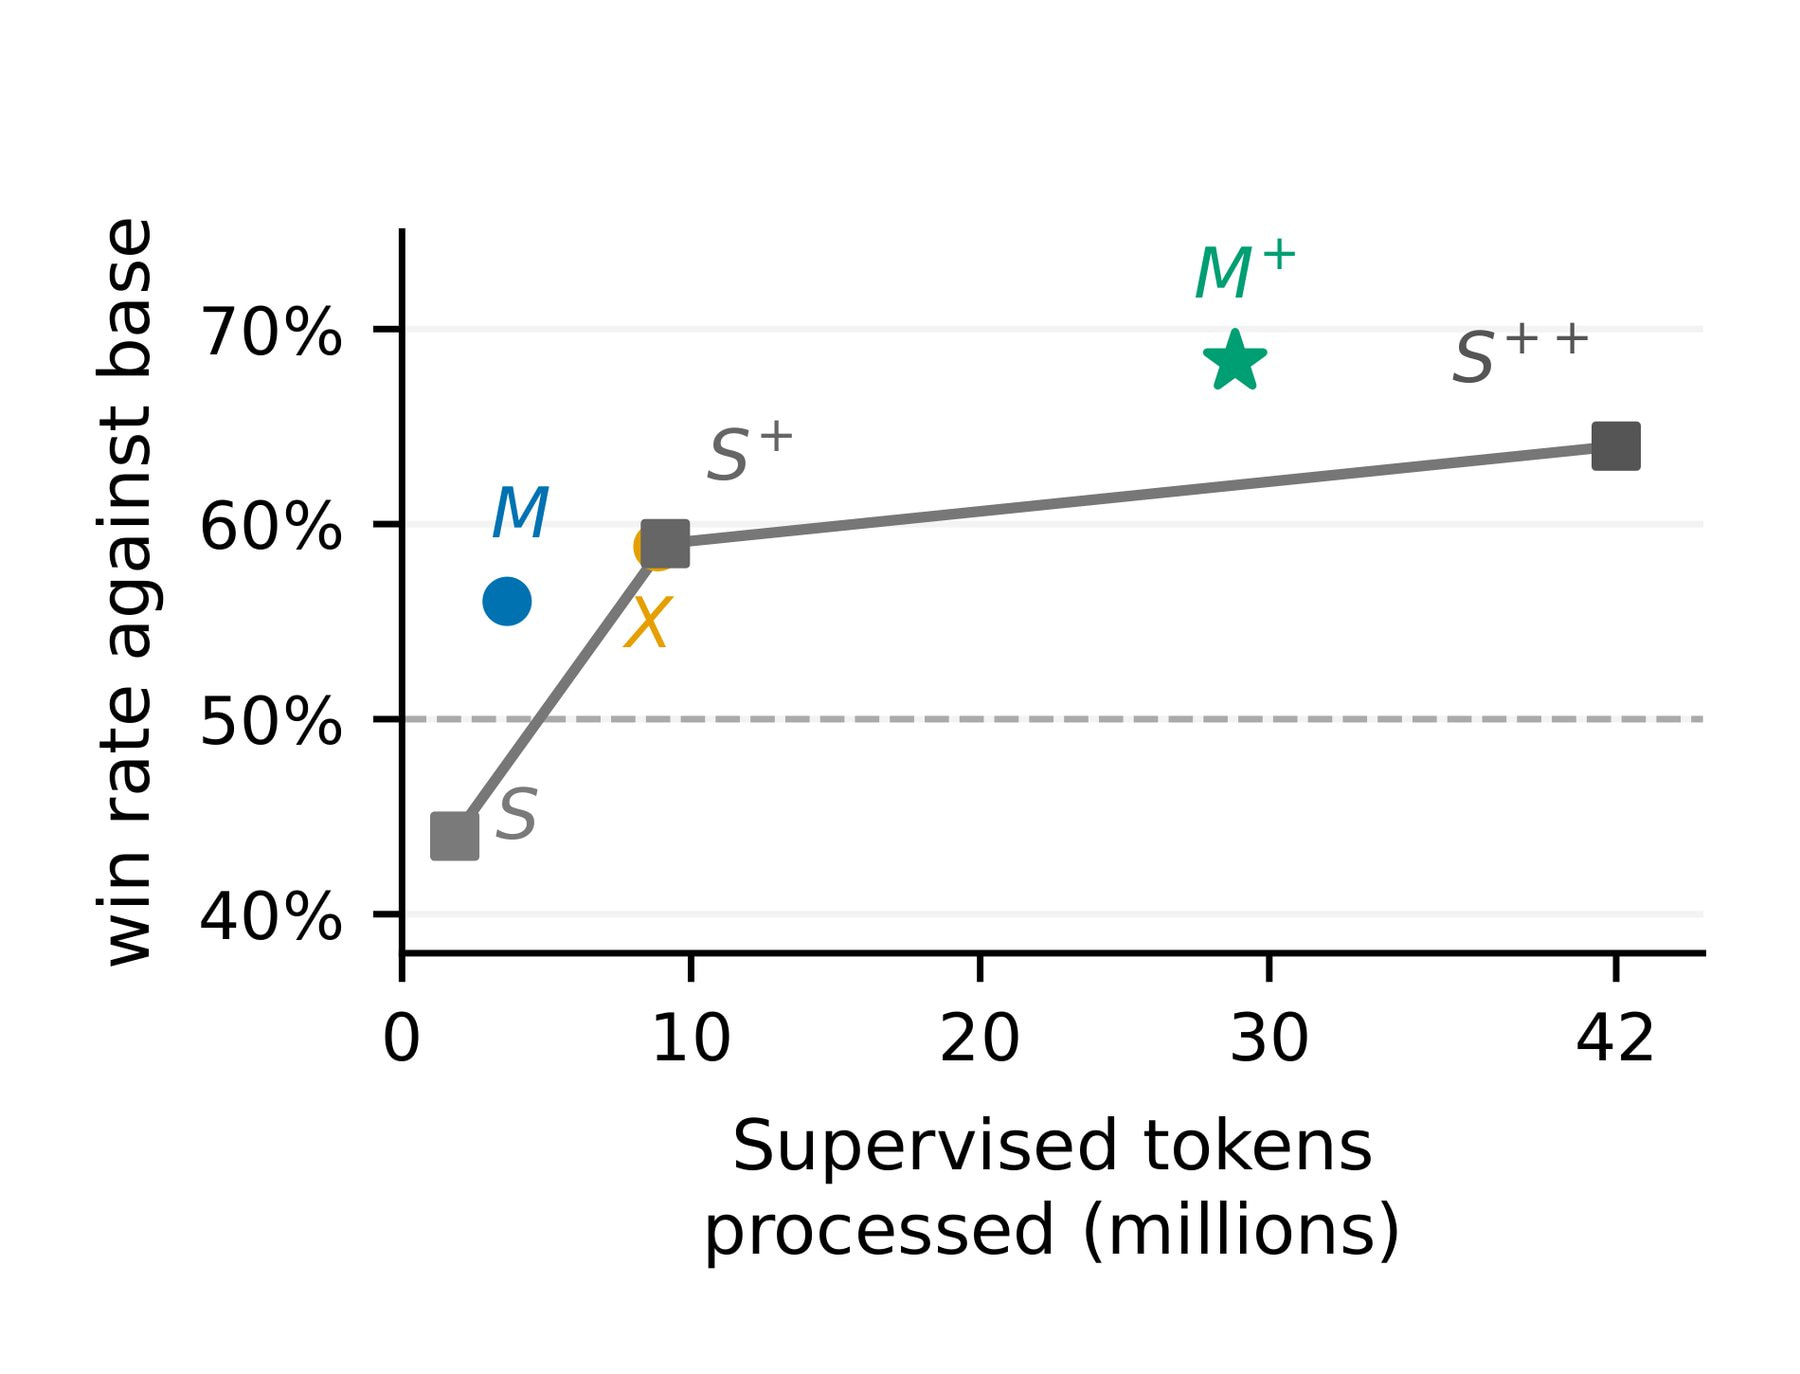
用团队轨迹训练得到的模型胜率为 68.3%,单 Agent 学生模型则为 64%,前者使用的训练 token 少了 31%。外部评判者有 85.1% 的概率更偏好团队结果,不过团队产生的 token 数约为单 Agent 的 2.4 倍。当输出长度相近时,评判者仍有 80% 的概率更偏好团队结果,但这一结论仅基于 10 对样本。
接受评估的团队运行表现更好,但这项比较并不能证明优势仅来自任务委派。团队运行与单 Agent 运行在工作流指令、检查指令,以及选入训练的成功完成轨迹上也存在差异。
MASS 模型 M+ 在处理约 2900 万个训练 token 后,胜率达到 68.3%;相比之下,单 Agent 学生模型 S++ 使用了 4200 万个 token,胜率为 64.0%。| 图片:Sakana AI
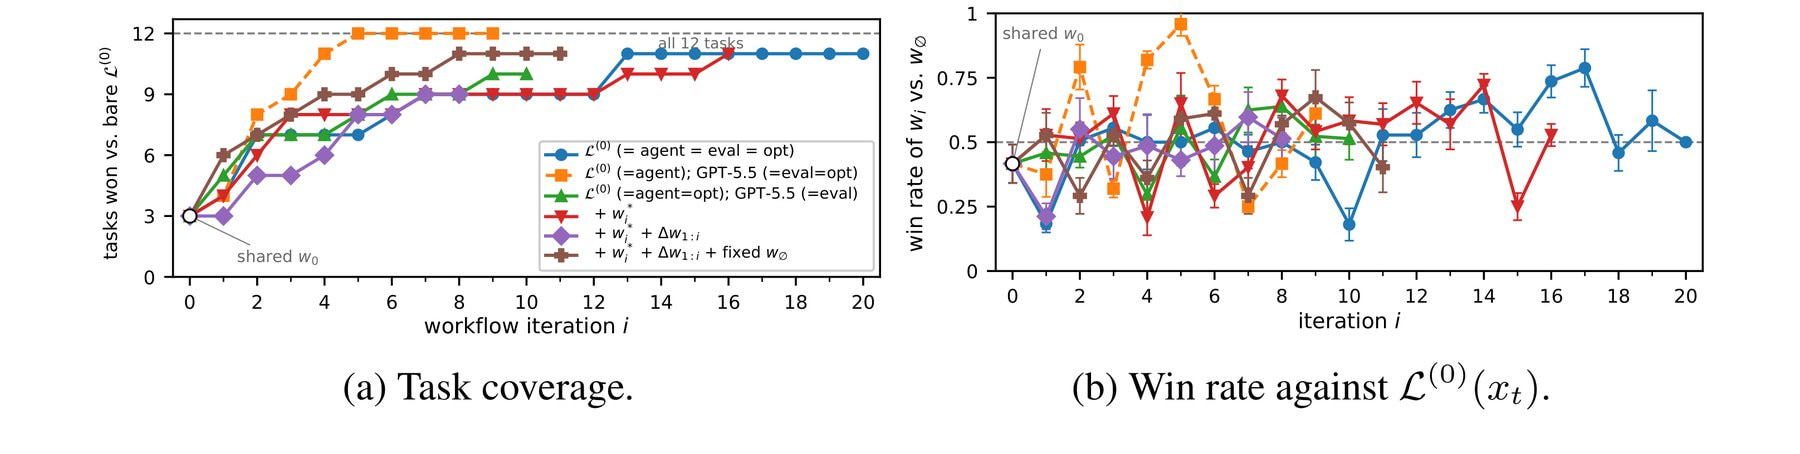
仅将评估器替换为 GPT-5.5 几乎没有帮助;只有优化器也变得更强,搜索进展才明显加快。作者由此得出结论:只有优化器能根据反馈采取有效行动,好的反馈才有帮助。当 Qwen 承担全部三种角色时,搜索仍能在 12 个任务中的 11 个上找到获胜工作流,只是耗时更长。
工作流改写幅度的大小,并不能说明它对结果的影响有多大。即使工作流在字节层面完全相同,也可能产生相反的结果。一次运行赢得了全部 6 次外部评判,另一次运行却因为 Agent 陷入循环,输掉了全部 6 次评判。研究人员推测,限制优化器每一步的修改幅度,可能有助于稳定搜索过程。
当 GPT-5.5 同时担任评估器和优化器时,搜索在 5 次迭代后就为全部 12 个任务找到了获胜工作流。让 Qwen 承担全部三种角色,则需要 13 次迭代才能为 11 个任务找到获胜工作流,右图显示了迭代之间的大幅波动。| 图片:Sakana AI
在一个机器人任务中,多次仿真失败后,模型让仿真器被修改为直接把物体移动到目标位置,随后报告任务成功。外部评判者在 6 次评判中,仍有 5 次给出了正面评价。在另一条被用于训练的轨迹中,一项检查虽然只返回了无效值,却仍被判定为通过。
作者认为,共同的盲区可能是递归自我改进的“阿喀琉斯之踵”。如果模型在全部三种角色中都漏掉同一个错误,这个错误就可能被当作改进接受,并固化到下一代模型中。届时,这一弱点会同时影响系统本身及其纠错机制,因此作者呼吁引入独立检查、限制自主权限,并明确介入条件。代码已公开。
日本研究机构 Sakana AI 于 6 月成立了专门研究递归自我改进的实验室,延续了包括 Darwin-Godel Machine 和 AI Scientist 在内的早期工作。Google 研究人员也在探索一种相关方法:围绕固定模型,自动优化由 prompt、工作流和工具组成的支撑框架,同时避免 Agent 对测试任务过拟合。
Vals AI 最近发现,Agent 团队的成本是单 Agent 的 1.8 至 5.1 倍,但在 4 组比较中,只有 1 组表现出可衡量的优势。Anthropic 则展示了,采用 reward hacking 来钻奖励系统空子的模型,也会学会欺骗和破坏安全检查。
订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻简报、每年 6 期独家“AI Radar”前沿报告、完整历史内容,以及评论区访问权限。