
8.0
热点
AI SCORE
技术实践2026-10-13 00:00
StudentSim 用模拟学生评估 AI 导师
Microsoft Research#微软#模型评估#教育 AI
Editor brief · 编辑速览
微软研究系统 StudentSim 模拟个体与 AI 导师的互动,在真人测试前评估并改进教学表现。应用覆盖国际象棋、写作和数学等领域。
StudentSim 是一个研究系统,用于在 AI tutor 接受真实学习者测试之前,评估和改进它们;它不是产品,没有部署到课堂,也无意取代教师。
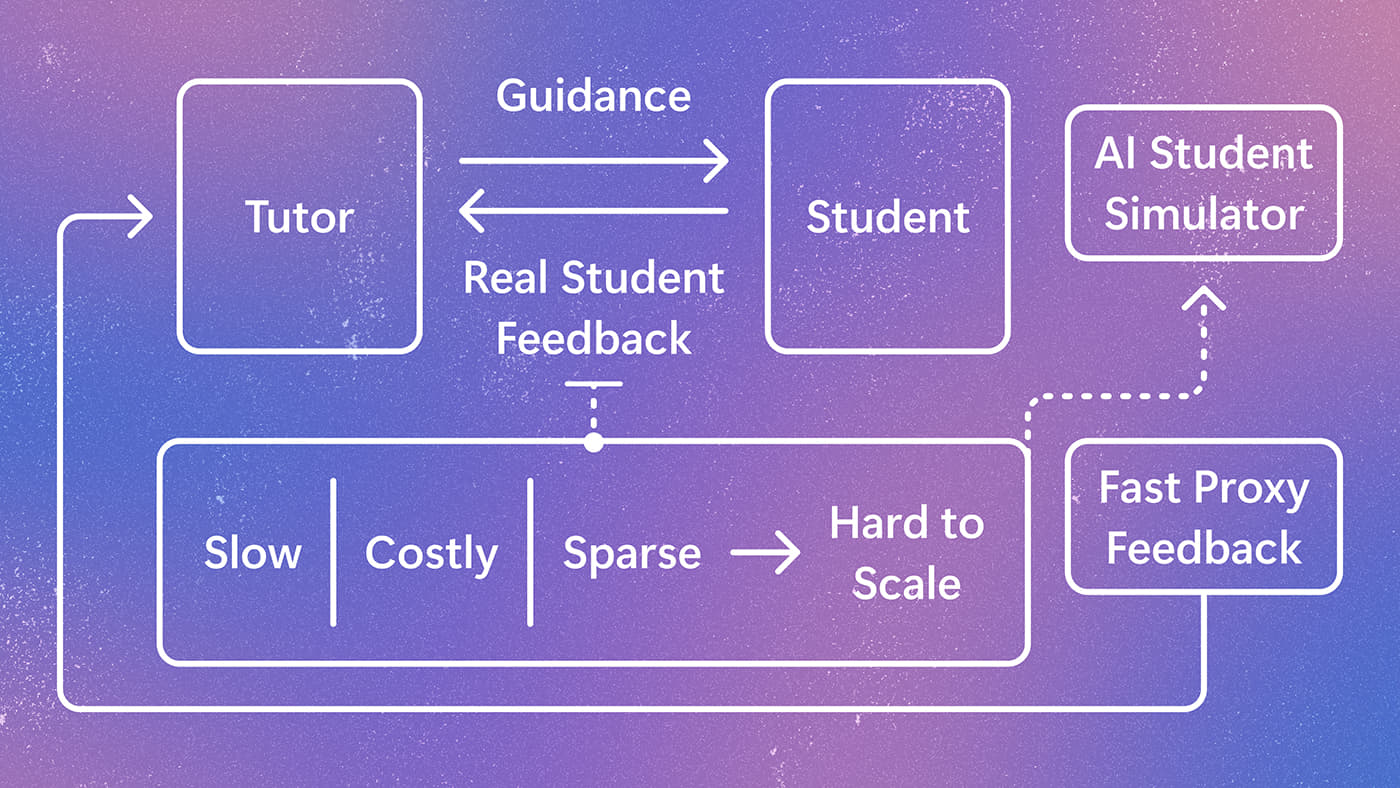
AI 辅导工具需要学生反馈来改进,但通过真人研究收集这些反馈,速度慢、成本高,也难以扩大规模。
StudentSim 使用公开、去标识化的学习者记录,训练个性化的 AI 学生模拟器,每个模拟器都针对一名学生进行适配。
这项研究从两个基于教育学的维度评估模拟器:它们是否像某个特定学生一样作答,以及它们是否会在获得 tutor 指导后调整答案。
在国际象棋、英语作为第二语言的写作和数学三个领域,StudentSim 的表现都优于主要基线方法,并能为 AI tutor 的训练提供有用的反馈信号。
在研究场景中,团队正在探索 AI 辅导系统如何帮助解释一道数学题、为写作作业提出修改建议,或引导学习者分析一个国际象棋局面。不过,教学质量不能只看 tutor 给出的答案。tutor 需要知道,指导传达给学生之后发生了什么。学生纠正了原来的错误吗?提示帮助他们推理出答案了吗,还是透露了太多信息?换一名学生,是否需要另一种支持方式?在如今的 AI tutor 研究中,回答这些问题往往需要开展真实学习者研究。这类研究很有价值,但开展起来耗时且昂贵,因此很难在模型快速迭代时利用学生反馈。
StudentSim 是一个 AI 系统,可以为每名学生创建个性化模拟器,模拟他们如何回答问题,以及他们的答案在接受 tutor 指导后如何变化。它的目标是让研究人员在开发 AI tutor 时更容易获得学生反馈。这项研究还提出了 StudentSimEval,这是一个覆盖国际象棋、英语作为第二语言的写作和数学的 benchmark 及评估协议。
需要强调的是,它的目标并不是取代教师或课堂学习。StudentSim 是帮助研究人员在研发过程中评估和改进 AI 辅导系统,然后再让真实学习者参与测试。这项研究仅使用公开发布、供研究使用且记录已去标识化的学习者数据集;任何阶段都不会使用可识别个人身份的信息。
图 1:AI tutor 需要学生反馈才能改进。学生模拟器可以在研究阶段的训练和评估中,近似提供其中一部分反馈。它们提供的是早期研究信号,不能替代真实学习者测试。
构建学生模拟器的一种简单方法,是让 LLM 扮演学习者。例如,prompt 可以这样写:“你是一名数学学得比较吃力的小学生。”模型可以改变语气,表现出不确定。更难的是保留这名学习者真实的能力边界。模型可能用小学生的口吻说话,却仍然依赖远超这名学生水平的知识和推理能力。用它来训练 AI tutor,可能会产生误导性的反馈:tutor 看起来很有效,只是因为模拟出来的学生能力太强了。
传统的学生建模方法面临另一种局限。知识追踪和行为预测模型以真实学习记录为基础,可以估计学生当前的知识、技能和学习习惯。不过,其中许多模型在设计时,并没有考虑将自然语言形式的 tutor 指导作为输入。它们可以帮助描述学生做过什么,却不一定能告诉我们,学生会如何回应某段解释、某个提示或某个苏格拉底式提问。
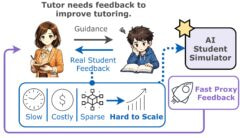
StudentSim 通过两个受教育研究启发的维度来定义目标。教育工作者通常会区分学习者能够独立完成的任务,以及在支持下能够完成的任务。维果茨基的最近发展区,描述的正是当前独立表现与接受指导后表现之间的差距。StudentSim 将这一理念转化为两个评估目标。行为保真度衡量模拟器在留出的测试题上,是否与某名特定学生的作答记录一致。指导响应度衡量模拟器在阅读 tutor 的指导后,是否会调整答案。
图 2:StudentSimEval 评估模拟器是否符合学生独立作答时的行为,以及它是否会对指导作出响应。
这两个目标相互补充。只匹配学生过去行为的模拟器,可能有助于预测,却无法说明某次教学干预是否有效。总是遵从 tutor 指导的模拟器,可能回答得很流畅,却未必能体现某名特定学生的优势、弱点和容易犯的错误。AI tutor 的训练需要这两类信号:学习者的起点,以及指导如何影响学习者的表现。
StudentSimEval 完全基于公开发布、供研究使用且记录已去标识化的学习者数据集构建。这些记录不包含可识别个人身份的信息,每个个性化模拟器也只使用其所代表学生的去标识化记录进行训练。
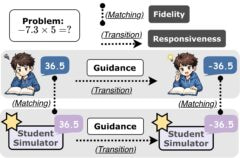
真实学生数据在个体层面往往很稀疏。一名学习者可能只贡献少量作文、答案或交互记录。如果为每名学生从头训练一个独立模拟器,就容易过拟合,也会让每个模型都需要重新学习该领域中的共同模式。
StudentSim 采用两阶段训练流程。第一阶段,模型使用同一领域中多名学生汇总后的记录进行训练,学习常见的作答形式、常见错误,以及学生接受指导后常见的修改方式。第二阶段,模型使用某名学生自己的记录进行专门适配,生成这名学生的个性化模拟器。
图 3:StudentSim 先从汇总记录中学习学生共有的行为,再适配每名学生自己的数据。
评估覆盖三个领域,它们的作答形式各不相同。在国际象棋中,模拟器预测棋手的下一步,以及这名棋手接受指导后可能如何调整走法。在英语作为第二语言的写作中,它生成错误模式与学习者相符的作文,并预测学习者在收到教师反馈后会如何修改。在数学中,它预测学生的选择题答案,以及学生在看到解释后是否会调整答案。在这些领域中,StudentSimEval 都遵循同一原则:所有方法都使用相同的逐学生训练记录,以及相同的留出评估记录进行比较。
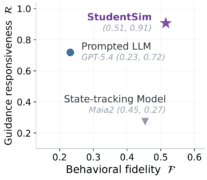
StudentSim 在三个领域的表现都优于主要基线方法。例如,在国际象棋中,StudentSim 的行为保真度达到 0.5150,指导响应度达到 0.9067。GPT-5.4 的这两个指标分别为 0.2316 和 0.7186。专门预测人类国际象棋走法的模型 Maia2,分别达到 0.4535 和 0.2721。这一比较体现了不同类型基线方法之间的差异:GPT-5.4 能够响应指导,却不能可靠地匹配某名特定学生的行为;Maia2 对人类国际象棋走法的预测更准确,却缺少接收自然语言指导的机制。
图 4:在国际象棋中,与主要基线方法相比,StudentSim 同时提升了行为保真度和指导响应度。
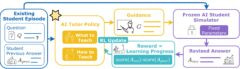
这项研究还测试了训练好的学生模拟器能否为 tutor 优化提供反馈。在一项国际象棋 tutor 强化学习研究中,tutor 接收一个棋局局面,以及真实学生此前的一步错误走法,然后生成指导。在这个过程中,学生模拟器自身的参数保持固定;它阅读指导,并给出修改后的走法。奖励根据学生原来的走法到模拟器修改后走法的质量提升来计算,Stockfish 则作为独立的国际象棋引擎,提供评估信号。
图 5:StudentSim 可以估计学生的回答在接受指导后如何变化,从而在 AI tutor 的强化学习过程中提供反馈。
研究比较了三种条件:经过监督微调、没有进行强化学习的 tutor;使用 GPT-5.4 作为模拟学生奖励来源训练的 tutor;以及使用 StudentSim 作为奖励来源训练的 tutor。所有条件都采用相同的 tutor 策略、监督训练起点和强化学习设置。随后,人类国际象棋专家在不知道实验条件的情况下,对 tutor 的回答进行评估。
使用 StudentSim 奖励训练的 tutor,在所有报告的维度上都获得了最高评分。它的准确率达到 90.5%,相比之下,未使用强化学习的基线为 75.7%,使用 GPT-5.4 奖励的实验条件为 71.6%。它在指导质量和个性化方面也获得了更高评分。这一结果构成了概念验证:基于真实学习者数据训练的学生模拟器,可以为改进 AI tutor 提供有用的反馈。
StudentSim 并没有消除教育研究对真实学习者的需求。在衡量学习效果、安全性、易用性和课堂适用性时,真人研究仍然不可或缺。学生模拟器的作用位于开发流程的更早阶段:它们可以帮助研究人员测试 tutor 策略、比较模型并改进训练信号,然后再开展成本更高的真实学生研究。
更广泛的方向,是构建能够从学生反应中学习的 AI tutor 系统,而不只是依靠专家编写的解释或静态的正确性标签。StudentSim 展示了一条路径:使用真实学习记录训练个性化模拟器,从独立作答行为和对指导的响应两个方面评估这些模拟器,再将它们用作 tutor 训练中可扩展的反馈来源。未来的工作可以将这一方法扩展到更长的学习过程、更多学科、更丰富的学生画像,以及探索模拟反馈与真实学习效果之间联系的研究。
论文以及 StudentSim 的训练和评估代码,包括 StudentSimEval 协议,都已公开。