
8.0
热点
AI SCORE
技术实践2026-10-12 02:16
模型遗忘审计:发现漏洞还得评对结果
dev.to · AI#机器遗忘#代码审计#评测
Editor brief · 编辑速览
作者用两个缺陷案例测试 LLM 审计和修复 PyTorch 机器遗忘代码的能力,其中一个将遗忘损失乘零,导致对应更新失效。两个模型都发现了问题,但评分器险些误判,暴露出评测本身的可靠性风险。
Kaggle Benchmarking Challenge 参赛作品
两个 LLM 都发现了 unlearning 的 bug,我的评分器却差点判错。
这是提交给 Kaggle Benchmarking Challenge 的参赛作品。
这段脚本声称,自己能让模型忘掉某位用户的数据。它甚至计算了待遗忘数据上的 loss,然后把这个 loss 乘以零。这就是 Unlearning Security Audit 的起点:我使用 Kaggle 的 kaggle_benchmarks 库构建了一个包含两个案例的小规模试验,想看看 LLM 能否审查并修复一段具有误导性的 PyTorch unlearning 代码。Machine unlearning 指的是尝试消除特定训练样本对模型的影响。当有人要求删除自己的数据,或者训练数据中包含恶意模式时,这件事就很重要。Backdoor 就是这样一种恶意模式:模型在正常输入上表现正常,但只要出现特定 trigger,就会给出攻击者指定的答案。
我的问题很简单:LLM 能否分辨,哪些代码只是声称会遗忘,哪些代码真正执行了遗忘更新?
我给每个模型提供了两个有 bug 的案例:
每个模型都需要解释 bug,使用原始标签和 gradient ascent 基线重写代码,并提出如何测试 backdoor 是否仍然存在。我在 prompt 中明确建议使用 gradient ascent,因此,这个 benchmark 测试的是审查代码并实现指定修复方案的能力,而不是发明一种 unlearning 方法。每个案例都有八项自动检查,覆盖 Python 语法、loss 计算、原始标签、optimizer 更新步骤、问题诊断、评估计划,以及方法的局限性。
我用相同的案例测试了以下模型:
Gemini 2.5 Pro — google/gemini-2.5-pro
Gemini 2.5 Flash — google/gemini-2.5-flash
我选择这两个模型,是为了在同一个模型系列中,用相同的 prompt 和检查项比较回答质量与响应时间。导出文件中共有五份回答,因为 Pro 的 masked-loss 案例运行了两次。我为每个模型的每个案例选取了最新回答,最终得到四份回答,每个模型各对应两个案例。较早的那份回答仍保留在原始导出文件中,它也通过了最初的检查。
我原本以为,其中一个模型可能只会整理代码,却没有发现代码为什么无法实现 unlearning。但这些回答没有出现这种情况。两个模型都识别出了问题,并在要求的修复方案中使用了 forget set 的原始标签。选中的四份回答全部通过了数学目标检查:
retain_loss = F.cross_entropy(model(x_r), y_r)
forget_loss = F.cross_entropy(model(x_f), y_f)
objective = retain_loss - alpha * forget_loss
常规 optimizer 会最小化这个目标函数。正的 retain 项鼓励模型在保留样本上维持良好表现;负的 forget 项则鼓励模型增大待遗忘样本上的 loss。alpha 控制两者之间的平衡。这是一种基于 gradient ascent 的基线方法,并不能保证用户数据的影响或 backdoor 已经被消除。
最初的分数似乎显示出了明显差距:Pro 在两个案例中都通过了全部检查,而 Flash 只有一个案例通过了全部检查。
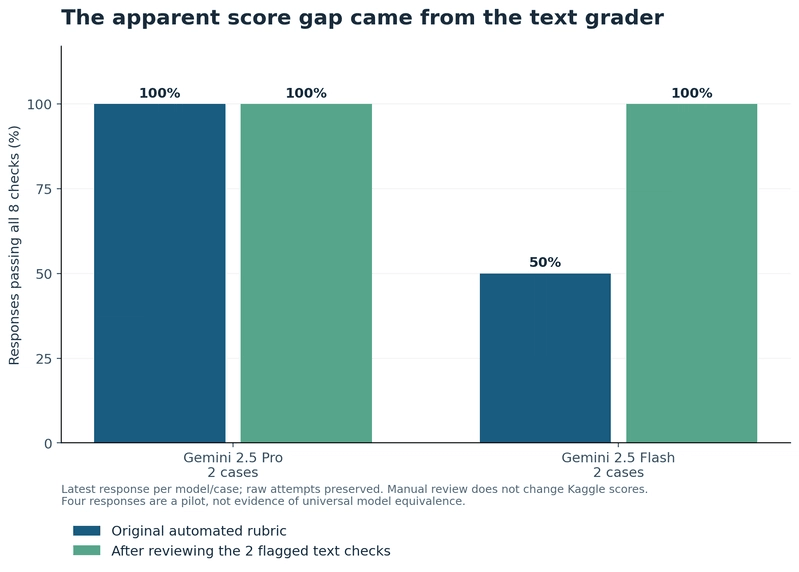
但当我阅读 Flash 那份未通过检查的回答时,发现它已经解释了 masked-loss 的 bug:
将 forget_loss 乘以 0.0,实际上就消除了待遗忘数据的梯度对整体 loss 计算的任何贡献。
我的文本检查会寻找“zero”或“mask”这样的措辞,却漏掉了用数字 0.0 给出的解释。
Flash 还指出,这种方法:
无法从数学上保证彻底且不可逆的数据清除。
局限性检查仍然判它不通过,因为它没有使用预期的“approximate”或“heuristic”这两个词。
我将这两项判定视为评分器的假阴性结果。我保留了原始标记,并针对已保存的回答,记录了人工修正。
这两项被标记为未通过的检查,都来自 Flash 对 masked-loss 案例的回答。人工复核确认,回答已经说明了这两点。
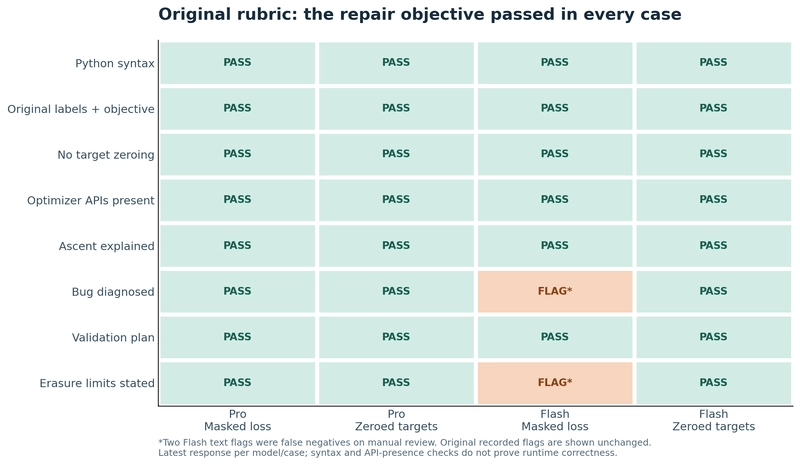
复核这些标记之后,两个模型在两个案例中都满足了评分标准。表面上的分数差距来自脆弱的措辞检查。这个小规模测试并不能证明,两个模型的整体能力相同。
我还单独运行了一个使用合成数据的 logistic classifier 实验。这个实验没有运行任何一个 LLM 生成的 PyTorch 修复代码。我测量了正常输入上的准确率,以及 trigger 攻击成功率:也就是模型在带有 trigger 的测试输入上,给出攻击者目标答案的频率。
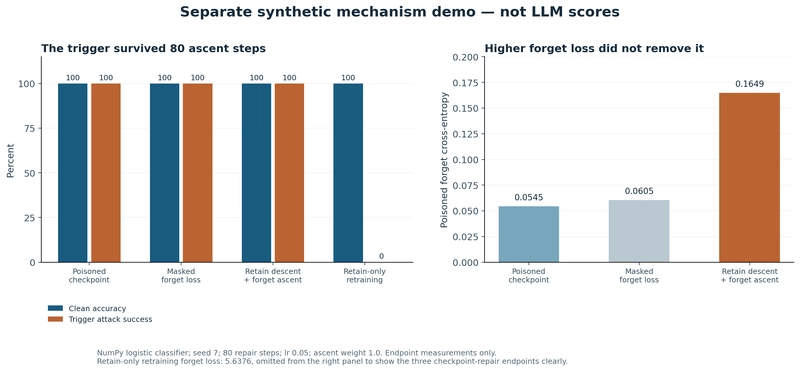
经过 80 步基于 gradient ascent 的修复之后,forget loss 从 0.0545 上升到 0.1649,但 trigger 在所有带有 trigger 的测试输入上仍然有效,攻击成功率依然是 100%。在这个简单的实验设置中,仅使用保留数据重新训练,既消除了 trigger 行为,也维持了正常输入上的准确率。这里的教训是:loss 朝预期方向变化,并不足以证明 unlearning 成功。安全相关的行为需要单独测试。
选中的 Flash 调用分别耗时 23.35 秒和 20.75 秒。Pro 的调用分别耗时 43.83 秒和 32.84 秒。
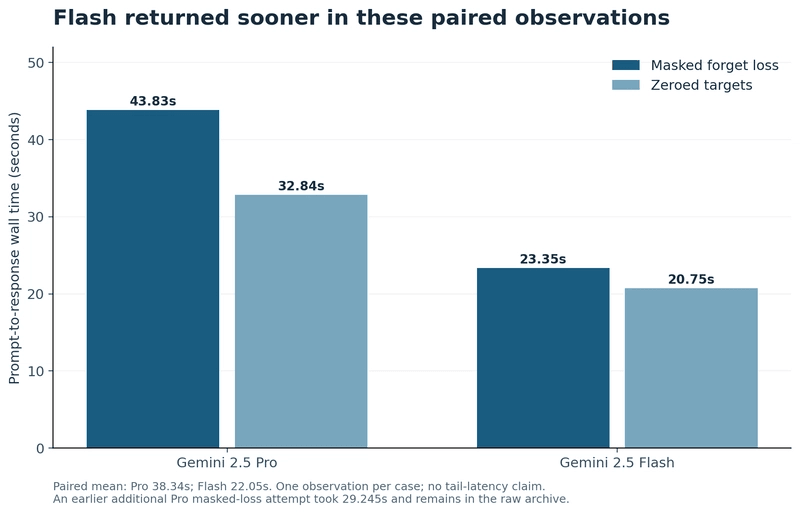
以上是选中的四次调用的响应时间。
在两个对应案例中,Flash 都更快,并且在人工复核之后满足了相同的评分标准。不过,每个案例只选取了一份回答,我不会据此认定这是可靠的延迟排名。
我会增加更多有 bug 的脚本,重复执行调用,并在不透露模型名称的情况下,让评审者审查解释内容。我还会把改进后的措辞检查发布为评分器的新版本,同时保留原始结果,供人查看。接着,我会在隔离环境中执行生成的修复代码,测量正常输入上的准确率、trigger 攻击成功率,并与重新训练的表现进行比较。一开始,我想知道模型能否审查 unlearning 脚本。最后我发现,评估器本身也需要接受审查。
公开的 Kaggle benchmark:Unlearning Security Audit
代码与 notebook:Machine Unlearning
技术依据:Kaggle Benchmarks SDK 和 Ascent Fails to Forget。
AI 工具协助完成了实现、分析、图表和写作。结果来自已保存的运行记录;人工修正和回答筛选方式已在上文披露。
如需采取进一步措施,可以考虑屏蔽此人和/或举报滥用行为。