万亿参数的模型开放权重了,真要搬进机房,量化版仍得准备四张 B200 或 B300。另一边,AI 编程工具把文件删了,恢复菜单却未必能找回来。这两件事放在一起,很像我们接入 AI 时的日常落差。能力看着越来越强,账单、权限和验收还得自己管。2026 年 10 月 30 日这份 AI 热点日报,我想沿着模型选型、执行权限、并行协作、输出验收、知识检索和调用成本六条线聊,帮你判断哪些值得试,哪些先别急着放进生产。
一、Mistral Large 4 开放权重,团队就该自部署吗?
先说结论,我会把它放进候选名单,但不会因为「万亿参数」就去申请机器。
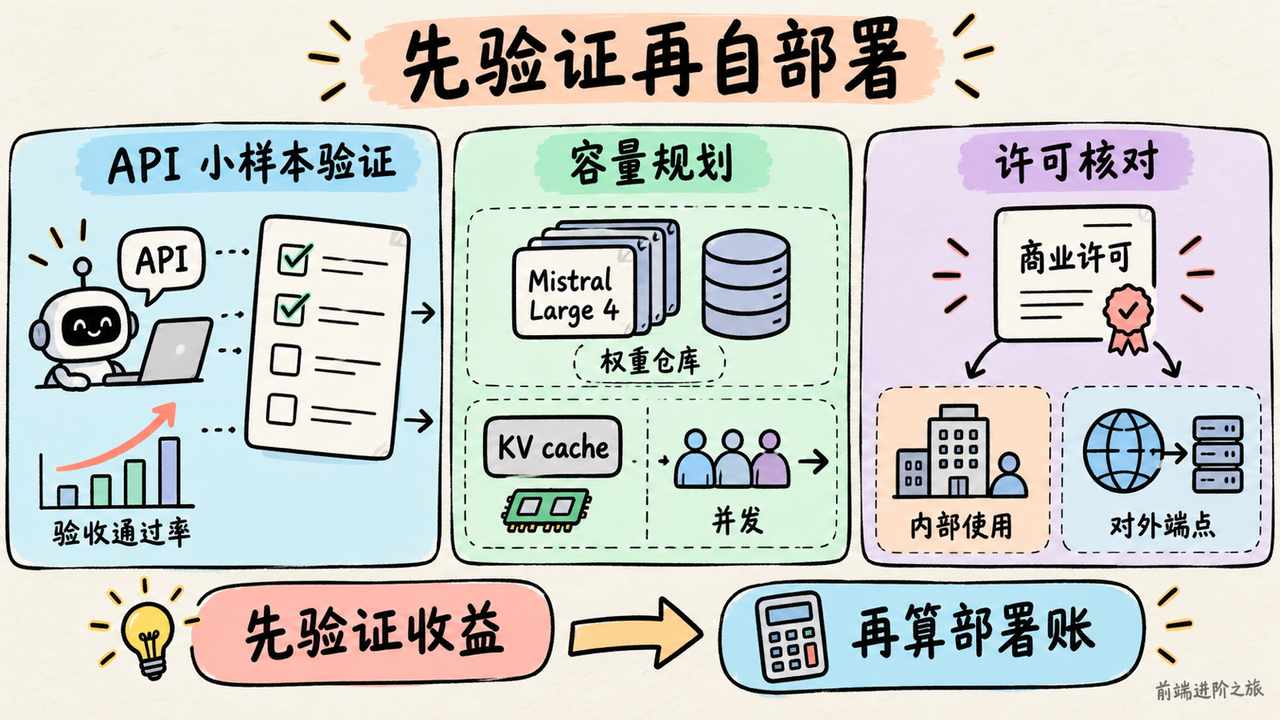
几篇关于 Mistral Large 4 的报道里,最容易被混在一起的是总参数和激活参数。按自托管分析文章的介绍,模型总参数约 1.05 万亿,每个 token 激活约 520 亿参数,采用混合专家架构。
计算时只调动部分专家,部署时仍要考虑整套权重。
这篇文章给出的 NVFP4 权重体积约 610 GB,并转述了四张 NVIDIA B200 或 B300 的部署配置。长上下文还要留出 KV cache 空间,不能把「权重装得下」当成「业务并发扛得住」。百万 token 上下文听起来很诱人,但文中没有并发、吞吐和延迟测试,容量规划还没法直接照抄。
这里还有个信息差。同一天的另一篇资讯汇总称,主检查点页面仍显示预计 10 月 31 日发布,NVFP4 检查点则已经可用。因此,读到「权重已开放」时,我会继续问一句,具体是哪个检查点,今天能不能下载,部署示例对应哪个版本。
许可比下载按钮更影响产品设计。
许可解读文章引用的条款区分了内部使用、嵌入特定功能的终端产品,以及向第三方提供模型访问能力的 Model-as-a-Service。后者需要另签商业许可,关联公司的业务也可能影响适用情况。
所以,一个固定用途的摘要功能,和允许客户自由提交提示词、调整参数的通用推理端点,不能只因为都套着业务页面,就按同一种授权方式处理。
性能这块也别只盯成功率。推理档位报道转述的厂商成绩里,Large 4 在 Artificial Analysis Coding Agent Index 上得分 48%,与 GLM-5.3 大致相当,每项任务平均少用 47% token。但这是特定测试中的比较,不能直接推成你们项目的费用打五折,更不能推成耗时减半。
我更关心每个验收通过的任务花了多少钱。
真要判断换不换,我会拿仓库最近 20 个真实任务,固定工具、权限和验收条件,对比现有模型与 Large 4。先走 API,把通过率、重试次数、总 token 和人工接手时间记下来;确认收益之后,再算机器、运维与授权的账。
二、AI 编程工具有恢复和确认按钮,为什么还会出事?
说实话,今天比模型跑分更该优先看的,是执行权限。
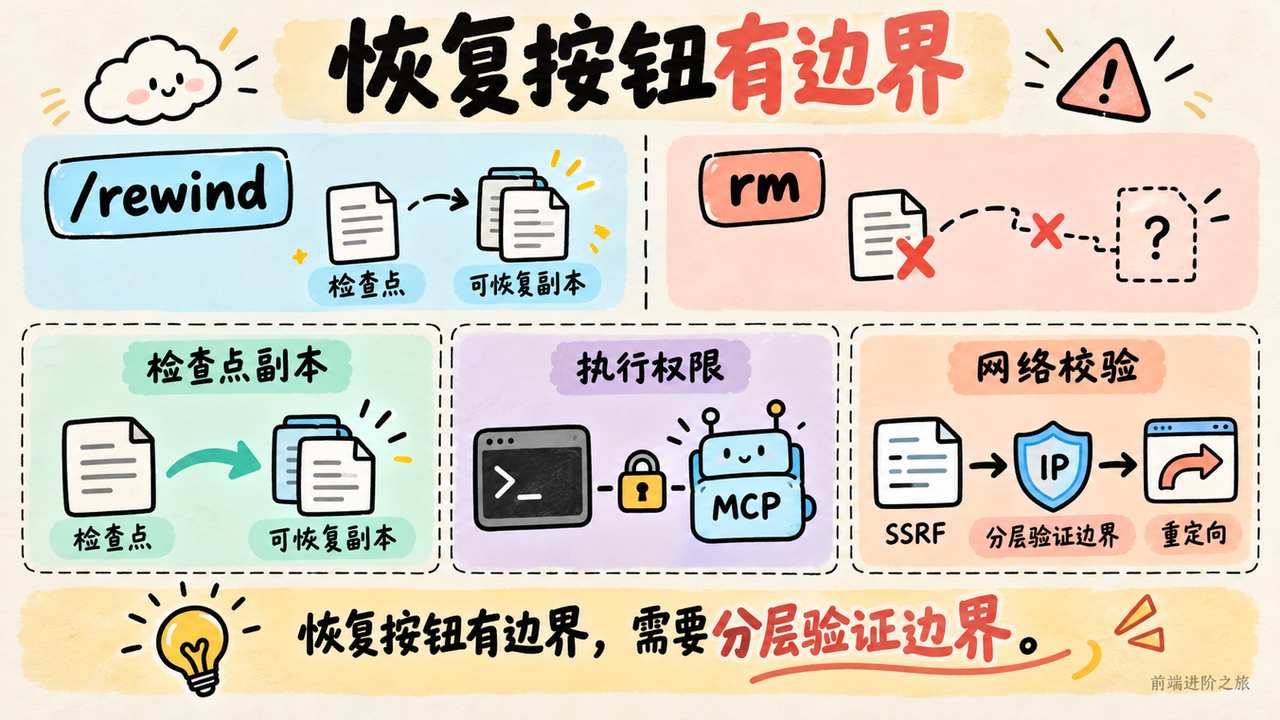
Claude Code 文件恢复实测把一个常见误会讲清楚了。/rewind 依赖特定编辑工具留下的检查点,它不是整个磁盘的撤销记录。一个从未被相关编辑工具修改、只被 shell 删除的文件,可能根本没有对应副本。
作者还用 18 条命令测试了防护钩子。问题不只在于能不能识别 rm,删除操作也可能藏在脚本内部。外层看起来只是运行测试,里面却能执行别的动作。
回到这块,命令文本检查、进程权限和可恢复副本,得分别考虑。提示词里写一句「不要删除重要文件」,补不上这三层。
同样的问题也出现在 MCP 工具上。protocolprobe-selftest 的实践没有只读工具描述,而是启动服务、实际调用工具,观察运行行为。作者测试五个参考服务器时发现,提供数据修改能力的工具通常直接完成调用,没有服务端确认步骤。
这个样本不能代表全部 MCP server,而且客户端负责确认也可能符合产品设计。但团队必须知道,一旦换成不弹确认的客户端,服务器是否还有自己的限制。
客户端替你问过一次,不代表服务器已经守住边界。
Agent 抓取工具的 SSRF 分析则把问题推进到了网络层。只过滤 localhost 字符串不够,域名可能解析到私网,重定向可能跳进内网,DNS 检查和实际连接也可能得到不同结果。作者强调校验连接实际使用的 IP,并对每次重定向重新检查。
这些能力一旦出错,影响的不只是生成质量,还可能是文件和凭据。当天能做的验证不必复杂。我会用临时目录里的假文件测试删除恢复,再对自己有权测试的 MCP 服务检查修改操作;抓取工具则单独测回环地址、私网解析和重定向,记录请求有没有真正发出去。
三、多个 Agent 并行写代码,多塞上下文能减少冲突吗?
我的读法是,上下文仍然有用,但它管不了所有协作问题。
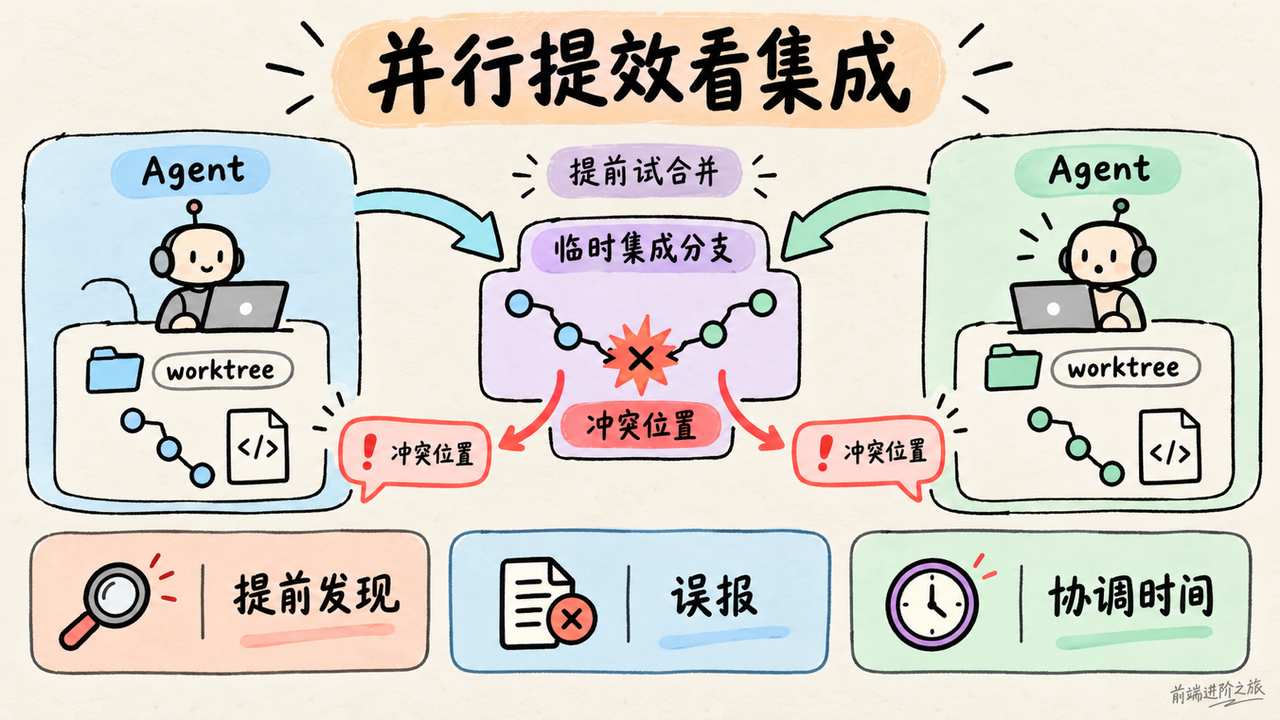
KandiForge 的并行开发实践里,作者尝试过简报、文件摘要、纠错规则等方式,行为改善并不明显。后来换了一个做法,后台持续尝试合并开放分支,发现文件或函数冲突后,在 Agent 下一次操作前发提醒。
这类提醒很像同事在工位上说一句,你俩都在改这个文件,先对一下。
它具体,也及时。
上线第一周,系统记录到 79 个合并前发现的问题。这个数不能读成避免了 79 次事故,因为此前没有同样的监测机制,也没有足够的对照。但它至少说明,冲突开始有地方被提前看见了。
作者进一步提出,每个 Agent 回合结束后自动创建本地检查点,让后台合并能看到尚未正式提交的工作。不过,这部分仍在设计阶段,「一分钟内可见」是目标,不能当成实测效果。
顺着上面聊,这和TypeScript Agent 执行框架文章讲的是同一个工程位置。模型提出工具调用,外部运行层接住请求、检查权限、执行,再把结果送回去。冲突通知、失败记录、运行上限,也可以在这一层安排。
与其把「你要注意别人的改动」反复写进提示词,我更愿意让运行环境告诉它,现在谁正在改哪里。
当然,共享信息也会产生噪声。所有失败都广播,Agent 可能收到一堆与当前任务无关的报错;只按文件名判断重叠,又会把同文件里的独立修改混在一起。提醒需要足够具体,最好能说明冲突位置和相关任务。
对技术管理者来说,并行提效要扣掉集成返工。两个 Agent 各自写得快,最后由一个人花半天解冲突,收益就没那么好看了。
当天可以先挑两个会碰到同一模块的小任务,分别放进独立 worktree,在临时集成分支尝试合并。把提前发现的问题、误报和人工协调时间记下来,再决定是否值得建设自动提醒,别一上来就做完整平台。
四、AI 返回的 JSON 能解析、React 能运行,就可以合并吗?
大概率你也遇到过,演示没问题,一换用户、一切路由,结果就开始不对。
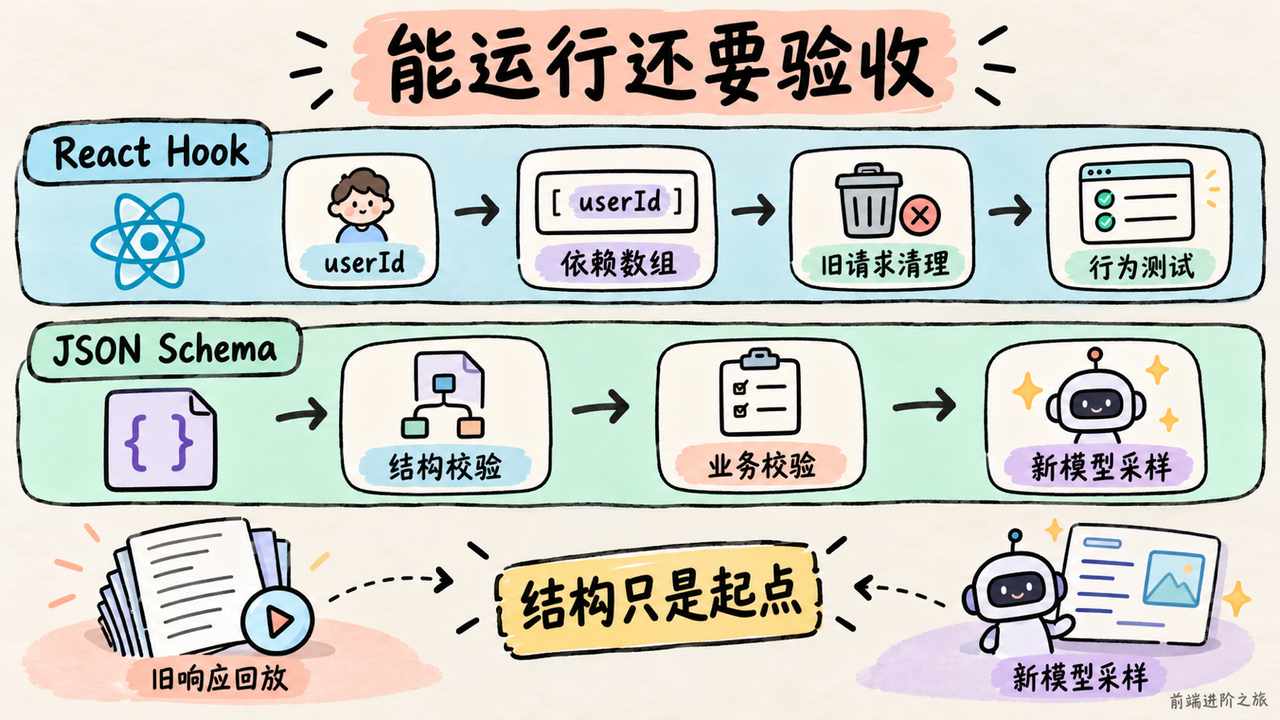
AI 生成 React Hook 的审查文章提到的典型问题,是 effect 读取了 userId,依赖数组却写成 []。代码可以通过类型检查,第一次请求也可能成功,但组件继续复用时,不会因为用户变化重新获取数据。
另一个方向是依赖过宽。业务只关心 item.id,却依赖父组件每次重建的整个 item 对象,可能让上报反复触发。
这类错误靠多看几眼「React 写法」不够,要先说清楚什么变化应该触发什么行为。
下面这个 JavaScript 示例,把切换用户后的请求与清理放在一起,解决旧请求继续影响当前组件的问题。
useEffect(() => {
  const controller = new AbortController();

  async function loadUser() {
    try {
      const response = await fetch(
        `/api/users/${encodeURIComponent(userId)}`,
        { signal: controller.signal }
      );
      if (!response.ok) throw new Error(`HTTP ${response.status}`);
      const user = await response.json();
      if (!controller.signal.aborted) setUser(user);
    } catch (error) {
      if (!controller.signal.aborted) setError(error);
    }
  }

  setError(null);
  loadUser();
  return () => controller.abort(); // 切换用户或卸载时清理旧请求
}, [userId]); // 触发条件跟实际读取的数据保持一致
最容易翻车的是依赖数组这一行。以后 effect 读取了新的动态值,就要重新核对依赖;加载状态、旧数据是否保留,也得按页面需求补齐。
结构化输出也是类似的问题。llm-contract 的实践用固定 JSON Schema 校验响应,失败后反馈具体错误,允许重试一次,再失败就交给人工。它还把录制响应放进 pytest 离线回放。
这个思路我认可,但要分清测试对象。旧响应回放通过,可以检查解析与下游逻辑;改了模型或提示词之后,仍然只回放旧响应,证明不了新的生成质量。
AI 短视频流水线提供了另一个例子。模型只填写受约束的场景 JSON,布局、图标和时间都在允许范围内,再由 Remotion 渲染。生成与执行分开后,错误就更容易定位。
结构正确,只是进入下一步的条件。
你要是也在做 AI 编程,今天就挑一个生成的 Hook,连续切换参数、制造慢请求、卸载组件,看结果是否仍然正确;做结构化输出的同学则补几条字段合法但业务含义错误的样本,再对新提示词真实采样一次。
五、给 Claude Code 接上 RAG,为什么还是可能答错?
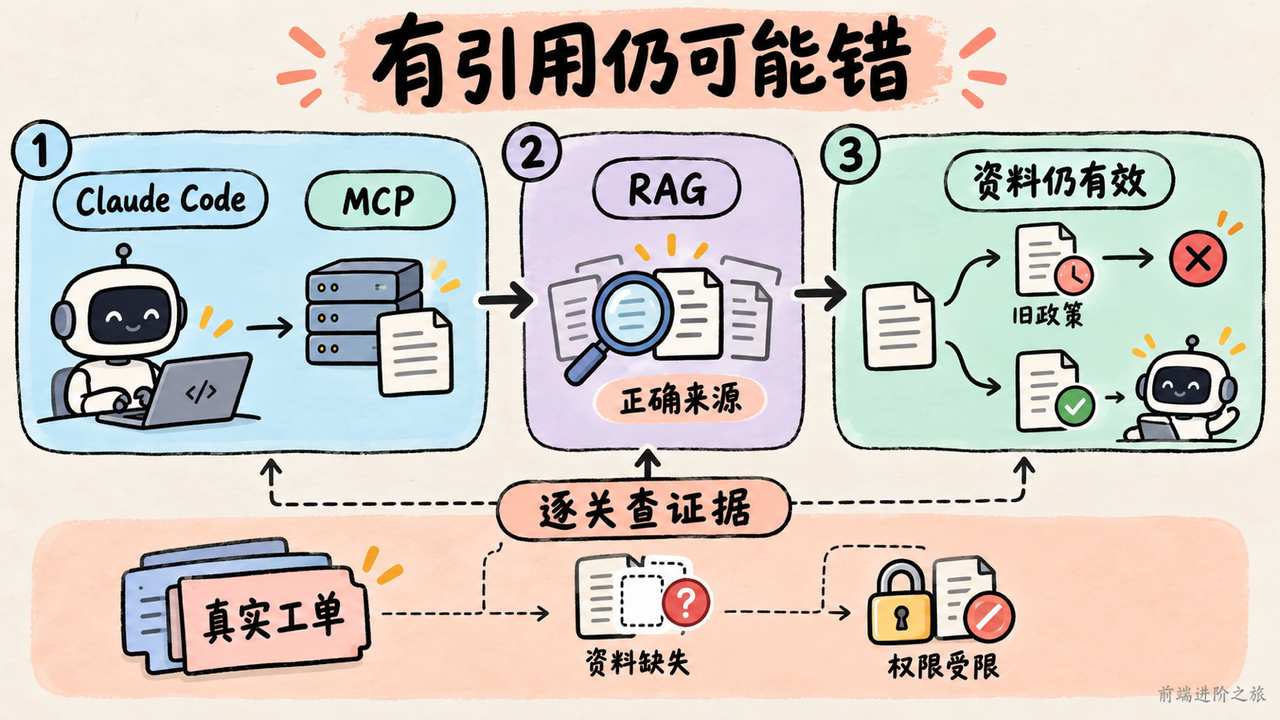
工具接通和工具用对,中间还隔着一段路。
把文档检索接入 Claude Code 的实践复用了已有检索函数,只暴露搜索文档与列出文档两个工具,服务端不再调用生成模型,由客户端组织答案。
这很适合已有内部知识库的团队。检索服务提供片段和来源,编码助手按需取资料,不必把长文档全部塞进上下文。
但作者的一次实际提问也暴露了问题,工具在那儿,模型未必知道什么时候该调用。
更麻烦的是,调用了也不一定找对。RAG 上线评测文章建议从真实工单、聊天记录和销售问答中整理 50 至 200 道起步题,覆盖可回答、资料缺失、信息过期和权限受限等情况。
这个范围是起步建议,没有实验说明 50 题或者 200 题适合所有业务。我更看重题目的来源,真实用户会怎么问,比测试集看起来多整齐更重要。
这里有个坑,回答忠于检索结果,不等于回答符合当前业务。检索出来的是旧政策,模型准确复述了旧政策,仍然会给用户错误结论。
一条简单的 JavaScript 评测记录,就可以把这些要求固定下来,避免验收只剩一句「回答挺像那么回事」。
const evalCase = {
  id: "policy-current-vs-archived",
  question: "退款现在按哪份规则处理?",
  expectedSourceIds: ["refund-policy-current"],
  forbiddenSourceIds: ["refund-policy-archived"],
  mustAbstain: false,
  severity: "critical",
  checks: {
    sourceRetrieved: false, // 没找对资料,先查检索链路
    answerSupported: false,
    sourceStillValid: false, // 有引用,也要确认资料仍有效
  },
};
最容易被省掉的是 sourceStillValid。只检查引用存在,挡不住旧文档被正确引用。
少样本意图分类实测也提醒了同一件事。在 1,001 条标准英语消息上,每类五条样本的逻辑回归分类器达到 84.2%,与 Jev 的 83.3% 接近;换成混合语言表达后,增加英语样本并没有补平差距。
所以,别拿干净的内部演示问题代替真实输入。当天可以先从最近工单抽 20 道题,混入旧政策、错别字和资料缺失问题,分别看有没有调用检索、正确来源有没有进入前列、回答有没有超出证据。
六、降低 LLM API 账单,先换便宜模型还是先查调用链?
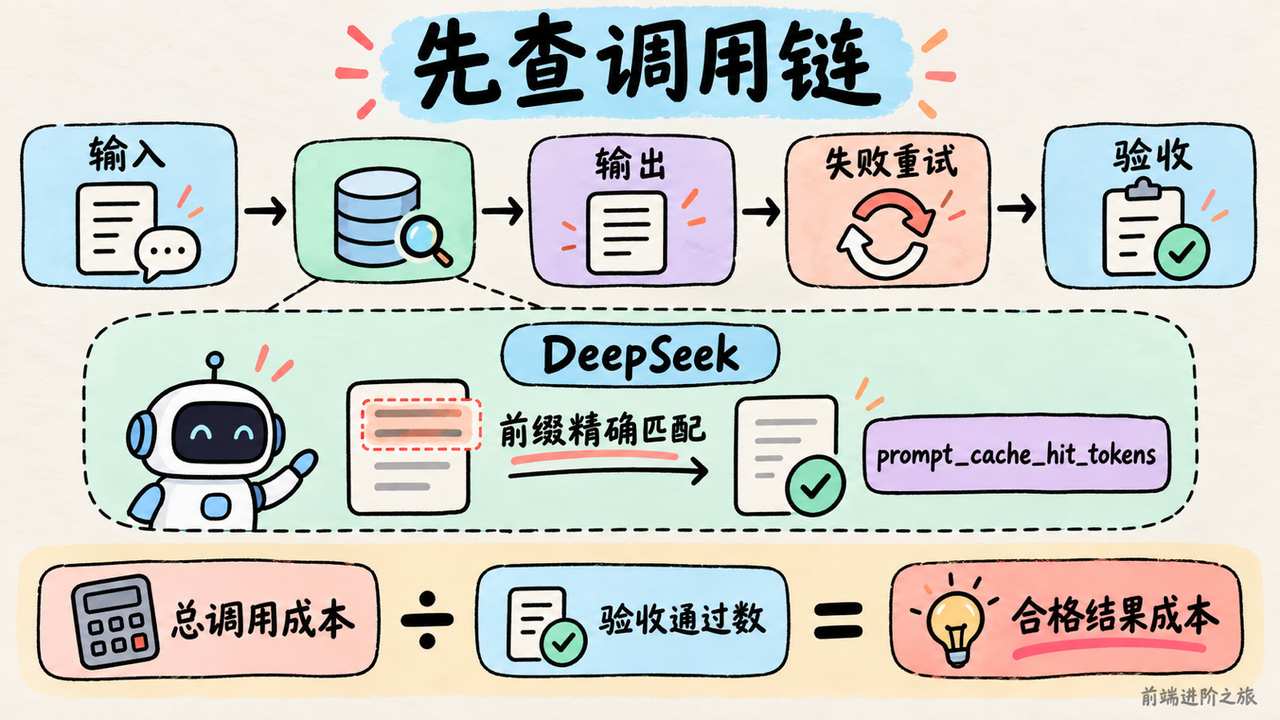
要我选,我会先查调用链。
LLM API 降本文章提醒的几个开销来源,都比模型单价更容易被忽略。Agent 重复循环,脚本反复发送整份文件,长对话不断累积上下文,还有本来一句话能完成的任务,生成了大段解释。
模型路由当然可能省钱,但它有自己的成本。换模型可能影响缓存,低价模型失败后反复重试,也可能把省下的钱花回去。文中推荐的自动路由没有给出完整质量与成本对照,我会先比较一个强模型和一个便宜模型,弄清任务分布,再考虑复杂路由。
DeepSeek 缓存分析则提醒,自动开启缓存,不代表请求一定命中。按作者的解释,命中依赖输入前缀与已持久化缓存单元的精确匹配,相似文本、相同文档都不能直接当成命中保证。
它提到的最高 50 倍价差,来自 2026 年 9 月 19 日特定模型、非高峰时段的输入价格快照。那是命中与未命中的输入单价之比,输出费用不跟着打同样的折扣,更不能直接当成 10 月 30 日的实时报价。
回到实际账单,我更愿意看响应里的 prompt_cache_hit_tokens,而不是看提示词里有多少重复文字。固定资料放前面、变化问题放后面可以作为尝试,但效果得靠用量字段确认。
省钱也得带着质量看。
今天的 Carbon 报道就提供了一个反例。Gemini 4 Carbon 的安全任务介绍转述了漏洞发现、利用和修复三项成绩,分别为 88.2%、54.8% 和 71%。它们来自不同测试,不能相乘或拼成端到端修复成功率。另一篇接入报道还称,模型只向指定防御机构和合作伙伴开放,普通团队目前也未必能接入比较。
我的取舍是,别为暂时用不到的榜单成绩打乱现有工作流。对 AI 办公提效里的短摘要、分类和格式整理,可以试低价方案;对代码修复,则把测试通过和人工审查时间算进去。
当天就选调用量最高的一类任务,拆开输入、输出、缓存命中、失败重试和验收通过数。用同一批输入比较两个方案,算每个合格结果的成本,这笔账比宣传里的单 token 价格更接近团队真正支付的费用。
总结
今天能从这些报道里读到的具体变化,是 Mistral Large 4 开始提供开放权重的部署选项,Agent 工具的执行与恢复边界被拿出来实测,结构化输出、检索评测和并行冲突检测也有了更细的工程方案。主检查点可用时间、Carbon 公布日期等细节在不同文章里仍有出入,不能直接写进上线排期。
我的判断很简单,程序员接下来更该补的是验收和运行环境。模型继续比较,但权限要能限制,过程要能追查,结果要能复测。
至于换模型能省多少钱、并行 Agent 能快多少、安全模型能独立修好多少漏洞,现在这些文章还不足以给所有团队一个通用答案。拿自己的任务跑一轮,答案通常比再读十张榜单更有用。
参考
- Mistral Large 4 开放权重,自托管门槛高|dev.to
- Mistral 万亿参数模型开放权重|dev.to
- Mistral Large 4 开放权重,托管需另授权|dev.to
- Mistral Large 4 开放权重与推理档位|dev.to
- Claude Code 误删文件的恢复与防护实测|dev.to
- 在 CI 中实测 MCP 服务行为并输出发现|dev.to
- 给 Agent 抓取工具补上 SSRF 防线|dev.to
- 多 Agent 协作,用预合并提前发现冲突|dev.to
- 用 TypeScript 循环拆解 Agent 执行框架|dev.to
- 合并 AI 生成的 React Hook 前检查什么|dev.to
- 让结构化 LLM 输出进入可回放测试|dev.to
- AI 短视频流水线如何拆分生成与渲染|dev.to
- 把文档检索接入 Claude Code 的 MCP 实践|dev.to
- 用真实问题集检验 RAG 上线质量|dev.to
- 少样本分类何时够用,混合语言实测|dev.to
- 降低 LLM 账单,先定位开销再分流|dev.to
- DeepSeek 缓存省钱的关键是精确匹配|dev.to
- Gemini 4 Carbon 聚焦漏洞发现与修复|dev.to
- 谷歌发布 Carbon,优先面向网络防御|dev.to
- 前端进阶之旅