
3GB 内存跑 35B-A3B 模型,手机端解码超过 13 token/s,这是面壁智能给 MiniCPM-V 4.7 报出的成绩。另一边,Meta 新模型的 Agent 能力往上走,调用成本也跟着涨。读完 2026 年 10 月 13 日这批 AI 热点,我更关心一个问题,模型变强之后,业务到底能不能少返工、少花钱?今天顺着模型选型、端侧部署、长期记忆、任务执行、质量评估和权限这六条线聊,帮你挑出值得试的东西,也避开几个容易花冤枉钱的坑。
一、AI 编程模型成绩更高,为什么还不能直接换
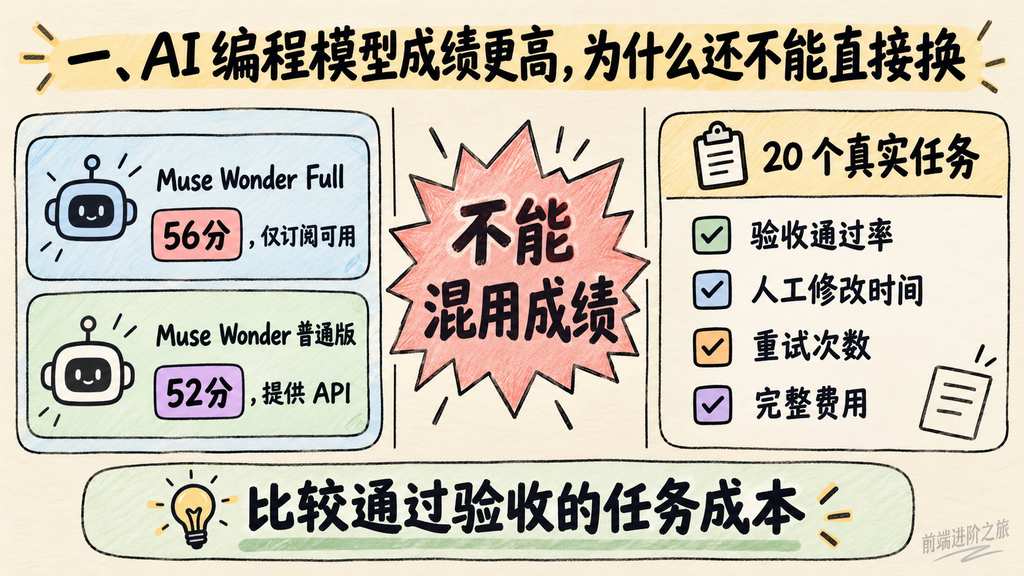
先说结论,Meta 的 Muse Wonder 值得进入候选名单,但现在就把团队的代码模型全部切过去,我会再等等。
这次发布的两个版本是 Muse Wonder 和 Muse Wonder Full。按 TechCrunch 的报道,Wonder 面向比 Muse Spark 更复杂的任务,普通版 API 定价为每百万输入 token 4 美元、输出 token 20 美元。Full 则只向 Muse Code 订阅用户开放,不通过 API 提供。
这个区别很实际。你想把模型接进自己的代码审查、工单处理或者后台 Agent,普通版和 Full 就不是同一种选项。别拿 Full 的成绩给普通版集成方案算收益。
The Decoder 给出了更具体的数字。Muse Wonder Full 在 Artificial Analysis Intelligence Index v4.3 上拿到 56 分,普通版为 52 分,前代 Muse Spark 1.3 为 48 分。报道中的 Terminal-Bench 4.0 成绩从 33% 提升到 57%,Full 在十项基准中有六项进入前三。
挺亮眼。
但同一篇报道也说,两款模型每次 API 调用的成本接近前代的三倍。这里讲的是调用成本,不能直接当成你们修复一个业务问题的成本。一次调用更贵,如果重试少了、人工改动少了,最终可能划算;如果它只是生成得更长,账单就会先到。
所以我会把选型指标改成「一个通过验收的任务要花多少钱」。
AWS 关于 Grok 4.7 推理强度的实践 正好提供了另一种读法。作者用三项有唯一正确答案、经过穷举验证的任务,测试四档推理强度,每项每档运行六次,共 72 次。最终 67 次正确,xhigh 档 18 次全部正确,low 档为 15 次正确,后者输出 token 用量约为前者的八分之一。
八分之一很诱人,但它只比较输出 token,也只覆盖这三类任务。别直接扩写成整个 Agent 系统便宜八倍,更不能保证你仓库里的复杂重构也有同样结果。
回到这块,日常 AI 编程任务其实没必要全用最高档。补一段字段映射和排查跨服务故障,难度不同,失败后的代价也不同。我的取舍是把复杂任务交给强模型,把规则明确、验收便宜的任务留给低成本方案。
真要判断换不换,我会拿仓库里最近 20 个真实任务,固定上下文、工具权限和验收条件,分别记录通过率、人工修改时间、重试次数和完整用量。Full 的订阅体验与普通版 API 也分开测,别混成一张成绩单。
二、手机能跑大模型,前端应用能直接搬过去吗
MiniCPM-V 4.7 是今天最容易让人想动手的一条。
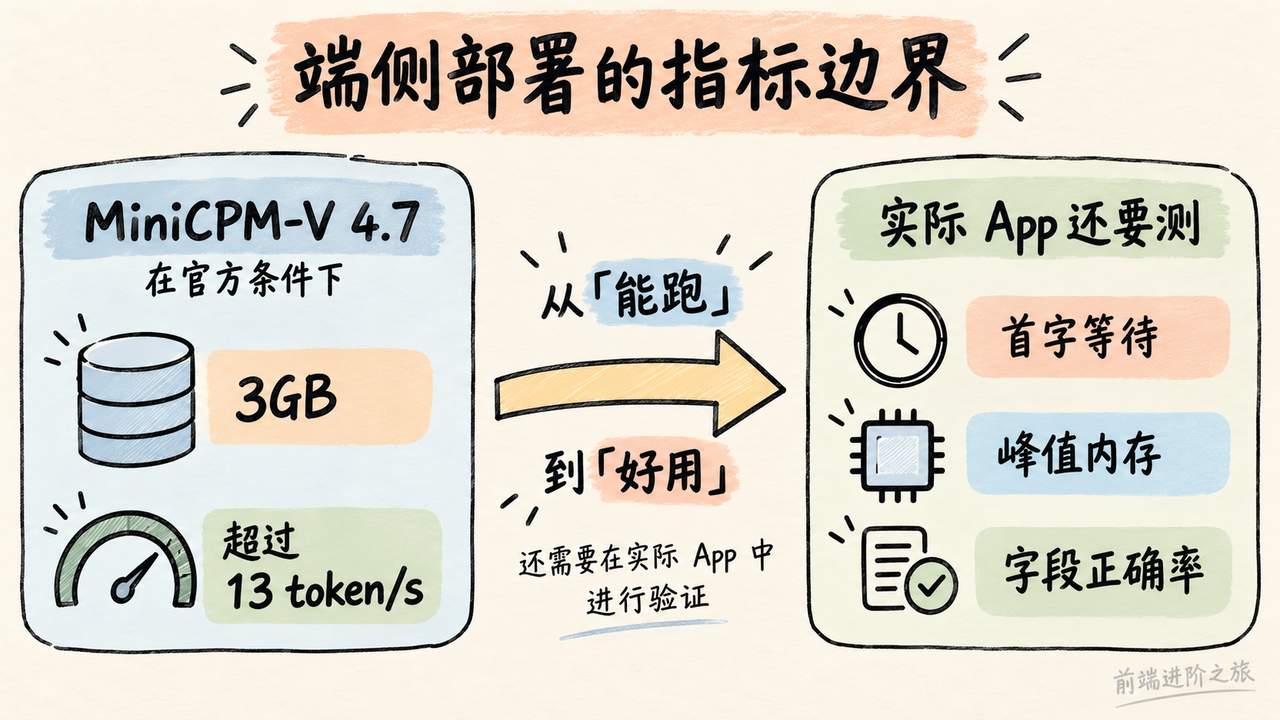
据 IT之家报道,面壁智能推出了 35B-A3B MoE 和 1B 两种规格。官方称,35B-A3B 借助 LES 前瞻专家调度,在 iPhone 17 Pro Max 上以 3GB 内存达到超过 13 token/s 的解码速度,并适配 iOS、安卓、鸿蒙及多种芯片平台。同时开源的 SRFT 微调方案,主打低成本扩展能力和减少遗忘。
我的读法是,端侧多模态应用多了一个值得认真测的候选。
不过,3GB 是官方报告条件下的数字,不是你整个 App 的内存预算。图片处理、页面渲染、历史消息和模型运行凑到一起,应用占用还得自己量。13 token/s 说的是解码速度,也不能替代首字出现前的等待时间。
手机能跑起来,离产品好用还有一段路。
对前端来说,我更愿意先考虑范围窄的功能,比如根据一张截图提取几个固定字段,或者在设备上完成简单分类。输入、输出和验收都容易限定,比较适合判断端侧方案值不值得继续投入。直接做一个什么都能问的助手,很快就会把问题扩大到上下文、耗电和失败回退。
同一天看到的 微软 BitNet 项目,走的是低比特本地推理路线。bitnet.cpp 面向 1-bit 大语言模型,项目提供构建与环境配置说明,也介绍了采用 BitNet I2_S 量化的 CPU 多语言语音识别引擎 VibeASR.cpp。
这两条可以放在一起看,但不能互相代替。MiniCPM-V 提供模型与端侧调度方案,BitNet 提供低比特模型的推理实现。你手上的业务任务能不能适配,仍然取决于模型能力、运行环境和构建依赖。
服务器端也有类似的取舍。SparseEngine 的介绍 报告,同批量条件下,Quest 和 OmniKV 的吞吐提升约为 1.5 至 2.6 倍;约十倍的结果则来自各组合能跑的最大批量,批量并不相同。它还记录到,有些加速更明显的方法,准确率损失也更大。
这里有个坑,把端侧调度、低比特推理和稀疏注意力都叫作「模型压缩提速」,会丢掉最重要的区别。它们省的资源不同,对结果的影响也不同,最后都得回到自己的输入上测。
如果目标是团队统一入口,Open WebUI 可以作为另一种起点。它支持自托管、离线运行,兼容 Ollama 和 OpenAI 格式接口,也提供角色、用户组和权限管理。先把候选模型放到同一个入口里比较,通常比立刻为每个模型写一套产品界面更容易看清差异。
你要是也在做本地多模态功能,我会先挑十张真实截图,测字段正确率、首字等待、完整输出时间和应用峰值内存。今天能跑完这轮,就足够决定下一步是继续端侧试验,还是保留服务端处理。
三、Agent 有长期记忆,怎么避免把两个项目记串
Meta 这次很强调 Active Memory 和 Active Focus。
IT之家 报道,新模型加入这两项能力,目标之一是减少 Agent 偏离任务。The Verge 则明确了入口,Wonder 可通过 Meta Model API 使用,两款模型向 Muse Code 订阅用户开放,接入 Muse Agent 的具体时间尚未公布。
对天天切仓库的程序员来说,长期记忆确实有吸引力。项目用什么包管理器、哪些目录不能改、某个兼容逻辑为什么保留,如果每次都要重新解释,很烦。
但记住得多,还得记对地方。
前一个项目约定使用某个导出标签,后一个项目恰好要求另一个标签。模型把它们混起来,回答可能特别自然,代码也可能通过语法检查,业务约定却已经错了。长上下文和长期记忆都不能替你回答「这条信息属于哪个项目」。
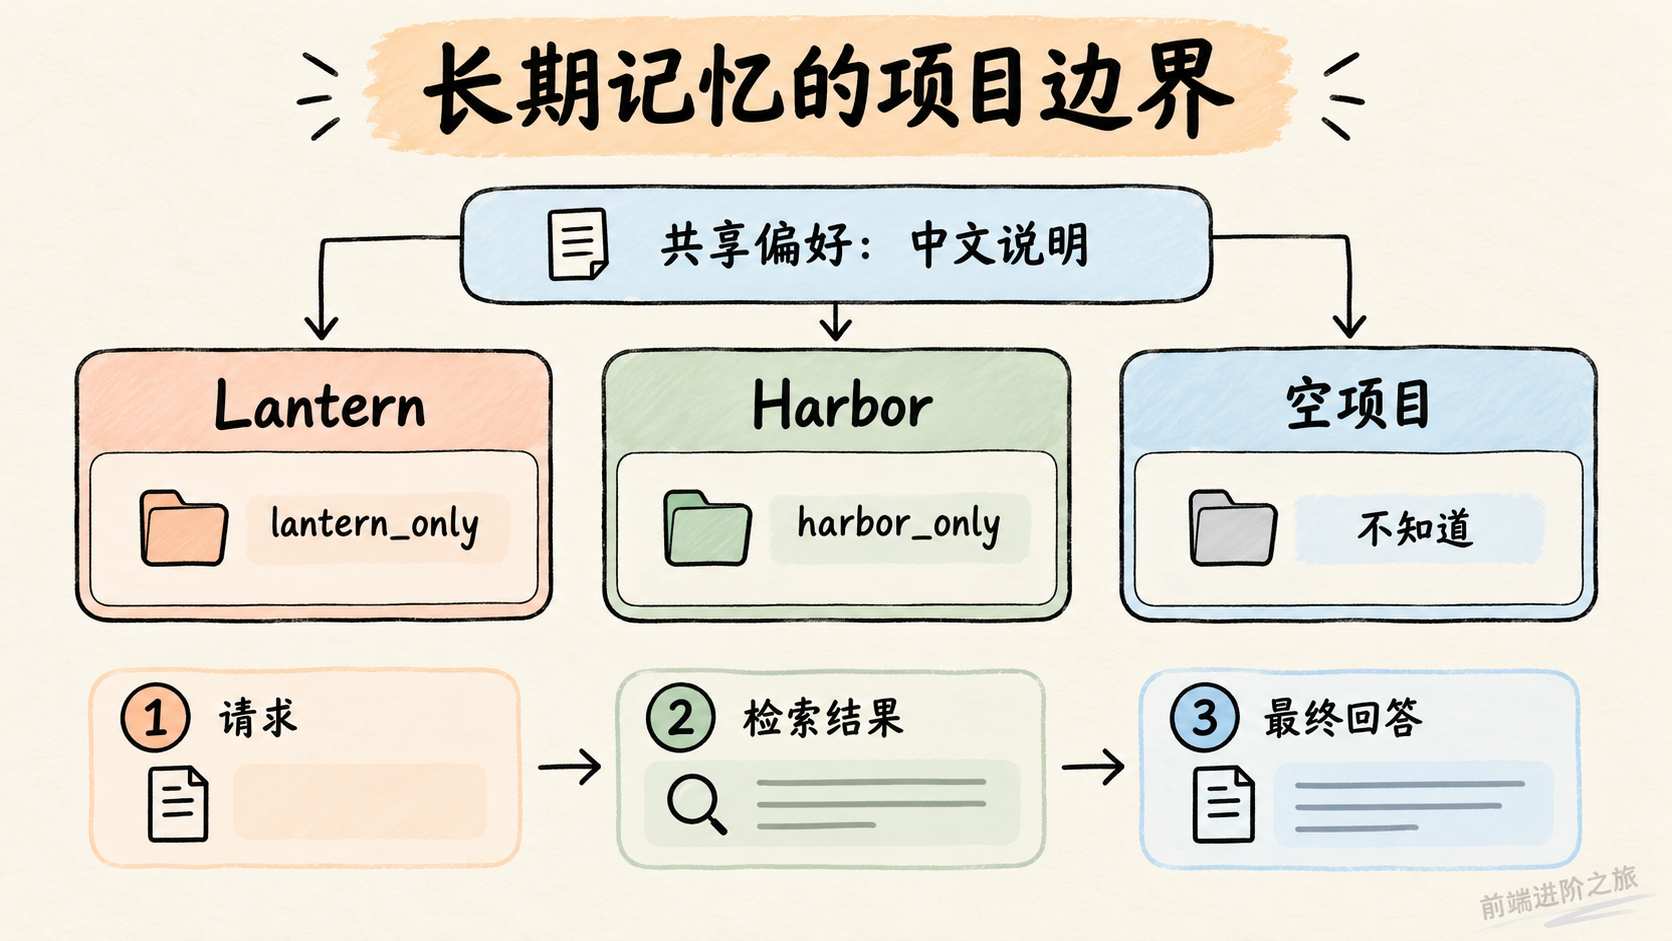
双项目记忆测试指南 给出的办法很朴素。创建两个虚构项目,放入互相冲突的项目约定,再加入一条明确共享的偏好。标准答案独立保存,结束设置对话后,在新会话中用相同的中性问题测试。
我喜欢它把检查拆到了请求、检索结果和最终回答三处。另一个项目的记录已经被检索出来,只是模型碰巧没用,不能算项目范围完全正确。正确记录返回了却没被采用,又是另一类故障。
下面这份 JavaScript 配置可以用来准备测试夹具,先把项目专属事实和共享偏好写清楚。
const memoryFixture = {
  shared: {
    explanationLanguage: '中文',
  },
  projects: {
    Lantern: {
      exportTag: 'lantern_only',
    },
    Harbor: {
      exportTag: 'harbor_only',
    },
  },
  cases: [
    {
      project: 'Lantern',
      expected: 'lantern_only',
      forbidden: ['harbor_only'],
    },
    {
      project: 'Harbor',
      expected: 'harbor_only',
      forbidden: ['lantern_only'],
    },
    {
      project: 'Empty',
      expected: null, // 没有记录时,应承认不知道
      forbidden: ['lantern_only', 'harbor_only'],
    },
  ],
};
最容易翻车的是 expected: null 这一项,空项目里听起来合理的猜测也应该判失败。
顺着上面聊,我对「以后不用再解释项目背景」会持保留意见。记忆功能能帮忙,但项目选择、存储范围、删除与纠正入口还得由产品和运行时处理。仅仅建立 MCP 连接,也不能证明这些策略已经生效。
今天可以做的测试很小,两个虚构项目加一个空项目就够。用实际记忆接口写入,保存记录标识符,再开新会话查看检索返回了什么;这能检查串扰,但不能当成安全隔离证明。
四、模型说任务完成了,怎么确认代码和消息真的到位
大概率你也遇到过,Agent 写了一段像模像样的总结,读起来全部完成,往下一查,还有测试没跑。
F avur 的状态驱动实践 讨论的就是这类问题。其一次公开运行中,运行程序根据任务状态生成了 607 条用户角色消息;重复操作计数达到十五时,会发出停止重复读取、继续推进的提醒。那次运行里,收到提醒的 21 个 Agent 都离开了卡住的步骤。
这个案例值得借鉴,但「继续推进」不能直接算「正确完成」。它展示的是运行程序能接管一部分进度催促,没证明自动提醒已经解决所有循环和质量问题。
我更关心状态从哪来。
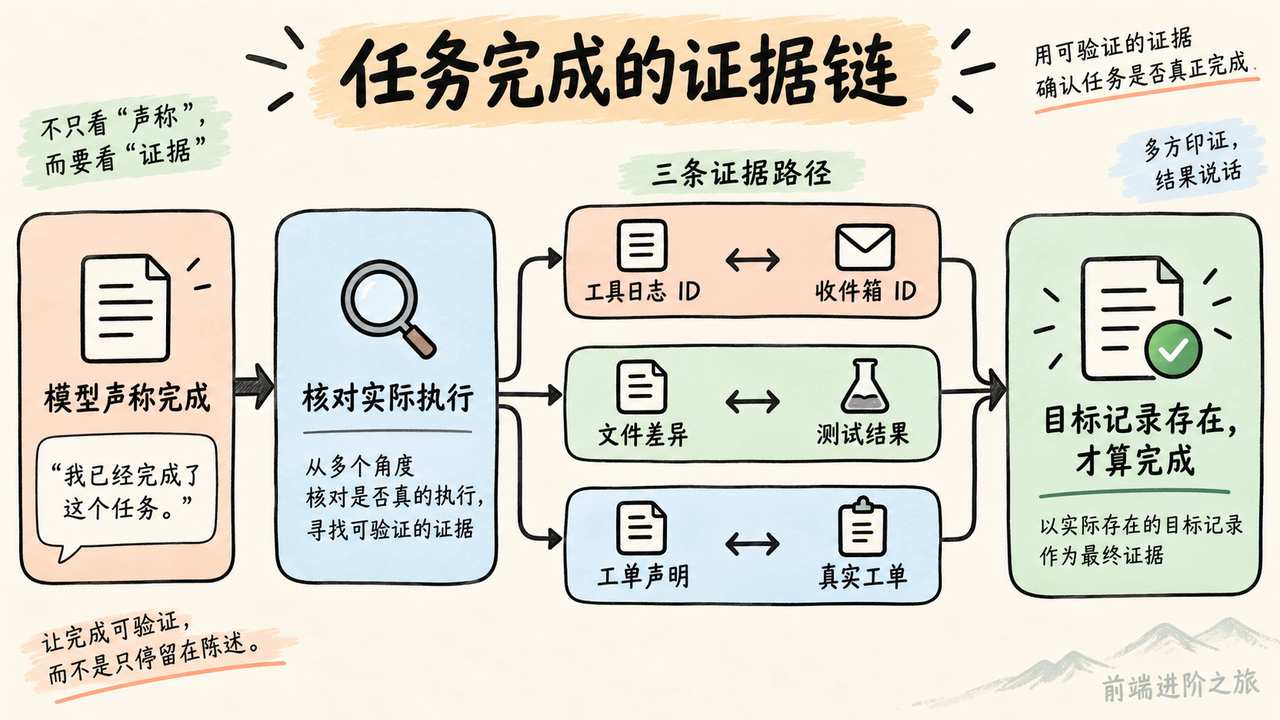
任务列表、测试结果和工具记录如果本来就在程序手里,就没必要等用户反复输入「继续」「跑测试」。但状态必须来自实际执行结果,不能把模型总结复制进数据库,再拿它当完成凭据。
一篇跨 Agent 消息排查记录 很有提醒作用。作者要求 Qwen Code 使用 MCP 消息工具,实际却调用了名称相近的内置工具。界面显示发送成功,目标 Agent 的 JSONL 收件箱没有对应记录。
后来他们用收件箱记录、随机标记和工具日志做检查,还要求日志 ID 与收件箱 ID 匹配。记录中的九次 CLI 测量通过了检查,但这些结果覆盖的是指定版本和运行条件,不能替其他环境担保。
这种检查思路很适合迁移到业务 Agent。
声称创建了 Jira 工单,就检查真实工单;声称写入了文件,就检查文件和差异;声称修复了问题,就跑对应验收。模型的描述可以帮你理解过程,系统状态得另外取。
ShipStation Global 的 Deckhand 案例 则展示了一个比较具体的业务闭环。它在 Slack 中回答知识库问题、识别报错截图,并创建或更新 Jira Service Management 工单。团队报告前三个月解决了频道中 97.5% 的提问,员工正面反馈为 96%。
这个数字要带着分母读,它针对该公司的频道咨询和反馈,不是任意企业 IT 故障的自动修复率。真正值得借鉴的是,回答不了时还能把已有上下文带进工单,用户不用重新描述一遍。
回到 AI 办公提效这块,减少一次重复输入,往往比多生成一段回复更有价值。今天我会挑一条现有工作流,故意让工具返回成功但不产生目标记录,看看系统会不会照样宣告完成;这轮故障注入能直接暴露你究竟在信模型,还是在检查结果。
五、模型误报更少,为什么业务效果反而变差
说实话,这批素材里最值得技术负责人读的,可能是那篇微调失败记录。
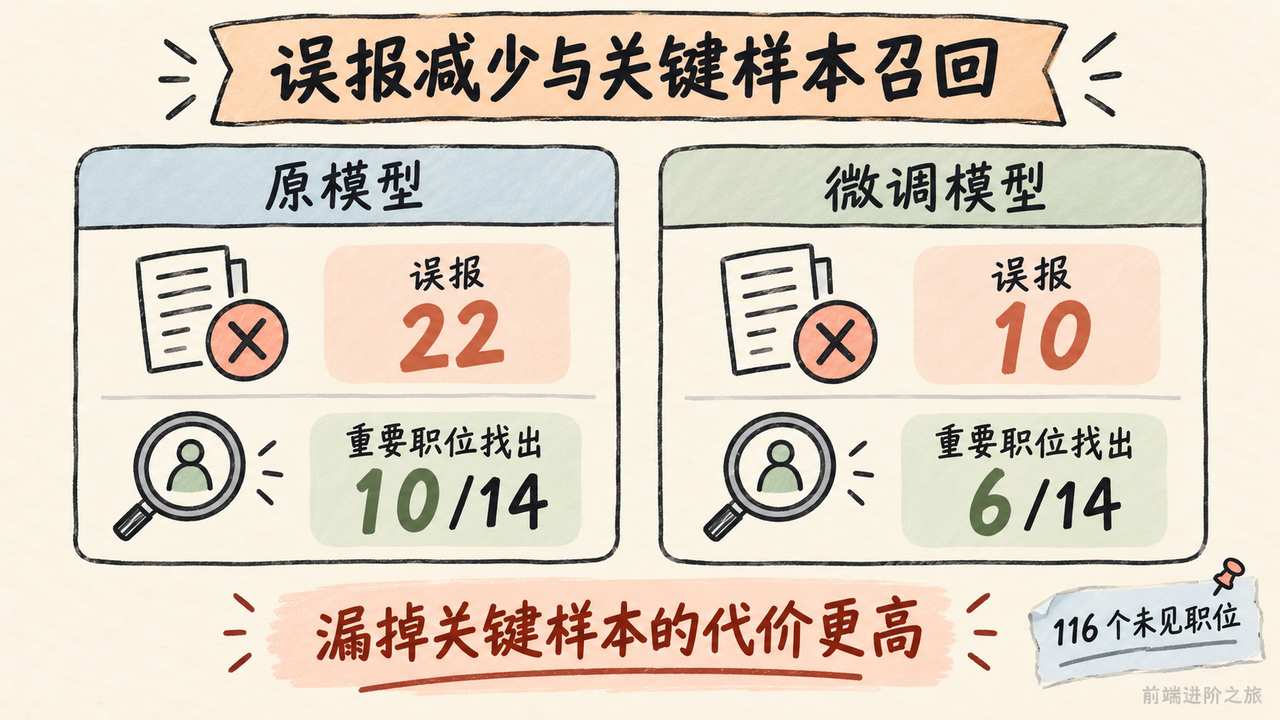
作者在 116 个未见职位上测试微调模型,排序相关性为 0.707,对照模型为 0.705,基本持平;误报从 22 个降到 10 个,看起来更省钱。可真正值得关注的 14 个职位,原模型找出 10 个,微调模型只找出 6 个。
作者还把输入提示从约 22,000 token 缩短到约 550 token。降幅很大,但最终三个训练版本都没通过预先写好的规则,生产继续使用原模型。
省下来的 token,补不回漏掉的关键样本。
这里不适合只盯着平均分。这个筛选器后面还有昂贵模型做完整评估,误报只是多花一次评估费用,漏报却让一个好职位彻底消失。两种错误的代价不一样,验收自然不能一视同仁。
前端接 AI 分类、审核和推荐功能时,也很容易遇到类似问题。页面上统一显示一个「准确率」,很省事,但业务真正介意的可能是某一类漏检。该单列的指标,不能藏进总平均。
另一篇 本地小模型提示测试 也提醒我,别一失败就换模型。作者测试八个 0.6B 至 14B 的本地模型,覆盖 50 道可自动校验的任务,比较简白、普通和华丽三种文风,并关闭 thinking。测试里,语言风格的影响较小,规定答案格式的那一行更关键。
这个结论有条件,它来自这批模型和任务。尤其小模型部分的文风差异区间触及零,不能据此宣布某种表达必胜。不过,用固定键提取 JSON 的场景,优先检查格式要求确实更直接。
拒收日志实践 则把失败归因为 prompt、fixture、model 和 data。作者三周记录 31 次拒收,其中 17 次标为 prompt,随后从措辞问题追到了回答范围偏移。
我不会把 17 次人工归因当作严格的因果证明,但它至少给修复工作一个入口。没有分类,团队很容易在「模型变笨了」和「再调一下温度」之间来回转。
下面这段 JavaScript 把整体表现和关键样本召回分开,避免误报下降把漏检问题盖过去。
function evaluate(rows) {
  const positives = rows.filter(row => row.important);
  const misses = positives.filter(row => !row.selected);
  const falsePositives = rows.filter(
    row => !row.important && row.selected
  );

  return {
    sampleCount: rows.length,
    importantCount: positives.length,
    falsePositiveCount: falsePositives.length,
    recall: positives.length
      ? (positives.length - misses.length) / positives.length
      : null, // 没有关键样本,就不能评价关键样本召回
    missedIds: misses.map(row => row.id),
  };
}

function canReplace(candidate, baseline) {
  return candidate.recall !== null
    && baseline.recall !== null
    && candidate.recall >= baseline.recall
    && candidate.falsePositiveCount <= baseline.falsePositiveCount;
}
最容易翻车的是 important 的标注,如果标准答案也由待测模型临时生成,这个验收就失去了独立依据;这里的替换规则也只适合漏检代价较高的筛选业务。
当天能做的验证,是从现有失败记录中挑出 20 条,先分清格式错误、输入问题、测试样例问题和判断错误,再单独统计关键样本。你可能会发现,真正该改的是一行输出约束,或者一个失真的回归样例。
六、Agent 能退款和提交代码,权限应该在哪一层拦
模型越来越能干,工程约束也得跟上。
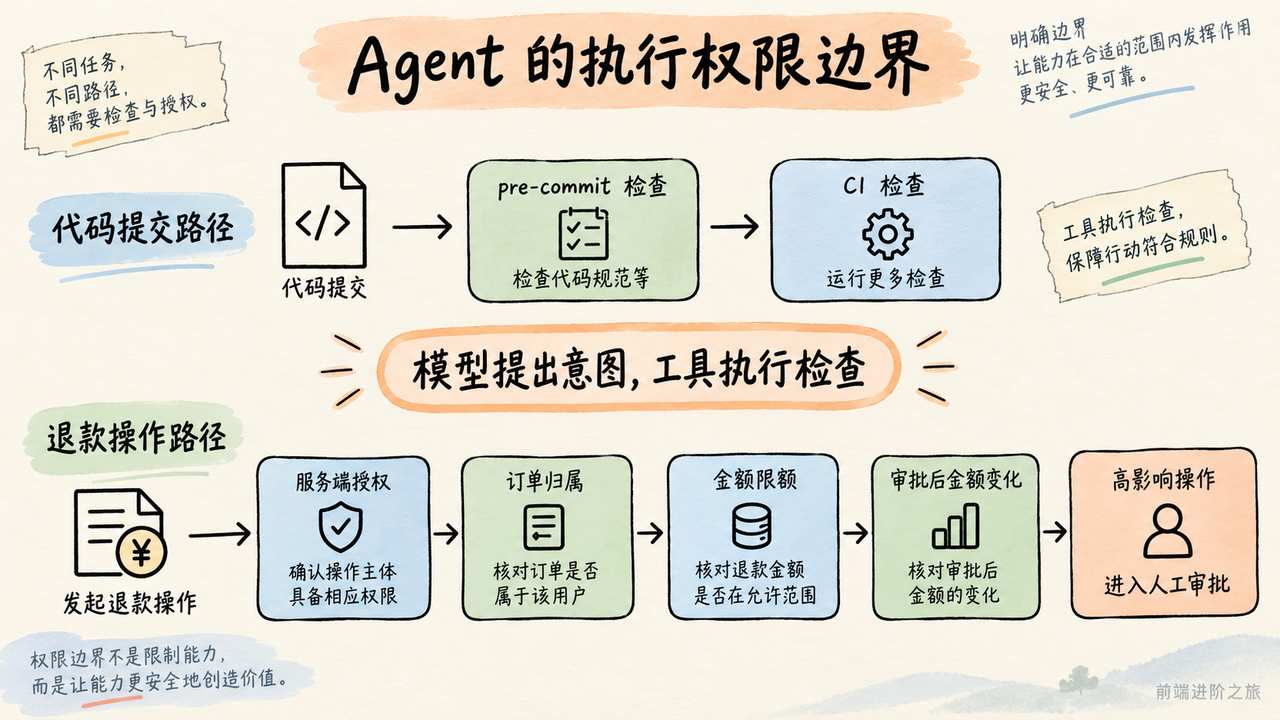
Simon Willison 收录的 Geoffrey Huntley 建议 是,把容易被 Agent 忽略的调用规范变成 pre-commit 检查。例如检查 git diff,发现代码绕过统一 diagnostics 库、直接调用 observability 模块,就让提交失败并返回修正提示。
我认可这个方向。AGENTS.md 可以解释规则,检查器可以让违规结果停下来。
但提交钩子能不能覆盖你们的实际路径,要另外确认。只配本地 hook,不能据此认定仓库已经不会出现违规代码。真要作为团队约束,我会考虑让同样的规则进入 CI,并选能检查真实调用关系的方式,避免简单文本匹配被别名或者间接调用绕过去。
资金和数据操作还要再往下走一层。
Agent 工具授权的讨论 把执行边界放在工具层,建议每个 Agent 使用独立身份、明确授权范围,并默认拒绝未授权操作。模型生成操作意图,真正写数据库、退款和部署的是工具,权限检查也应该在实际执行路径上生效。
这不代表身份和授权能解决所有提示注入。文章也指出,如果 Agent 本来就有发邮件的权限,被恶意文档诱导发错邮件,授权检查可能全部通过。限制权限能缩小影响范围,但不能替模型判断每一次合法操作是否合理。
退款 Agent 的架构文章 把这个问题落到了业务上。用户可以申请退款,应用持有支付凭证,Agent 负责处理流程,这三者不能混成一个身份。订单归属、支付状态、适用政策和证据条件,应由下游系统检查;高影响操作再进入审批。
文中的金额阈值和规则是示例政策,也不是生产安全证明。我的取舍是先明确能委托出去的业务子集,比如处理符合指定政策的损坏退款,再决定它需要哪些工具。把所有 API 都接上,后面补一句「请谨慎操作」,很难收回来。
前端也有责任。审批界面如果只放一个「同意」按钮,审核人看不到订单、金额和政策依据,确认动作就很空。应该让人知道自己批准的是哪一笔操作,而不是批准 Agent 接下来自由发挥。
还有一个容易被忽略的执行边界是文档。AI 排障文档实践 建议把实际采集的命令记录与模型解释分开保存,参数、退出状态和数值进入独立事实记录,再由校验器阻止未登记信息混入草稿。
这和权限设计有相通之处,模型可以组织解释,但不能顺手给自己扩大事实来源和可写范围。
今天可以用合成订单试三种失败路径,跨用户订单、超出配置限额、审批后金额变化。检查后端是否真正拒绝,并保留操作记录;如果只在页面上禁用了按钮,我不会认为这条边界已经守住。
总结
这一天的 AI 热点,发布消息里最醒目的是 MiniCPM-V 4.7 和 Meta Muse Wonder。按提供的报道,前者增加了端侧 MoE 与微调选项,后者给复杂编码和 Agent 任务增加了候选模型。API 入口、订阅限制与报价可以进入选型表,手机上的内存速度和榜单成绩则要连着测试条件读。
我的判断是,接下来 AI 编程的差距会越来越多地出现在模型周围。任务状态是否真实、记忆有没有串项目、关键样本会不会漏掉、工具权限能否拦住越界,这些都直接影响返工和成本。
新模型能不能替掉你当前的方案,今天还不能靠这些报道下结论。Deckhand 的咨询解决率、Grok 的三类任务测试、SparseEngine 的吞吐数字,也都不能直接搬成自己团队的收益。
要我选,我会先做一轮小而真实的验收。固定任务和权限,保存工具结果,单列最不能出错的样本,再看账单。对程序员和技术管理者来说,这比追着每一张新榜单换模型更有用。
参考
- MiniCPM-V 4.7 推出端侧 MoE 与微调方案|IT之家
- Meta 推出主打复杂任务的 Wonder 模型|TechCrunch
- Muse Wonder 跻身前列,调用成本上涨|The Decoder
- Meta 新旗舰模型强化代码能力|IT之家
- Meta 双新模型开放订阅与 API 入口|The Verge
- Grok 4.7 智能体如何平衡推理成本|AWS ML Blog
- BitNet 低比特模型本地推理框架|GitHub
- SparseEngine 统一接入稀疏注意力方法|dev.to
- Open WebUI 本地与云端模型入口|GitHub
- 用双项目测试检查 Agent 记忆串扰|dev.to
- 用运行状态自动推动编程 Agent 完成任务|dev.to
- Agent 消息显示成功却未送达的排查|dev.to
- 用 Slack 智能助手打通 IT 支持流程|AWS ML Blog
- 微调指标持平,却漏掉更多关键样本|dev.to
- 小模型提示测试,输出格式比文风更关键|dev.to
- 用拒收日志定位 LLM 工作流故障|dev.to
- 用提交钩子约束编程 Agent 的调用|Simon Willison
- Agent 安全应落实到工具授权层|dev.to
- 退款智能体如何设计授权边界|dev.to
- AI 排障文档应隔离命令证据与解释|dev.to
- 前端进阶之旅