62 个任务合并,便宜模型的执行费用按标价折算只有 14.22 美元,可任务从派发到合并,中位数还是 52 分钟。模型干活的时间不到一半,剩下的耗在排队、审查和重跑测试上。这是我读完 2026 年 10 月 25 日这批 AI 热点后,最想跟同事聊的反差。模型越来越能写,交付却未必更快。今天沿着模型选型、交付成本、代码审查、执行权限、故障回归和前端落地六条线,聊聊程序员该把时间花在哪。
一、百万 Token 的代码模型,能直接替换现有 Agent 吗?
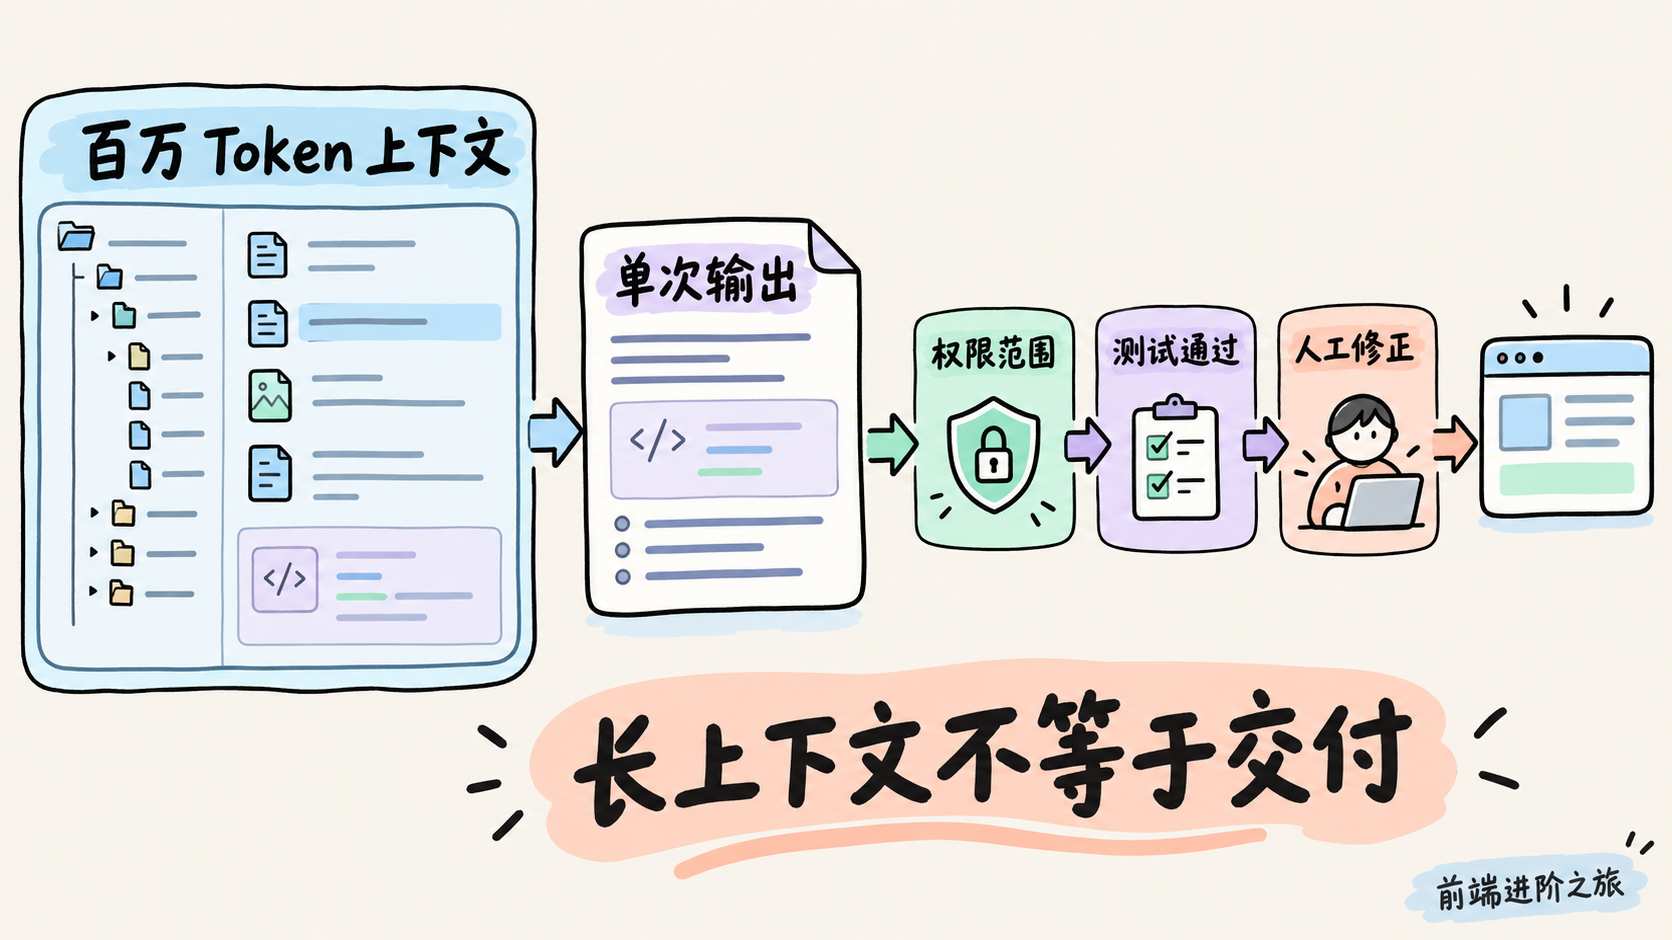
先说结论,我会把这些新模型放进候选池,但不会因为百万 Token 就换掉现有流程。
这批消息里,Gemini 4 Argon 和 Kimi K3.1 Pro 都把长上下文、长任务执行放到了显眼位置。问题是,几个看起来接近的指标,实际回答的是不同问题。
dev.to 的 Argon 文章声称,它拥有 1,048,576-token 上下文窗口,单次响应最多输出 1M tokens。前者关乎能装多少任务材料,后者关乎一次能生成多少内容,但文章没有交代输入与输出如何共享额度。
所以,别把它理解成百万输入加百万输出,更别直接推到整个仓库都能稳定改完。
文章还提到 Chromium 遗留代码重构,以及 google/adk-python 隔夜优化。后一个案例声称,会话准备时间降低 40%,冷导入耗时降低 21%。这两个数很吸引人,可测试环境、基线、重复次数和正确性验证都没展开。我的读法是,任务组织方式可以研究,百分比暂时不能拿去给团队估工期。
能连续生成很多代码,和能交付一个通过验收的改动,中间还隔着整条工程流程。
Kimi K3.1 Pro 的报道也有类似的阅读门槛。按文中转述,它支持百万 Token 上下文,网页、编程工具和 API 已提供服务,但完整权重计划在 11 月 4 日发布。API 可用和权重可下载,得分开算。
编程成绩同样要连着条件看。文中的厂商测试使用最高推理强度,不能直接当成日常默认配置的表现。另一个容易被忽略的数字,是该指数测试消耗了 150M tokens,中位数为 87M。单价低,遇上更长推理和更多重试,任务账单仍可能上去。
说实话,我更关心模型在约束下能不能完成任务。上下文再长,如果它顺手改掉无关文件、漏跑测试,最后还是人来收拾。
真要判断换不换,我会拿仓库里最近 20 个真实任务,覆盖跨文件修改、依赖升级和一个性能问题,固定工具权限与验收条件。当天先跑其中几个代表任务,把完成率、人工修正时间、总费用和耗时一起记下来。别只截一张榜单。
二、AI 编程费用降了 25 倍,为什么交付还在等?
模型选型接下来就得算账。
双模型编程实验让 Claude 规划和审查,MiMo-V2.6-Pro 实现代码。作者在 14 个仓库派发 95 个任务,其中 62 个完成合并,任务大多是 Python,不能直接当成前端项目的提效成绩。
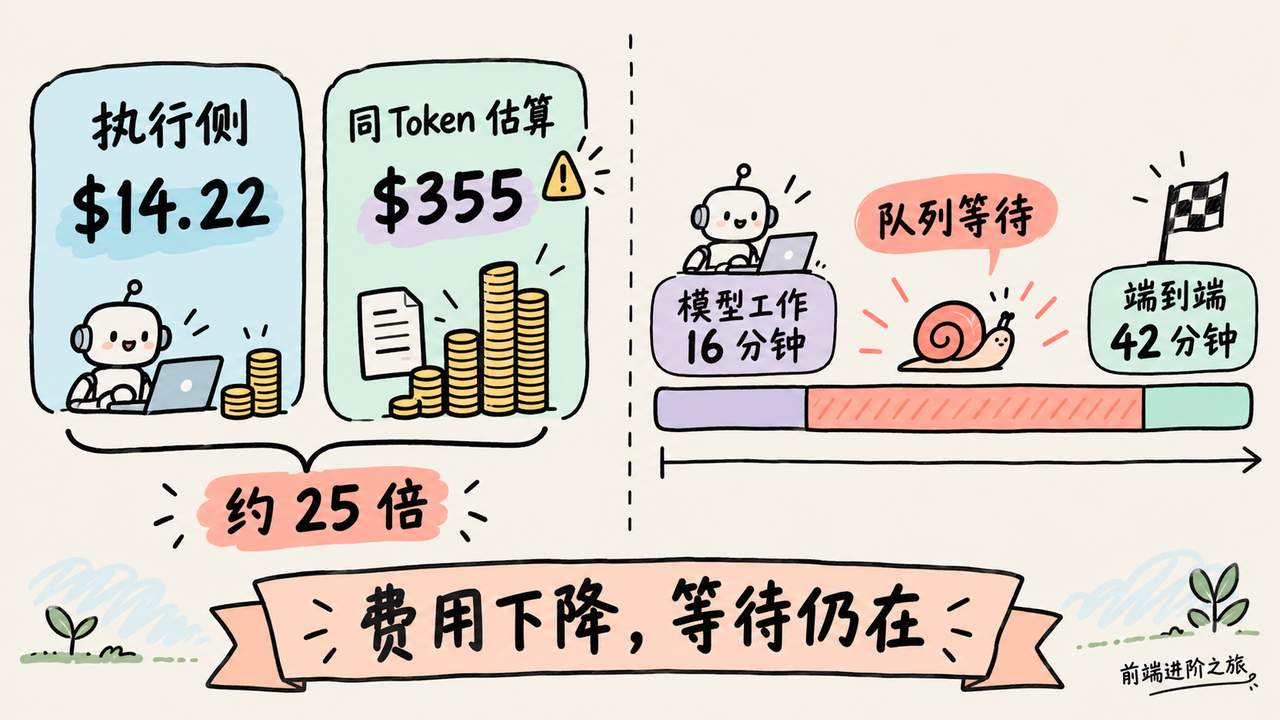
这 62 个已合并任务的 MiMo 执行侧费用,按公开标价折算为 14.22 美元。相同 token 数量套用 Opus 价格,估算为 355 美元,约有 25 倍差距。
这个账能说明执行侧的价格差,不能证明实际换用 Opus 就一定花 355 美元。模型不同,调用次数、推理长度和返工路径都可能变化,而且这也不是包含规划、审查和人工时间的完整成本。
更有意思的是耗时。
首次审查通过的任务,MiMo 工作中位数为 16 分钟,端到端却要 42 分钟。作者发现,多出来的时间很大一部分来自调度器隔近 10 分钟才查看一次队列。为了省审查模型的 token,流程让已经完成的任务继续等着。
模型交卷了,队列还没醒。
这里有个坑,大家讨论 AI 编程成本时,很容易只盯输出价格。这次实验中,97.8% 的 token 是缓存读取,输出只占 0.56%。对这种持续携带上下文的工作流,缓存价格可能比生成代码的价格更影响账单,但这个比例只属于作者这套流程。
再看备用模型路由的案例,作者按延迟优先选择提供商,结果某次请求很快返回,却跳过搜索,直接生成没有取证的答案。
如果只看接口成功率和响应时间,这次调用很好看。业务任务却失败了。
便宜和快都应该排在能力验收之后,否则省下来的只是一次没完成任务的调用费。
对做 AI 办公提效或编码平台的团队,我会把两种时间分开记。一种是模型实际运行时间,另一种是等待调度、人工审批和重复检查的时间。再把未完成任务算进去,否则只统计成功合并的任务,容易漏掉失败尝试的消耗。
当天可以从最近十个任务里抽时间线,不用先写复杂平台。找到完成后迟迟没人审、重复跑同一套检查的空档,再拿一个必须调用工具的任务测备用模型。先确认它会干这份活,再比较谁便宜。
三、AI 写九成代码,人工审查到底该看什么?
顺着上面聊,模型负责写、另一个模型负责审,听起来分工完整,但审查通过究竟证明了什么?
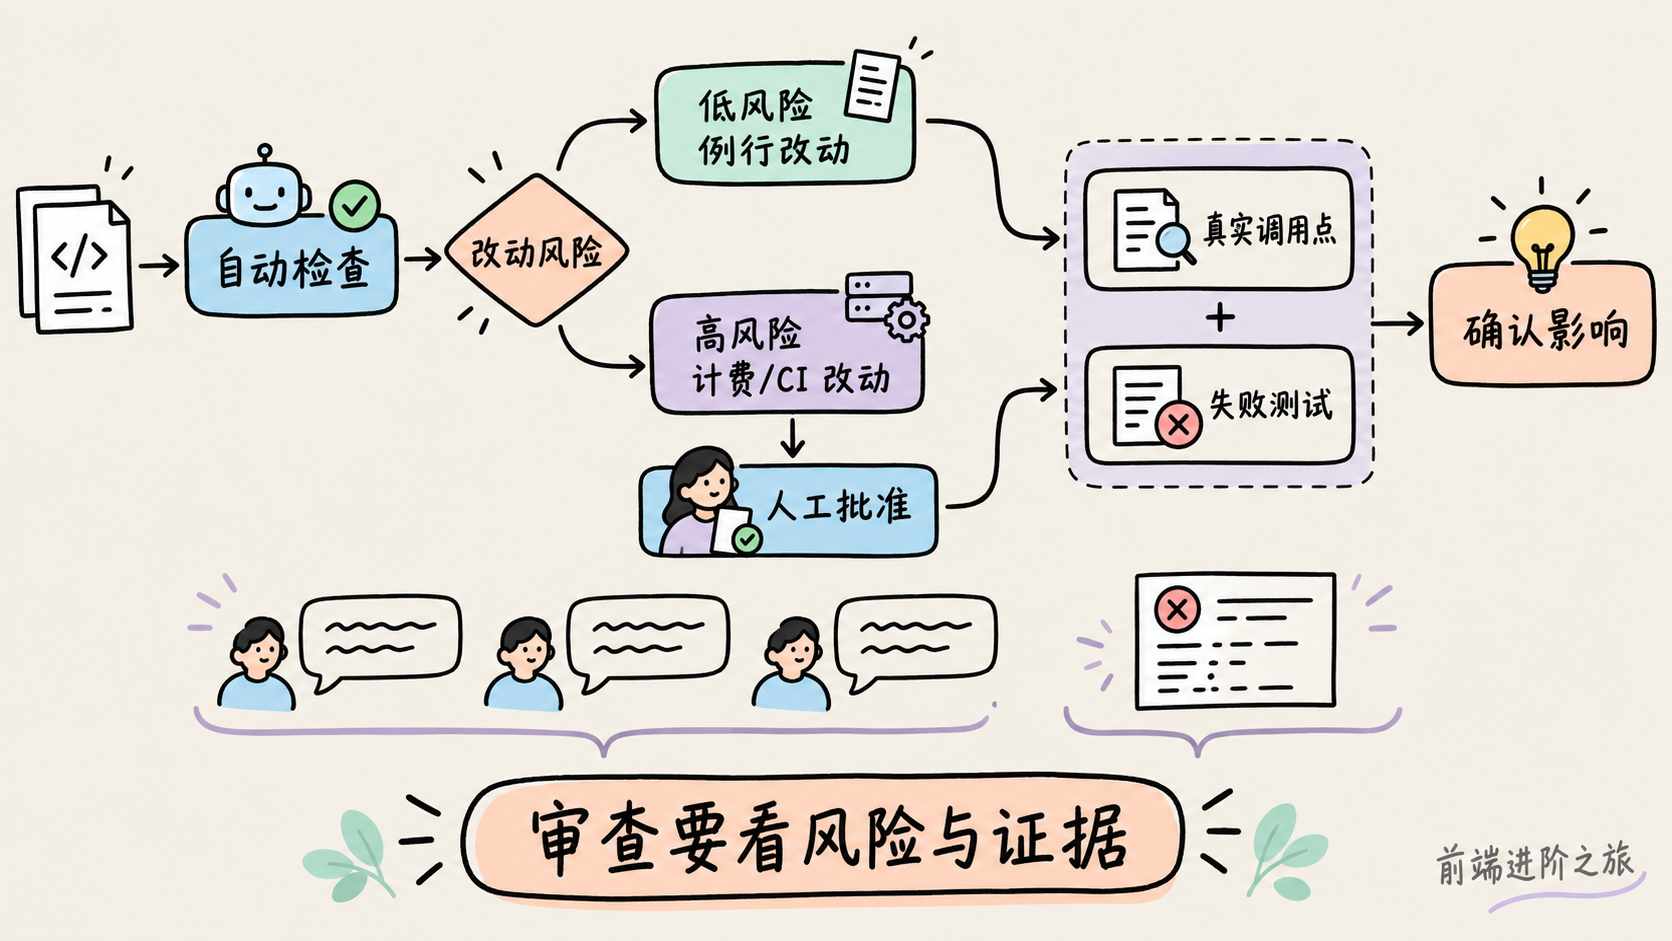
关于 Claude Code 审查流程的文章给出了一套风险分级安排。按文中描述,PR 先经过自动检查和多个 AI reviewer,再根据改动风险要求零到两个人工批准。计费、自动更新器和 CI 工作流属于高风险,安全问题会阻止合并。
我赞同按改到哪里分配审查资源。一个按钮文案和一段退款逻辑,确实不该机械地消耗同样的人力。
但低风险零人工批准,前提仍然是自动检查存在。它不是看到文档后缀就一路放行,更不能把所有新增代码都当低风险。文章提到的特定标记增量改动,具体边界并没有解释清楚。
文章报告了合并量翻倍、回滚减少 40% 等变化。这些是该文给出的团队结果,不能据此认定全部改善都由分级审查带来。
我更喜欢其中一个朴素做法,把历史事故变成 reviewer 的评测题。改审查提示词前,先看它能不能识别过去真的漏过的问题。
这比评论写得更长有用。
不过,多个 reviewer 赞同,也不一定是独立证据。针对 Agensh 千代理实验的评论指出,同模型实例可能重复相似错误。共享看板还要求不要重新推导同伴的 FACT,这能减少重复劳动,也可能让错误前提失去复核机会。
这里不能反过来断言,实验已经证明错误大规模传播。评论作者提出的是证据缺口,而且他也在推广自己的方案。但这个问题确实值得问,十个模型同意,到底是十次验证,还是同一种判断重复十遍?
Vendorwake 的依赖升级实践给了一个更具体的约束。它把发现分成已确认、潜在和不受影响,模型可以解释或降低风险等级,却不能自行升级为已确认。确认要靠准确的符号与 API 变更证据,或者升级后的失败测试。
我会把这个思路放到前端依赖升级里。模型说某个组件 API 变了,可以先列为线索;定位到真实调用点、对上变更内容,再用失败用例证明影响,才适合要求业务团队安排修复。
当天就能挑一个最近升级过的依赖,让 reviewer 找问题,同时埋入一处已经知道的错误。看它有没有抓住、证据能不能复现,比比较两份审查报告谁更像专家更直接。
四、AGENTS.md 写了限制,为什么还要在执行前拦一下?
回到这块,审查解决的是改动能不能接受,执行权限还得单独管。
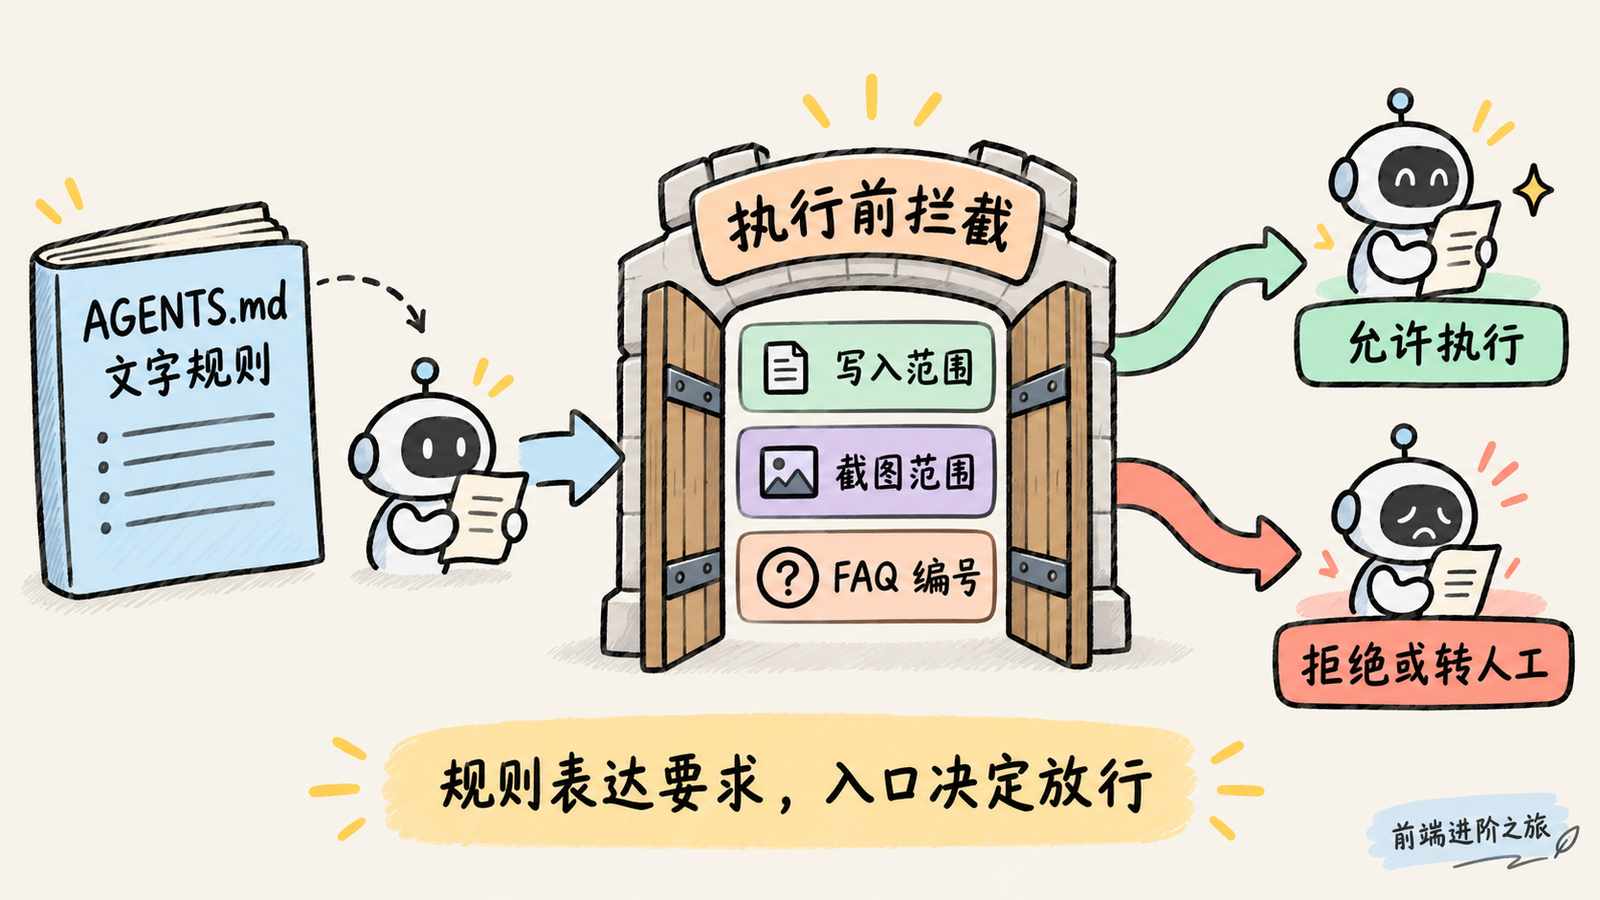
编码代理规则对照实验用了三种模型、八项任务,进行了 24 轮对照。一组只靠文字规则,另一组在动作执行前增加确定性检查。文中记录,提示组有四次违规被放行,拦截组拒绝了五次动作。
这个样本不大,也不能拿来比较所有模型谁最守规矩。但它把一个区别讲清楚了,模型提出违规动作,和系统允许违规动作发生,是两件事。
有个案例尤其像日常业务开发。模型为了满足新增依赖需要 ADR 的规则,创建了 docs/adr/ 文件,却同时违反只能写 src/ 的范围限制。它不是完全没读规则,而是在冲突里做了一个没有权限依据的选择。
规则文件负责表达要求,执行入口负责决定动作能不能发生。
这个边界放到桌面操作更明显。Cursor Computer Use 的介绍称,Agent 可以点击、输入、截图,并操作 iOS 模拟器。对界面开发,这能缩短写代码到验证交互的距离;可它面对的是本机桌面会话,邮件、聊天窗口也可能进入截图。
文章提醒,macOS 需要授权独立的 Computer Use 辅助应用。授权对象选对了,不代表截图范围就只剩测试应用。本地操作也不代表模型在本机推理。
你要是也在做客服或业务 Agent,可以再看只让模型选择 FAQ 编号的方案。它不给模型自由报价的出口,最终答案从维护好的表里取。
下面这段 JavaScript 表达的是同一个取舍,让模型只能选择已有答案。
const faq = new Map([
  ["hours", "营业时间请以预约页面展示为准。"],
  ["warranty", "保修范围请由人工核对订单后确认。"],
]);

function resolveReply(modelResult) {
  const id = modelResult?.id;

  if (typeof id !== "string" || !faq.has(id)) {
    return { handoff: true }; // 未知结果不直接发给客户
  }

  return {
    handoff: false,
    message: faq.get(id), // 最终措辞来自答案表
  };
}
最容易翻车的是 faq.has(id) 后的放行,编号合法只能证明它存在,不能证明选对了问题,还得拿相近问题和多意图问题测语义误选。
这三个案例放一起,我的取舍很明确。能用程序收紧输出和权限,就别全压在提示词上。当天可以挑一个越界修改任务、一个未知 FAQ 问题和一个桌面截图场景,检查系统是否真的拒绝、转人工或限制了可见范围。
五、Agent 说已经办好,怎样证明它真的成功了?
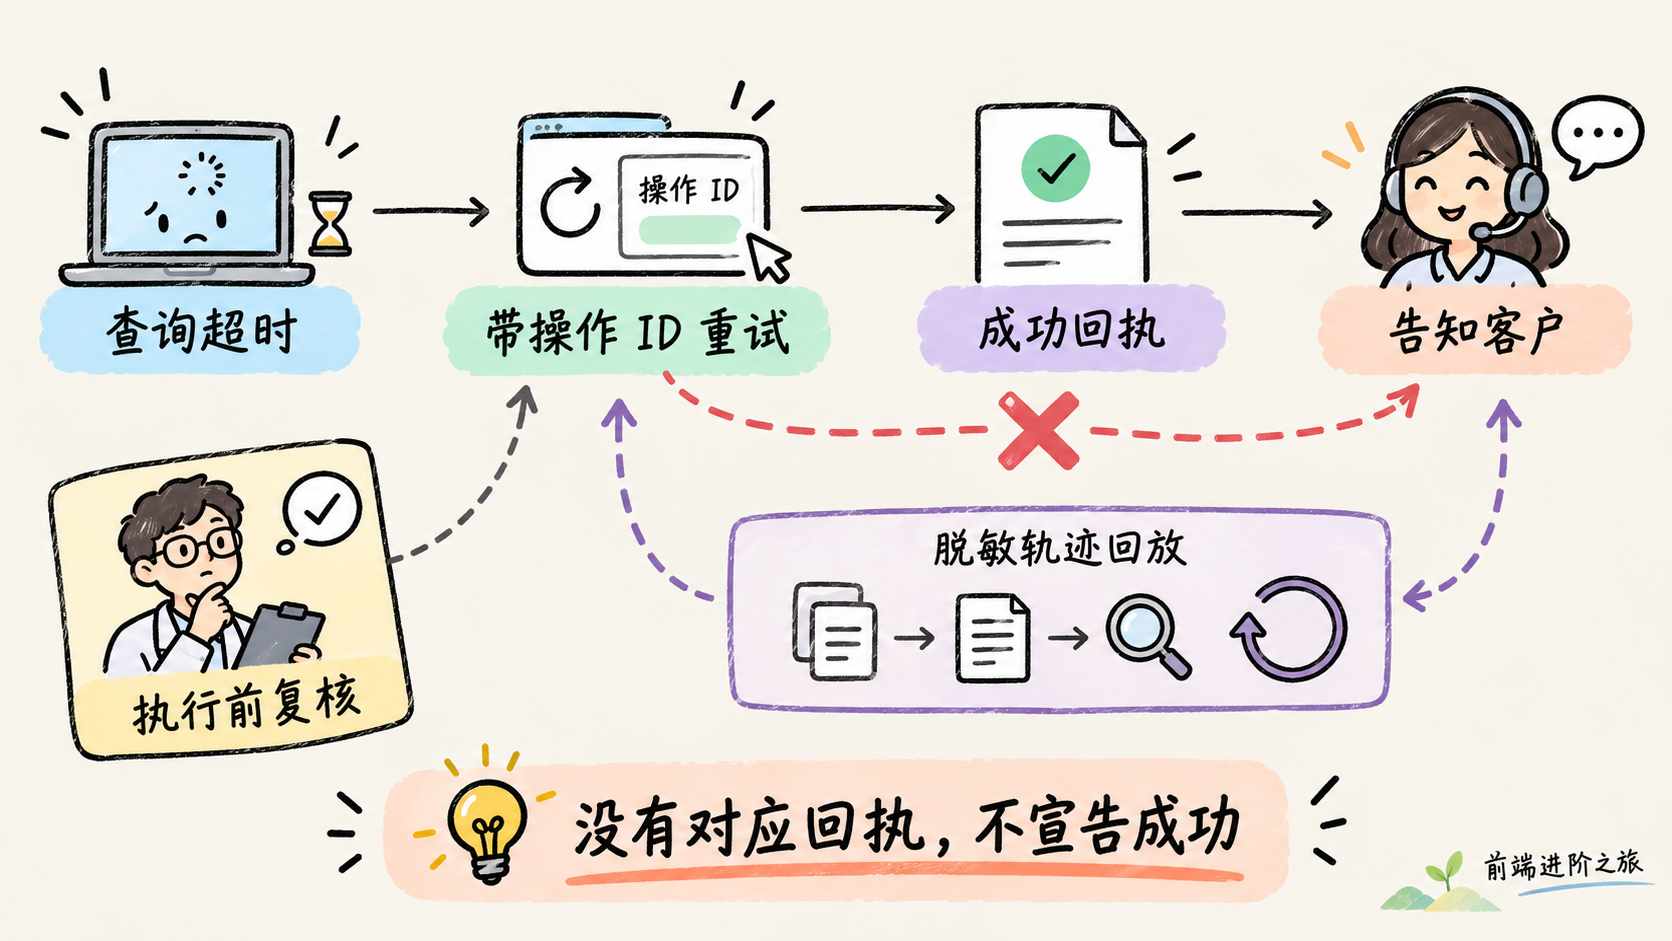
模型会调用工具之后,最麻烦的错误往往出现在几个动作之间。
Agent 轨迹回放文章举了一个暂停订阅的例子。查询账单超时,Agent 用错误账户标识重试,随后告诉客户已经暂停,但操作实际没有成功。
单测账单接口,可能没问题。单看回复,也很礼貌。错误藏在超时、重试、写入和成功声明串起来的过程里。
所以,成功声明也得有验收条件。
文章建议把失败轨迹脱敏成可回放样本,保留工具顺序、参数、错误类型和操作回执,用固定工具返回值重现故障。回放时不能真的再发邮件、建工单或扣款,否则测试本身又在改业务状态。
这里有个很细的提醒我赞同。脱敏不能顺手修好故障。如果畸形账户标识正是触发错误的条件,就不能把它替换成合法标识。否则测试很稳定,原来的错误却再也走不到了。
审批过期的文章补上了另一个环节。人工批准退款后,客户又说不用退了,系统执行时若只检查批准状态,仍可能沿用已经过期的决定。作者把动作和关键上下文绑定成指纹,执行前重新比较。
这能识别审批依据变化,但单独比较哈希,还不能消除检查后、写入前的竞争窗口。落到业务服务,仍要配合版本校验和幂等控制。
下面用 JavaScript 写一个回放断言,专门拦住没有确认结果却宣告成功的路径。
function assertPauseOutcome(events) {
  const receipts = events.filter(
    event =>
      event.tool === "billing.get_operation" &&
      event.status === "succeeded"
  );

  const claims = events.filter(
    event => event.type === "customer_success_claim"
  );

  for (const claim of claims) {
    const verified = receipts.some(receipt =>
      receipt.operationId === claim.operationId &&
      receipt.seq < claim.seq // 回执必须先于成功声明
    );

    if (!verified) {
      throw new Error("缺少对应操作的成功回执");
    }
  }
}
最容易翻车的是 operationId 的关联,拿到别的操作的成功回执也不能放行;这个示例只检查声明依据,没覆盖必调工具、调用次数和最终业务状态。
说实话,这类测试比再加一句必须准确更值得投入。RAG 排障文章也在提醒同一件事,先保存模型真正拿到的资料,再判断错误来自检索还是生成。有引用不代表资料正确,有工具调用也不代表操作成功。
当天可以取一条最近失败的问答或工具任务,固定输入、检索片段和工具返回,把成功条件写成断言。接着换提示词或模型跑一遍,看错误是否复发,别只挑一次看起来正常的结果。
六、前端接上 AI 后,为什么演示能跑、用户却用不了?
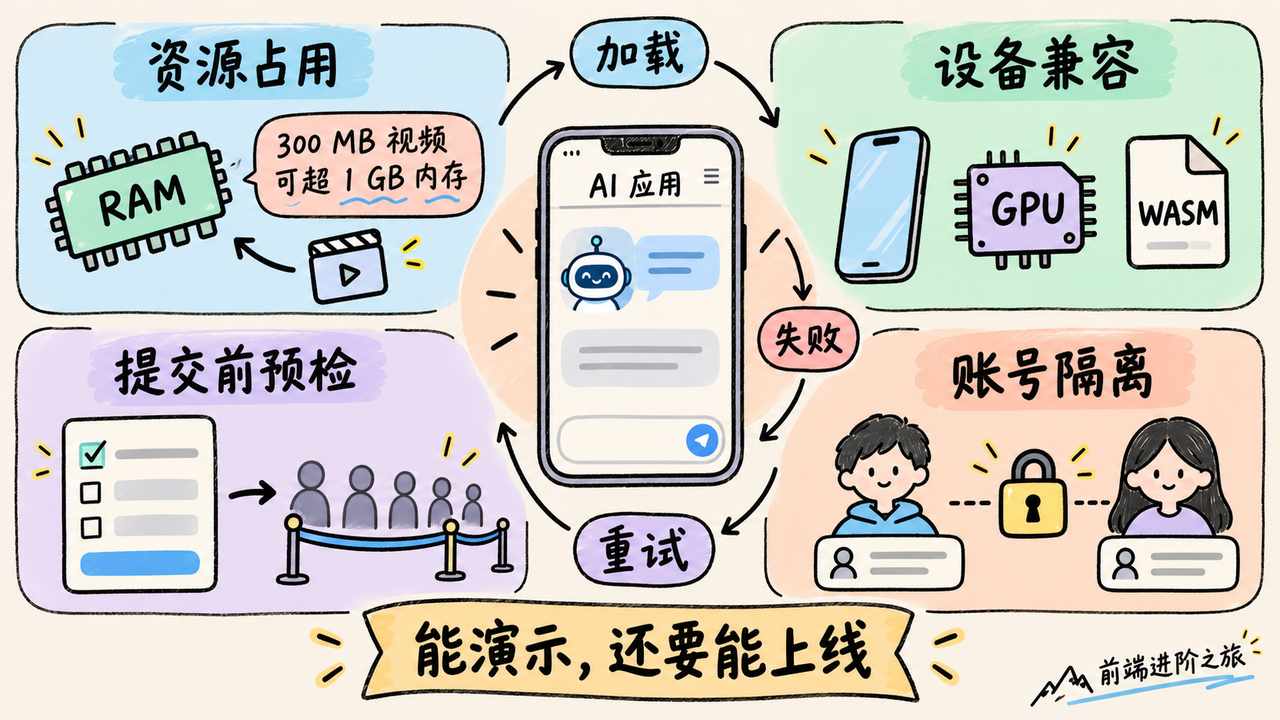
大概率你也遇到过,自己的电脑上很顺,换个手机就卡住。
浏览器 Whisper 转写实战里,作者遇到的麻烦就集中在模型之外。一个 300 MB 手机视频,仅提取音频就让内存占用超过 1 GB。原因之一是先把整个文件读进 JavaScript,再复制进 ffmpeg 的内存文件系统。
作者改用 WORKERFS 挂载 File 对象,减少整份输入文件的重复复制。但这没有消除音频和模型内存,文中估算 float32 PCM 每小时仍约占 230 MB。
WebGPU 也不是检测到就能放心开。文章记录了手机转录过程中 Worker 死亡,作者最终把手机切到 WASM。具体原因仍是怀疑,不能直接归结为所有手机 GPU 都不适合推理。
回到前端交付,这些问题会直接变成下载等待、页面卡死、失败重试和用户离开。模型能力只占其中一段。
另一段是请求合法性。Wan 3.0 本地预检文章把媒体组合、数量和时长约束提前编码,避免排队后才发现参数不合法。作者验证了本地测试,没有调用生成 API,所以预检通过仍不能保证视频效果。
这个方向我会借鉴,尤其是昂贵的异步任务。能在提交前发现的问题,没必要让用户等一轮。
还有更基础的上线边界。AI 生成应用安全检查提醒,进入前端构建产物的秘密密钥,应按已经公开处理。发现真实泄露后,先轮换,再迁移服务端调用。数据库权限也不能只看 RLS 开关,得用两个账号交叉访问记录,确认用户之间确实隔离。
前端 AI 功能能不能上线,要一起看资源、权限、失败恢复和等待体验。
这也是我对端侧 AI 的边界判断。它可以减少文件上传,但大文件处理、模型下载和设备兼容性不会自动消失。云端生成省了本机推理,又把队列和接口费用带进来。
当天不用追求完整压测。拿一个较大文件、一台低配设备、一个不合法请求和两个测试账号,把加载、失败、重试与越权路径走完。哪怕只查出一个重复复制或跨账号读数据的问题,也比再优化一句生成提示词更接近上线。
总结
读完 10 月 25 日这批消息,我更愿意把时间投给可验证的交付流程。
能从这些文章里落到具体实现的,是按风险分配审批、用工具回执约束成功声明、把故障轨迹变成回归样本,以及在调用前校验参数。它们都有明确检查对象,但报道里的提效百分比、模型成绩和个案费用,仍得带着样本与条件读。
我的判断是,下一阶段 AI 编程的差距,会越来越多地出现在任务怎么拆、证据怎么留、失败怎么重现。对技术管理者,合并量也该连着回滚和人工返工看;对程序员,生成速度之外,还得算验收成本。
至于 Gemini 4 Argon 的百万级输出、大仓库案例,以及 Kimi K3.1 Pro 能否替换现有模型,这批文章还不足以替我们做决定。前者缺少可核对的一手依据,后者的厂商成绩和社区个案也不等于自己的业务表现。
我会继续关注新模型,但先让现有 Agent 拿出做完的证据。
参考
- Gemini 4 Argon 据称支持百万 Token 输出|dev.to
- Kimi K3.1 Pro 的开发者选型讨论|dev.to
- 双模型编程的成本与耗时实测|dev.to
- 为什么备用模型不能只按延迟排序|dev.to
- Claude 写九成代码时如何审查|dev.to
- 千个同模型代理的验证盲区|dev.to
- Vendorwake 的依赖升级证据链|dev.to
- 编码代理规则与执行拦截对照实验|dev.to
- Cursor Agent 的桌面操作能力|dev.to
- 让客服模型只选择 FAQ 编号|dev.to
- 把 Agent 线上故障变成轨迹回放测试|dev.to
- 执行前重新检查审批上下文|dev.to
- RAG 答错时先检查检索结果|dev.to
- 浏览器运行 Whisper 的兼容性排障|dev.to
- Wan 3.0 请求提交前的本地预检|dev.to
- AI 生成应用的上线前安全检查|dev.to
- 前端进阶之旅