
每个请求都返回 200,缓存命中率却从约 90% 掉到 25%—45%,日费用涨到原来的 2—3 倍。Bedrock 提示缓存文章里的这次经历,比一张模型跑分表更让我在意。功能没坏,账单先坏了,直到六天后才找到原因。读完 2026 年 10 月 12 日这批 AI 热点,我想沿着成本、验收、证据、执行边界、模型选型和办公交付六条线聊聊,给还在写业务代码的程序员留几个当天就能验证的判断。
一、AI 接口返回 200,为什么费用涨了、业务还会失败?
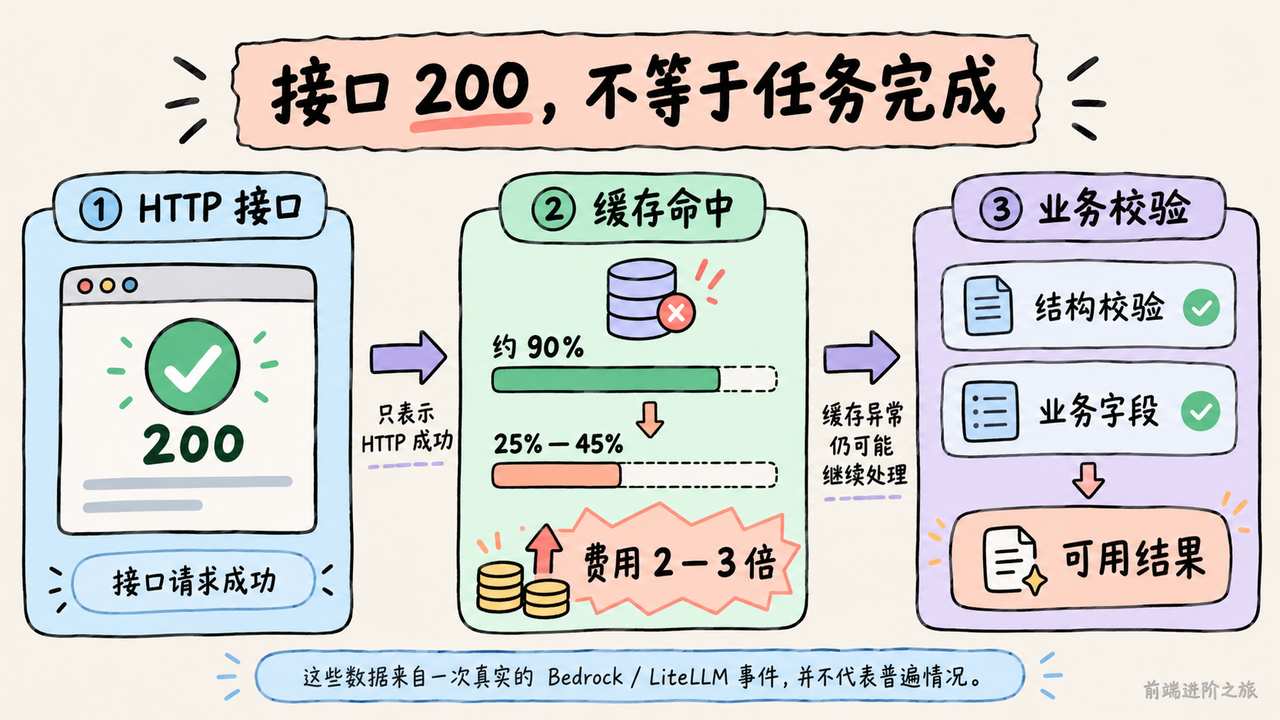
先说结论,接入模型以后,HTTP 成功只能说明请求走通了,不能替你证明缓存生效、内容可用,更不能证明整个业务完成了。
Bedrock 提示缓存排查文章记录了一次 LiteLLM 升级后的问题。system prompt 在请求里的位置发生变化,作者平台上的 Claude Code 流量缓存命中率从约 90% 降到 25%—45%,每天费用增加到原来的 2—3 倍,持续六天才查明原因。这是作者报告的特定平台经历,不能拿来预测所有团队升级后的账单。
但它提醒的问题很具体。
提示缓存复用的是请求前缀。cache point 之前的内容要一致,服务还得找到已有缓存条目。任一条件不满足,请求照样执行,只是没有拿到预期的缓存收益。文章还提到一种 Agent 循环里的位置错误,cache point 停在最后一条用户消息上,后续工具调用和结果一直堆在它后面。
回到这块,Agent 跑得越久,越应该检查实际复用了哪段历史。只看会话开头成功写入过一次缓存,很容易高估后面的节省。
另一篇多模型故障切换文章把失败分成服务中断、限流、响应过慢和内容无效。最后一种对前端尤其熟悉,接口状态码正常,返回的数据却不能驱动页面。模型给了字符串,解析器要 JSON;JSON 能解析,业务字段却不合法。只捕获网络异常,抓不到这些问题。
我的取舍是把输出校验放进调用链,再讨论换哪家模型。下面这段代码解决分类结果能解析、却不能用于业务的问题。
const categories = new Set(["billing", "support", "other"]);

function parseDecision(raw) {
  const result = JSON.parse(raw);
  if (!result || typeof result !== "object" || Array.isArray(result)) {
    throw new Error("invalid_object");
  }
  if (!categories.has(result.category)) {
    throw new Error("invalid_category"); // 能解析不代表业务接受
  }
  if (
    typeof result.confidence !== "number" ||
    !Number.isFinite(result.confidence) ||
    result.confidence < 0 ||
    result.confidence > 1
  ) {
    throw new Error("invalid_confidence");
  }
  return result;
}
最容易翻车的是 categories.has 这一行,允许值必须跟业务契约同步,不能照着模型某次输出临时补名单。
故障切换也有边界。备用模型能返回合法字段,不代表判断质量与主模型一致;每家分别设置超时,也不代表总耗时满足页面等待预算。真要落地,我会拿同一组正常输出、缺字段输出和错误枚举做校验,再注入一次超时,观察整条请求的耗时和最终状态。缓存则单独跑固定前缀的连续请求,对照实际缓存读写用量,别拿 200 当验收结果。
二、模型说代码做完了,怎样确认它没有漏跑测试?
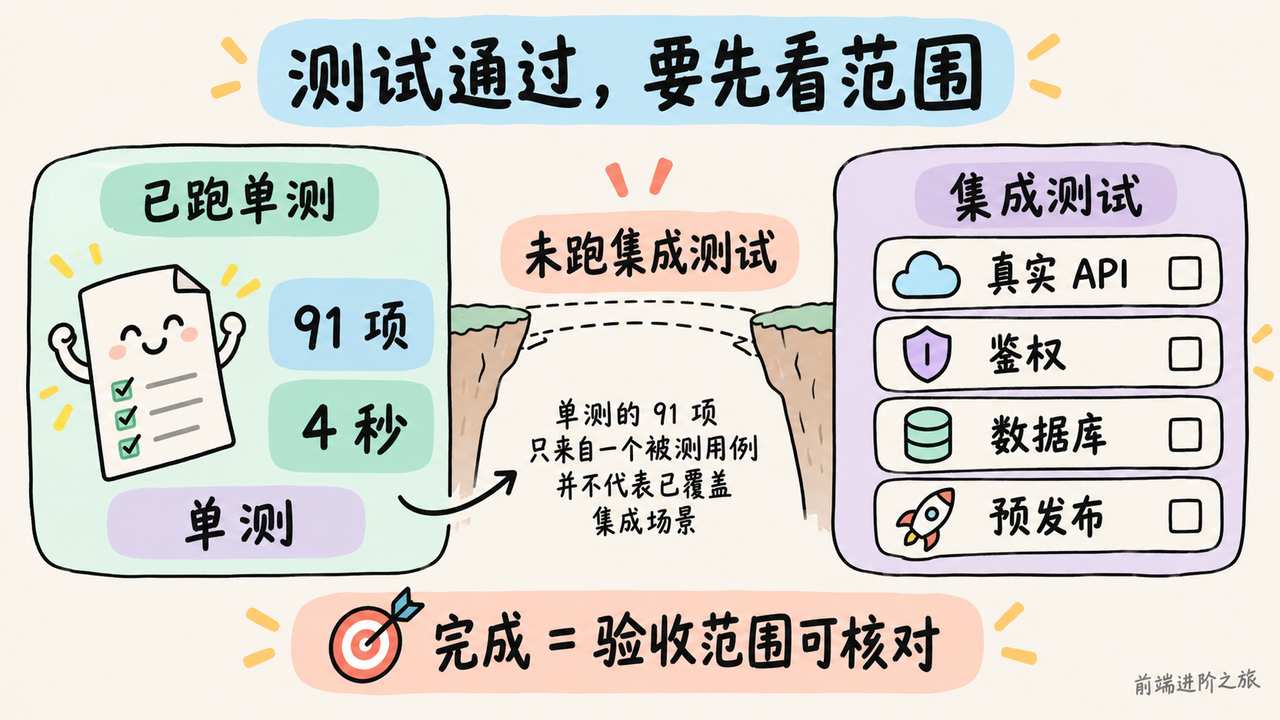
AI 编程的完成条件,应该落在实际执行的验收上。
遗漏集成测试的案例里,Agent 宣称所有测试通过,实际跑的是 pytest tests/unit -x --quiet。91 项单元测试,四秒结束。覆盖改动路径的集成测试没跑,问题到了预发布环境才暴露。
这不是所有 Agent 都会如此的统计结论,但那句「所有测试通过」确实藏了一个范围问题。通过的是哪套测试?数据库有没有启动?真实 HTTP 请求有没有经过鉴权和参数校验?这些都不能从一个绿色退出码里推出来。
顺着上面聊,Laravel AI 验证工具尝试把这件事固化。它根据 diff 选择测试、静态分析、格式和启动检查,并识别删除、跳过或削弱测试的行为,返回 pass、fail 或 incomplete。它还提供 Agent 停止钩子和供 CI 检查的提交标记。
我喜欢它把 incomplete 单独列出来。环境起不来、检查超时、覆盖不足,都不该被顺手归成完成。
不过,按差异挑选最小检查集合,前提是影响分析足够可靠。跨模块配置、公共中间件和数据库行为可能影响看起来没改的地方。工具声称支持哪些能力,可以从介绍里确认;它在你的仓库里会不会漏选,仍然要用真实改动检查。
验收也不能只盯着代码。Claude Code 与 Codex 的对照文章提前冻结了 20 项浏览器和 API 检查,覆盖退出后的旧 cookie 重放、用户数据隔离、空白标题、持久化、移动端和键盘操作。这套设计比看生成了多少行代码更有参考价值。摘录报告 Claude Code 首次通过全部 20 项检查,但没有完整呈现 Codex 的最终结果,两者推理强度也不同,我不会据此宣布谁普遍更强。
这里还有两种测试要分开。登录权限、金额计算和字段规则,可以有确定的期望;自然语言摘要则允许多种正确表述。AI 工作流测试文章建议检查关键信息、结构、长度和禁止内容,避免把精确字符串匹配用于自由生成文本。
结构通过也只是一关。
机器遗忘审计的小规模试验只有两个缺陷案例,两个模型都发现了问题,评分器却险些判错。它提醒我,验收器自己也可能出错,尤其是用文本特征代替实际效果的时候。
当天能做的验证很简单。拿仓库里最近一次涉及 API 或数据访问的改动,核对 Agent 实际执行的命令、耗时和输出,再补一条直接调用 API 的越权用例。生成内容则选几条固定输入重复运行,分别记录格式通过和信息正确的比例,别把重跑一次变绿当成问题消失。
三、RAG 回答错了,怎样判断该修检索还是换模型?
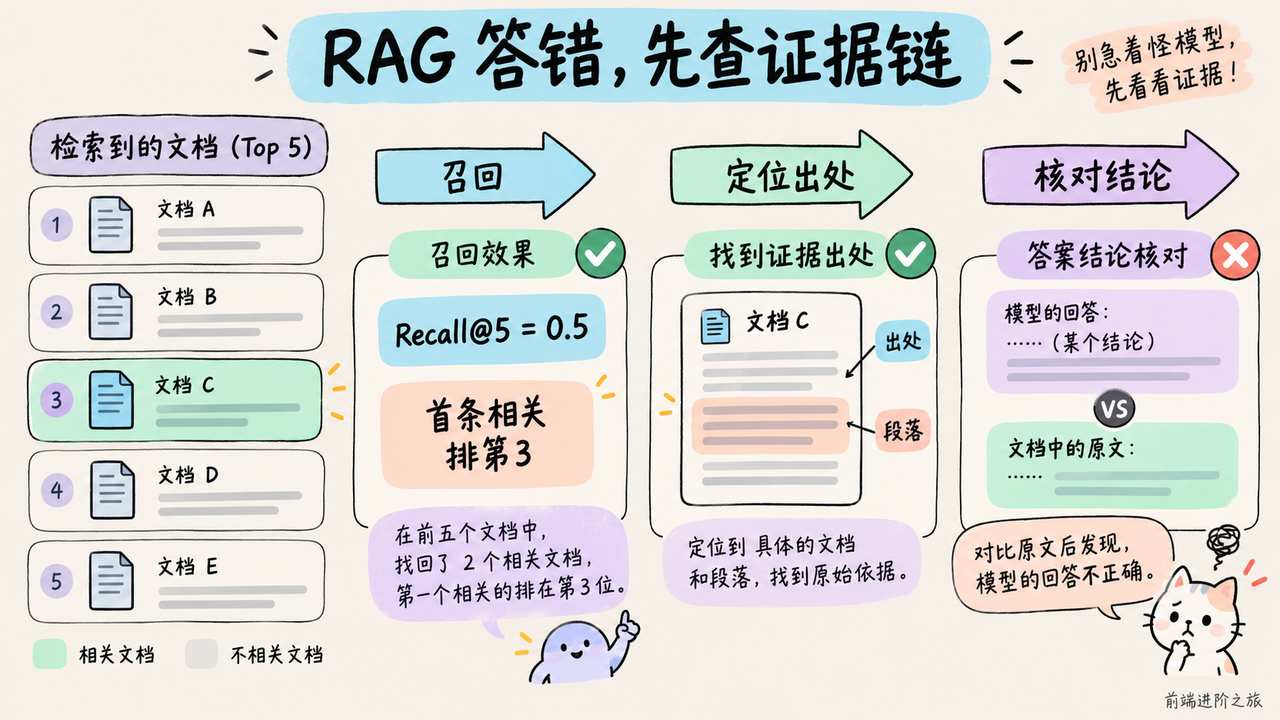
你要是也在做知识库问答,我会先问一句,正确证据进上下文了吗?
检索评估框架文章给了两个起点。Recall@k 看前 k 个结果覆盖了多少已知相关文档,倒数排名看第一条相关结果排在哪里。它明确是演示框架,不是客户项目实测,也不能衡量最终回答是否正确、安全或有依据。
用一个例子就能看出差别。问题有两份已知相关文档,前五条只找到一份,Recall@5 就是 0.5;这份文档排第三,倒数排名就是 1/3。前者告诉你漏了证据,后者告诉你证据的位置。两项都不错,模型仍可能曲解原文。
所以先别忙着改 prompt。
这里有个坑,检索返回 chunk,标注却写 document ID,直接比较会把命中算成遗漏。文章要求评分前统一标识层级,还要按文档去重。对于没有已知答案的问题,空的相关文档集合也不能证明所有检索结果都无关,这类用例应单独报告,不能混入召回和排名平均值。
检索到了以后,还得留住出处。研究型 Agent 的设计文章要求事实性结论关联文档、页码或章节及原文段落,而且这些信息要贯穿分块、总结和改写。PDF 两栏拼错、表格拆坏、图注丢失,都会让后续回答建立在错误输入上。
对前端来说,这会直接影响页面怎么做。一个只显示参考文献列表的回答,用户还得自己找支撑句;能跳到对应页码和段落,核验成本才真正降下来。我的判断是,企业知识库可以先少做一点回答花样,把来源定位做扎实。
但引用存在,不等于引用支持结论。稳定 ID 解决的是找得到,逐条核对才解决说得对。
我会当天挑十个真实问题,人工标好预期文档,再分别看证据是否召回、第一条证据的位置和回答是否引用到正确段落。十题不足以证明整体质量,却足够揪出一批明显的映射、分块和来源丢失问题。要决定换不换模型,至少先把这三类结果分开。
四、Agent 能调用工具,为什么还要单独做授权和人工审核?
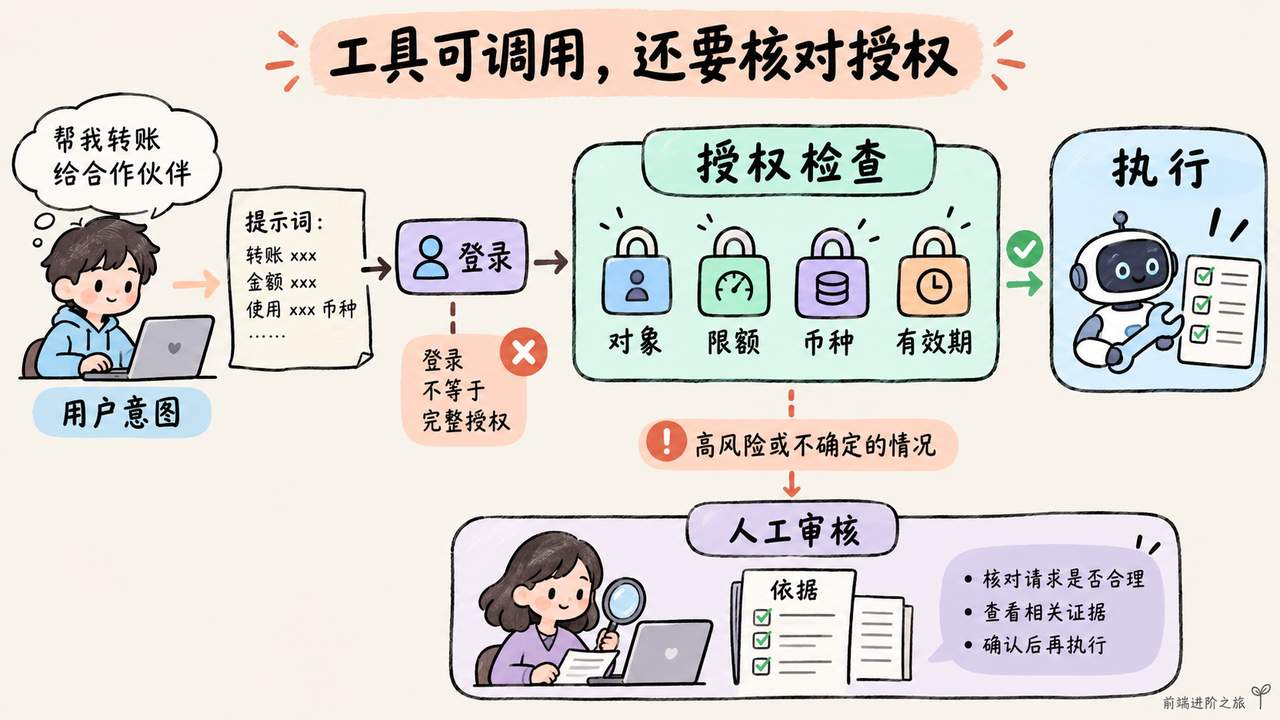
把用户一句话变成工具调用,中间省掉的步骤越多,边界越得写清楚。
四项提示词约定文章建议明确角色、单一交付任务、禁止事项和输出格式,并规定输入不满足要求时怎么办。这对评论分类、信息提取很实用。要求「简洁地总结一下,顺便判断情绪」和规定字段、枚举、无关输入的处理方式,留给模型猜测的空间差很多。
不过,提示词约定只能约束预期行为,不能替代服务端校验,更不能授予执行权限。
金融 Agent 授权架构文章把语言理解、策略授权和资金执行分开。用户已经登录,不代表 Agent 获得全部账户权限;工具可以访问,也不代表这次交易应当执行。金额上限、账单对象、币种和有效期,都需要进入明确的授权边界。
这套思路也适用于后台批量操作。下面的 JavaScript 示例把授权检查放在执行前,金额使用最小货币单位。
function assertAuthorized(intent, grant, now = Date.now()) {
  if (!Number.isSafeInteger(intent.amountMinor) ||
      intent.amountMinor <= 0) {
    throw new Error("invalid_amount");
  }
  if (intent.action !== grant.action ||
      intent.billerId !== grant.billerId ||
      intent.currency !== grant.currency) {
    throw new Error("outside_grant");
  }
  if (intent.amountMinor > grant.maxAmountMinor) {
    throw new Error("amount_exceeded"); // 模型理解不能放宽限额
  }
  if (!Number.isFinite(grant.expiresAt) || now >= grant.expiresAt) {
    throw new Error("grant_expired");
  }
}
最容易翻车的是金额上限比较,必须先确认双方采用同一种单位;这段示例还假定 grant 来自可信服务端,不能接受模型或客户端自己生成的授权。
说实话,把所有结果都交给人工,也没有自动补上这道边界。人工审核文章用合成例子说明,大量看起来正确的样本会诱发机械批准。文中的 97% 准确率、每天 300 张发票等数字用于说明问题,不是某家公司的效果统计。
它建议结合影响程度和不确定性分流,并对自动通过项抽样审计。原始置信度没校准之前,不能直接拿来决定免审。审核界面也得展示依据,否则审核者只能重做一遍任务,或者相信模型。
我的取舍是让程序检查硬边界,让人处理需要判断的例外。当天就能拿几条超额、错对象、过期授权和缺字段输入试一下,再看审核页面能不能直接显示触发原因。别只演示一条顺利通过的路径。
五、490 Token 每秒和免费百万上下文,值得换编程模型吗?
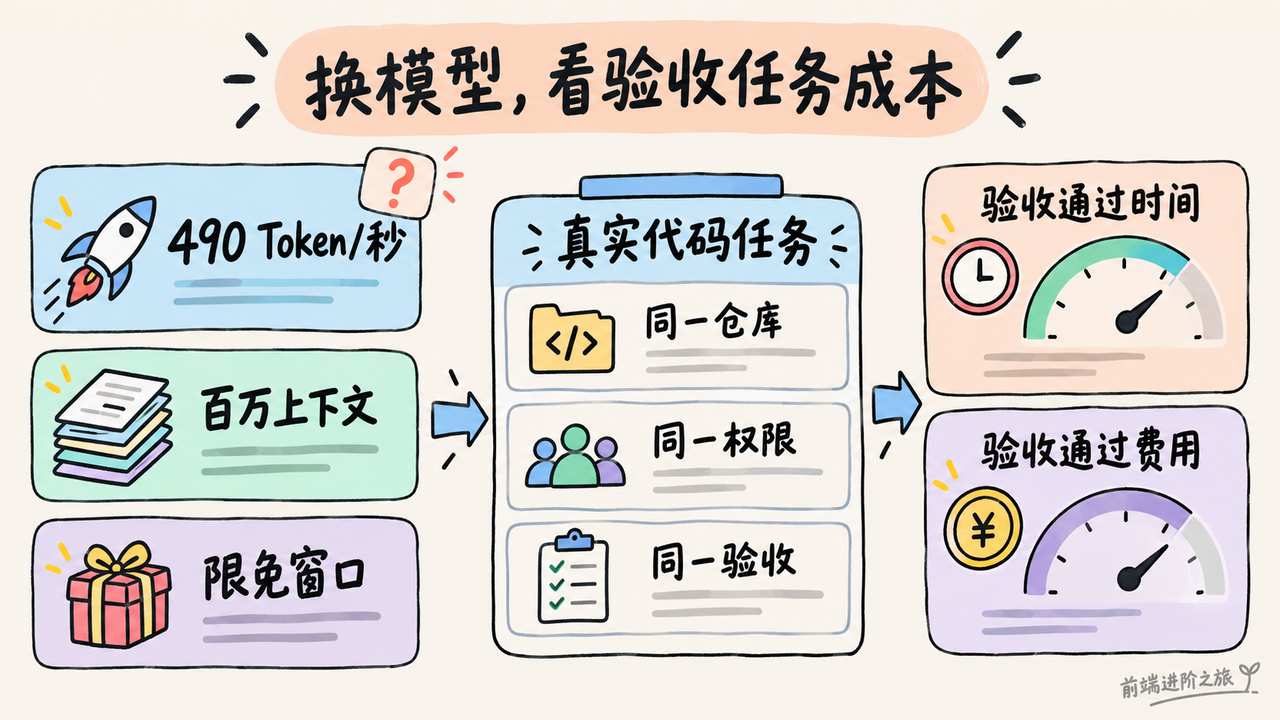
快,当然有吸引力。免费窗口也值得用。但我会把尝鲜和迁移分开。
WorkBuddy 接入 Step 5 Preview 的报道给出了明确时间,2026 年 10 月 12 日至 25 日限免。模型采用 600B 总参数、27B 激活参数的 MoE 架构,支持百万 Token 上下文和视觉输入,完整权重计划于 10 月 15 日开放。站在这份日报的日期,开源仍是计划,不能写成已经完成。
百万上下文是容量信息,不能直接推导出整个仓库都能理解好。对 AI 编程来说,我更关心它能否找对文件、保持已有行为,以及修复后通过验收。
GLM-5.3-Highspeed 的报道提到 Zcode 中的体验和网友展示的 490 tokens/s。这个数我会带着条件读,现有材料没有给出完整测速设置、持续表现或同任务代码质量对照。生成阶段快,不代表首次响应快,更不代表少走两轮错误工具调用。
另一个方向是缩小模型的职责。Cloudflare Clef-omni 报道介绍了对文本、图像、音频和视频进行评分的决策模型,报道给出的输入价格为每百万 Token 0.15 美元,Clef-flash 为 0.038 美元。它返回类型化选项的概率,适合拿来评估分类和路由,但报道也指出它在多数推理和工作流评测中落后于 Clef。这个输入单价不能直接当作整个应用的成本。
14 款决策模型的个人评测里,Decision-1 答对 82 道人工标注题中的 75 道,在 26 组选项反转测试中没有翻转。响应时间中位数 0.472 秒来自作者 Mac 发起请求的环境,每题 0.0000036 美元也对应他的题目和调用方式。它是可复用的评估线索,不是生产质量承诺;本地模型的 API 费用为零,也不等于硬件和运行成本为零。
要我选,我会先比较每个验收通过任务的时间和费用。
免费窗口刚好适合拿最近十个真实代码任务做初筛,固定仓库、权限、修复轮次和验收条件,同时记录工具调用耗时。若要试决策模型,就另外准备分类样本,别拿它和全栈编程任务混成一张榜。
六、长程 Agent 和 AI 办公提效,为什么都该看最后留下什么?
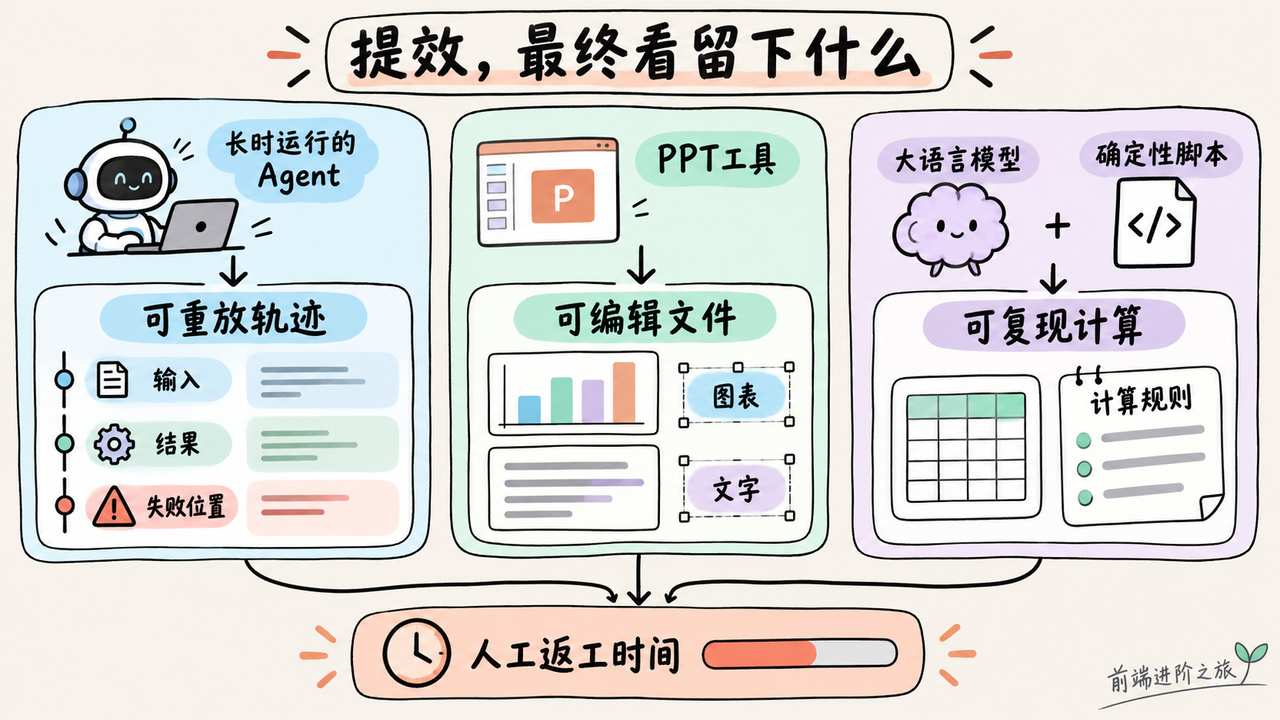
这一组看起来跨度大,一边是 GPU 训练调度,一边是自动生成 PPT。我读到的是同一个交付问题,过程耗了不少资源,最后能复用多少?
QwenGyre 的报道介绍了弹性 GPU 调度、按共享前缀组织的轨迹树,以及为部分完成任务提供反馈的评分方式。官方 NL2RepoBench 实验中,每次 rollout 约 70 万 Token,48 步训练后通过率从 52.5% 到 58.5%,提高了 6 个百分点;相同 GPU 预算下,相对 Async 的端到端加速为 1.78 倍。
这些数字属于在线强化学习实验。
它们不能直接套成业务 Agent 快了 1.78 倍,也不能推出前端团队接入后能省同样比例的钱。对多数应用团队,先借鉴它记录真实上下文、保留轨迹和利用部分成果的思路,比立即研究 GPU 调度更贴近工作。
另一头,PPT Master介绍了从文档或主题生成原生 PowerPoint 的能力,支持可编辑形状、图表、转场、动画,沿用模板,并把演讲备注转成音频旁白。这里我最在意可编辑。技术分享临时改数字、项目汇报临时换一页,能继续修改的文件,比一张漂亮但难改的截图更接近交付。
不过,项目介绍能支持功能判断,不能证明你的长文档会自动得到准确、好看的整套演示文稿。AI 办公提效要把人工修正时间一起算进去。
语言理解与脚本计算的分工文章也值得放在这里。它让模型解析点餐意图和表达方案,脚本负责枚举、优惠券匹配和确定性计算。我赞成这个职责划分,但不接受脚本天然不会算错的保证。规则写错、菜单数据过期或约束映射错误,照样会给出错误结果。
自然语言里的「不到 50 元」,也不能悄悄变成 45 元硬上限,除非用户认可预留预算的策略。计算可复现,前提得先表达准确。
当天能做的验证,是用一份已有技术文档生成五页演示稿,实际修改一个图表和两处文字,记下返工时间。已有长程 Agent 的团队则挑一条轨迹,检查每次工具调用的输入、结果和失败位置能否重放,看看中途停止后究竟留下了哪些可用成果。
总结
10 月 12 日这批消息里,有明确的产品时间,也有作者案例和官方实验。Step 5 Preview 的限免窗口写得清楚,10 月 15 日开放权重仍是计划;QwenGyre 的 1.78 倍加速有具体训练条件;Bedrock 费用上涨来自一个平台的升级经历。它们都值得看,但各自能回答的问题不同。
我的判断更偏业务一侧。前端、全栈和技术管理者现在最值得投入的,是把模型接入后的成本、测试范围、证据来源和执行权限做成可检查的结果。新模型可以试,验收条件要先定下来。
490 tokens/s 能否持续、百万上下文能否改善真实代码任务、差异验证工具会不会漏掉影响路径,这些还得在自己的环境里跑。对天天交付业务的程序员,我更愿意相信一次有记录的真实任务验收,而不是一句「已经完成」。
参考
- Bedrock 提示缓存失效为何没有报错|dev.to
- 用 n8n 与 Python 实现模型故障切换|dev.to
- AI 改完代码,测试全绿仍可能漏验|dev.to
- Laravel 新工具给 AI 改码设置验证关卡|dev.to
- 用统一验收测试比较两款编程代理|dev.to
- AI 工作流测试如何应对输出波动|dev.to
- 模型遗忘审计,发现漏洞还得评对结果|dev.to
- 先测检索命中,再定位 RAG 答错原因|dev.to
- 研究型 Agent 如何保留每条结论的出处|dev.to
- 用四项明确约定减少提示词输出漂移|dev.to
- 金融 Agent 的授权边界该如何设计|dev.to
- 人工审核为何会退化成机械批准|dev.to
- WorkBuddy 限时开放 Step 5 编程模型|IT之家
- 智谱新模型主打每秒 490 个 Token|量子位
- Cloudflare 发布低价多模态决策模型|MarkTechPost
- 14 款决策模型实测,准确率、延迟与成本|dev.to
- QwenGyre 提升长程智能体训练效率|IT之家
- PPT Master|GitHub
- 决策 Agent 如何分离语言理解与计算|dev.to
- 前端进阶之旅