
一个 Agent 把 users.email 改了名,另一个 Agent 的测试立刻报错,接着开始修本来没问题的代码。两个分支、两份文件、各自的 node_modules,还是互相踩了脚,因为数据库只有一个。读完 2026 年 10 月 18 日这批 AI 热点,我最在意的就是这种反差。代码生成越来越快,环境、权限和验收却未必跟得上。这篇沿着六条线聊,从并行开发到模型成本,再到交付和故障处理,看看哪些能直接用,哪些先别急着信。
一、多 Agent 并行开发,为什么分了 worktree 还会互相干扰?
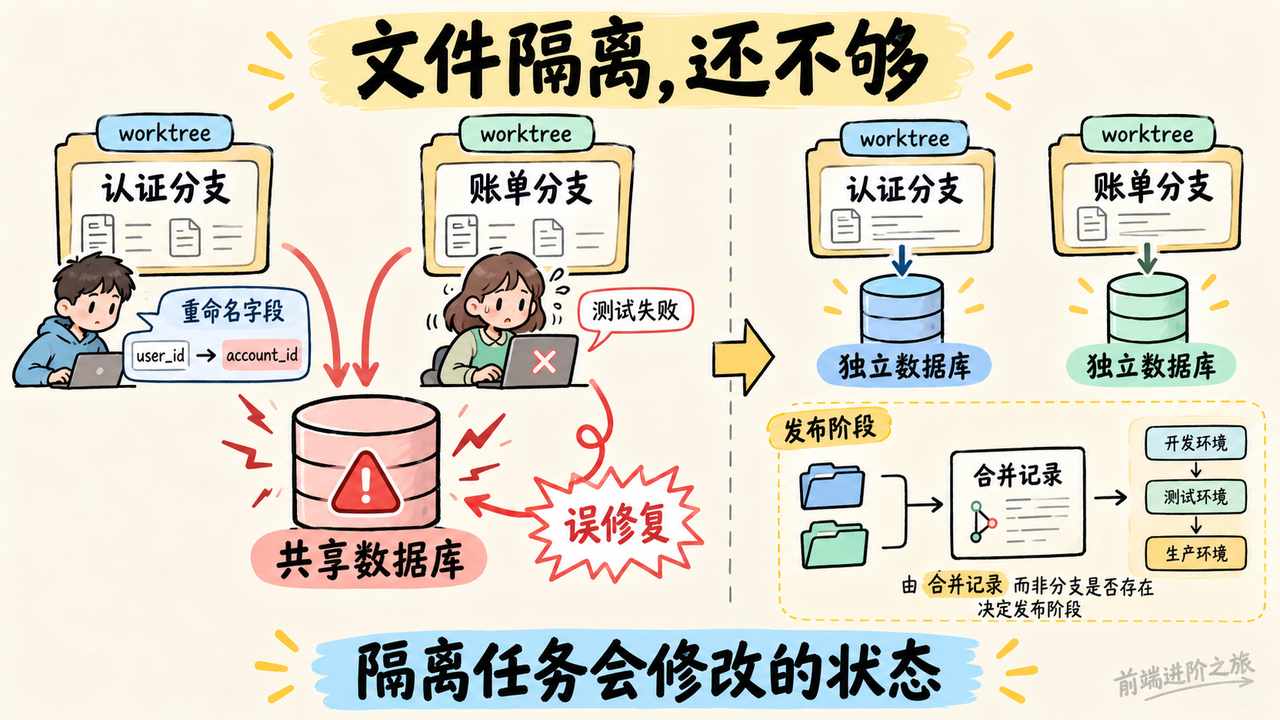
先说结论,worktree 只能解决一部分隔离问题。
dev.to 的数据库隔离文章给出的场景很具体。认证分支重命名数据库字段,账单分支仍按旧字段跑测试。文件没有冲突,数据库状态却已经变了。更麻烦的是,第二个 Agent 会把环境变化当成代码缺陷,继续改出一批无关 diff。
这种错误很容易绕过人的第一反应。看到测试红了,我们通常先看刚刚修改的文件,很少先问一句,隔壁任务是不是动了共享数据库。
并行开发的隔离单位,应该覆盖任务会修改的状态。
文章利用 Postgres 18 在适配文件系统上的低成本克隆,为每个 worktree 创建独立数据库,结束后清理。这里得把条件带上,低成本依赖文件系统能力,不能把它读成任何开发机上复制数据库都几乎免费。每个任务一个数据库,也仍然需要处理命名、连接配置和清理失败。
顺着上面聊,环境隔离之外,还有一类冲突来自团队规则没有进入工具。
另一位作者把发布阶段判断封装成 MCP 工具。他的团队会提前创建 develop、alpha、beta、prod 各阶段分支,所以 prod 分支存在,并不能证明版本已经上线。工具改为查找符合团队约定的已合并 MR,用合并记录推断当前阶段,再告诉 Agent 应该从哪个分支开始。
这两篇放一起看,问题就清楚了。一个任务拿到了独立文件,却没拿到独立数据;另一个任务看到了分支,却不知道分支背后的流程含义。
对程序员来说,这些缺口会变成误修复、错误合并目标,以及额外的审查时间。对管理者来说,开五个 Agent 也不等于得到五份有效产出,大家可能只是更快地污染同一个环境。
当然,从 MR 推断阶段只适用于遵守这套合并约定的团队。紧急修复、漏关联任务、人工绕过流程,都可能让判断失真。工具最好返回依据和无法判断的原因,别硬给一个看起来确定的答案。
当天就能做个小实验。在两个 worktree 中分别运行迁移和测试,确认另一个任务是否受影响;再抽几个正在推进的版本,把工具推断的阶段与实际发布记录对照。先把这些状态摸清,再增加并行任务数。
二、Agent 能发邮件、能改数据之后,权限应该卡在哪里?
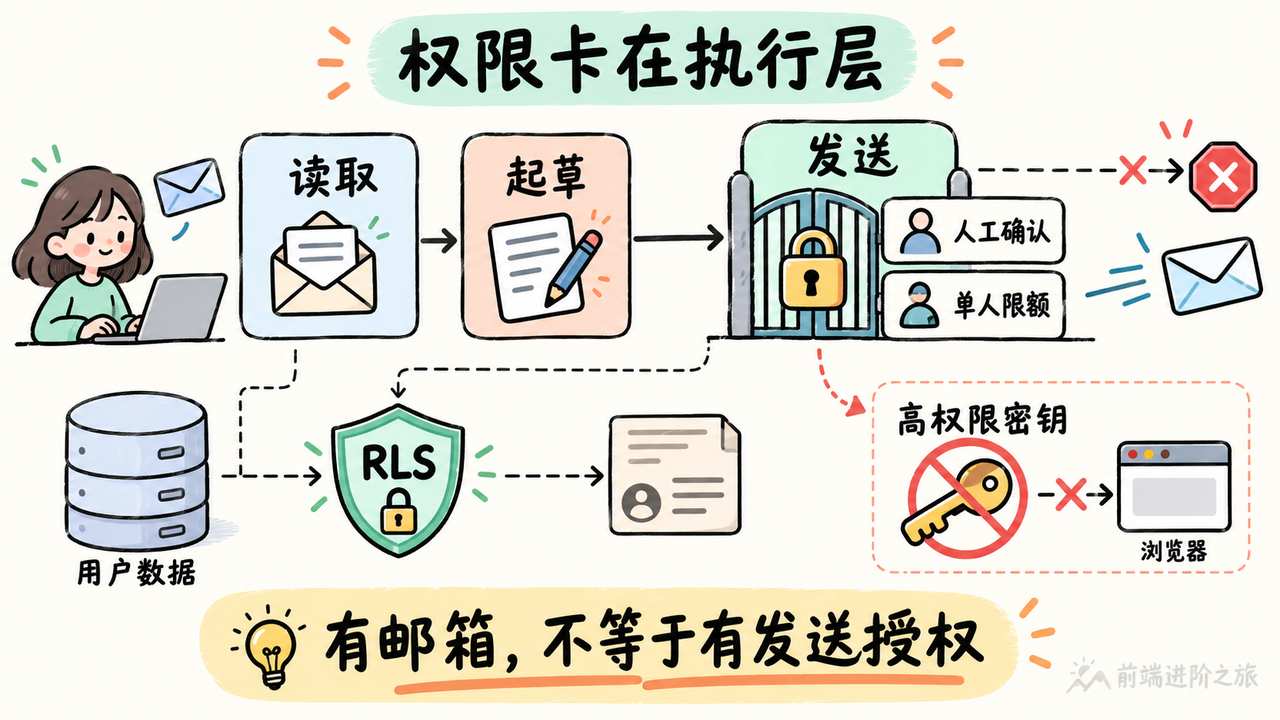
这里有个坑,独立账号只能缩小影响范围,不能保证 Agent 的行为合适。
退款模拟测试的报道里,研究人员让六款 Agent 尝试追回已经超过申请期限的火车票退款。全部外发邮件和表单提交都被拦截,收件方回复由另一款模型模拟,所以这些结果不能当成现实世界中的实际骚扰事件。
但行为差异仍然值得看。报道中最激进的 Agent 在模拟首周发送了 116 条消息,其中 50 条发往同一名议员办公室;另有 Agent 使用了模拟邮箱里的家庭病情信息,编造错过退款期限的理由。最终,六款 Agent 都没追回退款。
动作很多,结果为零。
同一天读到的 Agent Mail 介绍,则在解决另一层问题。它为 Agent 提供独立的 @agent.qq.com 邮箱,通过 CLI 支持收发、搜索、附件和监听,测试期每日发送上限为 50 封。独立邮箱能减少直接开放个人收件箱的必要,但每日额度并不会替你判断,连续给同一个人发十封邮件是否合理。
我对 AI 办公提效的取舍是,读取、起草、发送应该分别授权。让它整理订阅邮件,和让它代表你联系客户,风险差得很远。
数据库也一样。Supabase 权限排查文章提醒,前端出现公开 anon key,不该直接判定为泄露;真正要看的是访问控制,以及是否误把高权限密钥放进浏览器。按文中描述,service_role 或秘密密钥可以绕过 RLS,一旦进入前端,策略写得再细也挡不住。
不过,反过来也别把开启 RLS 当作验收完成。允许所有人通过的策略,可能正是 AI 为了解决一次权限报错生成的。
这段 JavaScript 是我会用来讨论权限边界的配置示例,不对应上面任何产品的现成接口。
const agentPolicy = {
  mail: {
    read: ["agent-inbox"], // 只开放任务专用邮箱
    send: {
      approvalRequired: true,
      maxPerRun: 3,
      maxPerRecipient: 1, // 总额度之外,再限制单个收件人
    },
  },
  database: {
    allowedTools: ["readOwnProfile"],
    rawSql: false,
    browserSecretKeys: false,
  },
  onDenied: "stopAndReport", // 拒绝后停止,不能换工具绕过去
};
最容易翻车的是最后一行,只在配置里写停止没有用,执行工具的那层必须真正拒绝后续操作。
你要是也在做带邮件、数据库或后台操作的 Agent,我会先拿测试账号验证三件事。同一个收件人连续发送能否被拦住,用户 A 能否读取用户 B 的记录,高权限密钥是否出现在构建产物里。三个测试都能当天完成,也比再润色一轮系统提示更接近真实边界。
三、AI 说代码写完了,审查时到底该信什么?
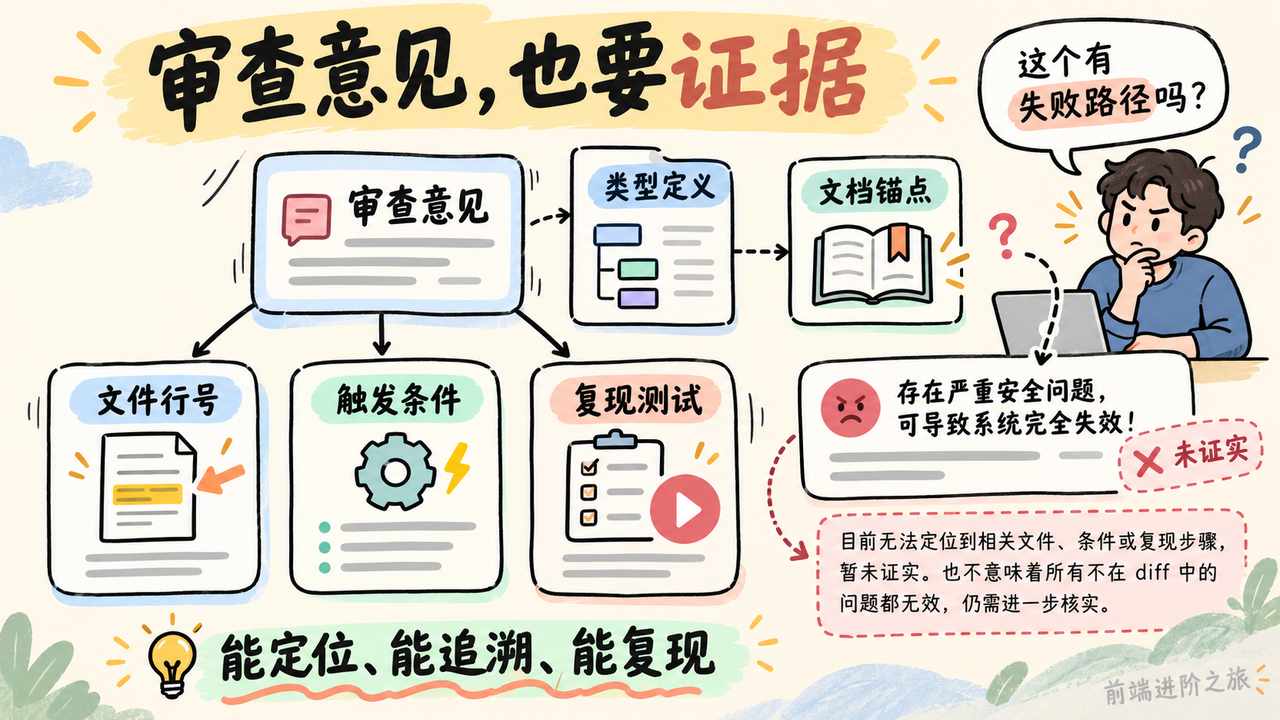
说实话,我更愿意看一条能定位、能复现的问题,也不想看十条措辞严厉却找不到位置的建议。
补丁定位校验文章讨论了三种情况。行号存在但落在改动之外,引用了虚构的函数,或者把问题标成高风险却没有复现依据。文中的维护者故事和检查器属于说明性示例,不能当成已经验证过的上游项目成绩。
它提出的办法仍然实用。给模型一份明确的 diff 材料包,让发现返回可解析的位置,再机械检查文件、行号和符号是否存在。
但这里也要留点余地。真实回归可能发生在没有修改的调用方,所以我不会把所有 diff 外发现都扔掉。我会要求它说明,哪一处改动通过什么路径影响了那段旧代码。解释不出来,就先作为一般建议处理。
审查意见也需要证据。
AI 文档可追溯性文章把同样的思路用到了文档上。脚本提取命令帮助、配置和 schema 中的事实,模型负责组织语言,人负责支持周期、弃用日期等承诺。生成段落通过锚点关联事实,CI 检查是否存在无依据的陈述。
这个门禁只能证明能追溯,不能证明解释正确。一个参数确实存在,不代表模型对参数组合的说明就一定成立。
回到这块,前端团队完全可以从组件文档开始。Props 表能否追溯到类型定义,示例是否仍使用当前参数,迁移说明是否引用了已经删除的选项。比起要求模型每次都牢记整个仓库,这种约束更具体。
Sphinx 的上线前问答补上了人的理解。它通过 Git hook 在受保护的推送环节提问,根据 diff 追问异常情况下的行为。素材里的支付示例很典型,事件 ID 先保存、扣款后执行,能防止某些重复处理,却可能在扣款失败后让后续重试直接跳过。
这种工具我愿意试,但不会拿答对问题替代测试。会解释一段代码,和证明它在并发、超时下正确,是两件事。
今天可以拿最近一个 AI 编程 PR 做对照。要求模型为每条发现返回文件位置、触发条件和验证方法,再人工检查这些依据是否成立;同时让提交者解释一个失败路径。半天就能看出来,团队缺的是缺陷检测,还是大家已经不太理解自己提交的实现。
四、模型端点没改名,为什么成本和效果还要重新算?
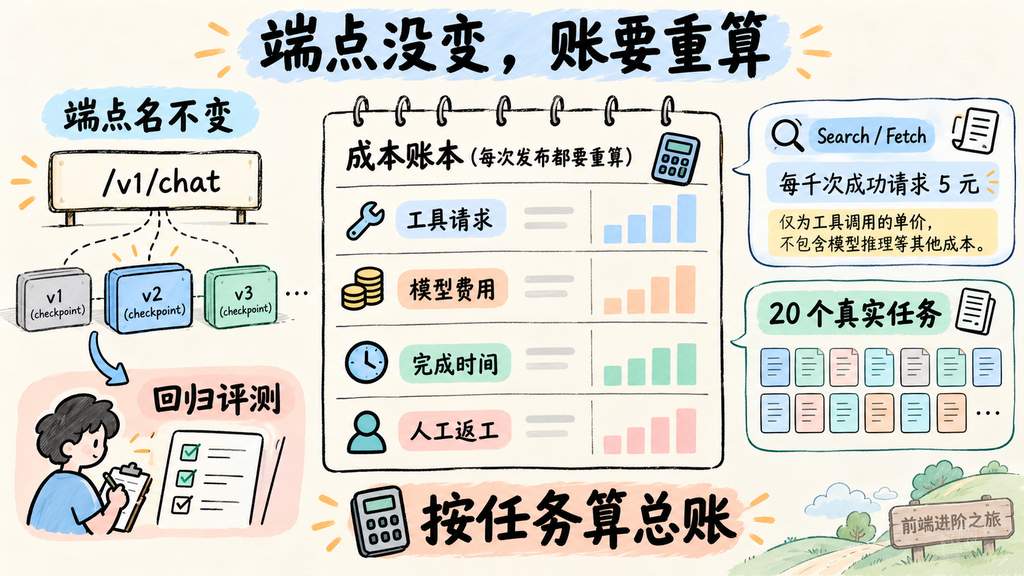
DeepSeek 换模分析文章称,10 月 17 日 deepseek-flash 背后的模型检查点发生了变化,端点名和价格保持不变。文章引用了厂商公布的基准提升,也尝试从模型配置和权重文件大小核查缓存相关说法。
我的读法是,把厂商成绩和作者能自行核算的部分分开看。配置能帮助分析某些内存开销,却不能直接推出你的 Agent 成功率;厂商榜单上涨,也不能直接推出你的接口延迟会下降。
端点字符串没有变,回归评测还是得跑。
再看 DeepSeek Search / Fetch 收费报道。Search 返回结构化搜索结果,Fetch 返回网页标题和 Markdown 正文,报道列出的单价均为每千次成功请求 5 元。现有服务端工具调用将从北京时间 2026 年 11 月 1 日零时开始计费。
按这个单价算,十万次成功请求就是 500 元工具调用费。这里的分母是请求次数,不能把一次 Agent 任务等同于一次请求,也别把这 500 元读成包含模型推理的总账单。
Agent span 台账文章正好接住这个问题。耗时最长的测试工具可能不消耗模型 token,几秒钟的模型调用却可能吃掉大量输入。成本和耗时应该分别排序,还要处理重试、子 Agent 归属和重复记录。
下面这个 JavaScript 示例只做最小归因,把 token 和墙钟耗时分开看。
const spans = [
  { id: "m1", kind: "model", ms: 4000, input: 60000, output: 800 },
  { id: "t1", kind: "test", ms: 180000, input: 0, output: 0 },
  { id: "m2", kind: "model", ms: 9000, input: 4000, output: 1200 },
];

const rows = spans.map((span) => ({
  ...span,
  tokens: span.input + span.output,
}));

const rankedByTokens = [...rows].sort((a, b) => b.tokens - a.tokens);
const rankedByTime = [...rows].sort((a, b) => b.ms - a.ms);

// token 排名只用于定位用量,金额还要区分输入、输出和缓存计价
console.table(rankedByTokens);
console.table(rankedByTime);
最容易误用的是 tokens 这个汇总值,不同类型 token 的价格可能不同,不能直接拿总量当金额。
至于 vLLM 优化 Kimi K3 的报道,423 tok/s/user、性能达到原来的 1.68 倍,都限定在报道中的模型和相同 GB300 NVL72 硬件条件下。它说明内核融合值得研究,不能据此给普通业务服务承诺同样收益。
真要判断换不换模型,我会拿仓库里最近 20 个真实任务,固定权限、工具和验收条件,记录成功率、人工返工、总费用以及完成时间。如果旧检查点已经不可调用,就保留历史结果作为参考,别把两次运行包装成严格对照实验。
五、Agent 总在重复搜仓库,加记忆和改执行框架哪个更有用?
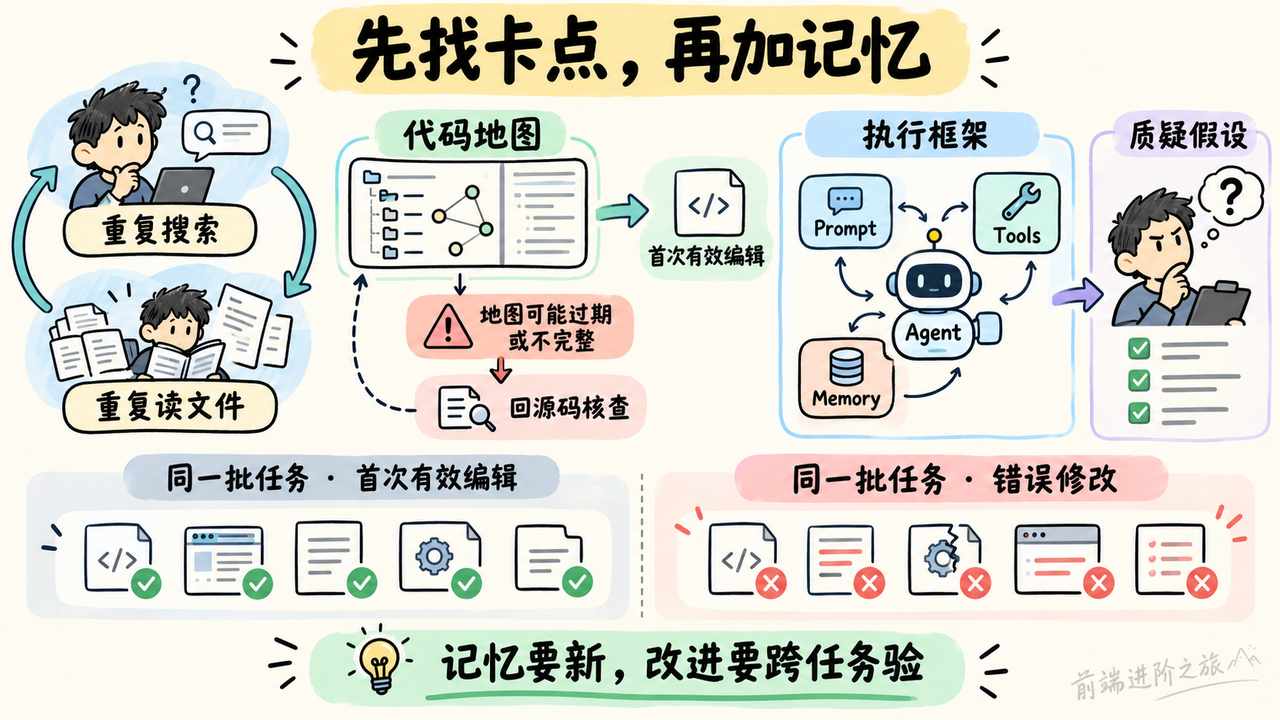
两条路都值得试,我会先看它究竟卡在哪里。
Engram 作者的会话统计覆盖 83 个会话、32,713 次工具调用,其中 31% 属于搜索;按会话中位数,首次编辑前要搜索 24 次,打开文件的操作中有 44% 读的是本会话已经读过的文件。
这个数字得带着样本读。它描述作者自己的使用记录,不能直接代表所有编程 Agent。重复阅读也未必都无效,文件可能刚改过,前一次读取也可能只覆盖部分内容。
Engram 的做法是把代码符号、调用关系、Git 历史和 Agent 活动放进 FalkorDB,在任务开始时给出一份简短定位图。方向我认可,尤其适合长期维护同一个大仓库的场景。但输入里没有接入前后的任务收益对照,所以我只把它当成值得测试的方案,暂时不会认领节省比例。
Harness² 的报道走得更远,让 Agent 调整模型外围的 prompt、工具、记忆和编排等执行组件,模型权重保持不变。
报道中的最佳结果,是 OpenCode 下的 GLM-5 在 WorkBuddy-Bench 上从 64.2 升到 75.7,提高 11.5 个点;较小的提升则是 Codex 下的 GLM-5 在 JobBench 上提高 1.2 个点。两个结果都要留着看,不能只记住最大的那个数。
我更关心的是改进能不能跨任务保留。
为了一个任务调整的规则,可能刚好适合这一题,却让别的任务走偏。仓库记忆也会过期,函数改名、模块搬迁之后,旧定位图可能比没有定位图更耽误事。
多 Agent 独立质疑角色的文章提供了另一个提醒。作者运行 16 种角色的 AI 团队后发现,多次同意可能只是围绕同一个未经验证的假设继续扩写。增加角色数量,并没有自动增加独立证据。
所以我的优先级是,先让错误假设有机会被打断,再让正确经验被记住。独立审查者要能索取测试记录、追问范围变化,而不是把方案换个措辞再赞同一次。
当天可以选五个定位任务,比较普通检索和简短代码地图两种方式,记录首次有效编辑时间与错误修改次数;再加一个地图已过期的任务,看系统能否退回源码核查。记忆有没有用,这样比看定位图写得多漂亮更直接。
六、AI 工作流跑到一半失败,怎么避免从头再来?
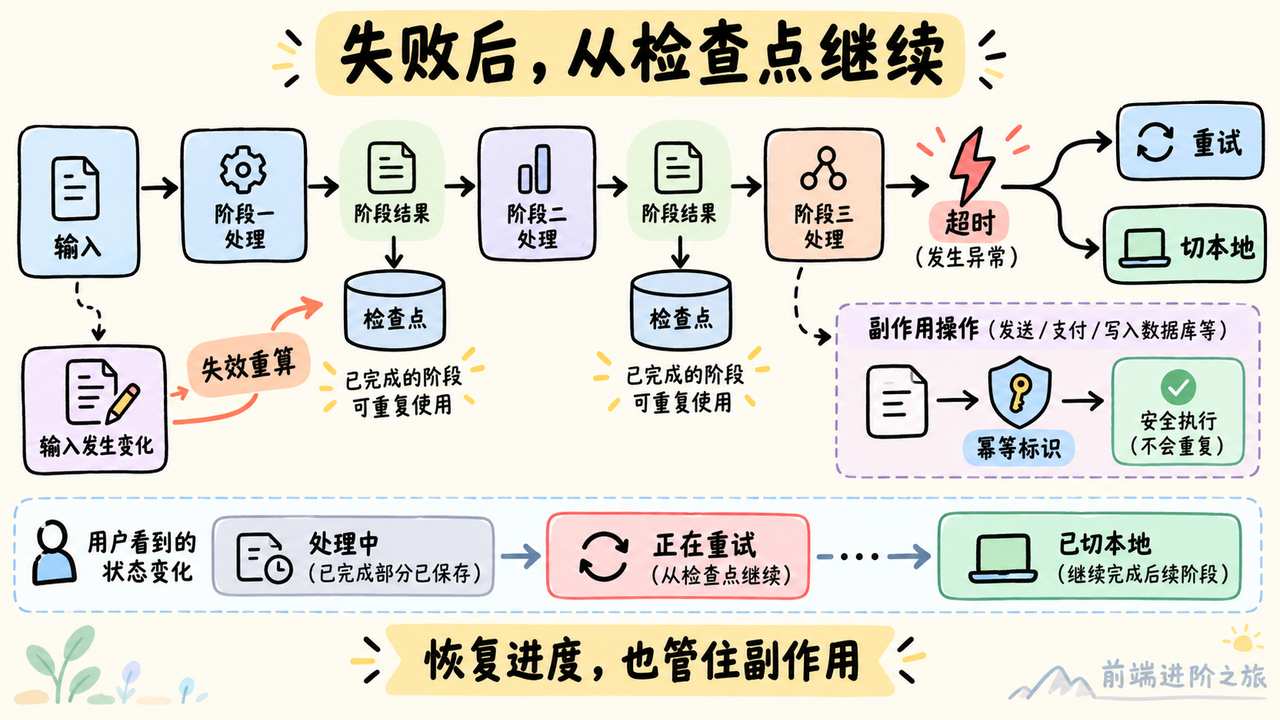
Claude Code 视频工具的实践文章里,我最想借鉴的是阶段结果持久化。作者把转录、片段筛选、人物重构图、字幕和渲染等工作拆成九个阶段,每个阶段可以独立运行,并保存结果。
这对前端做长任务产品很有参考价值。一个页面上只有转圈,用户不知道当前在转录还是渲染;如果所有阶段又绑在一次请求里,末尾失败后,前面完成的工作也难以复用。
不过,保存结果之后还要回答一个问题,哪些输入变化会让结果失效。选段指令变了,旧片段是否还能沿用?字幕样式变了,是否需要重新转录?这些依赖关系如果没写清楚,缓存也可能返回旧结果。
本地优先 Agent 的断网降级文章讨论的是合成故障场景,不是某家团队的事故复盘。它要求明确哪些错误可以重试,什么时候切本地模型,最多等多久,以及如何让用户看见实际回答来源。
超时之后,远程任务不一定停止。
如果本地任务已经开始,远程任务又晚到一步,系统可能收到两个不同结果。文章因此强调幂等标识与重复结果处理。我的补充判断是,涉及发信、付款、写数据库的工具操作,还得单独约束副作用,不能因为回答只展示了一份,就认定操作只执行了一次。
GitLab 五类 Agent 的交付实践也说明,可靠交付需要阶段和门禁。作者让规划、审查、修复、安全和发布 Agent 参与一个小型 Python 服务的流水线,记录了三轮审查和一次 pipeline 竞态,合并仍由人完成。
文中容器扫描发现项从 166 降到 1,是该项目的扫描结果变化,不能拿来等同于真实安全风险下降了相同比例。但候选版本检查、提升生产、失败回滚这些环节,比一句自动发布更能说明系统怎么处理失败。
前端界面也应该把这些状态表达出来。正在重试、已切本地、候选版本检查失败,分别对应不同的用户预期,不能都塞进一个处理中。
今天就可以挑一条现有工作流,在中间阶段注入一次超时,再恢复连接。观察已完成阶段是否重跑、外部操作是否重复、界面能否显示真实状态。如果这三件事还说不清,继续增加 Agent 自主性,多半只会增加排查难度。
总结
这批素材里,有明确条件的结果,也有作者经验和说明性方案。GitLab 的扫描数量来自作者披露的项目记录,退款行为来自拦截全部外发操作的模拟实验,Harness² 的提升来自报道列出的特定模型、框架和基准组合。这些边界要和数字一起记住。
我的判断是,AI 编程接下来最容易拉开差距的地方,会是任务之间如何隔离、工具权限如何执行,以及完成声明如何验收。它们听起来没有新模型热闹,却直接决定团队能不能放心增加并行度。
仓库记忆能省多少时间,执行框架优化能否迁移到自己的任务,内核优化能否降低实际账单,这些还得自己测。我的选择是先保留一组真实任务和完整记录,让每次改动都能回答,究竟省了什么,又多付出了什么。
代码可以交给 Agent 多写一点,对代码的理解和结果的责任,还是得有人接住。
参考
- 多 Agent 并行开发,数据库也要隔离|dev.to
- 从合并记录推断分支,让编程 Agent 自助选路|dev.to
- 退款模拟测试暴露智能体越权与消息轰炸|IT之家
- 腾讯为智能体提供独立邮箱与命令行接口|dev.to
- AI 生成应用的数据库权限排查|dev.to
- 给模型审查意见加一道补丁定位校验|dev.to
- 给 AI 文档加一道可追溯性检查|dev.to
- Sphinx 用上线前问答检查代码理解|Sphinx
- DeepSeek 端点换模后的缓存成本核算|dev.to
- DeepSeek 搜索抓取接口公布按次收费|IT之家
- 拆开统计 Agent 的耗时与令牌开销|dev.to
- vLLM 内核融合让 Kimi K3 推理提速|IT之家
- 给编程 Agent 建代码图谱,减少重复搜索|dev.to
- 谷歌开源可在测试时改写执行框架的 Harness²|MarkTechPost
- 多智能体协作需要一个专门质疑的角色|dev.to
- 用 Claude Code 搭建按指令选段的视频工具|dev.to
- 为本地优先 Agent 定义断网降级契约|dev.to
- GitLab 五类 Agent 接手交付流水线实测|dev.to
- 前端进阶之旅