
一个月部署超过 7.3 万次,Agent 写的代码 5 分钟就能上线,这是 Vercel 给 Rogo 案例摆出的数字。同一批资讯里,另一位开发者还在解决一个朴素的问题,Agent 已经崩了,看板却一直显示正在工作。把这两件事放在一起,2026 年 10 月 2 日这期 AI 热点就有了很具体的切口。AI 编程跑得越来越快,我们判断它有没有做对的办法,跟上了吗?今天聊六条线,从桌面操作、上线验收到上下文和模型成本,看看程序员该先试什么、哪些结论还不能照单全收。
一、AI 编程工具能操作桌面了,MCP 和直接点击该怎么选?
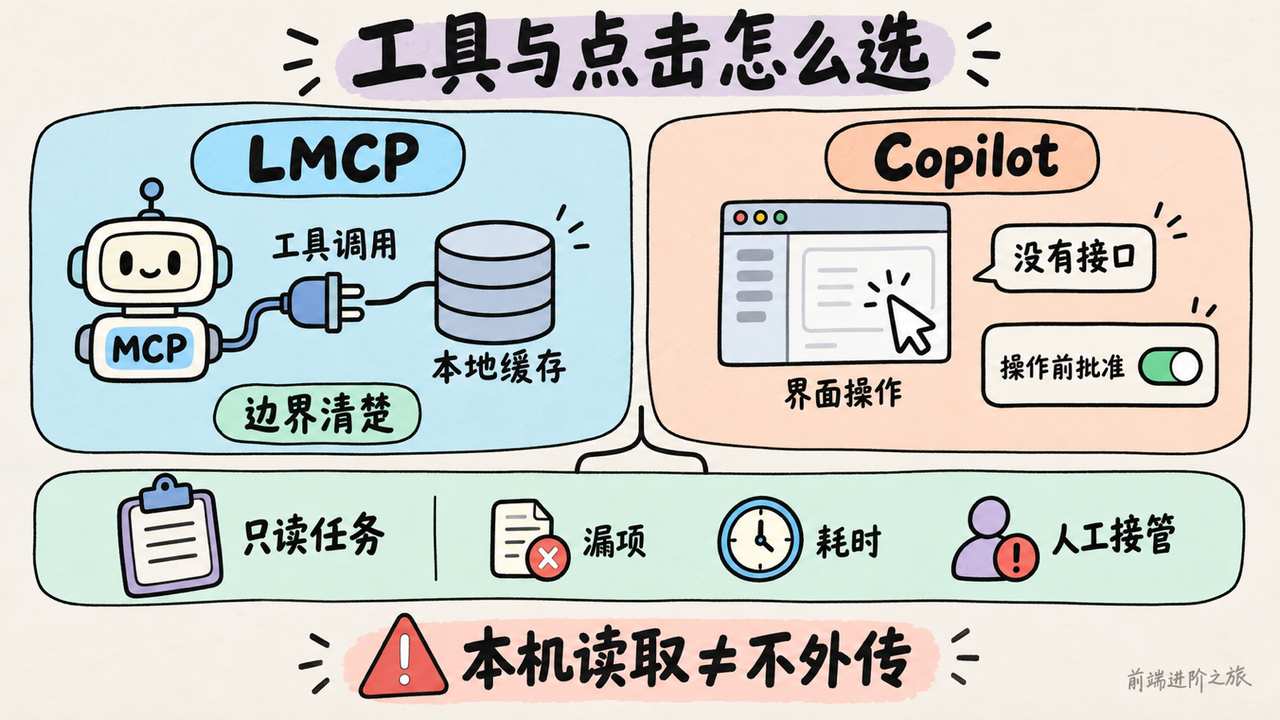
先说结论,我会先接边界清楚的工具调用,再考虑把整套桌面操作交给 Agent。
LMCP 和 GitHub Copilot 把这两条路线摆到了眼前。前者把 Mac 上已有的应用能力接入 MCP,后者让 Agent 直接读取界面、点击控件、输入文本和跨应用操作。对于那些每天在浏览器、邮件、表格之间搬数据的人,这比多补全几行代码更接近 AI 办公提效的实际需求。
但它们解决问题的方式不同。
按照作者介绍,LMCP 提供的是 190 多个工具,不是已经逐个验证过的 190 多款应用。 它优先利用本机应用已有的数据,比如读取 Teams 的磁盘缓存,省去通过 Microsoft Graph 集成时的部分配置步骤。浏览器工具还能复用已有登录状态,适合串起查资料、整理数据和填写表格这样的流程。LMCP 作者介绍
这里有个坑。工具在本机运行,不代表读取的内容只留在本机。作者明确提醒,AI 提供商仍然能看到你让它读取的内容。把云端 API 换成本地缓存,解决的是接入路径,不能直接推导出整条数据链都没有外传。
Copilot 的计算机操控则覆盖了另一类难题。软件没有 API,没有 CLI,也没有 MCP 集成,那就从界面操作。GitHub 在 10 月 1 日的更新中宣布,这项能力面向 macOS 和 Windows 公开预览,支持 Copilot CLI 和 Copilot 应用,操作应用前会请求批准,组织设置也可以禁用。GitHub Copilot 更新日志
我的取舍很直接。能通过明确的工具参数完成的工作,通常更容易记录输入、检查输出;只能点界面的旧系统,计算机操控才特别有价值。但公开预览不等于你的报销系统、内部后台和各种弹窗都已经跑通。
回到这块,前端团队可以从自己熟悉的后台页面入手。选一个只读任务,比如提取测试环境里十条订单的状态,分别走工具读取和界面操作,记录漏项、耗时、人工接管次数。再插入一次登录过期或空列表,看看 Agent 会停下来说明情况,还是继续往下猜。这个结果比一段顺利完成的演示更有参考价值。
二、Agent 写的代码五分钟上线,怎么证明它真的做完了?
Rogo 案例最抓眼球的是速度。Vercel 的介绍称,团队每月部署超过 73,000 次,Agent 编写的代码可以在 5 分钟内上线生产,并通过 AI SDK 上的 Agent Swarm 自动分诊和修复生产事故。Vercel 客户案例
说实话,单看这个数,我不会马上拿它当团队目标。
一次部署包含多少改动?有多少属于预览、重试或生产变更?自动修复覆盖哪些事故?给出的介绍没有把这些口径展开。它说明这家公司把自动化交付推得很远,却不足以证明别人照着部署次数做,就会获得相同收益。
部署次数是吞吐量,验收通过才是交付结果。
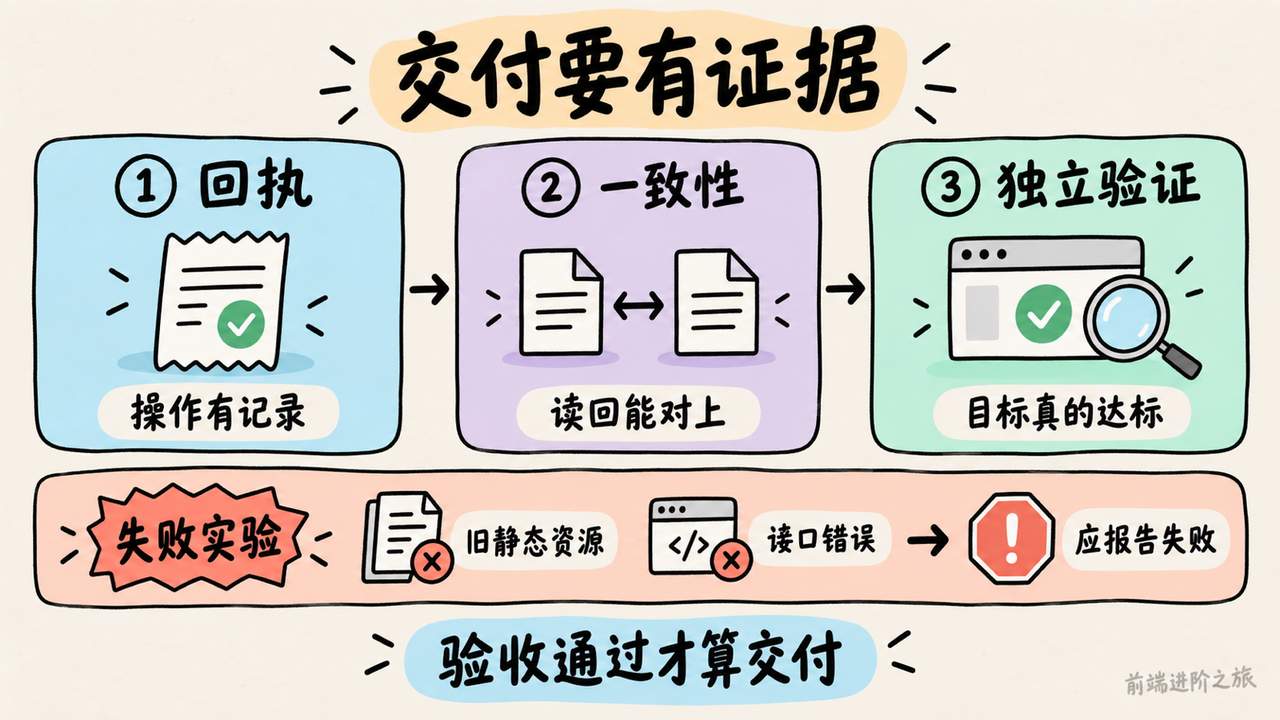
另一篇关于 Agent 验证的文章,正好补上了这个问题。作者区分了回执是否存在、读回内容是否一致,以及证据是否来自足够独立的来源。一个操作自己生成回执,再自己读取回执,可以证明流程内部对得上,却未必证明目标系统真的达到要求。验证方式分析
放到前端发布里,这事很好理解。构建日志显示成功,不能直接证明用户访问到新页面;页面返回 200,也不能证明缓存已经更新;Agent 说改好了按钮,更不能替代一次真实交互检查。
同源读回当然有用。它能发现写入失败、序列化错误和字段丢失。问题在于,你要知道它检查到了哪一层,别把文件一致性当成业务正确性。
模型替换测试的案例更有意思。作者原本希望测试「在模型 A 上认证、换模型 B 运行」是否会被拒绝,结果没有先完成认证就提交运行,拿到了 201。他一度以为防线失效,后来发现测试根本没建立要检验的前提。补上认证,再替换模型,才得到预期的 403。模型身份测试复盘
所以,验收脚本也得接受检查。
对技术管理者来说,我更愿意把预算花在可重复的验收上,而不是继续压低生成第一版代码的时间。生成快了十分钟,人工排查多花一小时,这笔账不划算。
当天就能做一个小实验。拿测试环境的一次页面改动,故意保留旧静态资源,或者让关键接口返回错误,然后照常运行 Agent 的验收流程。如果它仍然报告完成,先修验收条件。只有失败真的会被发现,五分钟上线才有讨论价值。
三、CLAUDE.md 越写越长,跨工具共享记忆能救回来吗?
大概率你也遇到过,把项目背景、接口约定、历史坑点都塞进说明文件,原本想减少反复解释,后来却发现 AI 开始拿旧规则改新代码。
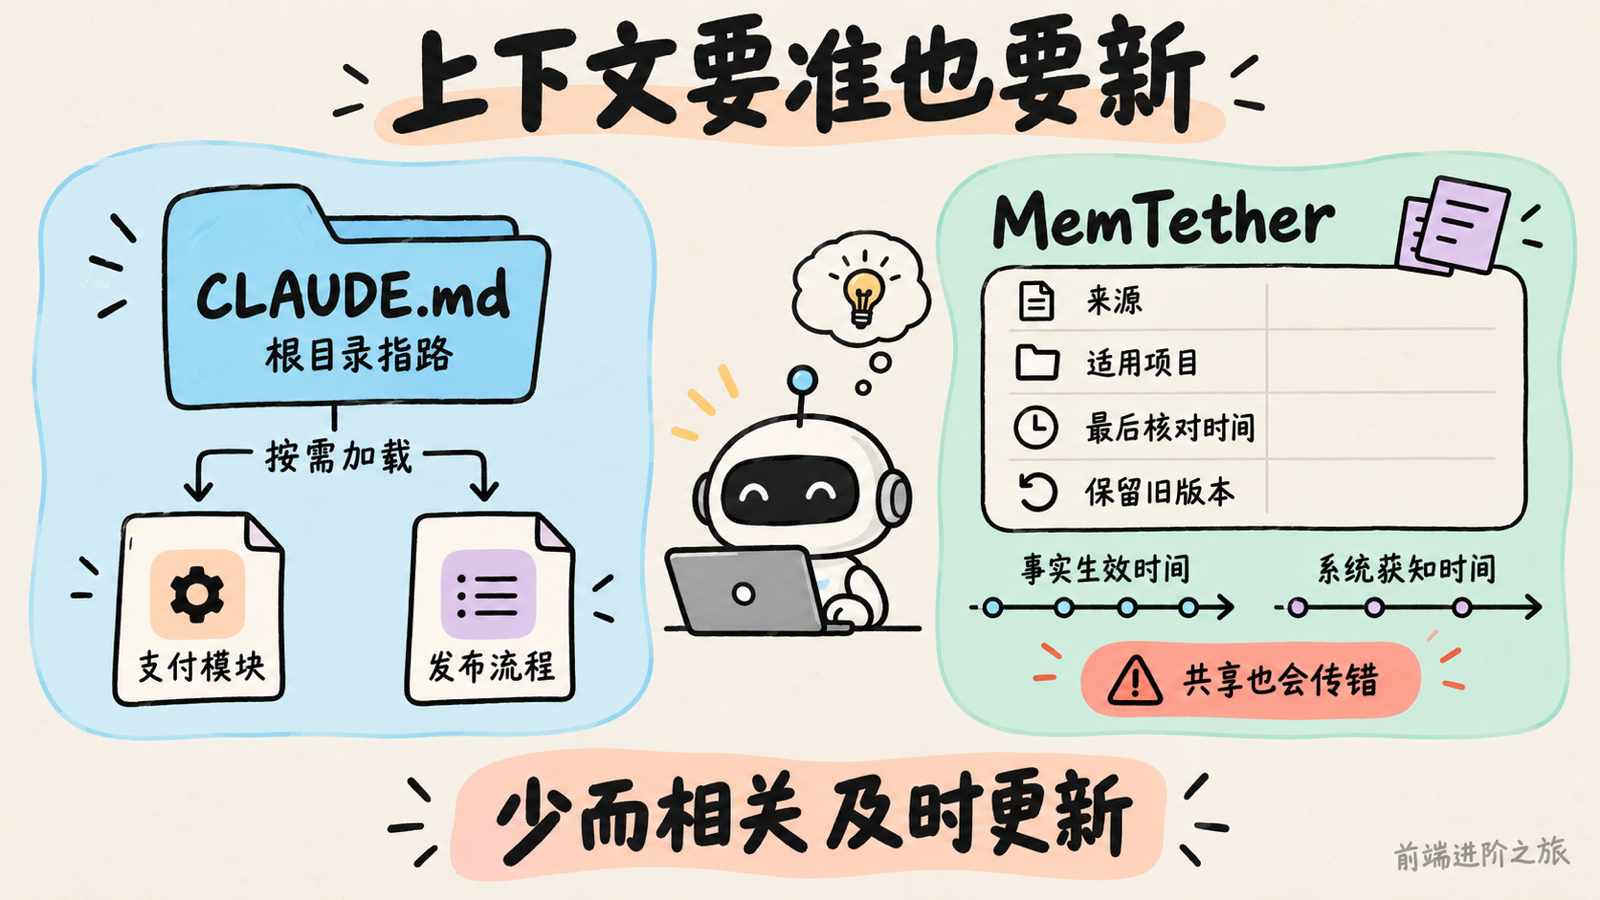
上下文工程那篇文章给出了四个方向。保留引用、按需加载、少而相关、及时更新。作者描述的团队里,一个根目录 CLAUDE.md 大约 238 行,修改某个子系统的测试时,也会带入相邻系统的 schema、配置和迁移笔记。Agent 上下文工程
238 行不是通用警戒线。真正的问题是,这次任务用得上的信息到底占多少,以及其中多少还是真的。
要我选,我会让根目录文件负责指路。支付模块的规则放支付目录,发布流程放对应文档,当前任务需要时再读。团队共享的说明也得有人维护,否则所谓长期记忆,很容易变成长期误导。
MemTether 则处理了另一个烦恼。Claude Code、Cursor、Windsurf 各记各的,切换工具就得重新解释。作者用一个本地 SQLite 数据库,让 23 多款客户端共享记忆,同时保留旧版本,将被更新的记录标记为已覆写。MemTether 作者介绍
这个方案里,我更看重的不是接了多少客户端,而是它区分了事实生效时间和系统获知时间。
比如某项接口规则周一变了,周三才有人更新记忆。你要追查周二为什么生成了旧实现,就得知道当时系统掌握的是哪版规则。直接用新记录覆盖旧记录,追查时很容易误判。
共享记忆也会共享错误。
如果错误规则被多个客户端同时读到,重复解释少了,错误传播却快了。MemTether 描述的使用频率排序也有边界,一条老规则经常被检索,不代表它今天仍然有效。因此,我会把来源、适用项目、最后核对时间放在记忆旁边,再考虑检索排序。
顺着上面聊,上下文优化的成本收益不能只看 token 下降。删得太狠,Agent 会重复搜索,甚至漏掉真正必要的约束。今天就能拿一个跨模块修改任务,分别用现有大文件和目录索引运行,固定模型与验收要求,比较读取量、补查次数和错误引用。再埋一条明确过期的规则,看它能不能识别。省下来的输入,得没有换成返工才算数。
四、Agent 一直显示运行中,权限和健康状态该怎么管?
企业 AI 编程难落地,有时不是模型能力差,而是它借用了人的整套访问权限。
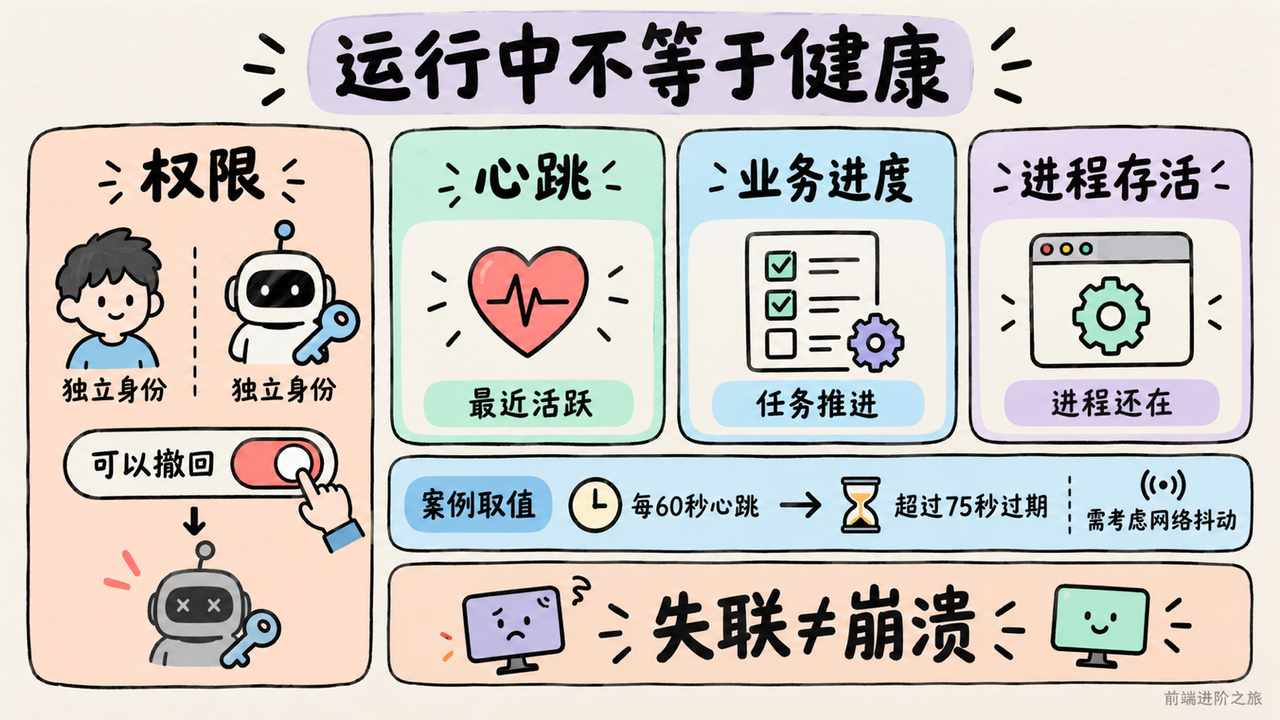
一篇 AWS 威胁模型文章把这个问题讲得很直白。人和 Agent 使用同一份云会话时,权限系统看到的是同一个身份,很难仅凭身份判断某次操作到底来自工程师,还是来自模型的一次尝试。作者主张把防护分层,而不是把安全寄托在模型永远判断正确上。企业 Agent 威胁模型
对于做全栈或内部平台的同学,这会影响凭证怎么发、日志怎么记、出了问题能不能单独停止某个 Agent。让它拥有真实环境的访问能力,不必等于复制一份开发者的全部权限。
运行状态也有相似的问题。Agent 启动时写入 working,结束时写入 done,看起来够用了。但如果它中途崩溃,结束状态永远写不回来。
ticket-tracker 的作者用独立心跳记录解决这个显示问题。orchestrator 每 60 秒发送一次心跳,当 working 状态距离上次心跳超过 75 秒,界面就显示异常。这里不是完全不存数据,而是存最后一次心跳,在读取时计算健康状态。Agent 心跳设计
下面这段 JavaScript 演示了如何让过期的 working 记录失去正常运行的显示状态,同时注入一个超时样本。
const staleAfterMs = 75_000;

function deriveHealth(record, now) {
  if (!record) return 'unknown';
  if (record.state !== 'working') return record.state;

  // 超时只说明失联,不能直接断言进程已经崩溃
  return now - record.lastBeatAt > staleAfterMs
    ? 'stale'
    : 'working';
}

const record = { state: 'working', lastBeatAt: 0 };
console.assert(deriveHealth(record, 60_000) === 'working');
console.assert(deriveHealth(record, 76_000) === 'stale');
最容易翻车的是时间差判断那一行,生产环境要统一时间口径,而且界面需要定时重算,否则没有新事件时,旧的绿色状态仍然不会变。
你要是也在做 Agent 看板,还得多问一句,心跳证明谁还活着?如果 orchestrator 自己还在发消息,底下的任务却早已卡死,持续收到心跳也不能证明任务有进展。最后活跃时间、业务进度和进程存活,是三个不同问题。
60 秒与 75 秒也只是这个项目的取值。中间只有 15 秒余量,调度延迟和网络抖动都可能触发过期,不能照抄后就当故障判定。
我的建议是把这些边界直接做成失败实验。在测试环境暂停一次心跳,再让任务停住但保留调度器运行,观察界面是否能分清失联与无进展;同时撤掉 Agent 的测试凭证,确认后续操作确实失败,而不只是聊天窗口里说自己已经停止。
五、Agent 成本太高,换小模型还是加模型路由?
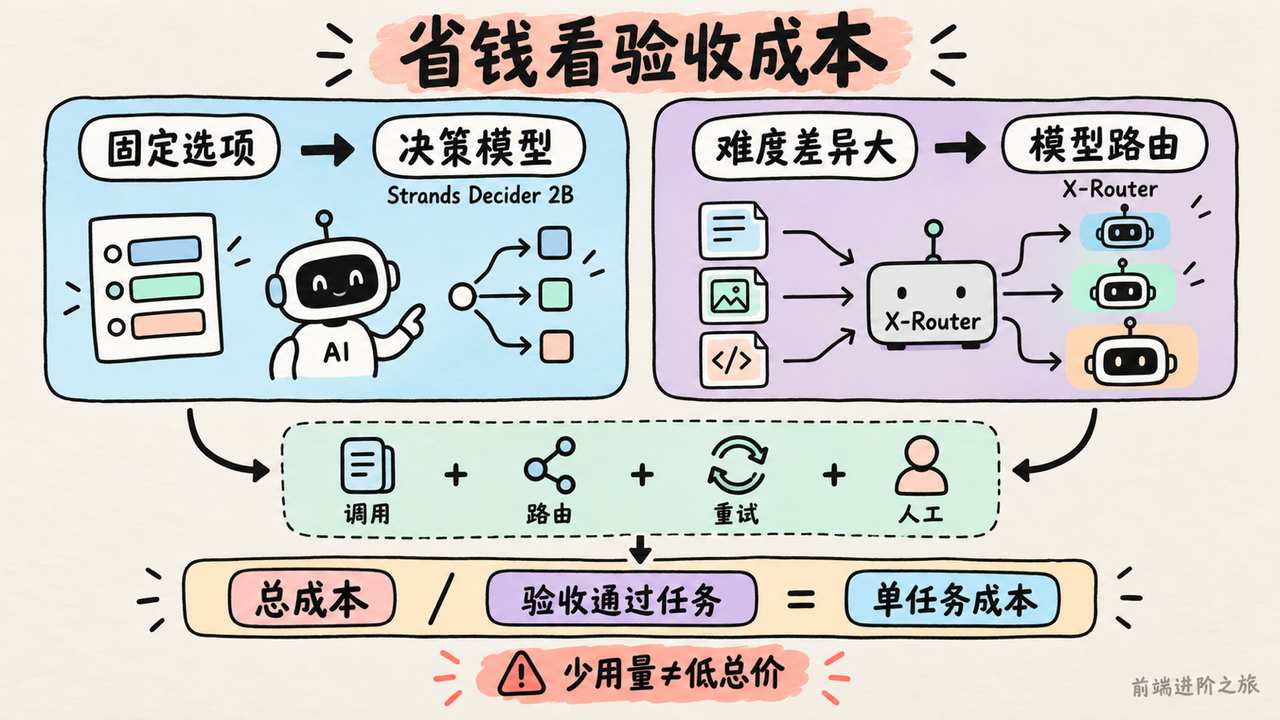
不是每一次模型调用都需要生成一大段文字。把工单分给哪个队列、从几个工具里选一个、判断是否需要升级处理,这些任务最后常常只消费一个选项。
这也是决策模型值得程序员关注的原因。
MarkTechPost 对 Strands Decider 2B 的介绍称,它基于 Qwen3.5-2B-Base,约 19 亿参数,用指针头替代语言建模头,通过一次前向传播给出选择或评分,不需要逐 token 生成答案。报道列出的 RTX 3090 延迟为中位数 115ms、p95 299ms。Strands Decider 2B 报道
115ms 得跟硬件和测试口径一起读。它不是你的服务端到端耗时,更不是所有任务的响应保证。同一份报道里,公开基准准确率是 167/231,约 0.723,困难任务准确率为 0.505。拿来做低风险路由可以研究,直接让它独立决定高风险操作,我不太买账。
Cloudflare 的 Clef 走的是另一档配置。按照 IT之家的报道,Clef 与 Clef-flash 分别使用 Qwen3.8-27B 和 Qwen3.5-9B 作为基座,支持视觉输入,兼容 Jev-API,并提供面向业务的强化学习定制路径。Clef 报道
接口兼容省的是接入工作,不能保证同一批业务问题答得一样。
Jev 开源替代方案的文章恰好给了一个提醒。Laya 虽然获得不少关注,但作者指出其基础 checkpoint 的零样本表现接近随机,更适合作为微调起点。其他项目也各有侧重,有的是适配器,有的是训练器,有的面向特定控制任务,不能因为都贴着决策模型标签就直接替换。Jev 开源方案比较
另一种省钱方式是路由。量子位介绍的 openJiuwen X-Router,会根据任务和反馈动态选择模型,报道给出的 Agent 场景结果是 token 消耗降低超过 50%。X-Router 报道
这个数字我会先当候选线索。具体任务怎么组成、成功率有没有变化、路由本身花了多少、失败后重试几轮,都影响最后的账单。token 少一半,也不自动等于钱少一半,候选模型的单价可能不同。
真正该比较的是每个验收通过任务的总成本。
如果输出只需要几个固定选项,我会先试决策模型;如果任务难度差异很大,再研究模型路由。当天可以从已有工单里抽出 30 条带人工答案的样本,把模糊任务也放进去,比较现有模型与候选方案的正确率、延迟和重试成本。这点样本不足以宣布选型成功,但足够筛掉明显不合适的方向。
六、本地 AI 要买工作站吗,业务规则能不能先少交给模型一点?
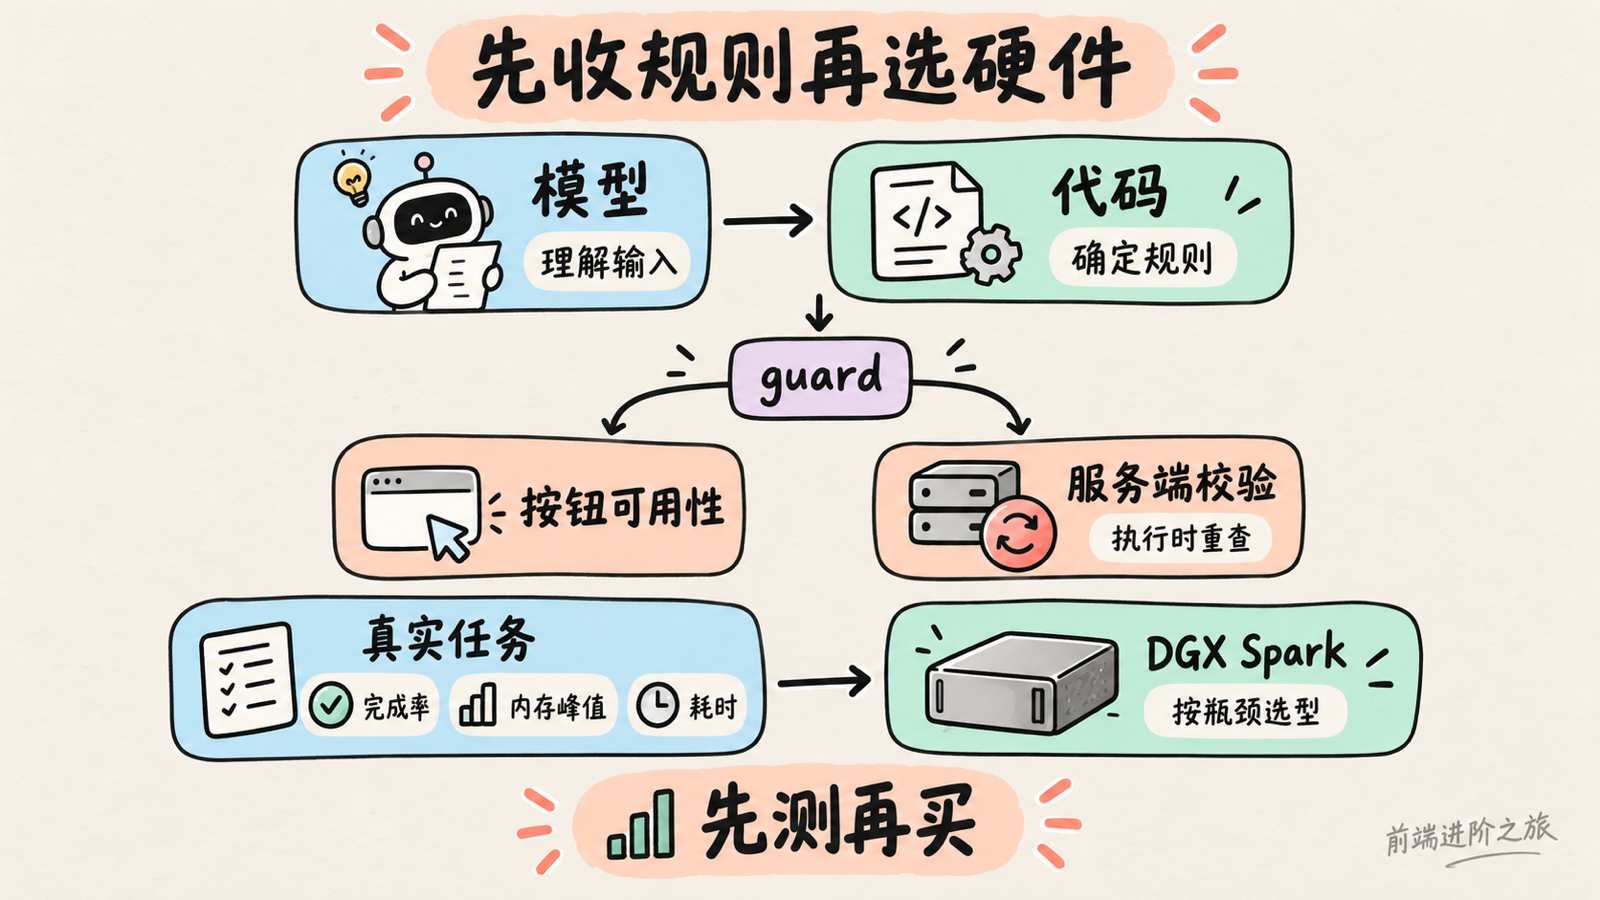
DGX Spark 的新配置很容易让人产生一个念头,要不把 Agent 全搬到本地?
先把发售时间说准。NVIDIA 的介绍是 64GB 配置将在本月晚些时候通过合作伙伴提供;IT之家的报道给出的日期是 10 月 23 日,起售价 4,999 美元。按这期日报的 10 月 2 日来算,还不能写成已经开售。NVIDIA 产品介绍 DGX Spark 更新报道
硬件之外,更有用的信息是软件与组网。官方介绍了 ConnectX-7 网络、Cluster Assistant,以及对常见推理运行时的支持。两台 64GB 设备运行 Qwen3.8-27B 时,官方测试给出的性能提升最高为 1.7 倍。
这是特定模型和测试条件下的结果。不能据此推算四台一定快四倍,也不能只看统一内存容量,就断言某个长上下文任务能流畅完成。
另一端是 MINICODE。作者用 Ollama 和 Qwen3 1.7B 构建终端编程助手,让小模型通过文件操作、命令执行和上下文循环完成任务,并在潜在危险操作前请求确认。MINICODE 作者介绍
它展示了轻量实验的入口,但作者没有给出可与大型编码模型横向比较的任务成功率。我的读法是,可以拿来研究工具循环,暂时别把它当作团队编程能力的等价替代。
回到业务代码,还有一类成本压根不需要换模型解决。确定性的规则,留在代码里就行。
状态机那篇文章举了订单发货的例子。同样是已付款,有的地址支持配送,有的不支持。如果只在执行函数里加检查,页面的可用操作列表仍然可能显示发货按钮。作者将条件归入对应转换,让展示与执行共享判断。状态机 guard 设计
下面这个 JavaScript 示例让按钮可用性与发货动作使用同一条规则,地址只是沿用原文的演示标签。
const shipRule = {
  from: 'paid',
  to: 'shipped',
  guard: order => ['Istanbul', 'Izmir'].includes(order.address),
};

function canShip(order) {
  return order.status === shipRule.from && shipRule.guard(order);
}

function ship(order) {
  // 执行时重新检查,不能信任先前显示的按钮状态
  if (!canShip(order)) throw new Error('当前订单不允许发货');
  return { ...order, status: shipRule.to };
}

const order = { status: 'paid', address: 'unsupported' };
console.assert(canShip(order) === false);
最容易翻车的是把 canShip 只放在前端,服务端执行时仍要基于最新数据检查权限和业务条件;共享规则的思路不能替代服务端校验。
这件事和选本地模型有什么关系?如果确定规则、状态转换、参数校验都要问模型,买更强的机器只是在替多余的调用付费。让模型处理需要理解的输入,让代码执行明确的约束,剩下的任务规模才是硬件选型该面对的规模。
真要判断要不要买,我会先拿十个真实任务,在现有设备上测完成率、内存峰值和耗时,再统计其中多少步骤可以用确定规则替代。先知道瓶颈在哪,再看工作站配置,花钱会踏实得多。
总结
这期能从给出的原文直接确认的是,GitHub 宣布了桌面操控公开预览,LMCP 作者介绍了本地应用接入方式,NVIDIA 公布了 DGX Spark 新配置。Rogo 的部署量属于厂商客户案例里的报告,决策模型的准确率和延迟也各自带着测试条件,不能混成一张通用能力排行榜。
我的判断是,AI 编程接下来最费工程功夫的地方,会是接入真实工作流之后的那一段。数据有没有读对,权限能不能收回,任务卡住能不能发现,验收会不会被自己生成的证据糊弄。这些问题都很像我们平时写业务系统时处理的问题,只是现在多了一个会自行选择下一步的执行者。
我还不会据此认定桌面 Agent 已经稳定、决策小模型可以普遍替换大模型,或者模型路由一定能让账单减半。这些都得放回自己的任务里跑。
如果今天只留时间试一件事,我会挑一个有明确正确答案的小流程,故意塞进一次失败。看它能不能发现、能不能停、能不能把原因讲清楚。对真正要交付的团队来说,这比又看完一个流畅演示更有用。
参考
- LMCP:让 AI 使用 Mac 应用|dev.to
- GitHub Copilot 桌面操控公开预览|GitHub Changelog
- Rogo 如何将 Agent 代码快速上线|Vercel Blog
- 回执、一致性与独立验证|dev.to
- 模型替换安全测试复盘|dev.to
- Agent 上下文工程四原则|dev.to
- 跨客户端记忆中枢 MemTether|dev.to
- 企业 Agent 的威胁模型与身份问题|dev.to
- 通过心跳派生 Agent 健康状态|dev.to
- Strands Decider 2B 决策模型|MarkTechPost
- Cloudflare 推出 Clef 决策模型|IT之家
- 五款 Jev 开源替代方案|dev.to
- openJiuwen X-Router 模型路由|量子位
- DGX Spark 64GB 与集群扩展|NVIDIA Blog
- DGX Spark 配置与软件生态更新|IT之家
- 使用 1.7B 模型构建 MINICODE|dev.to
- 用 guard 让业务数据参与状态转换|dev.to
- 前端进阶之旅