
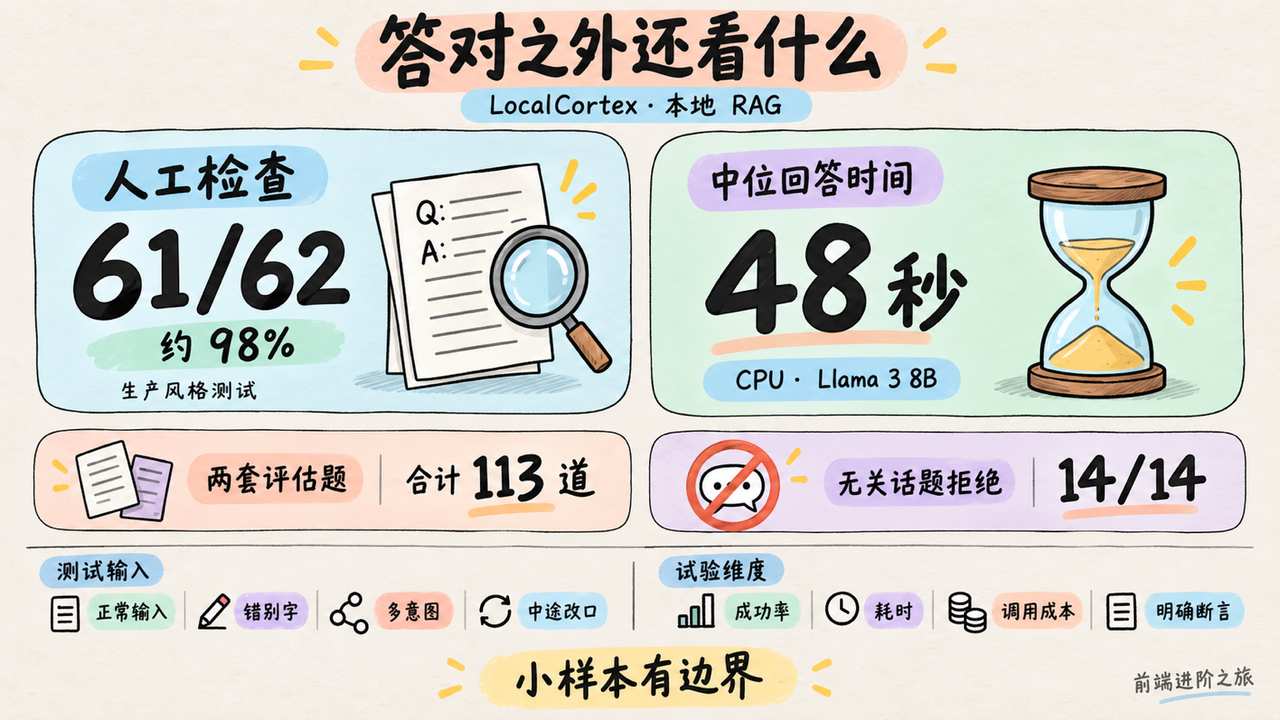
61 道题答对了,剩下 1 道答错,准确率约 98%。看着像个可以交付的知识库,结果每次回答的中位耗时是 48 秒。这是今天读到的本地 RAG 实验里,我最想留给同事看的反差。模型能答对,用户却未必愿意等;Agent 能改代码,团队也未必敢合并。2026 年 10 月 5 日这期 AI 热点,我们沿着研发自动化、上下文、评估、仓库规范、任务恢复和权限六条线,聊聊程序员该把时间花在哪里。
一、AI 开始参与研发下一代 AI,程序员该看哪些效率指标?
先说结论,我会关注 AI 研发自动化的进展,但不会拿「智能爆炸」给团队排下季度的交付计划。
量子位介绍的 Hinton 等人论文,讨论的是 AI 研发自动化是否可能触发智能爆炸。这里的 RSI 指递归自我改进。研究关心的反馈链条是,AI 参与研发,更好的 AI 又加速下一轮研发,循环会不会越来越快。量子位提到的「一年进步压缩到约 5 周」,属于极端情形下的推演,不能读成实验室已经交付的成绩。
同一篇报道转述,某头部实验室 AI 生成的获批代码比例,从 2025 年初的低个位数升到 2026 年 5 月的 80% 以上。这个变化足够大,但「获批代码有多少由 AI 生成」和「多少研究由 AI 独立完成」是两个分母。研究方向、实验设计、结果解释,不能用代码占比一笔带过。
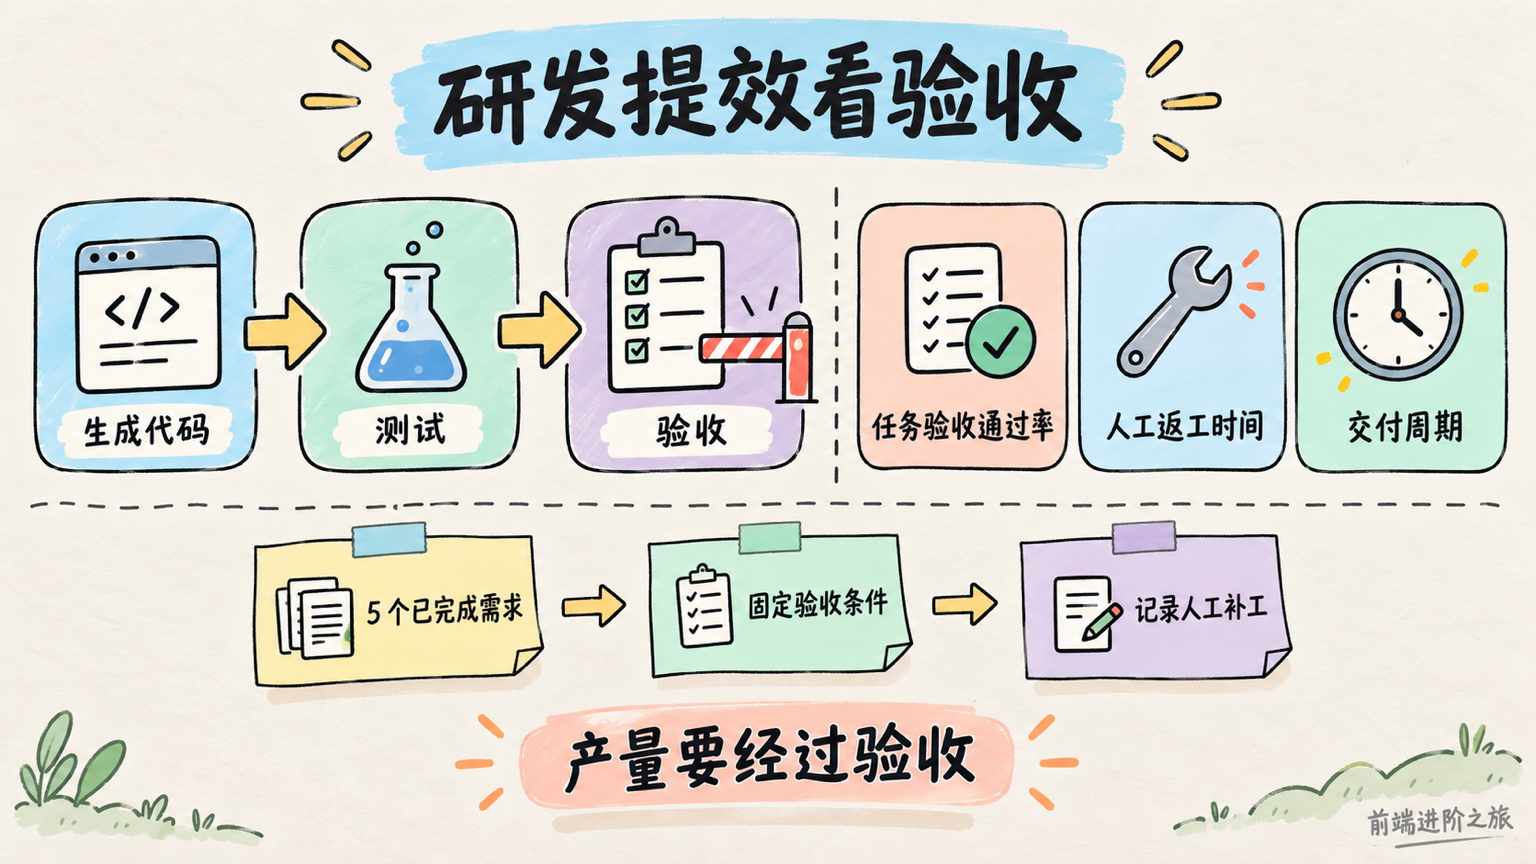
代码产量离研发产出,中间还隔着验收。
这点放到业务开发里更直观。gstack 仓库展示了一套围绕 Claude Code 的角色化工作流,覆盖设计、工程管理、QA、发布等环节。作者还给出了自己的代码变更速度对比。
说实话,我对拿「逻辑行数」比较多年生产率持保留意见。即使排除了部分代码膨胀,不同年份的项目、基础设施和工作内容也不一样。个人记录可以解释作者为什么喜欢这套工作流,不能直接换算成我们团队能少招多少人。
不过,这两条放在一起有个具体启发。AI 编程的价值正在延伸到整条研发流程,生成代码只是其中一站。对前端来说,一个需求还要经过接口对齐、交互实现、异常状态、测试和上线检查;任何一站返工,都可能吃掉前面省下的时间。
回到这块,技术管理者真正该追的是任务验收通过率、人工返工时间和交付周期。我会拿最近 5 个已完成的小需求,让 Agent 在独立分支重做,固定验收条件,记录它交出了什么、还要人补多少。一天里的小实验算不出全年收益,但足够识别「代码写得快,审核更累」的情况。
二、上下文压缩 16 倍,RAG 成本真能降到十六分之一吗?
长上下文确实诱人。需求文档、接口定义、历史讨论一股脑塞进去,似乎就能少解释很多遍。问题是,上下文越长,里面真正有用的信息未必越多。
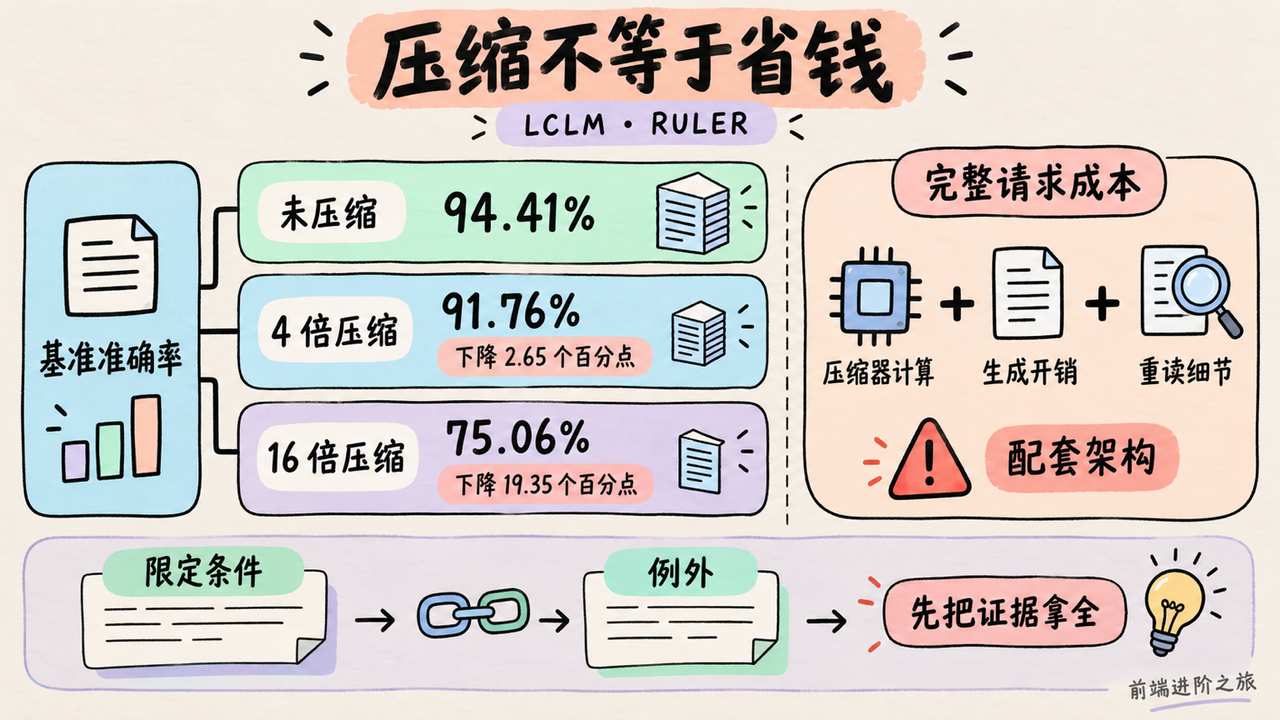
LCLM 的技术介绍给出了一条路线,由 encoder 先把输入压缩成潜在表示,再交给 decoder。文章报告,在 RULER 基准上,4 倍压缩的准确率为 91.76%,未压缩为 94.41%;16 倍压缩时为 75.06%。
数字要一起读。
4 倍压缩损失了 2.65 个百分点;到 16 倍,和未压缩结果已经差了 19.35 个百分点。更高压缩比能装下更多上下文,但细节任务是否扛得住,需要另外看。
文章还描述了百万 token 输入在单张 H200 上的内存表现。这是特定模型和运行条件下的结果,不能直接换算成线上 API 账单减少 93.75%。压缩器要计算,decoder 要生成,应用还可能需要重新读取细节。输入表示缩短多少,与完整请求便宜多少,不是一张表里的同一列。
这里有个坑,文章把集成描述得很轻松,好像在现有 RAG 前面加一个压缩器就行。但它介绍的是配套的 encoder-decoder 架构,不能据此推断,任意现成聊天 API 都能接收这些潜在向量。
另一篇RAG 检索排错文章提醒了更靠前的问题。文档切块之后,答案依赖的条件和例外可能分开,检索只带回其中一部分,后面的模型只能基于不完整材料作答。
我认同先检查检索结果,但不认同把几乎所有错误都归给检索。那篇文章用简化流程解释问题,不能把所有 RAG 都理解成只取一个片段,也不能排除生成阶段出错。
上下文装得下,不等于证据拿得全。
你要是也在做文档问答,今天就能挑 10 个必须结合两处原文才能回答的问题,把实际送给模型的片段保存下来。先检查限定条件有没有丢,再比较回答质量。连原始证据都没拿齐时,优先改切块和召回,比讨论十六倍压缩更接近当前问题。
三、本地 RAG 准确率 98%,为什么还不能直接上线?
开头那组数据来自 LocalCortex 的实战记录。作者用 Ollama 运行模型,搭配 Qdrant 和 Postgres,记录了本地文档问答的多轮实验。
这里有三个数字,不能混着用。两套评估题合计 113 道;后来人工检查的生产风格测试是 62 道,其中 61 道正确;另有 14 道无关话题提示全部被拒绝。约 98% 对应的是 61/62,不是 113 道题的统一正确率,更不是任意企业文档的表现。
速度也得放在旁边。在作者的 CPU 运行条件下,Llama 3 8B 的中位回答时间为 48 秒。对异步整理材料的 AI 办公提效工具,这个等待也许可以接受;对用户连续追问的客服界面,就需要重新设计交互预期。
我更喜欢这篇文章记录失败优化的部分。作者加入 BM25 并使用 RRF 融合后,手册数据集的首位命中从 56/58 变成 55/58。另一套数据里,补齐缩写处理又改变了结果。混合检索不是按一下就能上涨的按钮,语料和查询方式会影响收益。
顺着上面聊,Agent 测试数据来源的对比文章正好补上了评估集怎么来的问题。手写和合成用例能在上线前覆盖预期需求,但真实用户会打错字、混着问几件事,还会在多轮对话里改变目标。
所以,62 道题很有用,只是它回答的是这 62 道题上的表现。
前端测试也有类似变化。tester-army/e2e把自然语言操作和定位器断言放进同一条测试,项目还介绍了录制回放机制,应用未变化时可以减少后续模型调用。它仍在向 1.0 推进,API 和配置可能变化,适合先拿一条独立流程试点。
我的取舍是,让 Agent 帮忙走复杂路径,把关键结果写成明确断言。比如升级套餐后,页面出现 Pro 字样只是一个信号,还得检查应用真正认定的套餐状态。能被稳定校验的结果,别全部交给另一个模型自由判断。
今天能做的实验很小。选一条核心流程,准备正常输入、错别字、多意图和中途改口四组用例,同时记成功率、耗时和调用成本。这样明天讨论是否接入时,桌上至少有四列数据,而不是一段顺滑的演示录像。
四、AI 编程助手反复找命令,怎么让它更快完成任务?
565 行 Python 编程 Agent 教程把核心循环拆得很清楚。模型请求工具,宿主程序执行,再把结果交回模型,继续下一轮。
这个简化实现很适合理解原理,但它不等于完整复刻成熟产品的能力。对业务团队最有用的提醒是,模型不会凭空知道仓库里的所有约定。工具入口、执行结果和项目说明,都在影响下一步动作。
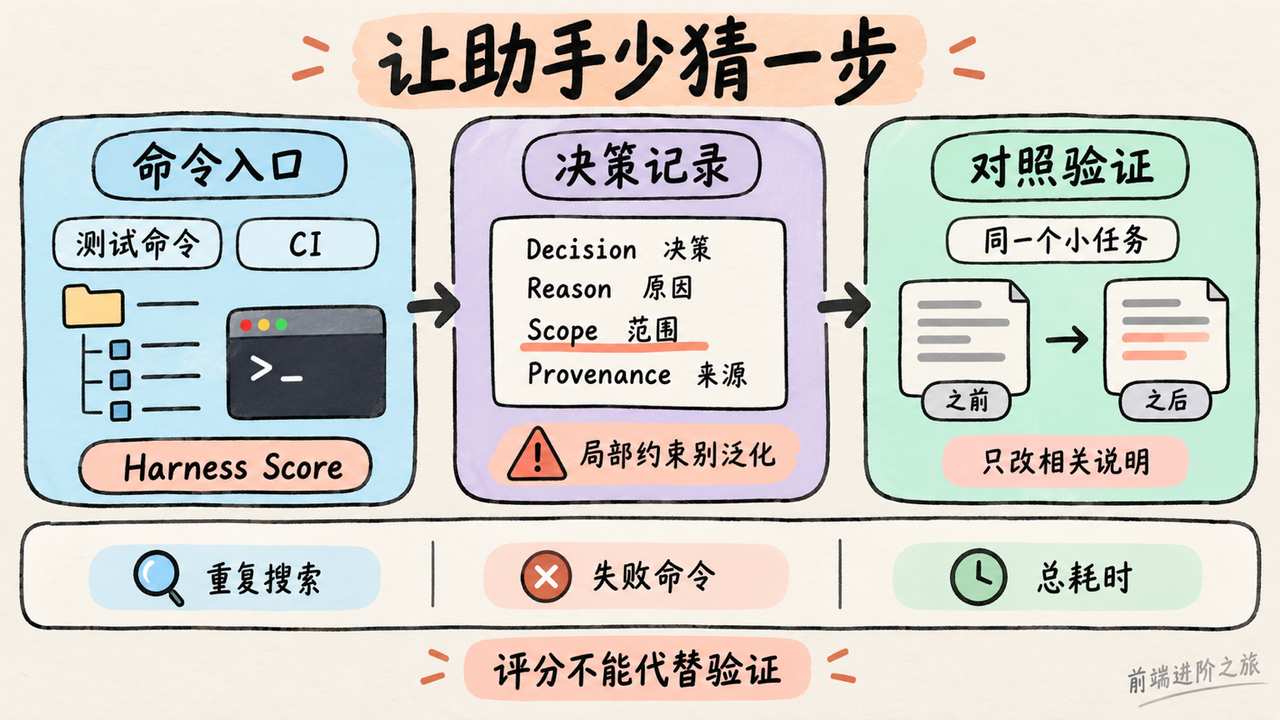
Harness Score检查的就是这部分外围条件。仓库有没有指引,测试命令能不能找到,CI 是否运行相应检查,扫描器通过文件里的证据给出评分。
分数高不代表代码质量高。它能帮助发现入口缺失,却不能证明测试断言有效,也不能证明 Agent 会正确使用这些入口。
大概率你也遇到过,README 写着「提交前跑测试」,真正可用的命令却藏在某个 workspace 的脚本里。人可以在群里问一句,Agent 就可能开始读目录、猜命令、重复失败。
另一个浪费来自团队决策丢失。跨工具上下文共享文章建议保存 Decision、Reason、Scope、Provenance,而不是把整段聊天当长期记忆。我赞成这个格式,但规则文件并非天然不能共享;关键是团队有没有统一维护,以及不同工具有没有真正读到它。
下面这个 JavaScript 对象展示了我会怎样记录一条假设的团队决策,让后来的 Agent 知道它为什么存在。
const decision = {
  decision: "账单状态更新继续使用 Postgres 事务",
  reason: "当前流程需要行级锁约束并发更新",
  scope: ["billing-service"], // 只约束相关服务
  provenance: {
    author: "billing-team",
    recordedAt: "2026-10-05",
    reference: "ADR-012", // 示例编号,落地时关联真实记录
  },
  status: "active",
  supersedes: null,
};
最容易翻车的是 scope,一条局部约束如果被当成整个公司的架构原则,共享记忆反而会扩大误导。
Skill 数据驱动优化记录也支持少写空泛规则。作者固定执行模型,通过 train、selection、test 划分筛选修改,部分听起来合理的建议实际让结果变差。这里所谓「训练」主要是在迭代指令文件,别误读成更新模型参数。
我会用同一个仓库小任务做两轮对照,只改命令入口和一条相关决策记录,看重复搜索、失败命令与总耗时是否下降。改完说明就给自己加效率分,太早了。
五、后台 Agent 等人回复时,任务状态应该放在哪里?
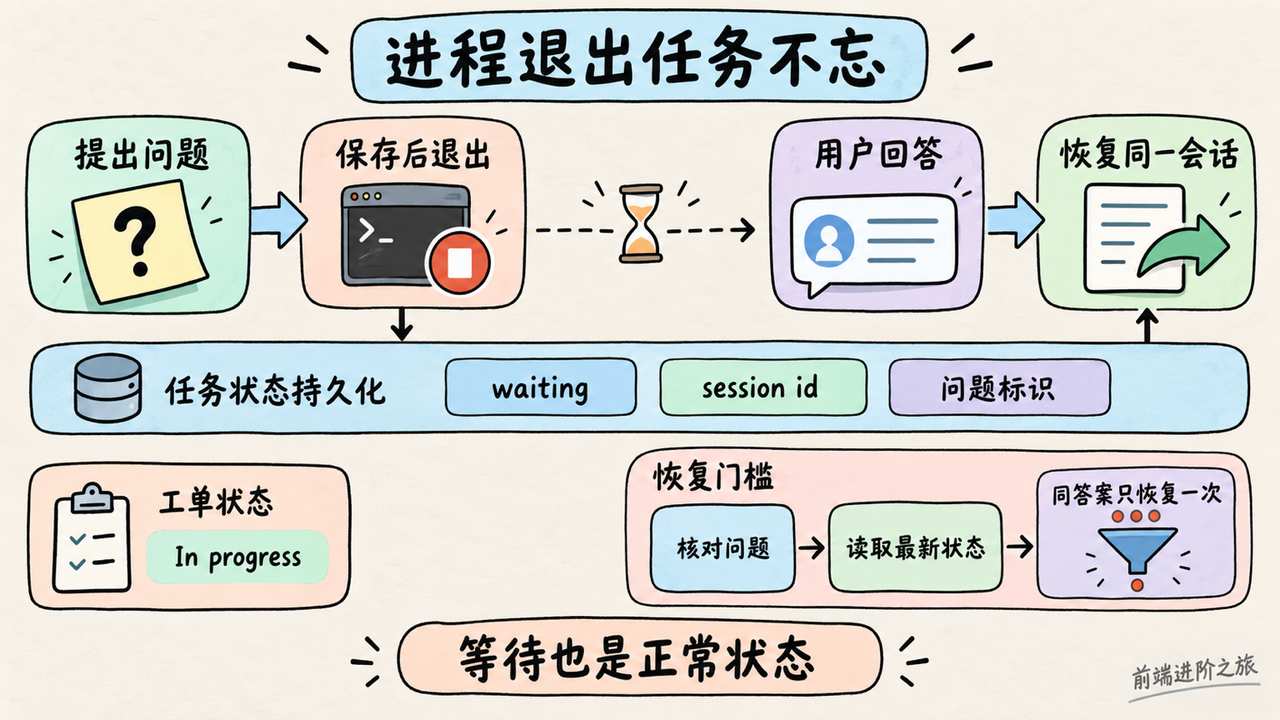
后台任务跑起来之后,真正麻烦的往往是半途那一下。Agent 需要确认一个范围,用户正在开会,进程要不要一直挂着?
Headless Claude Code 的中断恢复实践给出的方案是,把问题写进工单,结束当前进程,用户回答后再恢复同一个 session。作者的编排器默认一次只跑一个 Agent,每轮还有 240 分钟上限,因此等待会占用实际资源。
关键细节是,工单仍在 In progress,编排器另外保存 waiting 状态、session id 和问题标识。界面状态与执行状态没有混成一个字段。
进程可以退出,任务不能失忆。
Jev 工具链介绍从另一个方向处理类似问题。它把选择与分数做成结构化输出,调用方可以在置信度不足时转交人工。结构化信号更容易接代码,但输出一个概率,不代表这个概率已经在你的业务里校准好了。
我的读法是,人工接手应该成为正常状态。前端要能展示待回答的问题,后端要知道任务停在哪里,恢复时还得知道答案对应哪次提问。只在聊天窗口放一个「继续」按钮,容易丢掉这些关系。
Agent 云端基础设施选型文章把状态管理和隔离、命令执行、网络访问并列,也是在提醒同一件事。一次性环境和长期环境有不同取舍,不能只比较启动速度。
回到交付,一个具体风险是,用户回复前仓库已经变化,恢复后的 Agent 却继续使用旧结论。另一个是通知重复到达,同一个答案启动了两次后续操作。这些都需要编排器处理,不能靠模型记得小心。
当天就能做一次中断演练。在测试任务等待回答后结束进程,再重复提交同一份答案,检查是否只恢复一次、是否读到了正确问题和最新任务状态。这个实验比连续空跑几小时更容易暴露问题。
六、Agent 能调付费 API 和写数据库,权限边界该放哪?
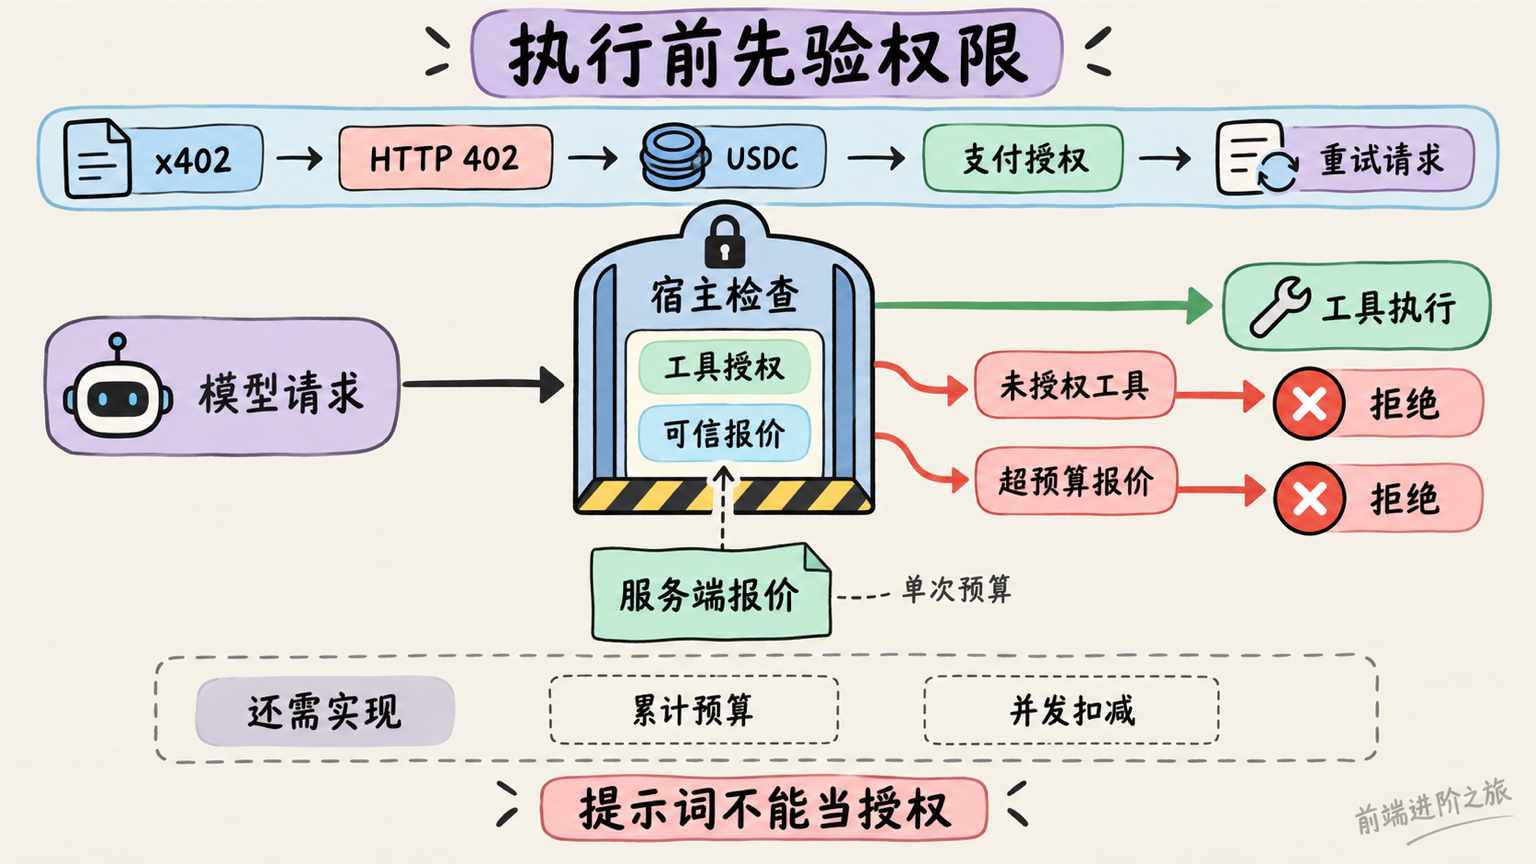
x402 教程展示了按次支付流程。服务端返回 HTTP 402 和支付条款,客户端签发 USDC 支付授权,再重试请求。教程里的服务单次调用价格是 0.005 美元,这是示例服务报价,不能当成协议的统一价格。
免账号、免 API key 的调用方式有吸引力,但支付授权、钱包与预算仍然需要管理。对全栈开发者来说,接通协议只完成了请求链路,业务还得决定允许买什么、每次最多花多少、失败后是否重试。
另一篇x402 数据 API 构建日志提供了很好的降温信息。作者打通了按次付费服务,截至写作时付费调用为 0,收入也为 0。协议跑通和市场愿意付费,得分开算。
再看权限。关于 NCSC Agent 安全建议的开发者解读用一个例子提问,检索文档里出现要求删除数据库表的指令时,究竟是什么阻止执行?如果答案只有系统提示词,运行时就还缺一道实际检查。
提示词攻击与传统安全栈的文章讨论了语义攻击的难点。我不会因此说传统安全设施全部失效,也不会把语义网关当成万能解法。对当前应用更直接的要求,是工具执行入口必须检查授权,不能因为模型提出请求就照做。
下面这段 JavaScript 展示一个最小故障注入测试,验证宿主侧拒绝未授权工具和超预算调用。
const policy = {
  allowedTools: new Set(["searchDocs"]),
  maxCostMicros: 5000,
};

function authorize(call) {
  if (!policy.allowedTools.has(call.tool)) {
    throw new Error("工具未授权");
  }
  if (
    !Number.isSafeInteger(call.costMicros) ||
    call.costMicros < 0 ||
    call.costMicros > policy.maxCostMicros
  ) {
    throw new Error("报价无效或超出单次预算");
  }
}

const faults = [
  { tool: "dropTables", costMicros: 0 },
  { tool: "searchDocs", costMicros: 6000 },
];

for (const call of faults) {
  let rejected = false;
  try {
    authorize(call); // 必须在真实工具执行前调用
  } catch {
    rejected = true;
  }
  if (!rejected) throw new Error("越权请求未被拦截");
}
最容易翻车的是 costMicros 的来源,线上必须使用经过校验的服务端报价,不能相信模型自行填写的金额;这段示例也没有处理累计预算和并发扣减。
我会先在测试环境注入一次越权工具请求、一次超预算报价,再确认执行日志里没有真实写入和付款。能拒绝这两个请求,只证明这两条边界有效,但已经比提示词里多写一句「注意安全」更可检查。
总结
这批内容里,有实验记录、有项目说明,也有对未来的推演,日期不能混为一谈。今天读到的项目,不一定今天发布;今天讨论的自动化能力,也不等于已经跑通自主研发闭环。
能从给出的实验数字里确认的是,LocalCortex 的约 98% 来自 61/62 道人工检查的回答,LCLM 的高压缩比伴随基准准确率下降。工单恢复、仓库扫描和按次支付,则是项目作者描述的实现方案,我没有把它们当成自己实测过的结果。
我的判断是,接下来团队在 AI 编程上的差距,会越来越多地出现在验收、上下文和运行时控制上。至于递归自我改进能加速多少、潜在上下文压缩能为你的应用省多少钱、Agent 是否愿意持续购买工具,这些问题还不能靠今天的几篇文章下结论。
要我选,我会先把一个真实任务的验收做扎实。等模型说「做完了」时,我们至少知道该检查什么。
参考
- Hinton 发表首篇 RSI 论文,AI 造 AI 进入流水线|量子位
- gstack 角色化 AI 开发工作流|GitHub
- LCLM 的 16 倍上下文压缩|dev.to
- 如何排查文档问答中的检索问题|dev.to
- 113 个评估问题带来的本地 RAG 实战经验|dev.to
- Agent 测试用例的合成数据与生产数据来源|dev.to
- tester-army/e2e 自然语言端到端测试框架|GitHub
- 从零构建 565 行编程 Agent|dev.to
- Harness Score 与仓库测试命令可发现性|dev.to
- 跨工具共享团队决策记录|dev.to
- 用评估筛选 Agent Skill 修改|dev.to
- Headless Claude Code 中断与恢复实践|dev.to
- Jev 结构化判断工具链与中文文档|dev.to
- Agent 云端基础设施选型维度|dev.to
- x402 按次付费 API 教程|dev.to
- x402 数据 API 构建日志|dev.to
- NCSC Agent 安全建议的开发者解读|dev.to
- 提示词攻击与 LLM 应用安全控制|dev.to
- 前端进阶之旅