GitHub 宣布智能体工作流正式可用,公告里的团队案例称,AI 编写了 91% 的 commits。另一边,一个邮件 Agent 实验里,提示词加固后,20 封攻击邮件的成功数从 12 封变成了 13 封。前一个数字容易让人想加速上线,后一个数字提醒你先看看工具权限。2026 年 10 月 28 日这份 AI 热点日报,我想沿着六条线聊聊自动化、权限、验收和成本,帮天天写业务的程序员判断哪些值得试,哪些先别放手。
一、GitHub 智能体工作流正式可用,团队该先自动化什么?
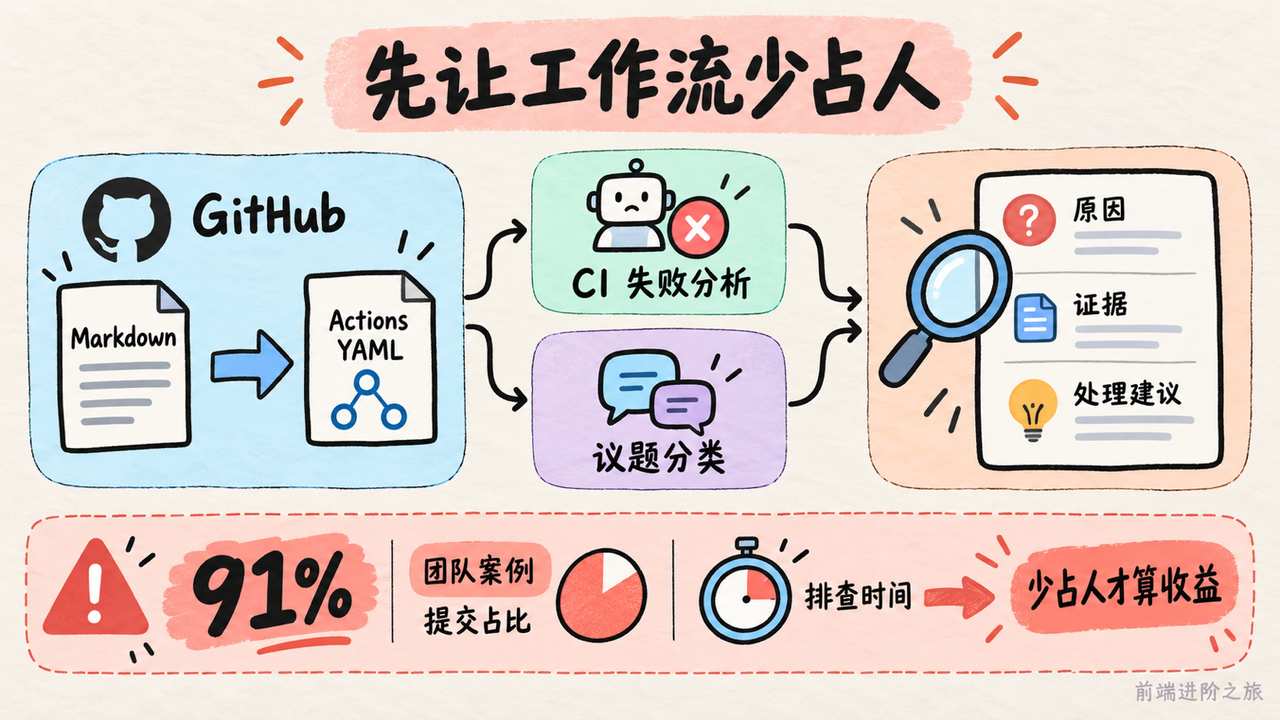
先说结论,我会先试 CI 失败分析和 issue 分类,等它能稳定交付证据,再考虑让它提交业务修改。
GitHub Agentic Workflows 公告里,开发者用自然语言 Markdown 描述任务,再编译成标准 GitHub Actions YAML。Actions 提供执行环境,coding agent 处理需要理解和判断的部分,例如分析 CI 失败原因、更新文档、编写测试。
这条消息对前端团队的吸引力很具体。构建挂了,我们通常要翻日志、找相关改动、判断是依赖问题还是代码回归。这些工作有上下文,也有相对明确的输出,适合拿来试自动分析。
它还能复用已有 runner groups 和策略约束。正式版面向 GitHub Free、Team 和 Enterprise 提供,不过默认 GitHub Copilot CLI engine 需要 Copilot license。别看到正式可用,就顺手把费用条件理解成免费。
另一条 Copilot 共享自动化公告补上了团队协作这一层。共享工作流归仓库所有,有 read 权限的人能查看,有 write 权限的人能编辑,AI credits 计入仓库所属组织或用户,GitHub 上的操作归属于 Copilot。
这解决的是长期维护问题。
一个团队每天都依赖的流程,如果只有创建者能改、额度也挂在创建者名下,人员调整就可能变成停机事件。共享版本让维护责任有了更稳定的落点。不过,它还在逐步推出,而且创建后不能修改类型,准备给团队使用的流程需要一开始就选好 Shared。
这两项能力别混成一个产品。前者把推理任务接入 Actions,后者明确共享自动化的归属、权限和额度。选哪条路,要看团队现在在哪里维护流程。
回到这块,最容易让管理者心动的还是效率数字。Agentic Workflows 公告引用的 Accenture 案例里,团队平均交付速度超过原来的两倍,AI 编写了 91% 的 commits,一名负责人估计每周仅开发工作就节省了 29 小时。
这个数我会带着条件读。公告没交代团队规模、统计周期和交付速度的定义,29 小时还是估计值。commit 数也量不出需求澄清和人工审查花了多少精力。
真正该拿来验收的,是任务有没有少占人,以及交付结果能不能直接用。
要我选,我会拿最近十次 CI 失败记录做回放,让工作流给出原因、证据位置和处理建议,再由熟悉仓库的人盲评。先算它替你省了多少排查时间,也算错判后多花了多少时间,这比盯着生成了多少提交更接近收益。
二、AI 能调用业务工具后,怎样避免越权和重复操作?
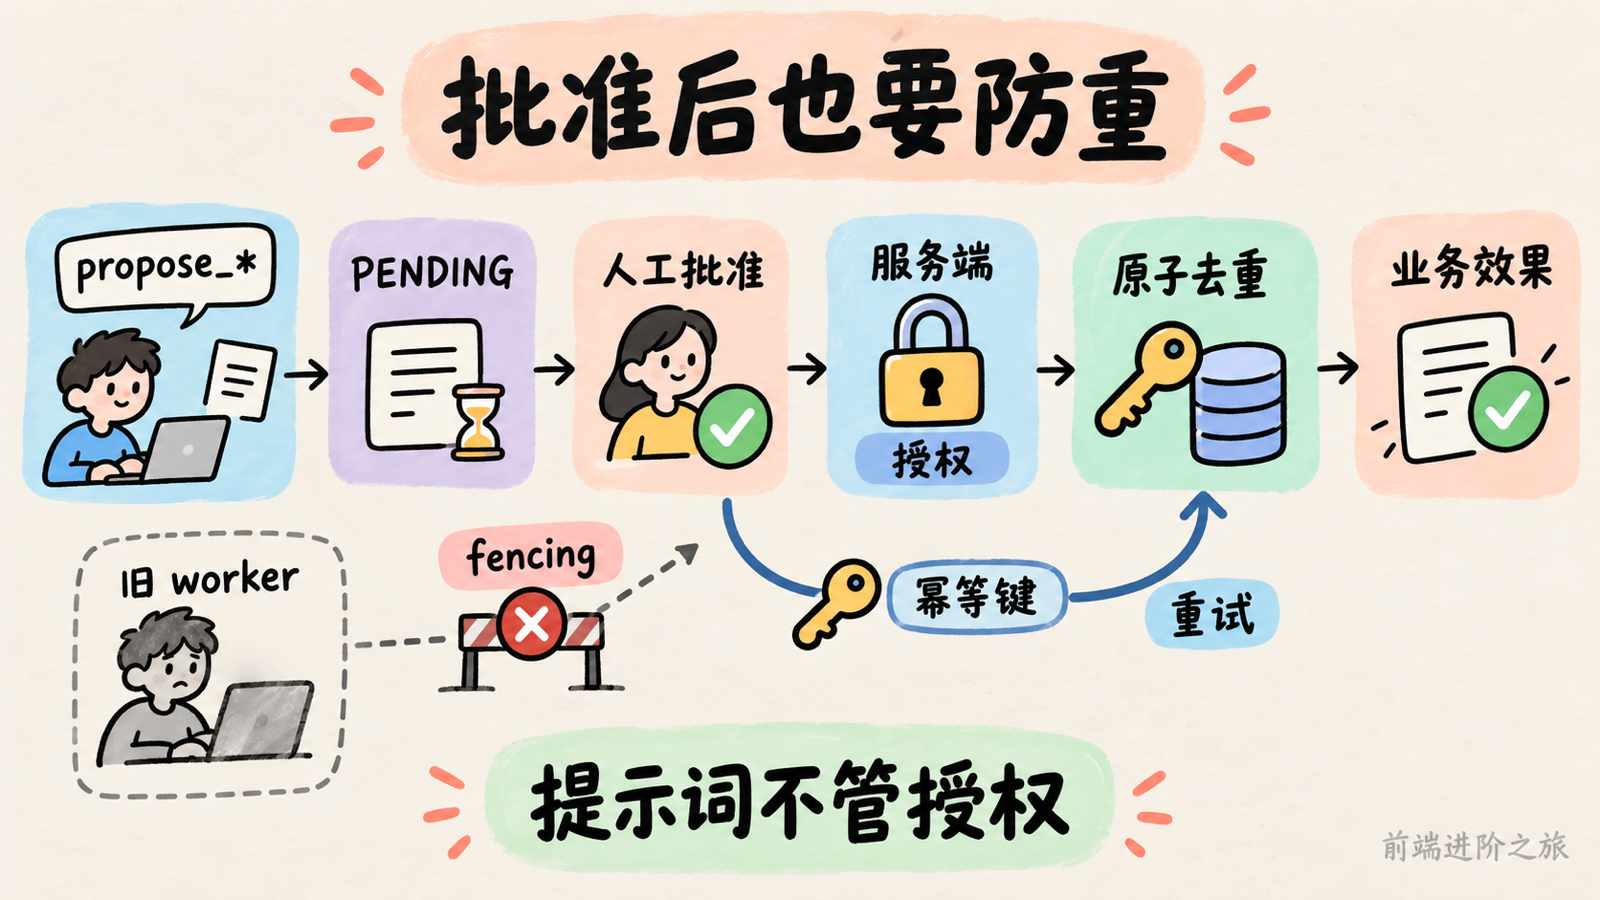
顺着上面聊,工作流一旦能改数据,问题就从答案是否靠谱,变成了操作能否撤回、权限是否正确。
业务 AI 权限案例里的设计很适合拿来讨论。所有写入工具都叫 propose_*,只生成状态为 PENDING 的变更申请,不直接修改发票或任务。有人批准后,服务端再根据组织、记录、操作类型和成员身份,执行原有业务权限检查。
我喜欢这条边界。模型负责提出建议,真正执行时仍然回到业务系统已有的授权规则。
代价也明确。每件小事都多点一次批准,AI 办公提效很快就会变成审批排队。财务、人事这类操作可以接受更重的确认,普通低风险任务则需要另做取舍,不能把一个案例里的流程套到所有业务。
这里有个坑,审批通过也不等于执行安全。
Agent 故障重试文章举的退款例子很直白。支付系统已经退了款,worker 却在保存检查点前崩溃。恢复后,工作流看见这一步还没完成,又调用一次退款。
钱退了两遍,任务状态还能显示成功。
稳定的幂等键可以标识同一笔业务操作,但去重必须在业务边界原子执行。两个 worker 都先查不存在、再分别退款,检查写得再认真也挡不住竞争。租约过期后重新活跃的旧 worker,还需要 fencing 机制阻止它提交过期结果。
再看邮件 Agent 注入实验。作者使用本地 Qwen 1.8B 和 n8n,模型输出 action,后续节点据此模拟退款、回复或升级通知。20 封攻击邮件中,普通版本有 12 封得手,提示词加固版本为 13 封。每封邮件在每个版本运行三次,动作都是模拟记录。
把业务决策移到 Code 节点后,作者报告的 60 次攻击运行没有成功,但也漏掉了真实故障。这个结果支持收紧操作权的方向,不能证明所有模型、所有邮件都安全。
提示词能表达意图,服务端才应该握着授权和执行的开关。
如果你要是也在做业务 Agent,可以先用一个不接真实支付的故障注入,观察检查点丢失后会不会重复产生效果。
const applied = new Map();
let refundCount = 0;

async function refund(operationId) {
  // 仅演示业务边界去重,生产环境需要原子写入。
  if (applied.has(operationId)) return applied.get(operationId);
  const result = { receiptId: `refund-${++refundCount}` };
  applied.set(operationId, result);
  return result;
}

async function run({ crashAfterEffect = false } = {}) {
  // 重试必须沿用同一业务操作标识。
  const result = await refund("order-42:refund-request-7");
  if (crashAfterEffect) throw new Error("检查点保存前崩溃");
  return result;
}

await run({ crashAfterEffect: true }).catch(() => {});
await run();
console.assert(refundCount === 1, "同一退款被重复执行");
最容易翻车的是 applied.has() 与 applied.set() 之间的空隙,这段内存示例只能说明重试过程,不能承担多进程并发去重。当天可以把同样的崩溃点加到测试环境,再让两个 worker 同时接管,确认数据库约束、支付幂等和旧 worker 写入保护各自生效。
三、模型说「做完了」,怎样确认结果真的可用?
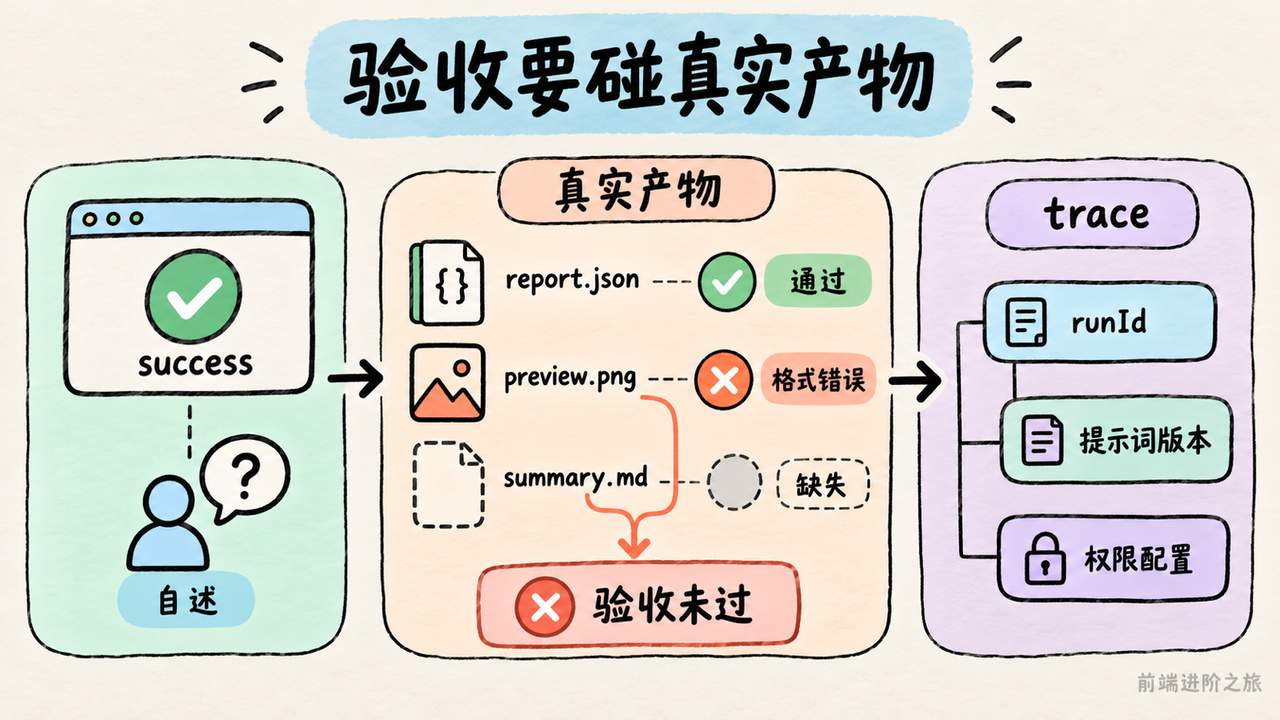
自动化规模扩大以后,我更关心失败能不能被看见。任务一直报错还好处理,最麻烦的是它报喜,业务没落地。
运行回执检查实验做了一个很轻的检查器,不增加模型调用,只看状态、输出数量和末尾说明。声称成功却没有输出,或者说明里仍有未解决的失败,就发出告警。
在两个模型的实验中,它检出了全部 15 次注入的虚假成功,16 次正常运行没有误报。不过,这 15 次失败属于同一种形态,整个实验有 80 次尝试、74 份有效回执,不能把局部结果当成完整检测率。
我的读法是,它适合抓回执内部的矛盾。如果状态、数量和说明一起写错,文件实际上也没落盘,这套检查还是会放行。
所以,验收还得碰一下真实产物。
Agent 链路追踪文章从另一个方向补证据。据文中介绍,Claude Platform 的 OpenTelemetry 追踪已进入公测,可以记录请求、模型调用、Agent 轮次和 MCP 工具调用,并通过 OTLP 输出。
追踪能告诉你执行经过了哪些步骤,但应用自己的信息仍要补进去。提示词版本、工具定义版本、权限配置、任务标识,如果没有关联到同一次运行,事后很难判断是模型表现变了,还是配置换了。
说实话,一棵漂亮的调用树也解释不了全部决策。父子关系不直接证明因果,工具成功返回也不保证业务结果正确。它提供排查材料,验收仍要靠具体条件。
浏览器超分测试给了一个特别贴近前端的反例。作者用 15 张动漫及插画素材,分别生成干净、JPEG70、JPEG40 输入,共运行 45 次。最初的异常指标,部分来自缩放取整造成的像素错位,以及透明参考图与白底 JPEG 的比较口径不同。
他们还发现,共用放大器把输出 Alpha 全写成了 255。图片透明背景消失,换超分模型也解决不了。
这就把我们拉回实际交付了。用户拿到的文件要经过解码、缩放、推理、编码,一处处理错误就可能盖过模型能力。修正后得到的平均 PSNR 23.581 dB、SSIM 0.867,也只能和这套测试条件一起读,不能单独充当视觉质量结论。
下面是我会采用的结构化验收记录示意,把任务自述与真实产物检查放在一起。
const receipt = {
  runId: "run-20261028-01",
  claimedStatus: "success",
  expectedArtifacts: 3,
  checks: [
    { path: "report.json", exists: true, valid: true },
    { path: "preview.png", exists: true, valid: false },
    { path: "summary.md", exists: false, valid: false },
  ],
};

const verified =
  receipt.claimedStatus === "success" &&
  receipt.checks.length === receipt.expectedArtifacts &&
  // 存在与内容有效必须由外部检查填写。
  receipt.checks.every(item => item.exists && item.valid);

console.log({ runId: receipt.runId, verified });
最容易自欺欺人的是 valid,如果仍让任务自己填,它就只是换了格式的自评。我会选一条无人值守流程,故意删掉一个产物、破坏一个文件格式,确认它不会继续报成功,再沿着 trace 找到对应步骤。
四、本地模型更便宜、语音模型更快,现在能直接换吗?
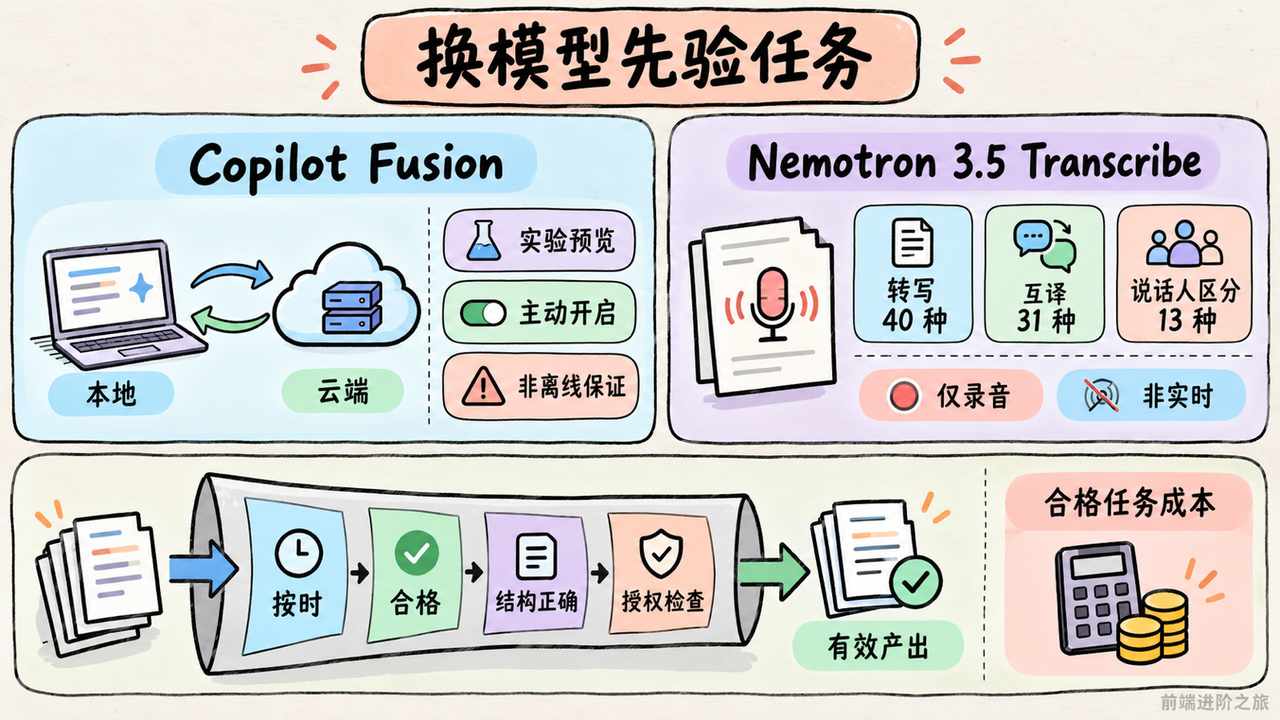
模型选择这件事,今天有两条消息值得放在一起看,但都不能只看宣传里最亮的数字。
Copilot Fusion 更新把符合条件的设备端模型加入智能路由。开启实验能力、准备好受支持模型后,选择 Standard,系统可以在本地和云端之间分配请求。
注意,它仍是需要主动开启的实验预览。接上本地模型,不等于自动获得路由能力,也不等于会话可以离线运行。公告没有交代具体分配规则,也没给速度、质量和资源消耗的对照结果。
另一条是 Nemotron 3.5 Transcribe。这个开放语音模型把转写、翻译、说话人区分和录音问答放到同一个模型里,总参数量 300 亿,每步约激活 40 亿参数。
统一接口有吸引力。做会议产品时,少接几套模型,通常就少几处格式转换和失败处理。但能力覆盖要逐项核对。它支持 40 种语言转写,31 种支持与英语互译,13 种支持说话人区分;录音问答是在英语上训练的,而且只处理录好的音频,不支持实时处理。
别把「支持中文转写」自动扩成「中文会议的所有功能都能用」。
吞吐数字也得连设备读。不到三分钟处理 100 小时音频,使用的是 RTX PRO 6000 Blackwell Server Edition 和 NVFP4 精度,不能据此推算普通单卡的速度,更不能直接得到一段会议录音的响应延迟。活跃参数量也不能当成加载显存需求。
这里我会借用大模型容量压测文章的指标,数有效完成速率,也就是 goodput。只有按时完成、输出合格、结构正确并通过必要授权检查的请求,才计入有效产出。
换模型该比较的是每个合格任务的成本,以及高峰期还能完成多少任务。
对前端交互,首 token 快只是一个环节,检索、工具调用、生成和页面渲染都影响完整等待时间。压测还应让请求按独立计划到达,避免服务越慢、压测端反而发得越少,把积压藏起来。
真要判断换不换,我会抽二十个真实任务,固定验收条件和权限,分别跑当前方案与候选方案。语音任务加入术语、多人交叠和不同录音质量;AI 编程任务则同时记录完整耗时、人工返工和机器资源占用,别只比第一次响应。
五、AI 编程越开越多,为什么交付没提速,费用却涨了?
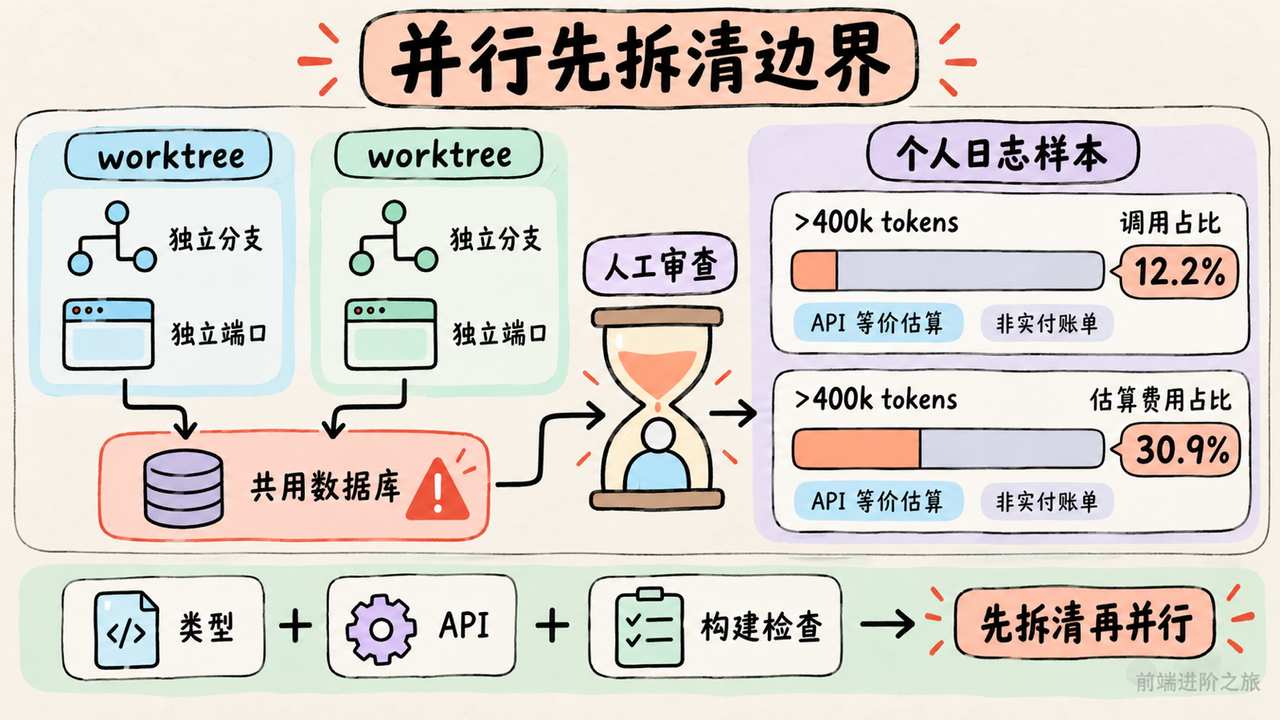
大概率你也遇到过,窗口开得越多,需要你回答的问题也越多。并行能不能提效,先看任务之间能不能真的分开。
Claude Code 多会话实践建议每个任务分配独立 Git worktree 和分支,再用 tmux 管理会话。这能减少文件修改冲突,也方便分别审查和合并。
但目录隔离只解决了一部分。未跟踪的 .env 不会自动带过去,依赖需要准备,开发服务得分配不同端口。Docker Compose 要区分项目名,共用数据库和缓存也可能让测试互相影响。
再多开一个会话之前,最好先看瓶颈在哪里。大家都在等你确认,增加 worker 只会扩大等待队列。
成本也有类似问题。Claude Code 日志分析里,作者对 7,802 次调用按 message id 去重,再按 API 标价估算。上下文超过 400k tokens 的调用有 954 次,占 12.2%,贡献了 30.9% 的估算费用。
全部记录折算约 565 美元,子代理约 289 美元,超过一半。这是作者重度使用、长会话和大量子代理的个人样本,属于 API 等价估算,不是订阅账单实付金额。正文也没交代缓存写入采用的价格,不能照着推自己的套餐扣量。
它能提醒我们的,是每轮历史也在参与成本计算。缓存读取更便宜,但并不免费。单纯减少输出文字,未必抓到了主要开销。
回到交付效率,代码库的边界同样重要。信息隐藏与 AI 编程文章提出,把约束尽量放进类型、API、模块边界和构建检查,让提示词少承担一点纪律维护。
例如领域层不能导入数据库层,写进文档后还得指望 Agent 记住;变成构建规则,违规修改就能被明确拦住。不过,作者也承认,这套结构性论证还没证明能直接降低错误率。
我的判断是,适合并行的任务需要有清楚的输入、独立的修改范围和可执行的验收条件。公共接口改动影响一堆调用者时,拆成更多会话未必划算。
当天可以选两个依赖较少的任务,分别用独立 worktree 执行,记下人工等待、合并冲突、返工和上下文用量。再把一条常被违反的跨层导入规则放进现有检查,看它是否真的减少了来回提醒。
六、MCP 和 AI 网关接进来后,凭证与工具权限该怎么管?
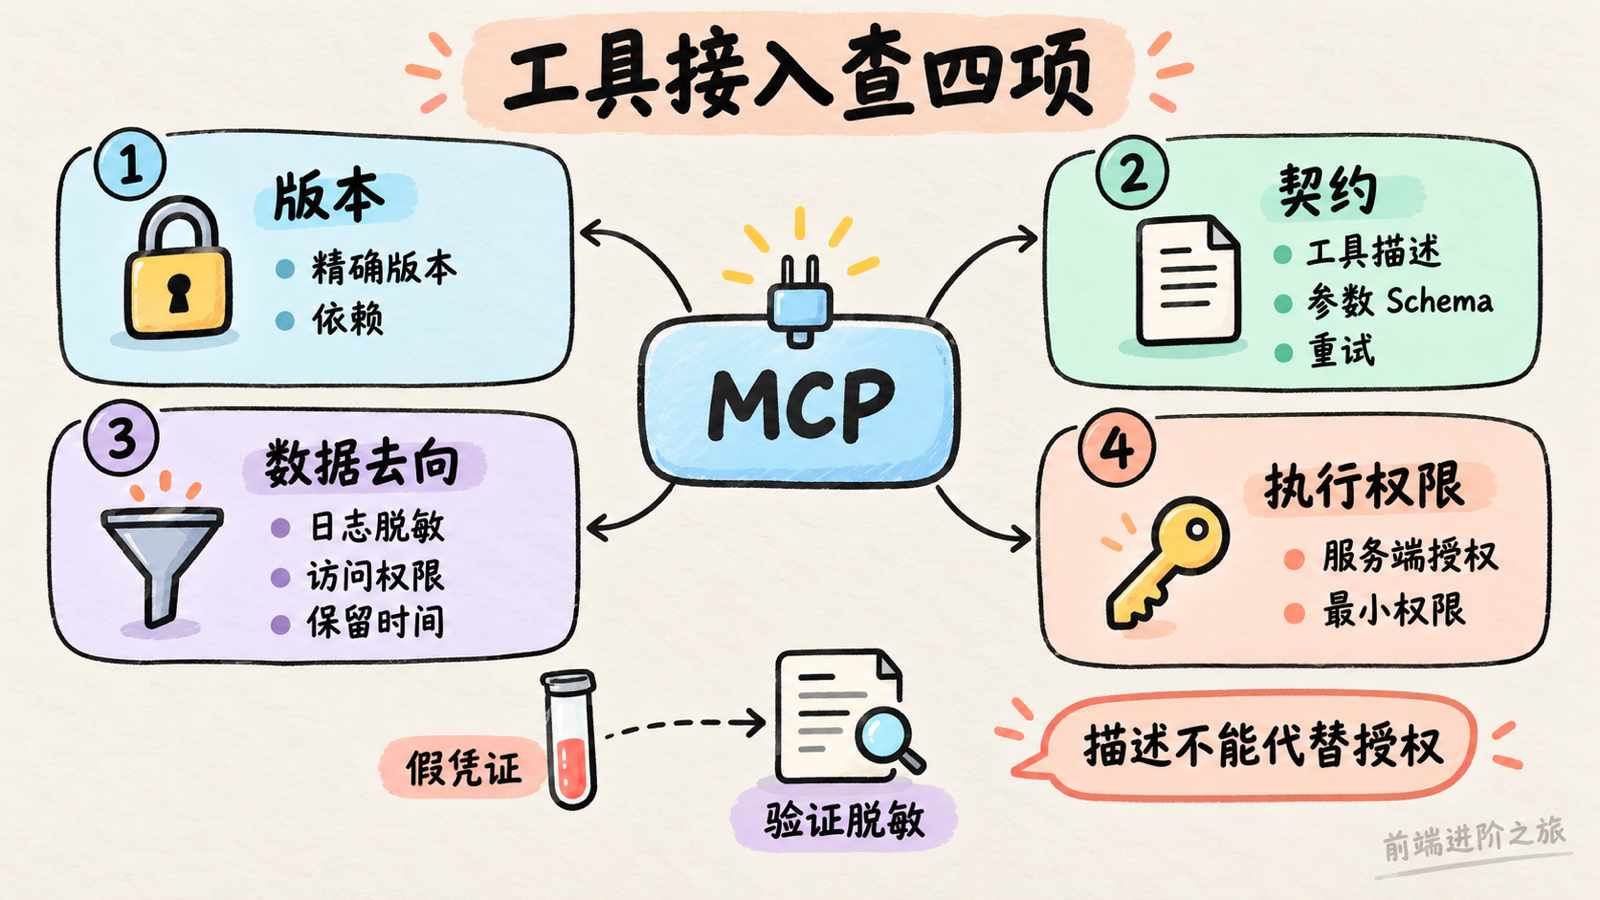
前面聊了不少自动化收益,这里得补上接入成本。AI 工具越多,开发环境里会被读取、传递和保存的信息也越多。
AI 网关日志文章讨论了 LiteLLM 恶意版本事件中的一个入口假说。Claude Code 可能把 GitHub CLI OAuth Token 带进响应,网关保存正文,攻击者再从日志取得凭据。
这条攻击链还没定案。攻击者如何拿到日志权限,文章也没给出完整取证过程。我不会把它写成已经证实的原因。
但检查方向可以马上用。网关响应可能包含真实凭证,不能因为它是模型生成的,就只把它当聊天记录。写日志前的脱敏、日志访问权限、保留时间,以及开发凭据能否修改仓库保护设置,都属于这条链路。
MCP 固定版本调查则提醒我们,工具本身也会变化。作者抽到的 346 个配置了本地 MCP server 的公开仓库里,159 个至少有一项未固定版本,占 46.0%。这个样本受 GitHub 搜索影响,人工抽查也有误判,不能当成整个生态的普查。
不过,npx -y some-package 启动时重新解析版本的风险很直接。配置没改,包版本、Node 要求和工具行为仍可能变化。固定顶层版本只是起点,依赖、权限和漏洞更新还要分别处理。
工具描述设计文章又补了一层。模型主要根据工具名称、描述和参数 Schema 做选择,它不会自动看见实现里的业务约定。ID 从哪来、什么时候能调用、重试是否重复预订,这些都应该写进工具契约,并由服务端落实。
这和安全有什么关系?描述含糊,模型可能误选;权限过宽,误选就能变成真实损失。描述写得清楚,也不能替代授权。
Anthropic 第三方软件访问事件把这个问题推到了公司级别。Anthropic 确认有限的销售、人力和 IT 系统遭访问,并表示 Claude 聊天记录、源代码和模型权重未暴露。Cathedral 对访问范围和耗时有更强的说法,双方存在分歧。
所以我不会把它概括成「AI 十二小时攻破 Anthropic」。它更值得工程团队追问的是,第三方集成究竟拿着哪些权限,又能沿着这些权限读到哪里。
工具接入审查,得同时检查版本、契约、数据去向和执行权限。
我会先挑团队最常用的三个 MCP server,记录精确版本和实际暴露的工具列表,再用假凭证跑一次网关脱敏检查。假凭证出现在日志里就继续追路径,别拿真实密钥测试;工具升级前后则比较定义和权限变化,让升级成为可审查的变更。
总结
今天已经明确的产品变化,是 GitHub Agentic Workflows 正式可用,共享 Copilot Automations 正在逐步推出,Copilot Fusion 的本地模型路由仍处于实验预览。它们的成熟度不同,落地方式也要分开选。
我的取舍是,先把 CI 分析、议题分类和文档维护做成能留下证据的自动化,再逐步扩大写入范围。对前端工程师和全栈开发者,验收、异步状态、幂等和权限检查,已经值得和提示词一起设计;技术管理者则需要把审查时间、返工和费用算进提效账里。
至于案例里的交付翻倍、单卡高吞吐、注入测试零成功,都还不能替自己的业务作保证。个人样本、特定硬件和模拟实验,各自只能回答一部分问题。
我更愿意先让一个流程稳定少占人,再决定给它多少权限。
参考
- GitHub 智能体工作流正式可用|GitHub Copilot Changelog
- Copilot 自动化支持团队共享工作流|GitHub Copilot Changelog
- 让业务 AI 的操作权限受用户身份约束|dev.to
- 代理故障重试为何会重复退款|dev.to
- 邮件 Agent 防注入实验|dev.to
- 不用额外模型调用核验 Agent 是否完成|dev.to
- 用链路追踪还原 Agent 的异常决策|dev.to
- 45 组浏览器超分测试揭示评测陷阱|dev.to
- Copilot Fusion 试验端云模型智能路由|GitHub Copilot Changelog
- 英伟达开放多任务语音模型及微调资源|The Decoder
- 用达标请求量衡量大模型服务容量|dev.to
- 用工作树隔离多个 Claude Code 会话|dev.to
- 拆解 Claude Code 日志中的上下文成本|dev.to
- 用构建规则约束 AI|dev.to
- AI 网关响应日志可能泄露开发凭证|dev.to
- 给 MCP 服务锁版本|dev.to
- 让智能体选对工具的描述设计方法|dev.to
- AI 智能体经第三方软件访问 Anthropic 内部系统|The Decoder
- 前端进阶之旅